Więcej niż chatbot: Jak warstwa semantyczna zwiększa niezawodność sztucznej inteligencji w firmach – Niedoceniany czynnik sukcesu sztucznej inteligencji w przedsiębiorstwach
Xpert przed premierą

Dostępne w 27 językach 📢
Preferuj Xpert.Digital w GoogleⓘOpublikowano: 1 listopada 2026 r. / Zaktualizowano: 1 listopada 2026 r. – Autor: Konrad Wolfenstein
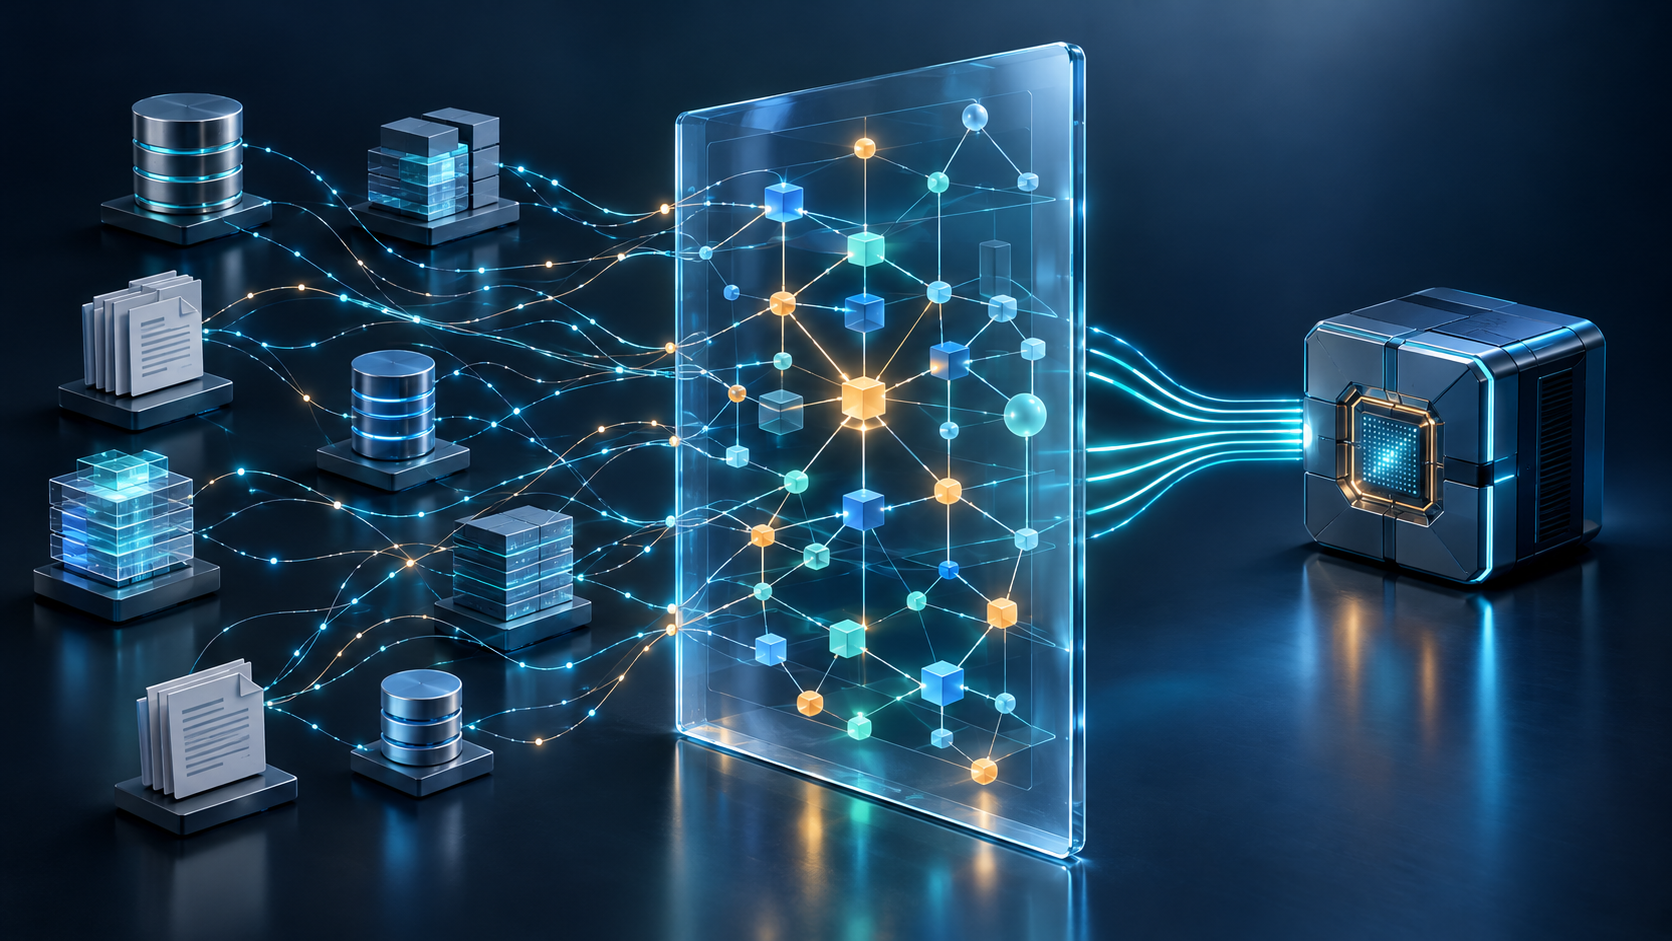
Więcej niż chatbot: Jak warstwa semantyczna zwiększa niezawodność sztucznej inteligencji w firmach – Niedoceniany czynnik sukcesu sztucznej inteligencji w przedsiębiorstwach – Kreatywny obraz na ten temat z wykorzystaniem sztucznej inteligencji: Xpert.Digital
Sztuczna inteligencja w biznesie: Dlaczego jasna terminologia decyduje o sukcesie ekonomicznym
Kiedy sztuczna inteligencja przyspiesza chaos: Dlaczego firmy potrzebują dzielenia się wiedzą biznesową
Mniej sprzeczności, lepsze decyzje: co warstwa semantyczna może zrobić dla firm
Firmy inwestują w sztuczną inteligencję, aby przyspieszyć procesy i podejmować lepsze decyzje. Jednak sam wydajny model językowy nie gwarantuje sukcesu w biznesie. Jeśli działy sprzedaży, finansów i obsługi klienta interpretują kluczowe terminy inaczej, sztuczna inteligencja może udzielać sprzecznych odpowiedzi i szybciej rozprzestrzeniać błędy. Warstwa semantyczna ma na celu rozwiązanie tego problemu: sprawia, że terminy, relacje i reguły są użyteczne i zrozumiałe w różnych aplikacjach. Jej wartość tkwi nie tylko w lepszych odpowiedziach, ale także w zmniejszeniu nakładów na koordynację i możliwości ponownego wykorzystania wiedzy firmowej. Warstwa semantyczna może jednak ujawnić niejasności organizacyjne, ale sama ich nie rozwiąże. Dlatego ważne jest, jak firmy mapują swoją rzeczywistość biznesową, definiują obowiązki zawodowe i mierzą rzeczywiste korzyści.
W związku z tym:
Warstwa semantyczna dla sztucznej inteligencji w przedsiębiorstwie: dlaczego znaczenie biznesowe determinuje zwrot z inwestycji w sztuczną inteligencję
Bez jasnych koncepcji sztuczna inteligencja automatyzuje chaos
Warstwa semantyczna sprawia, że terminy biznesowe, relacje i reguły są współdzielone i weryfikowalne w aplikacjach AI. Jej wartość ekonomiczna leży zatem nie tylko w lepszych odpowiedziach, ale także w perspektywie mniejszego wysiłku koordynacyjnego, możliwości ponownego wykorzystania wiedzy biznesowej i większej kontroli nad decyzjami. Kluczowym ograniczeniem jest jednak to, że taka warstwa semantyczna może ujawnić niejednoznaczności organizacyjne, ale nie jest w stanie ich samodzielnie rozwiązać.
Dla firm zmienia to strategiczne pytanie. Nie chodzi już tylko o to, który model językowy jest najskuteczniejszy lub jak szybko można opracować kolejnego asystenta. Ważniejsza staje się rzeczywistość biznesowa, na której opierają się te systemy. Jeśli działy sprzedaży, finansów i obsługi klienta używają tego samego terminu w różny sposób, technicznie zaawansowana sztuczna inteligencja może rozpowszechniać sprzeczne wyniki jeszcze szybciej i na większą skalę. Wyzwanie ekonomiczne polega na przekształceniu rozproszonych informacji w solidną, trwałą i użyteczną podstawę do podejmowania decyzji.
Różnica między wykorzystaniem a rezultatem
Wdrażanie sztucznej inteligencji (AI) rośnie, ale jej wykorzystanie nie ma jeszcze udowodnionego wpływu na gospodarkę. W 2025 roku 19,95% ankietowanych firm w UE zatrudniających dziesięciu lub więcej pracowników korzystało z co najmniej jednej technologii AI; stanowiło to wzrost o 6,47 punktu procentowego w porównaniu z 2024 rokiem. Istniały znaczne różnice między wielkościami firm: odsetek ten wyniósł 17% dla małych firm, 30,36% dla średnich i 55,03% dla dużych firm. Badanie objęło szerokie spektrum technologii AI, od analizy tekstu po maszyny autonomiczne, ale nie koncentrowało się konkretnie na wykorzystaniu AI generatywnej ani warstw semantycznych.
Z międzynarodowego badania biznesowego przeprowadzonego w 2026 roku wyłania się inny obraz. W badaniu tym 80% respondentów stwierdziło wzrost produktywności osobistej dzięki sztucznej inteligencji, a 37% wskazało na pozytywny wpływ na zysk przed opodatkowaniem (EBIT) swojej firmy. Tylko około 6% należało do grupy odnoszącej szczególne sukcesy, przypisując co najmniej 5% swojego EBIT sztucznej inteligencji i jednocześnie zgłaszając znaczące korzyści. Badanie objęło 1719 uczestników z 97 krajów i opierało się na danych deklarowanych przez samych respondentów; w związku z tym nie można go bezpośrednio porównywać z europejskimi statystykami biznesowymi.
Liczby nie dowodzą związku przyczynowo-skutkowego warstwy semantycznej. Raczej ilustrują problem biznesowy: pomiędzy indywidualnym uproszczeniem pracy a mierzalnym sukcesem biznesowym leży wysiłek organizacji włożony w tłumaczenie. To właśnie na tym styku istotna staje się wspólna warstwa znaczeniowa.
Znaczenie staje się częścią infrastruktury operacyjnej
Warstwa semantyczna łączy techniczne struktury danych z pojęciami biznesowymi, takimi jak klient, umowa, roszczenie czy przychód. Opisuje na przykład, które pola danych należą do klienta, jak obliczany jest kluczowy wskaźnik efektywności (KPI) oraz w jakich warunkach obowiązuje określony status. Dzięki temu różne aplikacje mogą opierać się na wspólnych definicjach zamiast czerpać własne interpretacje z etykiet tabel lub dokumentów.
Prosty przykład ilustruje implikacje. Firma może zdefiniować aktywnego klienta w sprzedaży poprzez trwające rozmowy, w finansach poprzez zarejestrowane transakcje biznesowe, a w obsłudze poprzez istniejące roszczenia serwisowe. Żadna z tych perspektyw nie jest z definicji błędna. Problem pojawia się, gdy sztuczna inteligencja nieumyślnie je miesza lub przedstawia jedną perspektywę jako uniwersalnie ważną.
Rozwiązanie ekonomicznie uzasadnione nie zawsze polega zatem na jednej definicji dla wszystkich celów. Często potrzebnych jest kilka jasno określonych, profesjonalnie odpowiedzialnych definicji o jednoznacznych granicach zastosowania. Wspólna warstwa znaczeniowa powinna w kontrolowany sposób odzwierciedlać różnice, a nie sztucznie tworzyć jednolitość, której firma w rzeczywistości nie posiada. Celem jest zrozumiała interpretacja, a nie homogenizacja pojęciowa.
Od raportu do decyzji operacyjnej
Klasyczne modele semantyczne Business Intelligence koncentrują się przede wszystkim na wskaźnikach kluczowych, wymiarach, agregacjach i relacjach między obiektami danych. Jednakże, całkowite pozbawienie ich logiki biznesowej lub funkcji autoryzacji byłoby nadmiernym uproszczeniem: na przykład, ugruntowane systemy BI obsługują relacje, obliczone wskaźniki kluczowe i dostęp do danych oparty na rolach. Dlatego granica między warstwą semantyczną BI a warstwą semantyczną AI nie jest wyraźna.
Główna różnica tkwi w wymaganiach. Na przykład raport powinien dokładnie odzwierciedlać przychody. Z kolei operacyjna aplikacja AI musi również potrafić określić, która umowa należy do procesu, która umowa specjalna ma pierwszeństwo oraz czy kolejny krok wymaga zatwierdzenia. To rozszerza zadanie z spójnej analizy na zależne od kontekstu wsparcie decyzyjne.
Z ekonomicznego punktu widzenia zwiększa to zarówno potencjalne korzyści, jak i potencjalne szkody. Źle zdefiniowany raport może prowadzić do błędnych decyzji. Asystent, który jest w stanie wdrożyć go natychmiast. Im bliżej AI jest zamówień, płatności, zobowiązań cenowych lub decyzji klientów, tym ważniejsze staje się rozróżnienie między wiarygodną interpretacją a wiążącą logiką wykonania.
Cztery podstawowe elementy wiedzy biznesowej
Kompleksowa warstwa znaczeniowa dla korporacyjnej sztucznej inteligencji powinna uwzględniać cztery rodzaje wiedzy: definicje encji, relacje, reguły decyzyjne i zebrane poprawki. Definicje encji określają, co stanowi obiekt biznesowy, na przykład aktywny klient, kluczowy kontrakt lub przypadek wysokiego ryzyka. Relacje łączą takie obiekty, na przykład spółkę zależną z kontem lub aneks do umowy z odpowiednią umową główną.
Reguły decyzyjne opisują progi, wyjątki, obowiązki i warunki zatwierdzenia. Zebrane poprawki rejestrują, gdzie eksperci merytoryczni poprawili błędne wyniki. Tylko w połączeniu może to stać się czymś więcej niż tylko wygodną funkcją wyszukiwania: transparentną podstawą interpretacji informacji i jej ram.
Z perspektywy ekonomicznej te rodzaje wiedzy należy wyceniać inaczej. Definicja klienta może być ponownie wykorzystana w wielu aplikacjach. Z drugiej strony, decyzja o wyjątku może dotyczyć tylko konkretnego kontraktu. Dobra architektura musi zatem nie tylko przechowywać wiedzę, ale także ograniczać jej zakres. W przeciwnym razie przekształca lokalny wyjątek w regułę ogólną i pogłębia błąd, któremu ma zapobiegać.
Dlaczego dokumenty są kluczowe dla zarządzania firmą
Warstwa semantyczna oparta na sztucznej inteligencji musi być w stanie połączyć nie tylko dane strukturalne, ale także umowy, e-maile, raporty i protokoły ze spotkań z odpowiednimi transakcjami biznesowymi. Powód jest oczywisty: wpis w bazie danych może zawierać uzgodnioną cenę standardową, podczas gdy zatwierdzona umowa uzupełniająca określa inne warunki. Każdy, kto analizuje jedynie zbiór danych, może przeoczyć ekonomicznie wiążący wyjątek.
Wyzwaniem nie jest samo znalezienie klauzuli. Chodzi o określenie jej statusu. Projekt nie jest podpisaną umową. Notatka ze spotkania wewnętrznego nie zastępuje zatwierdzenia. Późniejszy dokument może uzupełniać, częściowo zastępować lub mieć zastosowanie w innym zakresie niż wcześniejsza reguła. Te rozróżnienia muszą być wyraźnie modelowane i weryfikowane dla każdego konkretnego przypadku użycia.
Prowadzi to do ważnej perspektywy ekonomicznej: wartość analizy dokumentów nie jest mierzona liczbą przetworzonych stron. Pojawia się ona dopiero wtedy, gdy można na jej podstawie wyprowadzić wiarygodne wnioski dotyczące roszczeń, zobowiązań, terminów lub kierunków działań. Z drugiej strony, szybkie podsumowanie bez weryfikacji treści może wiązać się z dodatkowymi kosztami audytu i stwarzać fałszywe poczucie bezpieczeństwa.
Cztery źródła kosztów wynikające z niejednoznaczności semantycznej
Wpływ ekonomiczny można zrozumieć poprzez cztery kategorie kosztów. Po pierwsze, koszty wyszukiwania powstają, gdy pracownicy muszą zebrać informacje i zrozumieć ich znaczenie. Po drugie, koszty koordynacji powstają, gdy działy wyjaśniają i uzgadniają różne analizy. Po trzecie, koszty błędów powstają, gdy nieprawidłowe klasyfikacje lub reguły prowadzą do przeróbek i błędnych decyzji. Po czwarte, koszty powtórzeń powstają, gdy każdy nowy projekt sztucznej inteligencji wymaga ponownego opracowania tych samych podstaw technicznych.
Klasyfikacja ta stanowi analityczny model oceny, a nie empirycznie mierzony rozkład kosztów. Pomaga ona jednak uniknąć powszechnego błędnego przekonania: zwrot z inwestycji w warstwę semantyczną nie powinien zależeć wyłącznie od szybkości reakcji asystenta. Odpowiedź może pojawić się w ciągu kilku sekund i nadal być kosztowna, jeśli kilku specjalistów będzie musiało później zweryfikować jej poprawność.
Z drugiej strony, pozornie nieistotna poprawa może przynieść znaczną wartość. Jeśli wiążąca definicja skraca koordynację między działem finansowym a sprzedażą, korzyści mogą wpłynąć na wiele raportów i decyzji jednocześnie. Dlatego istotną jednostką ekonomiczną nie zawsze jest pojedynczy dialog ze sztuczną inteligencją, ale cały proces biznesowy, w tym jego pętle kontroli i korekcji.
Ponowne wykorzystanie pozwala uzyskać efekt skali
Wspólne definicje kluczowych wskaźników efektywności (KPI) pozwalają uniknąć powielania działań wdrożeniowych i zapewnić dostępność tej samej logiki biznesowej w różnych aplikacjach. W odniesieniu do szerszej architektury AI, jest to kluczowa obietnica skalowalności: już udostępnione terminy, relacje i reguły powinny pozostać użyteczne w innych przypadkach użycia. Dzięki temu warstwa semantyczna staje się potencjalną inwestycją w infrastrukturę, a nie izolowanym elementem projektu.
Logika ekonomiczna jest podobna do logiki współdzielonego zasobu. Jego początkowe utworzenie wiąże się z kosztami, a kolejni użytkownicy mogą korzystać z istniejących komponentów. Korzyści rosną jednak tylko wtedy, gdy nowe przypadki użycia rzeczywiście wykazują wystarczające pokrycie w zakresie wiedzy specjalistycznej. Inny asystent w tym samym obszarze usług może wykorzystać więcej istniejącej wiedzy niż aplikacja dla zupełnie innego obszaru biznesowego.
Dlatego nierealistyczne byłoby oczekiwanie automatycznego spadku kosztów z każdym kolejnym projektem AI. Nowe ramy prawne, rodziny produktów lub modele biznesowe mogą wymagać znacznych uzupełnień. Niezawodne korzyści skali nie polegają na tym, że kolejne projekty stają się darmowe, ale na tym, że kwestie już wyjaśnione nie muszą być ponownie wyjaśniane bez obiektywnego uzasadnienia.
Produktywność wymaga trzeźwej oceny
Badanie przeprowadzone wśród 5172 pracowników obsługi klienta wykazało, że dostęp do generatywnego asystenta AI skutkował średnim wzrostem liczby rozpatrywanych zgłoszeń klientów o około 15% na godzinę. Efekt ten był jednak nierównomierny: mniej doświadczeni i mniej wykwalifikowani pracownicy odnieśli większe korzyści, podczas gdy pracownicy o dużym doświadczeniu i wysokiej wydajności odnotowali jedynie niewielki wzrost szybkości, a w niektórych przypadkach również nieznaczny spadek jakości. Badanie pokazuje zatem konkretny efekt produktywności w konkretnym środowisku pracy, a nie izolowany zwrot z inwestycji w warstwę semantyczną.
To rozróżnienie jest kluczowe dla oceny ekonomicznej. Udana implementacja sztucznej inteligencji nie ujawnia, jaka część sukcesu była przypisywana modelowi językowemu, interfejsowi użytkownika, dostępnej wiedzy, szkoleniom czy zmienionym przepływom pracy. Każdy, kto na podstawie tych danych wyprowadza obietnice całkowitego zwrotu z inwestycji dla pojedynczego komponentu architektury, przekracza ich możliwości wyjaśniające.
Co więcej, uwolniony czas pracy nie przekłada się automatycznie na odpowiednią redukcję kosztów. Korzyści ekonomiczne pojawiają się na przykład wtedy, gdy firma radzi sobie z dodatkowym popytem, skraca czas oczekiwania, unika nadgodzin lub deleguje pracowników o ograniczonych kwalifikacjach do bardziej wymagających zadań. Bez takich zmian, mierzalna oszczędność czasu może pozostać w dużej mierze niewykorzystana z perspektywy biznesowej.
Obliczenie zwrotu uwzględniające wszystkie koszty
Skuteczny biznesplan powinien najpierw przeanalizować obecny proces. Obejmuje to liczbę spraw, czas przetwarzania, zapytania, korekty, eskalacje i konsekwencje błędnych decyzji. Następnie należy określić, które z tych czynników mogą być pod wpływem wspólnego znaczeniowo poziomu. Dopiero wtedy można rozpocząć merytoryczną dyskusję na temat zakresu inwestycji i oczekiwanych korzyści.
Po stronie kosztów, oprócz wykorzystania oprogramowania i modelu, należy również uwzględnić integrację systemów, modelowanie biznesowe, weryfikację tożsamości, zarządzanie dostępem, testowanie i bieżące aktualizacje. Zaangażowanie doświadczonych specjalistów nie jest w szczególności dodatkowym kosztem. Ich czas ma wartość ekonomiczną i nie jest dostępny do wykorzystania na inne zadania w trakcie wdrażania.
Wnikliwa ocena uwzględnia również straty początkowe i niepewność. Początkowo nowa aplikacja może wymagać dodatkowych kontroli, zanim procedury się ustabilizują. Niektóre korzyści stają się widoczne dopiero w kolejnych przypadkach użycia, podczas gdy inne nie materializują się. Dlatego etapowe podejście inwestycyjne z weryfikowalnymi celami pośrednimi jest często bardziej prawdopodobne niż duża inwestycja początkowa, której uzasadnienie opiera się głównie na obietnicach przyszłych synergii.
Właściwa miara sukcesu
Najważniejszym wskaźnikiem sukcesu jest ekonomiczny nakład na prawidłowo i zgodnie z przepisami zrealizowaną transakcję biznesową. Ta perspektywa łączy szybkość, jakość i kontrolę. Zapobiega ona uznaniu wysokiego wskaźnika wykorzystania lub krótkiego czasu reakcji za sukces, jeśli aplikacja generuje dodatkowe poprawki.
Należy rozróżniać różne rodzaje błędów dla celów pomiarowych. Nieprawidłowa metryka różni się od przeoczonego wyjątku umownego. Niekompletne powiadomienie różni się od nieautoryzowanego ujawnienia danych. Podobnie, musi być jasne, czy system rzetelnie odpowiada na pytanie, zgodnie z prawem przekazuje je człowiekowi, czy też generuje wynik bez wystarczającej podstawy.
Sensowne porównanie opiera się na wstępnie zatwierdzonych przypadkach i uwzględnia cały proces. W przypadku odpowiednich procesów, etapowe wdrożenia lub kontrolowane grupy porównawcze mogą pomóc odróżnić ulepszenia techniczne od zmian ogólnych. Przegląd powinien również uwzględniać rzadkie, ale istotne ekonomicznie wyjątki. System, który dobrze radzi sobie z rutynowymi przypadkami, ale pomija krytyczne wyjątki, może być przekonujący w przeciętnej ocenie, ale nadal nieakceptowalny w praktyce.
Wyszukiwanie wektorowe nie zastępuje wiążącego zobowiązania
Bazy danych wektorowych wspierają wyszukiwanie tekstów o podobnej treści, umożliwiając porównywanie informacji za pomocą reprezentacji liczbowych zwanych osadzeniami. Nowoczesne systemy mogą dodatkowo korzystać z filtrów metadanych, wyszukiwania według słów kluczowych i łączonych metod wyszukiwania. Dlatego nie można ich postrzegać jako repozytoriów zasadniczo niezależnych od kontekstu, pozbawionych możliwości filtrowania.
Jego podstawowa funkcja odpowiada jednak na inne pytanie niż pytanie o zarządzanie operacyjne. Podobieństwo merytoryczne nie wskazuje automatycznie, czy dokument jest aktualny, prawnie wiążący lub ma zastosowanie w konkretnej sprawie. System wyszukiwania może uwzględnić takie właściwości, jeśli są one niezawodnie przechowywane i poprawnie zintegrowane z zapytaniem. Nie decyduje on jednak sam o niezbędnych decyzjach biznesowych.
Prowadzi to do jasnej logiki inwestycyjnej dla firm. Ulepszone wyszukiwanie i rozbudowane warstwy znaczeniowe mogą się wzajemnie uzupełniać. Jednak dodatkowe wyniki wyszukiwania nie zastąpią jasno określonych obowiązków i zasad. Ci, którzy próbują korygować każdą błędną odpowiedź wyłącznie za pomocą bardziej zaawansowanego indeksu wyszukiwania, ryzykują dostarczenie większej ilości materiału bez wyjaśnienia jego merytoryczności.
🤖🚀 Zarządzana platforma AI: szybsze, bezpieczniejsze i inteligentniejsze rozwiązania AI dzięki UNFRAME.AI

Zarządzana platforma AI — zdjęcie: Xpert.Digital
Tutaj dowiesz się, jak Twoja firma może szybko, bezpiecznie i bez wysokich barier wejścia wdrażać dostosowane do jej potrzeb rozwiązania z zakresu sztucznej inteligencji.
Zarządzana platforma AI to kompleksowe i bezproblemowe rozwiązanie w zakresie sztucznej inteligencji. Zamiast zmagać się ze skomplikowaną technologią, kosztowną infrastrukturą i długotrwałymi procesami rozwoju, otrzymujesz gotowe rozwiązanie dostosowane do Twoich potrzeb od wyspecjalizowanego partnera – często w ciągu zaledwie kilku dni.
Najważniejsze zalety w skrócie:
⚡ Szybka implementacja: Od pomysłu do gotowej do użycia aplikacji w ciągu kilku dni, a nie miesięcy. Dostarczamy praktyczne rozwiązania, które generują natychmiastową wartość dodaną.
🔒 Maksymalne bezpieczeństwo danych: Twoje wrażliwe dane pozostają z Tobą. Gwarantujemy bezpieczne i zgodne z przepisami przetwarzanie bez udostępniania danych osobom trzecim.
💸 Brak ryzyka finansowego: Płacisz tylko za rezultaty. Wysokie początkowe inwestycje w sprzęt, oprogramowanie lub personel są całkowicie wyeliminowane.
🎯 Skoncentruj się na swojej podstawowej działalności: Skoncentruj się na tym, co robisz najlepiej. Zajmiemy się całościową implementacją techniczną, obsługą i utrzymaniem Twojego rozwiązania AI.
📈 Przyszłościowa i skalowalna: Twoja sztuczna inteligencja rośnie razem z Tobą. Zapewniamy ciągłą optymalizację i skalowalność oraz elastycznie dostosowujemy modele do nowych wymagań.
Więcej informacji tutaj:
Wpływ dokumentów na decyzje biznesowe
Wykresy wiedzy mogą pełnić więcej funkcji niż tylko tworzenie linków
Graf wiedzy reprezentuje byty i ich relacje w strukturze sieciowej, a zatem może stanowić istotny element warstwy semantycznej. Jednocześnie formalne ontologie i metody na nich oparte mogą również wspierać wnioskowanie logiczne; uznane standardy, takie jak OWL, nie ograniczają się do prostego przechowywania podstawowych powiązań. Ogólne stwierdzenie, że graf wiedzy z zasady nie może reprezentować reguł, byłoby zatem technicznie nieścisłe.
Kluczowe pytanie brzmi, jakie możliwości faktycznie łączy dane rozwiązanie. Graf zawierający obiekty przedsiębiorstwa nie zapewnia automatycznie kompleksowego zarządzania uprawnieniami, przetestowanej kontroli procesów ani profesjonalnego obsługiwania przypadków szczególnych. Z drugiej strony, odpowiednio zaprojektowana architektura grafu może spełnić znaczną część tych wymagań.
Warstwę semantyczną należy zatem rozumieć nie tyle jako koniecznie samodzielny produkt, co raczej jako pakiet wymaganych funkcji. Niektóre firmy mogą pokryć znaczną część tego procesu za pomocą istniejących modeli BI, katalogów danych, systemów grafowych i zestawów reguł. Inne potrzebują dodatkowej platformy. Ekonomicznie istotna jest udowodniona luka funkcjonalna, a nie liczba nowo wprowadzonych kategorii produktów.
Połącz zamiast zapisywać wszystko od nowa
Warstwa semantyczna może łączyć istniejące systemy ERP i CRM, platformy danych i repozytoria dokumentów bez konieczności wcześniejszej migracji wszystkich danych firmy do jednego nowego miejsca przechowywania. Modele semantyczne kluczowych wskaźników efektywności (KPI) mogą również bazować na istniejących strukturach danych i wyprowadzać z nich odpowiednią logikę zapytań. Wspólny sens jest zatem zasadniczo różny od fizycznego przechowywania danych.
Nie oznacza to jednak, że taka architektura może funkcjonować bez kopiowania danych. Indeksy wyszukiwania, wyodrębnione informacje o dokumentach, pamięci podręczne czy wstępnie obliczone wyniki mogą być przydatne w konkretnych przypadkach użycia. Istotnym pytaniem biznesowym jest to, jakie informacje należy przechowywać, gdzie i jak długo, a nie to, czy obietnica pełnej ochrony przed kopiowaniem jest realna.
Dobrze zaprojektowany system zapewnia równowagę między terminowością, czasem reakcji, dostępnością, kosztami i prywatnością danych. Inne wymagania dotyczące terminowości mogą dotyczyć stanu zapasów niż klauzul umownych. Zapytanie rozproszone w wielu systemach źródłowych może być elastyczne, ale zwiększa również zależność od ich dostępności. Dlatego najlepszym rozwiązaniem niekoniecznie jest maksymalne scentralizowanie lub rozproszenie, ale raczej dostosowanie go do procesu biznesowego.
Jakość danych pozostaje odrębnym zadaniem
Wspólna warstwa znaczeniowa nie oznacza automatycznie, że błędne dane źródłowe są poprawne. Nawet dostawcy semantycznych systemów zapytań zalecają jak najwcześniejsze zajęcie się podstawowymi zadaniami spójności, takimi jak normalizacja wspólnych obiektów i czyszczenie nieodpowiednich danych. Semantyka biznesowa i jakość danych wzajemnie się uzupełniają; nie można ich stosować zamiennie.
Szczególnie ilustratywnym przykładem jest tożsamość partnera biznesowego. Różne zapisy mogą odnosić się do tego samego dostawcy. Jednak podobne nazwy mogą również należeć do różnych podmiotów prawnych. Pochopne scalanie tych nazw może prowadzić do nieprawidłowego przypisania informacji o płatnościach, danych o zdolności kredytowej lub relacji umownych. Dobra architektura musi zatem umożliwiać wykrycie, które przypisania są potwierdzone, a które opierają się jedynie na wiarygodnych założeniach.
Ma to istotne znaczenie ekonomiczne, ponieważ błędy nie zawsze są widoczne w miejscu ich wystąpienia. Niedokładne dopasowanie tożsamości może później wpłynąć na wiele analiz i decyzji. Dlatego wdrożenie powinno koncentrować się nie tylko na jakości poszczególnych odpowiedzi, ale także na wiarygodnym przypisaniu obiektów bazowych. W przeciwnym razie ponowne wykorzystanie nie tylko mnoży wiedzę, ale także błędy.
Zasady muszą stać się technicznie skuteczne
Polityka w dokumencie nie stanowi wymuszonej kontroli. W przypadku zastosowań AI, koncepcje bezpieczeństwa wyraźnie rozróżniają wymagania językowe od środków technicznych, takich jak ograniczone funkcje, ograniczone uprawnienia i weryfikowalne warunki wykonania. W szczególności nadmierna autonomia i zbyt szerokie uprawnienia dostępu mogą prowadzić do błędnych lub zmanipulowanych wyników modelu, wyzwalających szkodliwe działania.
Solidna architektura powinna zatem oddzielać interpretację od wykonania. Model językowy może na przykład klasyfikować proces lub sugerować działanie. To, czy kwota została poprawnie obliczona, czy udzielono zgody, czy też można zrealizować rezerwację, powinno być dodatkowo zabezpieczone w procesach krytycznych weryfikowalną logiką i odpowiedzialnymi za nią systemami.
To wyjaśnia powszechne nieporozumienie. Warstwa semantyczna może stanowić podstawę biznesową dla zachowania zgodności z regułami. Jednak sama w sobie nie gwarantuje, że probabilistyczny model języka będzie niezawodnie stosował każdą regułę. Ekonomicznie opłacalne rozwiązanie wynika z wzajemnego oddziaływania znaczenia, uprawnień, testów, kontroli procesów i jasno zdefiniowanych kierunków działań.
Uprawnienia są częścią znaczenia
Uzyskując dostęp do wiedzy firmowej, należy sprawdzić nie tylko jej istotność, ale także uprawnienia dostępu. Mechanizmy kontroli dokumentów mogą ograniczać wyniki wyszukiwania na podstawie tożsamości użytkownika i przypisanych mu uprawnień; ich skuteczność zależy między innymi od poprawnej synchronizacji informacji o uprawnieniach. Wspólna baza wiedzy nie oznacza zatem, że każdy użytkownik ma dostęp do tych samych treści.
W praktyce wymiar czasowy ma kluczowe znaczenie. Pracownik może zmienić rolę, projekt może się zakończyć, a dokument może zostać następnie ograniczony. Jeśli warstwa wyszukiwania i kontekstu korzysta z nieaktualnych uprawnień, może ujawnić treści, które nie są już dostępne w systemie źródłowym. Dlatego utrzymanie uprawnień musi być wyraźnie uwzględnione w kosztach operacyjnych.
Nawet pytania o podobnej treści mogą, z uzasadnionych powodów, otrzymać różne odpowiedzi. Dwóch użytkowników może należeć do różnych obszarów odpowiedzialności lub mieć dostęp do różnych zbiorów danych. Spójność nie oznacza zatem identycznego sformułowania, ale raczej te same zasady zawodowe w porównywalnym kontekście. Odchylenie stanowi problem jakościowy tylko wtedy, gdy nie można go wyjaśnić czasem, rolą, dostępnością danych ani samym pytaniem.
Korekty wymagają ustrukturyzowanego procesu
Rejestrowanie poprawek wprowadzanych przez użytkowników jest jednym z zamierzonych elementów wiedzy warstwy semantycznej zorientowanej na sztuczną inteligencję. W zarządzaniu ryzykiem związanym ze sztuczną inteligencją, badanie błędów wprowadzanych przez ludzi i ich przyczyn jest również cennym źródłem informacji do oceny wdrożonych systemów. Nie oznacza to jednak, że każda zmiana wprowadzana przez użytkownika powinna automatycznie stać się ogólną regułą.
Przyczyny skorygowanego wyniku mogą być bardzo różne. Być może rekord danych został nieprawidłowo przypisany. Być może zastosowano wyjątek umowny. Być może poprzednia zasada firmy była nieaktualna. A może użytkownik po prostu wprowadził osobiste preferencje. Te przypadki wymagają różnych odpowiedzi i nie powinny być bezkrytycznie włączane do wspólnej bazy wiedzy.
Ekonomicznie uzasadniony proces uczenia się początkowo traktuje informację zwrotną jako weryfikowalne sugestie. Eksperci merytoryczni decydują o jej zakresie, wiążącym charakterze i niezbędnych testach. Dopiero wtedy zatwierdzona zmiana jest udostępniana do dalszych zastosowań. Nie wymaga to koniecznie ponownego uczenia modelu językowego. Kluczowe jest, aby uniknąć błędu w odpowiednim kontekście w przyszłości, bez nieumyślnego wprowadzania nowych błędów w innych miejscach.
Wersjonowanie chroni przed błędnymi poglądami retrospektywnymi
Definicje i reguły biznesowe ulegają zmianom, dlatego warstwa semantyczna powinna wersjonować zmiany i przypisywać je ekspertom merytorycznym do zatwierdzenia. Istniejące platformy semantyczne obsługują już wersjonowane definicje lub zweryfikowane zapytania referencyjne, w tym informacje o tym, kiedy i przez kogo zostały one potwierdzone. Prześledzona historia nie jest zatem jedynie ozdobą, lecz integralną częścią kontrolowanego użytkowania.
Jednakże, do późniejszej analizy, obecnie obowiązująca zasada jest niewystarczająca. Istotne jest również, jaka wersja obowiązywała w momencie transakcji i jakie informacje system był w stanie przetworzyć w tym czasie. Otrzymana później zmiana umowy nie może stać się nieumyślnie podstawą oceny wcześniejszej decyzji. W przeciwnym razie, z perspektywy czasu, powstaje pozór jasności, którego nie było w momencie podejmowania decyzji.
Firmy powinny zatem uwzględniać historię przepisów, wersje dokumentów i statusy danych łącznie. Opłacalność w tym przypadku nie polega na oszczędzaniu sekund, a na redukcji kosztów rozwiązywania sporów. Osoby, które potrafią odtworzyć podstawę decyzji, poświęcają mniej czasu na jej składanie w całość z wiadomości e-mail, pojedynczych plików i kolejnych przypomnień.
Wolność modelu nie jest jeszcze wolnością dostawcy
Wiedza w przedsiębiorstwie powinna być zorganizowana w taki sposób, aby zmiana modelu językowego nie wymagała automatycznie całkowitego przeprojektowania fundamentów biznesowych. Strategiczny argument za tym przemawia dynamika techniczna: między listopadem 2022 a październikiem 2024 r. koszt zapytań do modelu spadł ponad 280-krotnie przy poziomie wydajności porównywalnym z GPT-3.5. Porównanie to odnosi się do konkretnego poziomu benchmarku i nie powinno być interpretowane jako odpowiednia redukcja całkowitego kosztu aplikacji korporacyjnej.
Niemniej jednak wniosek jest wiarygodny: gdy wydajność i ceny modelu ulegają znaczącym zmianom, możliwość zmiany staje się coraz cenniejsza. Trwale użyteczny model techniczny może zapobiec sytuacji, w której każda aktualizacja technologiczna pociąga za sobą konieczność przeprowadzenia kompleksowych prac nad tłumaczeniem technicznym. Niezależność modelu nabiera zatem charakteru opcji strategicznej.
Nie eliminuje to jednak wszystkich zależności. Definicje mogą nadal być powiązane z zastrzeżonymi formatami platformy, interfejsami lub modelami operacyjnymi. Dlatego firma powinna osobno ocenić, czy może zmienić modele językowe, wyeksportować definicje wiedzy i kontynuować korzystanie z całego rozwiązania u innego dostawcy. Tylko to rozróżnienie pozwala na realistyczną ocenę kosztów zmiany i siły negocjacyjnej.
Rynek rośnie razem
Definicje semantyczne są teraz dostępne zarówno dla BI, jak i AI: Snowflake łączy metryki biznesowe i relacje encji z zapytaniami i agentami, a dbt udostępnia również centralnie zdefiniowane metryki za pośrednictwem interfejsów dla narzędzi AI. Równolegle powstała inicjatywa Open Semantic Interchange, umożliwiająca niezależną od dostawcy wymianę metadanych semantycznych. Projekt został przyjęty do Apache Incubator w 2026 roku pod nazwą Apache Ossie.
Ten rozwój ma większe znaczenie ekonomiczne niż kolejna zapowiedź produktu. Jeśli wiele narzędzi może korzystać z tych samych definicji, potrzeba tworzenia nowej logiki biznesowej w każdej aplikacji zostaje radykalnie ograniczona. Jednocześnie ugruntowane platformy danych mogą przejąć większą część tworzenia wartości, która wcześniej była zarezerwowana dla wyspecjalizowanych rozwiązań dodatkowych.
Dla klientów oznacza to: Przed dokonaniem nowego zakupu należy przeprowadzić inwentaryzację. Istniejące modele danych, katalogi kluczowych wskaźników efektywności (KPI), systemy autoryzacji i interfejsy mogą spełnić część wymagań. Otwarte formaty wymiany danych są w tym względzie pomocne, ale nie stanowią pełnego dowodu skuteczności. Należy je oceniać pod kątem tego, które definicje, reguły i informacje kontekstowe można przesyłać między faktycznie używanymi systemami bez utraty ich znaczenia.
Struktura wiedzy Unframe, widziana obiektywnie
Unframe łączy swoje funkcje semantyczne pod nazwą Knowledge Fabric, łącząc koncepcje przedsiębiorstwa, logikę biznesową, relacje i uprawnienia. Podejście to ma na celu ustrukturyzowanie zbiorów danych i treści dokumentów w celu dostosowania ich do konkretnych zastosowań oraz stopniowe rozszerzanie bazy wiedzy. Rozwiązanie jest również oferowane z różnymi modelami językowymi i integracją z istniejącymi systemami przedsiębiorstwa.
Atrakcyjność ekonomiczna tej koncepcji tkwi w połączeniu dotychczas oddzielnych zadań. Jeśli integracja systemów, kontekst biznesowy i kontrolowane użytkowanie dobrze ze sobą współgrają, można zmniejszyć nakład pracy wymagany do obsługi dodatkowych aplikacji. Jednak to, czy ta zaleta zmaterializuje się w konkretnej firmie, nie może być wywnioskowane wyłącznie z nazwy architektury. Potrzebne są weryfikowalne wyniki z procesów w samej firmie.
Jednocześnie kwestia własności i eksploatacji pozostaje istotna: Unframe rozróżnia dane, wyniki i konfiguracje rozwiązań będące własnością klienta z jednej strony, a Knowledge Fabric i inne komponenty platformy obsługiwane przez dostawcę z drugiej. Dlatego swoboda wyboru modelu nie powinna być utożsamiana z całkowitą niezależnością od platformy. Aby zapewnić rzetelną ocenę, należy wyraźnie określić opcje eksportu, prawa do definicji technicznych oraz ciągłość działania systemu w przypadku zmiany operatora.
Zacznij od małych rzeczy, zachowaj elastyczność
Podejście zorientowane na aplikacje ogranicza zakres modelowania i umożliwia weryfikację definicji z odpowiednimi ekspertami w danej dziedzinie, wykorzystując rzeczywiste zadania. Zamiast od razu mapować całą firmę, najpierw rejestruje się niezbędne systemy, obiekty, relacje i reguły jasno zdefiniowanego procesu. Zatwierdzone komponenty można następnie rozszerzyć o powiązane przypadki użycia.
Z ekonomicznego punktu widzenia, proces z częstymi powtórzeniami, weryfikowalnymi wynikami i wystarczająco istotnymi problemami koordynacyjnymi jest szczególnie odpowiedni. Zbyt prosty przypadek użycia może jedynie wykazać, że okno czatu można połączyć ze źródłem danych. Z drugiej strony, zbyt złożone wprowadzenie może stworzyć tak wiele nierozwiązanych przypadków szczególnych, że korzyści staną się widoczne dopiero po długim czasie.
Właściwa równowaga leży między ograniczonym zakresem a fundamentem wielokrotnego użytku. Projekt pilotażowy nie powinien być prototypem do jednorazowego użytku. Jednocześnie jego potencjał integracyjny nie powinien stać się pretekstem do zbudowania kompleksowego modelu biznesowego przed wprowadzeniem pierwszych mierzalnych usprawnień. Punktem odniesienia pozostaje to, jakie techniczne elementy konstrukcyjne są faktycznie potrzebne do kolejnego, znaczącego kroku.
Odpowiedzialność zawodowa determinuje akceptację
Wprowadzenie sztucznej inteligencji (AI) nie przenosi odpowiedzialności z ludzi na oprogramowanie. Każda centralna definicja wymaga kompetentnego organu, który może oceniać i zatwierdzać zmiany. Nawet nadrzędne ramy dla wiarygodnej sztucznej inteligencji podkreślają jasno zdefiniowane role i obowiązki człowieka w obsłudze systemów AI. Dlatego też, kompetencje techniczne i eksperckie nie powinny być domyślnie przypisywane tej samej roli.
Może to być niewygodne z punktu widzenia organizacji. Wspólna definicja przychodów, przynależności do klienta lub ryzyka może wpływać na systemy docelowe, obowiązki i istniejące praktyki ewaluacyjne. Warstwa semantyczna ujawnia takie różnice. Nie rozwiązuje ich poprzez techniczną elegancję, ale raczej wymusza podjęcie decyzji, których wcześniej można było uniknąć.
W tym właśnie tkwi jego długoterminowa wartość. Gdy koncepcje i reguły nie są już ograniczone wyłącznie do umysłów poszczególnych pracowników lub rozproszone w różnych aplikacjach, firma może stać się mniej zależna od nieformalnych monopoli wiedzy. Jednak ta przewaga zakłada, że specjaliści są zaangażowani w proces projektowania i postrzegają warstwę znaczeniową jako wspierającą. Jeśli zostanie ona wprowadzona jedynie jako narzędzie kontroli, gotowość do wnoszenia cennej wiedzy opartej na doświadczeniu może się zmniejszyć.
Nie każda firma potrzebuje takiej samej głębi
Dane dotyczące wykorzystania sztucznej inteligencji w Europie ujawniają znaczące różnice w skali wdrażania sztucznej inteligencji, niekoniecznie wskazując na potrzebę konkretnej architektury. Co więcej, wśród firm, które rozważały wdrożenie sztucznej inteligencji, ale nie zrobiły tego jeszcze w 2025 roku, 70,89% wskazało brak odpowiedniej wiedzy specjalistycznej jako powód rezygnacji z niej; 52,52% wskazało na niejasne konsekwencje prawne, a 48,83% na obawy dotyczące prywatności danych. Dane te odnoszą się konkretnie do tej podgrupy, a nie do wszystkich firm.
Pozwala to na opracowanie zróżnicowanej perspektywy inwestycyjnej. Mała firma z niewielką liczbą systemów i łatwymi w zarządzaniu procesami może początkowo wymagać spójnych kluczowych wskaźników efektywności (KPI) i jasno prowadzonej bazy wiedzy. Z kolei korporacja z licznymi oddziałami, liniami produktów i rolami dostępu może skorzystać z bardziej kompleksowej infrastruktury semantycznej. Odpowiedni poziom szczegółowości zależy od złożoności i ryzyka, a nie od atrakcyjności konkretnego terminu technologicznego.
Rezygnacja z niektórych zadań może być również ekonomicznie uzasadniona. Jeśli zadanie występuje rzadko, nie ma poważnych konsekwencji i można je niezawodnie wykonać za pomocą prostej procedury, koszty utrzymania dodatkowej warstwy mogą przewyższyć korzyści. Przekonujące podejście architektoniczne musi zatem również wskazywać, gdzie nie jest potrzebne.
Kontrolowane znaczenie jako przewaga konkurencyjna
Generatywna sztuczna inteligencja może przekonująco prezentować wadliwe treści; ryzyko to należy do wyraźnie opisanych cech i zagrożeń związanych z takimi systemami. Nawet dodatkowe informacje firmowe i metody wyszukiwania nie eliminują wszystkich zagrożeń bezpieczeństwa, takich jak te wynikające ze zmanipulowanych instrukcji w przetworzonych treściach. Dlatego warstwa semantyczna nie gwarantuje prawdziwości, bezpieczeństwa ani opłacalności.
Jego uzasadnione znaczenie strategiczne leży gdzie indziej. Może wspierać przejście od rozproszonej wiedzy opartej na doświadczeniu do jawnych, wielokrotnego użytku i rozliczalnych definicji biznesowych. Umożliwia to nie tylko sporadyczne wdrażanie sztucznej inteligencji, ale także stopniowe jej osadzanie w kontrolowanym systemie operacyjnym. Trwałym atutem nie jest zatem indywidualny asystent, ale zorganizowana zdolność do niezawodnego wykorzystania wiedzy firmy do nowych zadań.
Decydująca przewaga konkurencyjna nie wynika zatem z posiadania największej liczby autonomicznych agentów. Powstaje ona tam, gdzie firmy mogą szybciej rozpoznać, które informacje są prawidłowe, które wyjątki są istotne i które działania pozostają uzasadnione. Ci, którzy opanują ten fundament, mogą efektywniej wykorzystywać zmieniające się modele i narzędzia. Ci, którzy go zaniedbują, ryzykują przede wszystkim narastaniem własnych nieporozumień z każdym nowym zastosowaniem sztucznej inteligencji.
Doradztwo - Planowanie - Wdrażanie

Konrad Wolfenstein
Chętnie będę pełnić rolę Twojego osobistego doradcy.
Możesz się ze mną skontaktować pod adresem wolfenstein∂xpert.digital lub
Po prostu zadzwoń do mnie pod numer +49 7348 4088 965 .