Bien plus qu'un chatbot : comment une couche sémantique rend l'IA plus fiable en entreprise – Le facteur de succès sous-estimé de l'IA d'entreprise
Xpert Pré-lancement

Disponible en 27 langues 📢
Préférez Xpert.Digital sur GoogleⓘPublié le : 1er novembre 2026 / Mis à jour le : 1er novembre 2026 – Auteur : Konrad Wolfenstein
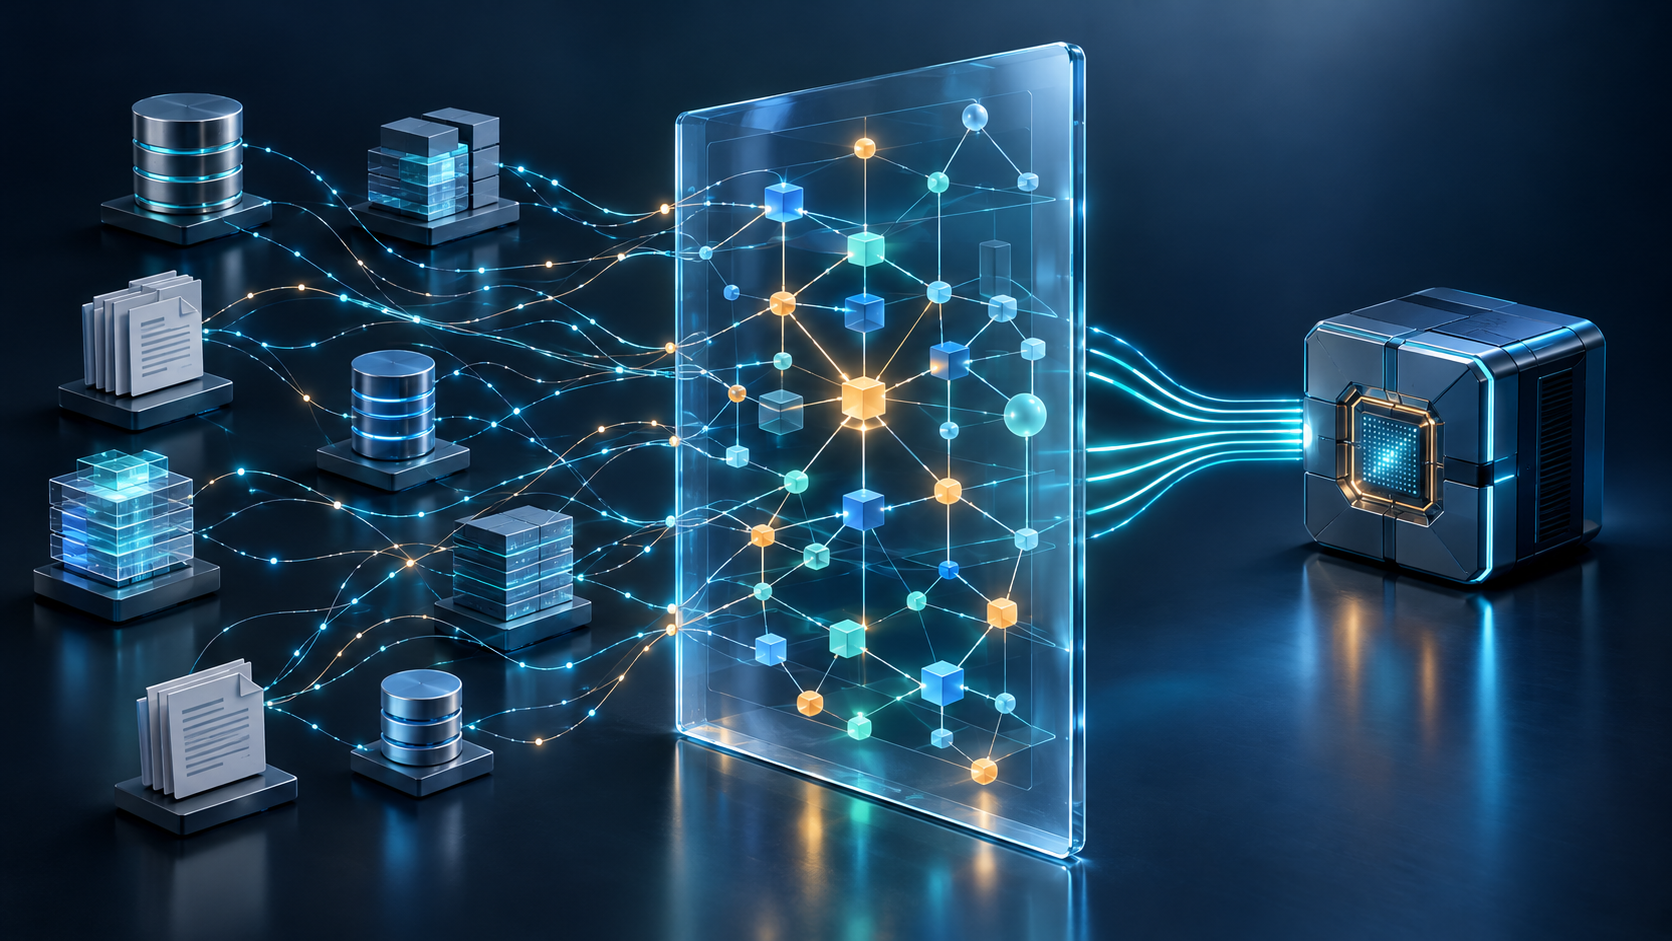
Bien plus qu'un chatbot : comment une couche sémantique renforce la fiabilité de l'IA en entreprise – Le facteur de succès sous-estimé de l'IA en entreprise – Une image créative sur le sujet, avec l'IA : Xpert.Digital
L'IA en entreprise : pourquoi une terminologie claire détermine la réussite économique
Quand l'IA accélère le chaos : Pourquoi les entreprises ont besoin de connaissances commerciales partagées
Moins de contradictions, de meilleures décisions : ce qu’une couche sémantique peut apporter aux entreprises
Les entreprises investissent dans l'intelligence artificielle pour accélérer leurs processus et prendre de meilleures décisions. Cependant, un modèle de langage performant ne garantit pas à lui seul le succès commercial. Si les services commerciaux, financiers et le service client interprètent différemment les termes clés, l'IA peut fournir des réponses contradictoires et propager les erreurs plus rapidement. Une couche sémantique vise à remédier à ce problème : elle rend les termes, les relations et les règles utilisables et compréhensibles dans diverses applications. Sa valeur réside non seulement dans l'amélioration des réponses, mais aussi dans la réduction des efforts de coordination et la réutilisation des connaissances de l'entreprise. Toutefois, une couche sémantique peut révéler les ambiguïtés organisationnelles, mais elle ne les résout pas à elle seule. Par conséquent, ce qui importe, c'est la manière dont les entreprises modélisent leur réalité métier, définissent les responsabilités professionnelles et mesurent les bénéfices concrets.
En lien avec ceci :
Couche sémantique pour l'IA d'entreprise : pourquoi la pertinence métier détermine le retour sur investissement de l'IA
Sans concepts clairs, l'IA automatise le chaos
Une couche sémantique permet de partager et de vérifier les termes, les relations et les règles métier pour les applications d'IA. Sa valeur économique réside donc non seulement dans l'amélioration des réponses, mais aussi dans la perspective d'une réduction des efforts de coordination, d'une réutilisation des connaissances métier et de décisions plus maîtrisables. Cependant, sa principale limite est qu'une telle couche sémantique peut révéler l'ambiguïté organisationnelle, mais ne peut la résoudre à elle seule.
Pour les entreprises, cela modifie la question stratégique. Il ne s'agit plus seulement de savoir quel modèle de langage est le plus efficace ou à quelle vitesse un nouvel assistant peut être développé. Ce qui devient primordial, c'est la réalité commerciale sur laquelle reposent ces systèmes. Si les services commerciaux, financiers et le service client utilisent un même terme de manière différente, une IA techniquement puissante peut diffuser des résultats contradictoires encore plus rapidement et plus largement. Le défi économique consiste à transformer des informations éparses en une base solide et durable pour la prise de décision.
L'écart entre l'utilisation et le résultat
L'adoption de l'IA progresse, mais son impact économique reste à démontrer. En 2025, 19,95 % des entreprises européennes interrogées, comptant au moins dix employés, utilisaient au moins une technologie d'IA, soit une hausse de 6,47 points de pourcentage par rapport à 2024. Des disparités importantes existent selon la taille des entreprises : 17 % pour les petites entreprises, 30,36 % pour les moyennes entreprises et 55,03 % pour les grandes entreprises. L'enquête a couvert un large éventail de technologies d'IA, de l'analyse de texte aux machines autonomes, mais ne s'est pas spécifiquement intéressée à l'IA générative ni aux couches sémantiques.
Une enquête internationale menée auprès d'entreprises en 2026 révèle une situation différente. Dans cette enquête, 80 % des répondants ont déclaré avoir amélioré leur productivité personnelle grâce à l'IA, tandis que 37 % ont indiqué une contribution positive à l'EBIT de leur entreprise. Seuls 6 % environ appartenaient à un groupe particulièrement performant, attribuant au moins 5 % de leur EBIT à l'IA et faisant simultanément état de bénéfices significatifs. L'enquête, menée auprès de 1 719 participants issus de 97 pays et basée sur des données autodéclarées, n'est donc pas directement comparable aux statistiques des entreprises européennes.
Ces chiffres ne démontrent pas un lien de causalité avec une couche sémantique. Ils illustrent plutôt le problème commercial : entre la simplification des tâches individuelles et la réussite commerciale mesurable se trouve un effort de traduction organisationnelle. C’est précisément à cette interface qu’une couche de signification partagée prend tout son sens.
L'importance devient partie intégrante de l'infrastructure opérationnelle
Une couche sémantique relie les structures de données techniques aux concepts métiers tels que client, contrat, réclamation ou chiffre d'affaires. Elle décrit, par exemple, les champs de données relatifs à un client, le mode de calcul d'un indicateur clé de performance (KPI) et les conditions d'application d'un statut spécifique. Ainsi, différentes applications peuvent s'appuyer sur des définitions communes au lieu d'interpréter les libellés des tables ou les documents.
Un exemple simple illustre les implications. Une entreprise pourrait définir un client actif pour les ventes par des échanges réguliers, pour la finance par des transactions commerciales enregistrées et pour le service après-vente par des demandes de service existantes. Aucune de ces perspectives n'est nécessairement fausse. Le problème survient lorsqu'une IA les mélange par inadvertance ou présente une perspective comme universellement valable.
La solution économiquement viable ne consiste donc pas toujours en une définition unique applicable à tous les cas. Souvent, plusieurs définitions claires, élaborées par des professionnels compétents et assorties de limites d'application précises sont nécessaires. Un cadre sémantique commun doit refléter les différences de manière maîtrisée, sans créer artificiellement une uniformité qui n'existe pas réellement au sein de l'entreprise. Son objectif est une interprétation compréhensible, et non une homogénéisation conceptuelle.
Du rapport à la décision opérationnelle
Les modèles sémantiques classiques de l'informatique décisionnelle se concentrent principalement sur les indicateurs clés, les dimensions, les agrégations et les relations entre les objets de données. Cependant, il serait réducteur de les priver totalement de logique métier ou de fonctions d'autorisation : les systèmes d'informatique décisionnelle existants, par exemple, prennent en charge les relations, les indicateurs clés calculés et l'accès aux données basé sur les rôles. Par conséquent, la frontière entre une couche sémantique d'informatique décisionnelle et une couche sémantique d'intelligence artificielle ne constitue pas une simple barrière technologique.
La principale différence réside dans les exigences. Un rapport, par exemple, doit refléter fidèlement le chiffre d'affaires. Une application d'IA opérationnelle, en revanche, doit également être capable de déterminer quel contrat appartient à un processus, quel accord spécifique prévaut et si l'étape suivante requiert une approbation. Cela transforme la tâche, passant d'une analyse classique à une aide à la décision contextuelle.
Sur le plan économique, cela accroît à la fois les avantages potentiels et les risques. Un rapport mal rédigé peut mener à une décision erronée. Un assistant opérationnel peut la mettre en œuvre immédiatement. Plus l'IA s'intègre aux commandes, aux paiements, aux engagements de prix ou aux décisions des clients, plus la distinction entre interprétation plausible et logique d'exécution contraignante devient cruciale.
Les quatre éléments constitutifs du savoir commercial
Une couche de signification complète pour l'IA d'entreprise doit prendre en compte quatre types de connaissances : les définitions d'entités, les relations, les règles de décision et les corrections collectées. Les définitions d'entités précisent ce qui constitue un objet métier, comme un client actif, un contrat critique ou un cas à haut risque. Les relations relient ces objets, par exemple une filiale à un compte ou un avenant au contrat principal correspondant.
Les règles de décision définissent les seuils, les exceptions, les responsabilités et les conditions d'approbation. Les corrections recensées indiquent les corrections apportées par les experts du domaine aux résultats erronés. Seule leur combinaison permet de dépasser le simple cadre d'une fonction de recherche pratique et d'établir une base transparente pour l'interprétation des informations et leur cadre d'application.
D'un point de vue économique, ces types de connaissances doivent être valorisés différemment. Une définition client peut être réutilisée dans de nombreuses applications. En revanche, une décision d'exception ne s'applique qu'à un contrat spécifique. Une bonne architecture doit donc non seulement stocker les connaissances, mais aussi en limiter la portée. Autrement, elle transforme une exception locale en règle générale et aggrave l'erreur même qu'elle est censée prévenir.
Pourquoi les documents sont essentiels à la gestion d'entreprise
Une couche sémantique pilotée par l'IA doit pouvoir relier non seulement les données structurées, mais aussi les contrats, les courriels, les rapports et les comptes rendus de réunion aux transactions commerciales correspondantes. La raison est évidente : une entrée de base de données peut contenir le prix standard convenu, tandis qu'un avenant approuvé stipule des conditions différentes. Quiconque se contente d'analyser l'ensemble de données risque de négliger cette exception, pourtant essentielle sur le plan économique.
La difficulté ne réside pas simplement dans la recherche d'une clause, mais dans la détermination de son statut. Un brouillon n'est pas un accord signé. Une note de réunion interne ne remplace pas une approbation. Un document ultérieur peut compléter, remplacer partiellement ou s'appliquer à un champ d'application différent d'une règle antérieure. Ces distinctions doivent être explicitement modélisées et examinées pour chaque cas d'utilisation spécifique.
Ceci nous amène à une perspective économique importante : la valeur de l’analyse documentaire ne se mesure pas au nombre de pages traitées. Elle n’apparaît que lorsqu’il est possible d’en tirer des conclusions fiables concernant les créances, les obligations, les échéances ou les plans d’action. À l’inverse, un résumé rapide sans vérification du contenu peut engendrer des coûts d’audit supplémentaires et créer un faux sentiment de sécurité.
Quatre sources de coûts dues à l'ambiguïté sémantique
L'impact économique peut être appréhendé à travers quatre catégories de coûts. Premièrement, les coûts de recherche surviennent lorsque les employés doivent collecter des informations et en comprendre la signification. Deuxièmement, les coûts de coordination apparaissent lorsque les services expliquent et harmonisent différentes analyses. Troisièmement, les coûts liés aux erreurs surviennent lorsque des classifications ou des règles incorrectes entraînent des reprises et des décisions erronées. Quatrièmement, les coûts de répétition surviennent lorsque chaque nouveau projet d'IA nécessite de développer à nouveau les mêmes fondements techniques.
Cette classification constitue un cadre d'évaluation analytique, et non une distribution des coûts mesurée empiriquement. Elle permet toutefois d'éviter une idée fausse courante : le retour sur investissement d'une couche sémantique ne doit pas dépendre uniquement de la rapidité de réponse d'un assistant. Une réponse peut apparaître en quelques secondes et s'avérer coûteuse si plusieurs spécialistes doivent ensuite en vérifier l'exactitude.
À l'inverse, une amélioration apparemment insignifiante peut générer une valeur considérable. Si une définition claire et contraignante simplifie la coordination entre les services financiers et commerciaux, les bénéfices peuvent se répercuter simultanément sur de nombreux rapports et décisions. Par conséquent, l'unité économique pertinente n'est pas toujours le dialogue individuel avec l'IA, mais bien l'ensemble du processus métier, y compris ses boucles de contrôle et de correction.
La réutilisation permet de réaliser des économies d'échelle
Des définitions communes des indicateurs clés de performance (KPI) permettent d'éviter les efforts de mise en œuvre redondants et de rendre la même logique métier accessible à travers différentes applications. Appliquée à une architecture d'IA plus large, cette approche constitue la promesse centrale de la scalabilité : les termes, relations et règles déjà publiés restent utilisables pour d'autres cas d'usage. La couche sémantique se transforme ainsi en un investissement potentiel pour l'infrastructure plutôt qu'en un composant de projet isolé.
La logique économique est similaire à celle d'une ressource partagée. Sa création initiale engendre des coûts, tandis que d'autres utilisateurs peuvent exploiter les composants existants. Toutefois, l'avantage ne se renforce que si les nouveaux cas d'usage présentent un chevauchement suffisant d'expertise. Un autre assistant du même secteur d'activité peut s'appuyer sur davantage de connaissances existantes qu'une application destinée à un domaine d'activité totalement différent.
Il serait donc illusoire d'espérer une baisse automatique des coûts à chaque nouveau projet d'IA. De nouveaux cadres juridiques, gammes de produits ou modèles économiques peuvent nécessiter des investissements importants. Les économies d'échelle fiables ne résident pas dans la gratuité des projets ultérieurs, mais plutôt dans le fait que les points déjà clarifiés n'ont pas besoin d'être réexaminés sans justification objective.
La productivité nécessite une évaluation objective
Une étude menée auprès de 5 172 employés du service client a révélé que l'accès à un assistant d'IA générative entraînait une augmentation moyenne d'environ 15 % du nombre de demandes clients résolues par heure. Cependant, cet effet était inégalement réparti : les employés les moins expérimentés et les moins qualifiés en ont davantage profité, tandis que les employés les plus expérimentés et les plus performants n'ont constaté que de légers gains de rapidité et, dans certains cas, une légère baisse de la qualité. L'étude démontre ainsi un impact concret sur la productivité au sein d'un environnement de travail spécifique, et non un simple retour sur investissement lié à une couche sémantique.
Cette distinction est cruciale pour l'évaluation économique. Une mise en œuvre réussie de l'IA ne révèle pas la part de succès attribuable au modèle de langage, à l'interface utilisateur, aux connaissances disponibles, à la formation ou aux flux de travail modifiés. Quiconque tire de ces données des promesses générales de retour sur investissement pour un seul composant architectural en dépasse le pouvoir explicatif.
Par ailleurs, le gain de temps de travail ne se traduit pas automatiquement par une réduction des coûts. Les avantages économiques apparaissent, par exemple, lorsqu'une entreprise gère une demande accrue, réduit les temps d'attente, évite les heures supplémentaires ou affecte des travailleurs qualifiés, souvent rares, à des tâches plus exigeantes. Sans ces changements, un gain de temps mesurable peut rester largement inexploité du point de vue de l'entreprise.
Un calcul de retour sur investissement incluant tous les coûts
Pour élaborer une stratégie commerciale viable, il convient d'abord d'analyser le processus actuel. Cela inclut le nombre de dossiers, les délais de traitement, les requêtes, les corrections, les remontées d'information et les conséquences des décisions erronées. Ensuite, il est nécessaire de déterminer quels facteurs sont susceptibles d'être influencés par une compréhension commune. Ce n'est qu'à cette condition que des discussions pertinentes sur l'étendue de l'investissement et les bénéfices attendus pourront avoir lieu.
Du côté des coûts, outre l'utilisation des logiciels et des modèles, il convient également de prendre en compte l'intégration du système, la modélisation des processus métier, la vérification d'identité, la gestion des accès, les tests et les mises à jour régulières. Le recours à des professionnels expérimentés, en particulier, représente une dépense supplémentaire non négligeable. Leur temps a une valeur économique et n'est pas disponible pour d'autres tâches pendant la mise en œuvre.
Une évaluation objective tient également compte des pertes et des incertitudes liées au démarrage. Dans un premier temps, une nouvelle application peut nécessiter des vérifications supplémentaires avant que les processus ne se stabilisent. Certains avantages ne se manifestent qu'avec l'expérience, tandis que d'autres ne se concrétisent pas. Par conséquent, une approche d'investissement progressive, assortie d'objectifs intermédiaires vérifiables, est souvent plus judicieuse qu'un investissement initial important dont la justification repose principalement sur des promesses de synergies futures.
La bonne mesure du succès
Le principal indicateur de performance est le coût économique par transaction commerciale correctement et conformément aux exigences. Cette perspective allie rapidité, qualité et contrôle. Elle permet d'éviter qu'un taux d'utilisation élevé ou un temps de réponse court ne soient considérés comme un succès si l'application engendre des retouches supplémentaires.
Il convient de distinguer différents types d'erreurs à des fins de mesure. Une mesure erronée diffère d'une exception contractuelle négligée. Une notification incomplète diffère d'une divulgation non autorisée de données. De même, il est essentiel de déterminer clairement si un système répond de manière fiable à une question, la transmet légitimement à un humain ou produit un résultat sans justification suffisante.
Une comparaison pertinente s'appuie sur des cas préalablement approuvés et prend en compte l'ensemble du processus. Pour les processus appropriés, des mises en œuvre progressives ou des groupes de comparaison contrôlés peuvent aider à distinguer les améliorations techniques des changements généraux. L'analyse doit également inclure les exceptions rares mais économiquement significatives. Un système qui gère bien les cas courants mais néglige les exceptions critiques peut sembler convaincant en moyenne, tout en étant inacceptable en pratique.
La recherche vectorielle ne remplace pas un engagement contraignant
Les bases de données vectorielles facilitent la recherche de textes similaires en rendant l'information comparable grâce à des représentations numériques appelées plongements lexicaux. Les systèmes modernes peuvent également utiliser des filtres de métadonnées, la recherche par mots-clés et des méthodes de recherche combinées. Il serait donc erroné de les présenter comme des référentiels fondamentalement décontextualisés et dépourvus de capacités de filtrage.
Sa fonction principale, cependant, répond à une question différente de celle de la gouvernance opérationnelle. La similarité de fond n'indique pas automatiquement si un document est à jour, juridiquement contraignant ou applicable à un cas particulier. Un système de recherche peut prendre en compte ces propriétés si elles sont stockées de manière fiable et correctement intégrées à la requête. Toutefois, il ne détermine pas à lui seul les décisions commerciales nécessaires.
Cela induit une logique d'investissement claire pour les entreprises. L'amélioration de la recherche et l'enrichissement des informations peuvent se compléter. Toutefois, l'augmentation des résultats de recherche ne saurait remplacer des responsabilités et des règles clairement définies. Ceux qui tentent de corriger systématiquement toute réponse erronée par le seul biais d'un index de recherche plus performant risquent de fournir davantage de contenu sans en vérifier la pertinence.
🤖🚀 Plateforme d'IA gérée : Accédez à des solutions d'IA plus rapides, plus sûres et plus intelligentes avec UNFRAME

Plateforme d'IA gérée - Image : Xpert.Digital
Vous découvrirez ici comment votre entreprise peut mettre en œuvre des solutions d'IA personnalisées rapidement, en toute sécurité et sans barrières à l'entrée élevées.
Une plateforme d'IA managée est votre solution clé en main pour l'intelligence artificielle. Fini les technologies complexes, les infrastructures coûteuses et les longs processus de développement : vous bénéficiez d'une solution clé en main, adaptée à vos besoins, fournie par un partenaire spécialisé – souvent en quelques jours seulement.
Les principaux avantages en un coup d'œil :
⚡ Mise en œuvre rapide : De l’idée à l’application prête à l’emploi en quelques jours, et non en plusieurs mois. Nous fournissons des solutions pratiques qui créent une valeur ajoutée immédiate.
🔒 Sécurité maximale des données : Vos données sensibles restent chez vous. Nous garantissons un traitement sécurisé et conforme à la réglementation, sans partage de données avec des tiers.
💸 Aucun risque financier : vous ne payez que pour les résultats. Les investissements initiaux importants en matériel, logiciels ou personnel sont totalement éliminés.
🎯 Concentrez-vous sur votre cœur de métier : nous prenons en charge l’intégralité de la mise en œuvre technique, de l’exploitation et de la maintenance de votre solution d’IA.
📈 Évolutif et à l'épreuve du temps : votre IA évolue avec vous. Nous assurons une optimisation et une évolutivité continues, et adaptons les modèles avec souplesse aux nouveaux besoins.
Plus d'informations ici :
L'influence des documents sur les décisions commerciales
Les graphes de connaissances peuvent faire bien plus que de simples liens
Un graphe de connaissances représente les entités et leurs relations au sein d'une structure en réseau et peut donc constituer un élément important d'une couche sémantique. Par ailleurs, les ontologies formelles et les méthodes qui en découlent peuvent également prendre en charge les inférences logiques ; les normes établies comme OWL ne se limitent pas au simple stockage des connexions de base. Affirmer catégoriquement qu'un graphe de connaissances ne peut par principe pas représenter de règles serait donc techniquement inexact.
La question cruciale est plutôt de savoir quelles fonctionnalités une solution spécifique combine réellement. Un graphe contenant des objets d'entreprise ne possède pas automatiquement une gestion complète des droits, un contrôle des processus éprouvé ou une gestion des cas particuliers approuvée par des professionnels. En revanche, une architecture de graphe bien conçue peut répondre à une part importante de ces exigences.
Il convient donc de considérer la couche sémantique moins comme un produit nécessairement autonome que comme un ensemble de fonctions requises. Certaines entreprises peuvent couvrir une grande partie de ces fonctions grâce à leurs modèles de BI, catalogues de données, systèmes de graphes et ensembles de règles existants. D'autres ont besoin d'une plateforme supplémentaire. Ce qui importe sur le plan économique, c'est le manque de fonctionnalités avéré, et non le nombre de nouvelles catégories de produits.
Connectez-vous au lieu de tout sauvegarder à nouveau
Une couche sémantique permet de connecter les systèmes ERP et CRM existants, les plateformes de données et les référentiels documentaires sans qu'il soit nécessaire de migrer au préalable toutes les données de l'entreprise vers un emplacement de stockage unique. Les modèles sémantiques des indicateurs clés de performance (KPI) peuvent également s'appuyer sur les structures de données existantes et en déduire la logique de requête appropriée. La signification partagée est donc fondamentalement distincte du stockage physique des données.
Toutefois, cela ne signifie pas qu'une telle architecture puisse fonctionner sans aucune copie de données. Les index de recherche, les informations extraites des documents, les caches ou les résultats précalculés peuvent s'avérer utiles dans certains cas. La question essentielle pour l'entreprise est de savoir quelles informations doivent être stockées, où et pendant combien de temps, et non de savoir si la promesse d'une protection totale contre la copie est commercialisable.
Un système bien conçu équilibre la rapidité, le temps de réponse, la disponibilité, les coûts et la confidentialité des données. Les exigences de rapidité peuvent différer selon qu'il s'agit de l'état d'un stock ou d'une clause contractuelle. Une requête répartie entre plusieurs systèmes sources offre une certaine flexibilité, mais accroît également la dépendance à leur disponibilité. Par conséquent, la meilleure solution n'est pas nécessairement la plus centralisée ni la plus distribuée, mais plutôt celle qui est adaptée au processus métier.
La qualité des données demeure une tâche distincte
L'existence d'une couche de signification partagée ne corrige pas automatiquement les données sources erronées. Même les fournisseurs de systèmes de requêtes sémantiques recommandent de traiter au plus tôt les problèmes de cohérence fondamentaux, tels que la normalisation des objets communs et le nettoyage des données inappropriées. La sémantique métier et la qualité des données sont complémentaires ; ce ne sont pas des tâches interchangeables.
Un exemple particulièrement parlant est celui de l'identité d'un partenaire commercial. Différentes orthographes peuvent désigner le même fournisseur. Cependant, des noms similaires peuvent également appartenir à des entités juridiques distinctes. Une fusion hâtive de ces entités peut alors entraîner une attribution erronée des informations de paiement, des données de solvabilité ou des relations contractuelles. Une architecture de données efficace doit donc permettre de distinguer les attributions confirmées de celles qui ne reposent que sur une hypothèse plausible.
Ceci est économiquement important car les erreurs ne sont pas toujours visibles à leur origine. Une identification erronée peut ultérieurement influencer de nombreuses analyses et décisions. Par conséquent, la mise en œuvre doit se concentrer non seulement sur la qualité des réponses individuelles, mais aussi sur l'attribution fiable des objets sous-jacents. Autrement, la réutilisation ne fait qu'accroître la quantité de connaissances, mais aussi celle des erreurs qui y sont associées.
Les règles doivent devenir techniquement effectives
Une politique énoncée dans un document ne constitue pas un contrôle effectif. Pour les applications d'IA, les concepts de sécurité distinguent clairement les exigences linguistiques des mesures techniques telles que les fonctions restreintes, les permissions limitées et les conditions d'exécution vérifiables. Une autonomie excessive et des droits d'accès trop étendus, en particulier, peuvent conduire à des résultats de modèles erronés ou manipulés, déclenchant ainsi des actions malveillantes.
Une architecture robuste doit donc séparer l'interprétation et l'exécution. Le modèle de langage peut, par exemple, classifier un processus ou suggérer une action. Dans les processus critiques, la vérification de l'exactitude d'un calcul, l'obtention d'une autorisation ou la possibilité d'effectuer une réservation doivent être assurées par une logique vérifiable et les systèmes responsables.
Cela dissipe une idée fausse courante. Une couche sémantique peut fournir le socle métier d'un comportement conforme aux règles. Cependant, elle ne garantit pas, à elle seule, qu'un modèle de langage probabiliste appliquera systématiquement chaque règle. La solution économiquement viable résulte de l'interaction entre le sens, les permissions, les tests, les contrôles de processus et des actions clairement définies.
Les autorisations font partie du sens
Lors de l'accès aux connaissances de l'entreprise, il est essentiel de vérifier non seulement la pertinence des informations, mais aussi les autorisations d'accès. Les contrôles d'accès aux documents permettent de restreindre les résultats de recherche en fonction de l'identité de l'utilisateur et des droits qui lui sont attribués ; leur efficacité dépend notamment de la synchronisation correcte des informations d'autorisation. Une base de connaissances partagée ne signifie donc pas que chaque utilisateur a accès au même contenu.
En pratique, la dimension temporelle est cruciale. Un employé peut changer de poste, un projet peut se terminer ou un document peut être soumis à des restrictions d'accès. Si la couche de recherche et de contexte utilise des autorisations obsolètes, elle risque d'afficher du contenu qui n'est plus accessible dans le système source. Par conséquent, la gestion des autorisations doit être explicitement intégrée aux coûts opérationnels.
Même des questions au contenu similaire peuvent, à juste titre, recevoir des réponses différentes. Deux utilisateurs peuvent avoir des responsabilités différentes ou accéder à des ensembles de données distincts. La cohérence ne signifie donc pas une formulation identique, mais plutôt l'application des mêmes règles professionnelles dans un contexte comparable. Un écart ne constitue un problème de qualité que s'il ne peut être expliqué par le temps, le rôle, la disponibilité des données ou la question elle-même.
Les corrections nécessitent un processus structuré
La capture des corrections des utilisateurs est l'un des éléments de connaissance prévus pour une couche sémantique orientée IA. En matière de gestion des risques liés à l'IA, l'étude des modifications apportées par les utilisateurs et de leurs causes est également considérée comme une source d'information précieuse pour l'évaluation des systèmes déployés. Toutefois, cela ne signifie pas que chaque modification apportée par un utilisateur doive automatiquement devenir une règle générale.
Un résultat corrigé peut avoir des causes très diverses. Il se peut qu'une donnée ait été mal attribuée, qu'une exception contractuelle se soit appliquée, que la règle interne de l'entreprise soit obsolète ou que l'utilisateur ait simplement indiqué une préférence personnelle. Ces cas requièrent des réponses différentes et ne doivent pas être intégrés sans discernement dans une base de connaissances partagée.
Un processus d'apprentissage économiquement viable considère initialement les retours d'information comme des suggestions vérifiables. Les experts du domaine déterminent leur portée, leur caractère contraignant et les tests nécessaires. Ce n'est qu'ensuite qu'une modification approuvée est mise à disposition pour d'autres applications. Cela ne nécessite pas forcément de réentraîner le modèle de langage. L'essentiel est d'éviter l'erreur dans le contexte approprié à l'avenir, sans en introduire involontairement de nouvelles ailleurs.
Le versionnage protège contre les fausses interprétations rétrospectives
Les définitions et règles métier évoluent ; par conséquent, une couche sémantique doit gérer les versions des modifications et les soumettre à l’approbation d’experts du domaine. Les plateformes sémantiques existantes prennent déjà en charge les définitions versionnées ou les requêtes de référence validées, en précisant la date et l’auteur de leur validation. Un historique traçable n’est donc pas un simple ajout, mais une composante essentielle d’une utilisation contrôlée.
Pour un examen ultérieur, la règle actuellement en vigueur est toutefois insuffisante. Il convient également de prendre en compte la version applicable au moment de la transaction et les informations que le système était en mesure de traiter à ce moment-là. Un avenant au contrat reçu ultérieurement ne doit pas servir de base à l'évaluation d'une décision antérieure. Autrement, une illusion de clarté pourrait apparaître a posteriori, alors qu'elle n'existait pas au moment de la décision.
Les entreprises devraient donc considérer conjointement l'historique des règles, les versions des documents et l'état des données. L'intérêt réside moins dans le gain de temps que dans la réduction des coûts de résolution des litiges. Ceux qui sont capables de reconstituer le fondement d'une décision consacrent moins de temps à le reconstituer à partir de courriels, de fichiers individuels et de rappels ultérieurs.
La liberté de conception n'implique pas encore la liberté de fournisseur
Les connaissances de l'entreprise doivent être organisées de manière à ce qu'une modification du modèle de langage n'entraîne pas automatiquement une refonte complète des fondements métiers. Cet argument stratégique est étayé par des données techniques : entre novembre 2022 et octobre 2024, le coût des requêtes de modèle a été divisé par plus de 280, pour un niveau de performance comparable à celui de GPT-3.5. Cette comparaison se réfère à un niveau de référence spécifique et ne doit pas être interprétée comme une réduction équivalente du coût global d'une application d'entreprise.
Néanmoins, la conclusion est plausible : lorsque les performances et les prix d’un modèle évoluent significativement, la possibilité de changer de modèle devient de plus en plus précieuse. Un modèle technique utilisable en permanence peut éviter que chaque mise à niveau technologique n’entraîne un effort considérable de conversion technique. L’indépendance du modèle acquiert ainsi le caractère d’une option stratégique.
Toutefois, cela n'élimine pas toutes les dépendances. Les définitions peuvent rester liées à des formats, interfaces ou modèles d'exploitation propriétaires. Par conséquent, une entreprise doit évaluer séparément sa capacité à changer de modèle de langage, exporter ses définitions de connaissances et continuer à utiliser l'intégralité de la solution avec un autre fournisseur. Seule cette distinction permet une évaluation réaliste des coûts de migration et un pouvoir de négociation optimal.
Le marché se développe ensemble
Des définitions sémantiques sont désormais explicitement proposées pour la BI et l'IA : Snowflake relie les indicateurs métier et les relations entre entités aux requêtes et aux agents, tandis que dbt fournit également ses indicateurs définis de manière centralisée via des interfaces pour les outils d'IA. Parallèlement, l'Open Semantic Interchange (OSI) a vu le jour comme une initiative visant à faciliter l'échange indépendant des fournisseurs de métadonnées sémantiques. Le projet a été accepté dans l'incubateur Apache en 2026 sous le nom d'Apache Ossie.
Cette évolution est plus significative sur le plan économique qu'une simple annonce de produit. Si plusieurs outils peuvent utiliser les mêmes définitions, la nécessité de créer une nouvelle logique métier dans chaque application s'en trouve considérablement réduite. Parallèlement, les plateformes de données existantes peuvent prendre en charge une part plus importante de la création de valeur, auparavant assurée par des solutions complémentaires spécialisées.
Pour les clients, cela signifie qu'avant tout nouvel achat, un inventaire doit être réalisé. Les modèles de données existants, les catalogues d'indicateurs clés de performance (KPI), les systèmes d'autorisation et les interfaces peuvent répondre à certaines exigences. Les formats d'échange ouverts sont utiles à cet égard, mais ne constituent pas une garantie absolue d'efficacité. Leur pertinence doit être évaluée en fonction de la possibilité de transférer les définitions, les règles et les informations contextuelles entre les systèmes réellement utilisés sans perte de sens.
La structure de connaissances Unframe, vue objectivement
Unframe regroupe ses fonctions sémantiques sous le nom de Knowledge Fabric, reliant les concepts d'entreprise, la logique métier, les relations et les permissions. Cette approche vise à rendre les ensembles de données structurés et le contenu documentaire exploitables pour des cas d'usage spécifiques et à enrichir progressivement la base de connaissances. La solution est également proposée avec différents modèles de langage et une intégration aux systèmes d'entreprise existants.
L'intérêt économique de ce concept réside dans la combinaison de tâches auparavant distinctes. Si l'intégration des systèmes, le contexte métier et le contrôle d'utilisation sont bien coordonnés, les efforts requis pour les applications supplémentaires peuvent être réduits. Cependant, la simple dénomination de l'architecture ne permet pas de déduire si cet avantage se concrétisera au sein d'une entreprise donnée. Des résultats vérifiables issus des processus propres à l'entreprise sont indispensables.
Parallèlement, la question de la propriété et de l'exploitation demeure pertinente : Unframe distingue d'une part les données, les résultats et les configurations de solutions appartenant au client, et d'autre part la plateforme Knowledge Fabric et les autres composants exploités par le fournisseur. Par conséquent, la liberté de choix concernant le modèle ne saurait être assimilée à une indépendance totale vis-à-vis de la plateforme. Pour une évaluation fiable, les options d'exportation, les droits sur les définitions techniques et la continuité du système en cas de changement d'opérateur doivent être clairement définis.
Commencez petit, restez adaptable
Une approche orientée application limite la portée de la modélisation et permet de valider les définitions avec les experts métiers concernés à l'aide de cas concrets. Au lieu de cartographier immédiatement l'ensemble de l'entreprise, on identifie d'abord les systèmes, objets, relations et règles nécessaires à un processus clairement défini. Les composants validés peuvent ensuite être étendus pour inclure des cas d'utilisation connexes.
D'un point de vue économique, un processus comportant des répétitions fréquentes, des résultats vérifiables et des problèmes de coordination suffisamment importants est particulièrement adapté. Un cas d'utilisation trop simple pourrait se limiter à démontrer qu'une fenêtre de chat peut être connectée à une source de données. À l'inverse, une introduction trop complexe risque de générer tellement de cas particuliers non résolus que les avantages ne se manifesteront qu'après un long délai.
Le juste équilibre réside entre un périmètre limité et une base réutilisable. Un projet pilote ne doit pas se réduire à un prototype jetable. Parallèlement, son potentiel d'intégration ne doit pas servir de prétexte pour élaborer un modèle économique complet avant même d'avoir constaté la première amélioration tangible. L'objectif principal reste d'identifier les éléments techniques réellement nécessaires à la prochaine étape significative.
L'acceptation relève de la responsabilité professionnelle
L'introduction de l'IA ne transfère pas la responsabilité des humains vers les logiciels. Toute définition fondamentale requiert une autorité compétente capable d'évaluer et d'approuver les modifications. Même les cadres généraux pour une IA digne de confiance insistent sur la définition claire des rôles et responsabilités humaines dans la gestion des systèmes d'IA. Par conséquent, l'exploitation technique et l'expertise ne doivent pas être tacitement attribuées à une seule et même fonction.
Cela peut s'avérer problématique sur le plan organisationnel. Une définition partagée du chiffre d'affaires, de l'affiliation client ou du risque peut impacter les systèmes cibles, les responsabilités et les pratiques d'évaluation existantes. Une couche sémantique met en évidence ces différences. Elle ne les résout pas par une élégance technique, mais oblige plutôt à prendre des décisions qui auraient pu être évitées auparavant.
C’est là aussi que réside sa valeur à long terme. Lorsque les concepts et les règles ne sont plus cantonnés à l’esprit de chaque employé ni dispersés dans diverses applications, l’entreprise peut devenir moins dépendante des monopoles informels du savoir. Toutefois, cet avantage suppose que les spécialistes participent au processus de conception et perçoivent cette dimension sémantique comme un atout. Si elle est introduite uniquement comme un instrument de contrôle, la volonté de contribuer par une précieuse expérience pratique risque de diminuer.
Toutes les entreprises n'ont pas besoin du même niveau de profondeur
Les données d'utilisation en Europe révèlent des différences significatives dans l'ampleur du déploiement de l'IA, sans pour autant indiquer un besoin d'architecture spécifique. Par ailleurs, parmi les entreprises qui avaient envisagé d'utiliser l'IA mais ne l'avaient pas encore fait en 2025, 70,89 % ont invoqué un manque d'expertise pertinente comme raison de leur inaction ; 52,52 % ont évoqué des conséquences juridiques incertaines et 48,83 % des préoccupations liées à la protection des données. Ces chiffres concernent spécifiquement ce sous-groupe et non l'ensemble des entreprises.
Cela permet de développer une perspective d'investissement différenciée. Une petite entreprise dotée de peu de systèmes et de processus gérables peut initialement se contenter d'indicateurs clés de performance (KPI) cohérents et de bases de connaissances clairement tenues à jour. En revanche, une grande entreprise avec de nombreuses filiales, gammes de produits et rôles d'accès peut tirer profit d'une infrastructure sémantique plus complète. Le niveau de détail approprié dépend de la complexité et du risque, et non de l'attrait d'un terme technologique particulier.
Renoncer à certaines tâches peut également s'avérer judicieux sur le plan économique. Si une tâche est peu fréquente, sans conséquences majeures et peut être réalisée de manière fiable grâce à une procédure simple, les coûts de maintenance d'une couche supplémentaire peuvent être supérieurs à ses avantages. Une approche architecturale convaincante doit donc également pouvoir expliquer dans quels cas elle n'est pas nécessaire.
Importance maîtrisée comme avantage concurrentiel
L'IA générative peut présenter de manière convaincante un contenu erroné ; ce risque figure parmi les caractéristiques et dangers explicitement décrits de tels systèmes. Même des informations supplémentaires sur l'entreprise et des méthodes de recherche avancées ne permettent pas d'éliminer tous les risques de sécurité, notamment ceux liés à la manipulation d'instructions dans le contenu traité. Par conséquent, une couche sémantique ne garantit ni la véracité des informations, ni leur sécurité, ni leur rentabilité.
Son importance stratégique justifiée réside ailleurs. Elle peut faciliter la transition d'un savoir-faire empirique dispersé à des définitions métier explicites, réutilisables et traçables. Cela permet non seulement de déployer l'IA de manière sporadique, mais aussi de l'intégrer progressivement dans un système opérationnel maîtrisé. L'atout durable n'est alors plus l'assistant individuel, mais la capacité organisée à exploiter efficacement le savoir-faire de l'entreprise pour de nouvelles tâches.
L'avantage concurrentiel décisif ne réside donc pas dans le nombre d'agents autonomes, mais dans la capacité des entreprises à identifier rapidement les informations valides, les exceptions pertinentes et les actions justifiables. Celles qui maîtrisent ces fondamentaux peuvent exploiter plus efficacement l'évolution des modèles et des outils. Celles qui les négligent risquent surtout d'amplifier leurs propres erreurs d'interprétation à chaque nouvelle application d'IA.
Conseil - Planification - Mise en œuvre

Konrad Wolfenstein
Je serais heureux de vous servir de conseiller personnel.
wolfenstein∂xpert.digitalmeVous pouvez contacter à ou
Appelez-moi simplement au +49 7348 4088 965 .