Aleph Alpha et Kolibri-1 : le retour de l’Allemagne en IA entre efficacité, dépendance et nouveau bloc de pouvoir – une image créative sur le sujet, avec l’IA : Xpert.Digital
78 milliards de paramètres et toujours aussi performant : Kolibri-1 sous les projecteurs
Allemand et anglais : Kolibri-1 comme facteur de différenciation économique
Du chatbot à l'automatisation des processus : le développement de Kolibri-1
Avec le lancement de Kolibri-1, Aleph Alpha présente un modèle d'IA innovant, non seulement adapté aux besoins des entreprises allemandes, mais également susceptible de devenir une référence internationale. Contrairement aux autres grands modèles linguistiques, souvent dominés par des entreprises américaines ou chinoises, Kolibri-1 vise à fournir une solution d'IA contrôlable et performante, particulièrement adaptée aux données sensibles et aux documents complexes. Son orientation vers l'allemand et l'anglais, ainsi que son intégration aux processus métier existants, pourraient s'avérer cruciales pour de nombreuses organisations, notamment sur un marché en quête croissante de solutions à la fois performantes et sécurisées. Dès lors, la question se pose de savoir si Kolibri-1 n'est qu'une simple expérimentation technologique ou la pierre angulaire d'une nouvelle ère pour le développement de l'IA en Europe. Les défis et les opportunités que présente ce modèle sont analysés en détail dans les sections suivantes.
78 milliards de paramètres – et pourtant, au final, ce n’est pas le modèle qui décide, mais l’infrastructure
Un modèle comme signal de politique économique
Avec Kolibri-1, Aleph Alpha renoue avec un domaine que l'entreprise d'Heidelberg semblait avoir largement délaissé : le développement de modèles linguistiques vastes et à usage général. Cependant, ce nouveau système ne se contente pas de reproduire les modèles américains ou chinois. Il est conçu comme une plateforme germano-anglaise spécialisée pour les entreprises, les administrations publiques et les secteurs réglementés. Ainsi, Kolibri-1 vise moins le grand public des chatbots gratuits qu'un marché commercialement attractif, mais moins accessible : l'IA pilotable pour les données sensibles, les documents volumineux, les bases de connaissances internes, les processus industriels et les flux de travail multi-agents.
Cette publication ne doit donc pas être perçue uniquement comme un événement technique. Elle aborde trois questions économiques clés de la stratégie européenne en matière d'IA. Premièrement, elle interroge la capacité des fournisseurs européens à développer des modèles de base technologiquement indépendants sans devenir dépendants des grandes plateformes américaines et chinoises. Deuxièmement, elle soulève la question de la viabilité économique d'un modèle performant et accessible à tous. Troisièmement, la rentabilité ne dépend pas du nombre de paramètres, mais de la capacité des entreprises à exploiter le modèle en toute sécurité à un coût raisonnable, à l'intégrer à leurs processus existants et à le maintenir à jour en permanence.
Kolibri-1 arrive sur le marché dans un contexte favorable. Les dépenses allemandes en intelligence artificielle devraient atteindre 28,7 milliards d'euros en 2026, soit une croissance d'environ 48 % par rapport à l'année précédente. L'IA générative représente déjà près de 11,5 milliards d'euros, soit environ 40 % du marché total. Pourtant, son application concrète au sein des entreprises allemandes reste bien moins répandue que ne le laissent supposer les investissements importants. Seule une minorité d'entreprises offre à ses employés un accès direct aux applications d'IA générative. Les PME, en particulier, hésitent en raison des coûts, des préoccupations liées à la confidentialité des données, du manque de personnel qualifié et du manque de clarté des procédures d'intégration.
Cela crée un manque sur le marché. Les entreprises souhaitent utiliser une IA performante, mais refusent de transférer des informations sensibles vers des plateformes externes sans vérification. Elles ont besoin de modèles opérationnels transparents, de flux de données contrôlables, d'une qualité en langue allemande et de concepts de déploiement juridiquement solides. C'est précisément là qu'intervient Kolibri-1. Ce modèle représente donc moins une attaque contre les chatbots les plus populaires qu'une offre aux organisations qui souhaitent construire leur propre infrastructure d'IA pour des raisons réglementaires, stratégiques ou économiques.
Activation économique plutôt que petite architecture
Kolibri-1 comprend environ 78,1 milliards de paramètres. Ce nombre peut paraître important et, par conséquent, coûteux. En réalité, le système fonctionne selon une architecture à expertise mixte. Cela signifie que tous les paramètres ne sont pas activés à chaque étape de traitement. Un routeur détermine quels sous-réseaux spécialisés sont responsables du jeton correspondant. Sur les 78,1 milliards de paramètres, seuls 3,46 milliards environ sont actifs par jeton, soit environ 4,4 % de la capacité totale.
L'architecture se compose de 50 couches de transformateurs. Chaque couche compte 384 experts spécialisés. Un expert commun est toujours actif, tandis que six autres sont activés en fonction du contenu du jeton correspondant. Le concept sous-jacent est économiquement avantageux : le modèle possède la capacité de connaissances et de spécialisation d'un très grand système, tout en ne nécessitant qu'une fraction des opérations de calcul habituelles pour une seule étape. Ceci permet des améliorations fondamentales en termes de débit et de coûts d'exploitation par rapport à un modèle dense de taille globale similaire.
Cette efficacité ne doit cependant pas être confondue avec de faibles besoins en mémoire. Toutes les pondérations du modèle doivent rester disponibles en mémoire, car le routeur peut activer différents experts en fonction des données d'entrée. La variante FP8 requiert environ 78 gigaoctets de mémoire graphique pour les seules pondérations. De la mémoire supplémentaire est nécessaire pour le contexte (le cache KV), les calculs temporaires, la parallélisation et l'environnement d'exécution. Par conséquent, la configuration minimale recommandée est de deux GPU A100 de 80 gigaoctets chacun, deux GPU H100 SXM5 ou un seul GPU H200, B200 ou B300. Pour un fonctionnement stable en production, des configurations plus puissantes ou redondantes sont conseillées.
Ceci met en lumière la tension centrale inhérente à Kolibri-1. L'effort de calcul par jeton est relativement faible, mais l'accès au matériel nécessaire reste coûteux en capital. Pour une entreprise disposant déjà d'une infrastructure GPU, le modèle peut s'avérer économiquement avantageux. Cependant, pour une PME ne possédant pas son propre cluster d'IA, l'hébergement direct est rarement la solution la plus rentable. Dans ce cas, les services d'hébergement géré, les services de cloud souverain ou les plateformes sectorielles sont susceptibles de jouer un rôle déterminant.
L'avantage économique d'une architecture experte n'est donc pas automatique. Il dépend d'une utilisation intensive. Un GPU coûteux ne traitant que des requêtes occasionnelles reste non rentable, même avec un modèle performant. Plus le nombre d'utilisateurs, de processus documentaires et d'applications multi-agents regroupés sur une infrastructure partagée est élevé, meilleure est la répartition des coûts fixes. Pour les opérateurs de centres de données, les fournisseurs de cloud et les grandes entreprises, Kolibri-1 est donc nettement plus attractif que pour les PME à faible utilisation.
Un million de jetons ne constitue pas un laissez-passer gratuit
L'une des caractéristiques clés de Kolibri-1 est sa capacité à traiter des entrées très longues. L'entraînement initial a été réalisé avec des séquences de 16 384 jetons. Lors d'une phase d'entraînement ultérieure, la longueur a été portée à 65 536 jetons. La phase finale, en contexte long, a été menée avec 262 144 jetons. Cette longueur est considérée comme le contexte natif du modèle. Techniquement, le système peut être étendu au-delà sans mise à l'échelle positionnelle ultérieure. La qualité et la disponibilité ont été vérifiées jusqu'à 1 048 576 jetons.
Selon la langue, le format et la tokenisation, un million de tokens peuvent représenter plusieurs milliers de pages de texte. Ceci ouvre la voie à des applications pour les entreprises qui ne sont possibles que de façon limitée avec les chatbots traditionnels. Il s'agit notamment de l'analyse de contrats volumineux, de manuels techniques, de documentation de maintenance, de collections juridiques, d'archives de recherche, de documents fournisseurs et de bases de connaissances internes. Les audits préalables complexes, les analyses d'appels d'offres, les comparaisons de conformité et l'évaluation de volumineux dossiers sont également simplifiés.
Cependant, d'un point de vue économique, ce n'est pas seulement la longueur maximale du contexte qui importe, mais le coût par information traitée de manière pertinente. Un contexte très long accroît la consommation de mémoire du cache de la logique de calcul (CLU), allonge les temps de réponse et peut réduire considérablement le débit. De plus, une fenêtre de contexte étendue ne garantit pas que le modèle trouvera systématiquement toutes les informations pertinentes, les pondérera correctement et les traitera de manière cohérente. Plus l'entrée est longue, plus le risque de perdre des détails cruciaux noyés dans des passages non pertinents est élevé.
Par conséquent, la plage d'utilisation économiquement viable est souvent inférieure au maximum technique. Pour les tâches complexes et les applications critiques en termes de latence, il est recommandé de ne pas dépasser 262 144 jetons. Dans de nombreuses applications d'entreprise, un contexte nettement plus restreint, associé à une génération augmentée par la recherche, reste plus efficace. Dans cette approche, tous les documents disponibles ne sont pas chargés simultanément dans le modèle. Un système de recherche sélectionne d'abord les sections présumées pertinentes et ne transmet que celles-ci au modèle de langage.
Kolibri-1 ne remplace pas RAG. Son large champ d'application contextuel élargit plutôt le champ des architectures hybrides. Par exemple, une entreprise peut d'abord effectuer une recherche sémantique dans des milliers de documents, puis charger plusieurs centaines de pages pertinentes dans le contexte et laisser le modèle générer une analyse raisonnée à partir de ces données. La valeur ajoutée réside dans la combinaison de la recherche, de la compréhension des documents, de l'attribution des sources, de la structuration des résultats et de la validation humaine. À l'inverse, l'intégration indiscriminée de l'intégralité des données dans le modèle risque d'entraîner des coûts élevés pour des enseignements limités.
L'allemand devient un facteur de différenciation économique
La véritable valeur stratégique de Kolibri-1 réside dans son orientation constante vers l'allemand et l'anglais. Environ 62,5 % du matériel de formation de base est composé de contenu en anglais, environ 23,9 % de textes en allemand et environ 13,6 % de code source. Lors des phases de formation ultérieures, des données d'instruction, des exercices de raisonnement, des processus multi-agents, du contenu thématique et des documents longs ont été intégrés. La phase de pré-formation a nécessité 20 000 milliards de jetons. 3 440 milliards de jetons supplémentaires ont été utilisés lors de la phase de formation intermédiaire, et 201 milliards de jetons ont été investis dans l'élargissement du contexte.
La composante allemande est significative par rapport aux autres langues. Si de nombreux modèles globaux peuvent générer un allemand fluide, ils ont été principalement entraînés sur des données anglaises. Cela a un impact particulier sur les nuances juridiques, le langage administratif, les termes techniques composés, les expressions régionales et les types de textes spécifiques à un secteur. Kolibri-1 utilise son propre tokenizer avec 128 000 entrées, qui prend davantage en compte la morphologie et la formation des mots composés de la langue allemande. Cela permet un traitement plus compact et plus efficace des textes allemands.
Cette caractéristique technique a des implications économiques directes. Un nombre réduit de jetons par document allemand permet de diminuer les besoins de stockage, le temps de traitement et, par conséquent, les coûts. Toutefois, la qualité est encore plus cruciale dans les applications spécialisées. De légères imperfections linguistiques sont souvent tolérables dans une conversation avec un service client. En revanche, une terminologie imprécise dans une analyse de contrat, une directive technique de sécurité ou une procédure administrative peut engendrer des coûts supplémentaires importants.
L'Allemagne possède d'immenses bases de données de documents techniques précieux mais difficiles d'accès. Les entreprises industrielles y conservent des archives de spécifications de conception, de rapports de maintenance, de notifications de qualité, de normes, de commentaires sur les nomenclatures de pièces et de correspondance avec les fournisseurs, accumulées au fil des décennies. Les autorités publiques gèrent d'importants volumes de dossiers, de réglementations, d'avis officiels et de documents de procédures. Les compagnies d'assurance, les banques, les fournisseurs d'énergie et les organismes de santé exploitent des bases de données textuelles soumises à une réglementation stricte. Un modèle capable de mieux appréhender ce contenu sur les plans linguistique et structurel peut générer des gains de productivité là où les chatbots classiques atteignent leurs limites.
Le bilinguisme constitue également une limite. Les entreprises internationales ont souvent besoin de systèmes unifiés pour des dizaines de langues. Dans ce cas, un modèle multilingue étendu peut s'avérer plus avantageux économiquement, malgré une spécialisation allemande moins poussée. Kolibri-1 est donc particulièrement pertinent lorsque l'allemand et l'anglais représentent la majeure partie des communications à valeur ajoutée. Le choix délibéré de se limiter à deux langues n'est pas une solution universelle, mais plutôt une orientation stratégique sur un marché clairement défini.
Du chatbot à l'assistant de processus numérique
Kolibri-1 prend en charge un mode de raisonnement explicite. Les utilisateurs ou les applications peuvent paramétrer l'effort de raisonnement sur faible, moyen ou élevé, ou désactiver complètement le raisonnement supplémentaire. Cette gradation est plus importante qu'il n'y paraît pour une utilisation en entreprise. Toutes les tâches ne nécessitent pas un traitement interne long. La classification simple, l'extraction rapide ou la reformulation de texte doivent être effectuées rapidement et à moindre coût. En revanche, l'analyse technique complexe ou la planification en plusieurs étapes peuvent tirer profit d'un niveau de raisonnement plus élevé.
Cela permet de contrôler la puissance de calcul en fonction de la valeur économique d'une tâche. Une entreprise peut ainsi exécuter des processus routiniers nécessitant un faible effort cognitif et n'allouer du temps de calcul supplémentaire qu'aux cas complexes. Ce principe s'apparente à la gestion des ressources basée sur les risques : plus les conséquences potentielles d'une réponse incorrecte sont importantes, plus l'effort autorisé pour la vérification, la recherche et le raisonnement est élevé. Toutefois, cela suppose que l'application sélectionne judicieusement ce niveau de complexité et surveille les résultats.
Plus important encore est son aptitude à exécuter des appels d'outils. Le modèle peut générer des appels de fonctions structurés, récupérer des informations via des interfaces de programmation, accéder à des systèmes de recherche, exécuter du code et exporter des données dans des formats prédéfinis. Ceci transforme un simple générateur de texte en un élément fondamental des flux de travail basés sur des agents. Par exemple, un assistant peut comprendre une requête, rechercher des documents pertinents, extraire des données d'un système ERP, effectuer des calculs et créer un modèle de décision préliminaire.
Le véritable levier économique ne réside pas dans la génération automatisée de textes, mais dans la combinaison d'étapes de processus auparavant distinctes. Lorsqu'un technicien de maintenance n'a plus à consulter plusieurs systèmes pour trouver les références des pièces, l'historique de maintenance et les conditions contractuelles, le temps de traitement diminue. Lorsqu'un service des achats structure automatiquement les documents fournisseurs, identifie les risques et établit des tableaux comparatifs, sa capacité augmente sans augmentation proportionnelle des effectifs. Lorsqu'un organisme gouvernemental extrait le contenu des fichiers et crée des versions standardisées, ses spécialistes peuvent consacrer davantage de temps à l'analyse juridique et à la communication avec les citoyens.
Toutefois, il n'en découle pas une prise de décision totalement autonome. Kolibri-1 est conçu pour les systèmes où des humains examinent les dépenses avant toute action. Dans les processus décisionnels, le modèle doit recueillir des données probantes, formuler des options et mettre en évidence les contradictions, mais ne peut prendre de décisions contraignantes sans supervision. Ceci s'applique particulièrement aux ressources humaines, aux prêts, à la médecine, aux services publics, aux questions de sécurité et à d'autres domaines ayant des conséquences importantes sur les individus ou la société.
La disponibilité des poids modifie le pouvoir de négociation
Kolibri-1 a été distribué sous licence Apache 2.0. Les entreprises peuvent télécharger les poids, les exécuter sur leur propre infrastructure, les personnaliser et, en principe, les utiliser à des fins commerciales. Comparé aux interfaces de programmation propriétaires, cela réduit la dépendance à un fournisseur unique. Les changements de prix, de conditions d'utilisation ou de stratégies produits d'un opérateur de plateforme externe peuvent impacter moins brutalement le système d'une entreprise lorsque le modèle opère dans son environnement interne.
Cette transparence renforce la position de négociation des clients auprès des fournisseurs de services cloud et de logiciels. Une entreprise peut comparer différents partenaires d'hébergement, changer d'infrastructure ou exécuter en interne des applications particulièrement sensibles. Des personnalisations sectorielles sont également possibles. Les cabinets de conseil, les intégrateurs et les éditeurs de logiciels peuvent développer leurs propres solutions à partir de ce modèle sans avoir à payer de frais d'utilisation pour chaque demande.
Open Weight ne signifie pas pour autant que l'ensemble du système est open source au sens strict. Les poids des modèles et les fichiers de configuration sont disponibles. Les données d'entraînement, le code d'entraînement complet, le développement de l'architecture et tous les outils de production ne sont pas divulgués automatiquement. La licence publiée accorde de larges droits d'utilisation des composants fournis, mais n'autorise pas la reproduction intégrale du processus de développement.
Même les modèles de poids téléchargeables gratuitement ne permettent pas d'éliminer les coûts d'exploitation. Les entreprises doivent financer le matériel, l'énergie, l'espace des centres de données, la surveillance, la sécurité, les mises à jour et le personnel qualifié. À cela s'ajoutent les dépenses liées à la préparation des données, aux bases de données vectorielles, aux contrôles d'accès, à l'évaluation, à la journalisation et à la protection des applications. Dans bien des cas, la licence du modèle ne représente qu'une petite partie du coût total.
La décision économique ne consiste donc pas à choisir entre un modèle gratuit et une API payante, mais entre coûts fixes et coûts variables. Les API propriétaires facturent généralement un prix par jeton traité ou par requête. L'hébergement en interne engendre des coûts initiaux et de mise en place élevés, mais peut devenir plus rentable en cas d'utilisation importante et régulière. Les entreprises dont le volume d'activité est faible ou fluctuant bénéficient souvent d'une facturation cloud basée sur l'utilisation. Les organisations présentant une utilisation élevée et constante, des exigences strictes en matière de données ou des besoins d'adaptation stratégiques peuvent tirer profit d'un hébergement en interne.
Une nouvelle dimension de la transformation numérique avec l'IA managée (Intelligence Artificielle) - Plateforme et solution B2B | Xpert Consulting

Une nouvelle dimension de la transformation numérique avec l'IA managée (Intelligence Artificielle) – Plateforme et solution B2B | Xpert Consulting - Image : Xpert.Digital
Vous découvrirez ici comment votre entreprise peut mettre en œuvre des solutions d'IA personnalisées rapidement, en toute sécurité et sans barrières à l'entrée élevées.
Une plateforme d'IA managée est votre solution clé en main pour l'intelligence artificielle. Fini les technologies complexes, les infrastructures coûteuses et les longs processus de développement : vous bénéficiez d'une solution clé en main, adaptée à vos besoins, fournie par un partenaire spécialisé – souvent en quelques jours seulement.
Les principaux avantages en un coup d'œil :
⚡ Mise en œuvre rapide : De l’idée à l’application prête à l’emploi en quelques jours, et non en plusieurs mois. Nous fournissons des solutions pratiques qui créent une valeur ajoutée immédiate.
🔒 Sécurité maximale des données : Vos données sensibles restent chez vous. Nous garantissons un traitement sécurisé et conforme à la réglementation, sans partage de données avec des tiers.
💸 Aucun risque financier : vous ne payez que pour les résultats. Les investissements initiaux importants en matériel, logiciels ou personnel sont totalement éliminés.
🎯 Concentrez-vous sur votre cœur de métier : nous prenons en charge l’intégralité de la mise en œuvre technique, de l’exploitation et de la maintenance de votre solution d’IA.
📈 Évolutif et à l'épreuve du temps : votre IA évolue avec vous. Nous assurons une optimisation et une évolutivité continues, et adaptons les modèles avec souplesse aux nouveaux besoins.
Plus d'informations ici :
Le véritable coût de Kolibri-1 dans les opérations commerciales
Le véritable calcul commence après le téléchargement
Une analyse économique rigoureuse pour Kolibri-1 doit aller bien au-delà de l'achat du GPU. Côté investissements, elle doit prendre en compte l'approvisionnement, le financement, les technologies réseau, les systèmes de stockage, le refroidissement et les éventuelles modifications structurelles nécessaires. Côté exploitation, les coûts incluent l'électricité, la maintenance, le personnel, l'exploitation des logiciels et la fiabilité. Des systèmes redondants sont souvent indispensables pour les applications de production. Un serveur unique peut suffire pour les tests, mais ne constitue pas un service fiable pour une entreprise.
Le taux d'utilisation est le principal facteur de coût. Un modèle géré en interne peut théoriquement atteindre de faibles coûts marginaux par requête supplémentaire. En pratique, cependant, l'infrastructure doit également rester disponible même en période de faible demande. Si elle n'est utilisée qu'à 10 ou 20 % de sa capacité, les coûts fixes sont répartis sur un petit nombre de jetons. Un fournisseur d'hébergement spécialisé peut agréger les charges de différents clients et ainsi optimiser considérablement l'efficacité. Ceci plaide en faveur des offres d'IA gérées de manière souveraine, où le stockage des données, l'exploitation des modèles et la gouvernance sont intégrés au sein d'une infrastructure européenne contrôlée.
Les contextes à long terme modifient également la structure des coûts. Le traitement d'un document volumineux mobilise des ressources de stockage et de traitement pendant une période prolongée. Lorsque plusieurs utilisateurs soumettent simultanément des centaines de milliers de jetons, le nombre de requêtes pouvant être traitées en parallèle diminue. Par conséquent, les entreprises doivent modéliser non seulement la requête moyenne, mais aussi les pics de charge, les exigences en matière de temps de réponse et les priorités. Un système de traitement par lots nocturne peut s'avérer nettement plus rentable, avec le même matériel, qu'un assistant interactif avec des temps de réponse garantis.
L'adaptation aux données de l'entreprise engendre des coûts supplémentaires. Souvent, un paramétrage fin complet n'est pas nécessaire. Un bon système RAG (Real Age, Agility, Garanti) et des métadonnées propres, associés à un concept d'autorisation robuste, offrent généralement de meilleurs résultats. Le paramétrage fin peut s'avérer utile pour l'apprentissage fiable de formats, de langages métier ou de flux de travail récurrents. Toutefois, il accroît les efforts requis pour la qualité des données, les tests, le versionnage et la revérification après les mises à jour du modèle.
Le principal facteur de coût caché réside dans l'assurance qualité. Un modèle de langage peut produire des résultats convaincants tout en étant erroné. Par conséquent, les systèmes opérationnels nécessitent des cas de test pertinents pour le métier, des seuils de tolérance aux erreurs définis et une évaluation continue. Pour chaque application critique, les entreprises doivent mesurer la fréquence à laquelle le modèle trouve des informations correctes, identifier les cas où il génère des conclusions erronées, vérifier le respect des droits d'accès et analyser sa réaction face à des documents manipulés. Sans ces contrôles, un faible coût de tokenisation est économiquement inutile, car une seule erreur peut avoir des conséquences importantes.
950 mégawattheures et la question de l'efficacité
La consommation énergétique des phases de pré-entraînement, d'entraînement intermédiaire et d'apprentissage en contexte long est estimée à environ 950 mégawattheures. Ce chiffre inclut la consommation des nœuds de calcul et les ressources du centre de données. Il n'inclut pas, entre autres, l'ajustement supervisé, l'apprentissage par renforcement, les modèles auxiliaires, les séries de tests, ni les états d'inactivité et de pointe. La consommation énergétique totale réelle du programme de développement est donc supérieure au chiffre publié.
La phase de pré-entraînement s'est déroulée sur 21 jours et a nécessité 768 GPU Nvidia B200 répartis sur 96 systèmes HGX, soit environ 392 000 heures de calcul. La phase d'entraînement intermédiaire, d'une durée d'environ cinq jours, a quant à elle requis près de 90 000 heures de calcul. Enfin, la phase de contextualisation à long terme a ajouté 10 000 heures de calcul supplémentaires. L'effort de calcul total s'élève à 6,4 × 10²³ opérations en virgule flottante.
Le chiffre de 950 mégawattheures semble élevé, mais il convient de le replacer dans son contexte économique. La formation représente un investissement unique dans une ressource numérique réutilisable. Le facteur déterminant est l'intensité d'utilisation ultérieure du modèle et les retombées économiques qu'il génère. Si un modèle est utilisé dans des milliers d'applications pendant plusieurs années, l'effort de formation est amorti sur une production économique importante. À l'inverse, s'il demeure un projet de démonstration technologique peu utilisé, la productivité des ressources est faible.
Pour l'évaluation de l'impact environnemental, le fonctionnement continu s'avère souvent plus important à long terme qu'une session de formation ponctuelle. Chaque requête consomme de l'énergie, et les fenêtres de contexte étendues augmentent cette demande. Parallèlement, un modèle expert performant peut nécessiter moins de calculs par jeton qu'un modèle dense de capacité totale comparable. La comparaison essentielle ne porte donc pas sur une consommation absolue élevée contre une consommation nulle, mais plutôt sur l'énergie consommée par résultat exploitable.
L'Europe a un intérêt stratégique à privilégier l'efficacité. Le prix élevé de l'électricité et la capacité limitée des centres de données rendent les architectures énergivores particulièrement coûteuses. Les modèles comme Kolibri-1, qui n'activent qu'une petite partie de leurs paramètres, s'inscrivent dans une stratégie européenne visant à allier performance technologique et productivité des ressources. Cependant, cet avantage est partiellement contrebalancé par les besoins importants en stockage et le matériel haute performance nécessaire.
Les indicateurs de référence montrent une bonne performance, mais aucun vainqueur clair
Les données comparatives publiées positionnent Kolibri-1 comme un modèle très performant dans sa catégorie de taille et d'efficacité. Il obtient une moyenne globale de 75,5 points en anglais et de 70,8 points en allemand. Ses performances sont particulièrement remarquables en mathématiques et en raisonnement multi-étapes. Il atteint 96,0 % au test AIME-2026 en anglais et 90,0 % à la version allemande. Au test GPQA Diamond, réputé pour son exigence scientifique, le modèle obtient 84,3 % en anglais et 81,3 % en allemand.
Kolibri-1 affiche également des performances compétitives dans les tâches de programmation, les processus multi-agents et les scénarios RAG industriels. Ses excellents résultats dans des domaines tels que la sous-traitance automobile, les semi-conducteurs, le secteur public allemand et les systèmes d'entraînement industriels sont particulièrement remarquables. Ceci conforte son positionnement en tant que modèle pour les processus métier à forte intensité de connaissances. L'amélioration par rapport à un modèle de référence précédent est tout aussi significative : la formation a considérablement renforcé le raisonnement, l'utilisation des outils et le respect des consignes.
Néanmoins, Kolibri-1 n'est pas leader dans toutes les disciplines. Des modèles concurrents plus denses et plus vastes obtiennent de meilleurs résultats dans plusieurs tests portant sur les connaissances, le code et le contexte long. D'autres modèles experts surpassent également Kolibri-1 dans certaines tâches d'appel d'outils ou de recherche. Les résultats allemands sont solides, mais pas systématiquement supérieurs. Par conséquent, un avantage économique clair ne peut être déduit d'un simple tableau de référence.
Les benchmarks ne reflètent que des conditions de test définies. Dans les entreprises, la qualité des documents, les autorisations, la diversité des formats, le jargon technique et les conséquences des erreurs sont bien plus complexes. Un modèle peut obtenir de bons résultats lors d'un test standardisé, mais échouer en raison de PDF mal numérisés, de données héritées contradictoires ou d'abréviations internes. Inversement, un modèle avec un score moyen légèrement inférieur peut se révéler supérieur dans une application d'entreprise bien configurée.
Pour les décisions relatives aux achats et à l'architecture, les tests internes sont donc essentiels. Les entreprises doivent utiliser des documents représentatifs, des cas limites complexes et des données de processus réelles. Les mesures doivent couvrir non seulement la précision des réponses, mais aussi le coût, la latence, la stabilité, la référence de la source, le comportement en cas de défaillance et la maintenabilité. Kolibri-1, avec ses pondérations ouvertes, est parfaitement adapté à de telles évaluations contrôlées. Il s'agit d'un avantage considérable par rapport aux systèmes dont les versions internes et les conditions de fonctionnement peuvent changer sans intervention du client.
La sécurité est une tâche systémique
L'entraînement de Kolibri-1 intègre des mesures de protection contre les contenus malveillants, les données personnelles et les hallucinations. Les informations permettant d'identifier une personne ont été partiellement supprimées ou remplacées lors de la phase de pré-entraînement. Pour un réglage fin supervisé, des données ont été ajoutées afin de se prémunir contre les attaques visant les informations personnelles. De plus, le modèle a été entraîné à ne pas réagir face à des informations manquantes ou contradictoires.
Ces mesures réduisent les risques, mais ne les éliminent pas. Les modèles de langage peuvent générer de fausses informations, intégrer des biais politiques ou sociaux et réagir à des entrées manipulées. Les attaques par injection indirecte d'instructions sont particulièrement problématiques. Dans ce type d'attaque, un document récupéré contient des instructions cachées conçues pour tromper le modèle et l'amener à effectuer des actions indésirables. Plus les appels d'outils et les processus automatisés sont utilisés, plus les dommages potentiels d'une telle attaque sont importants.
Les systèmes d'entreprise sécurisés nécessitent donc une protection multicouche. L'accès doit être accordé selon le principe du moindre privilège. Les appels d'outils doivent être validés, les actions sensibles doivent être approuvées et les résultats doivent être consignés. Le modèle ne doit pas décider seul des données auxquelles il peut accéder ni des transactions qu'il peut exécuter. Ses permissions doivent être techniquement limitées en dehors du modèle.
L'élargissement du contexte engendre également de nouveaux risques. De grands volumes de documents peuvent contenir des informations confidentielles, des données personnelles ou des instructions contradictoires. Toute personne en charge de salles de données complètes doit s'assurer que les utilisateurs ne reçoivent que les informations auxquelles ils sont autorisés à accéder. Un modèle de langage unique pour tous les services, sans séparation cohérente des accès, peut involontairement fragiliser les silos d'information existants.
Par conséquent, le déploiement dans les secteurs réglementés exige bien plus qu'un modèle développé en Europe. Il requiert des évaluations des risques documentées, une classification des données, une supervision humaine, des protocoles techniques et une définition claire des responsabilités. La souveraineté ne se limite pas à la simple localisation des données dans un centre de données spécifique. Elle implique qu'une organisation maîtrise l'ensemble du processus décisionnel, tant sur le plan technique que juridique.
Le bloc de puissance transatlantique à l'origine du modèle
Le lancement de Kolibri-1 coïncide avec une période de profonde restructuration. Aleph Alpha et la société canadienne d'IA Cohere ont conclu un accord de fusion contraignant. La transaction reste soumise à l'approbation finale des autorités réglementaires début octobre 2026. La nouvelle entité opérera à l'échelle mondiale sous la marque Cohere, avec des sièges sociaux à Toronto et à Berlin. Le site d'Heidelberg sera conservé comme centre de recherche.
Cette nouvelle configuration modifie la classification de Kolibri-1. Bien que le modèle ait été développé en Allemagne, son avenir économique se joue de plus en plus au sein d'une organisation transatlantique. La fusion associe la recherche d'Aleph Alpha, son expertise germanophone et son accès au secteur public à la portée internationale, aux produits et à la force de vente de Cohere. Si cela peut accélérer la commercialisation, cela remet en question l'idée d'un champion allemand de l'IA totalement indépendant.
Sur le plan politique, ce partenariat est présenté comme une alternative pour l'Allemagne et le Canada aux plateformes américaines dominantes. Cette description est compréhensible, mais incomplète. Si le Canada est un partenaire proche de l'Europe, il est soumis à des structures juridiques, financières et de sécurité différentes. La souveraineté numérique ne découle pas automatiquement de la nationalité des entreprises impliquées. Parmi les facteurs essentiels figurent les structures de propriété, la gouvernance, l'accès aux données, le contrôle de l'infrastructure et la possibilité pour les clients européens de changer de fournisseur et de localisation.
Le groupe Schwarz joue un rôle clé dans ce projet. Déjà investisseur important d'Aleph Alpha, il renforce son investissement dans la nouvelle entité. Via Schwarz Digits et la plateforme cloud STACKIT, il fournira la capacité de calcul nécessaire aux offres d'IA souveraine. Il en résulte une structure plus intégrée verticalement, englobant le développement de modèles, les logiciels d'entreprise, l'infrastructure cloud et la capacité des centres de données.
D'un point de vue économique, cette consolidation est justifiée. Un modèle unique ne suffit pas à lui seul à générer un pouvoir de marché. La création de valeur repose sur les ventes, l'intégration, l'hébergement, les plateformes de données et les contrats clients à long terme. L'alliance transatlantique est mieux placée qu'Aleph Alpha pour couvrir ces différents niveaux. Toutefois, elle accroît la dépendance à l'égard de quelques grands partenaires. Si STACKIT devenait la plateforme technique de référence, l'ouverture des pondérations du modèle pourrait être complétée concrètement par un engagement fort envers un écosystème opérationnel spécifique.
La souveraineté de l'Europe a besoin d'être concrétisée, pas symbolique
L'Europe investit massivement dans les infrastructures d'IA. Le réseau des AI Factories européennes se développe et des milliards d'euros ont été alloués à ces infrastructures et aux structures connexes. Par ailleurs, plusieurs Gigafactories d'IA sont en projet. L'objectif est de fournir aux entreprises, aux instituts de recherche et aux pouvoirs publics européens un accès à une capacité de calcul haute performance. Cette politique d'infrastructure est indispensable car les modèles modernes ne peuvent être développés ni exploités de manière rentable sans de vastes clusters de GPU.
Cependant, Kolibri-1 démontre que le matériel seul ne suffit pas. L'Europe a besoin d'un écosystème industriel complet comprenant des modèles, des centres de données, des salles de serveurs, des intégrateurs, des logiciels spécialisés, des services de sécurité et des utilisateurs qualifiés. L'investissement public dans la puissance de calcul n'est efficace que s'il débouche sur des applications commercialisables. Autrement, l'Europe subventionne des infrastructures coûteuses tandis que les activités lucratives liées aux logiciels et aux plateformes restent hors du continent.
La demande est bien présente. Une large majorité d'entreprises allemandes privilégient les solutions d'IA allemandes. Cependant, dans la pratique, les services américains dominent nettement. Cet écart ne s'explique pas par un manque d'intérêt pour la souveraineté, mais plutôt par des raisons de commodité, de maturité des produits, d'écosystèmes et de contrats existants. Les entreprises choisissent rarement un modèle en fonction de son origine. Elles optent pour une solution si elle est rapide à intégrer, fiable, à prix transparent et facile à gérer au sein de leur organisation.
Kolibri-1 doit donc offrir bien plus qu'une simple promesse d'origine européenne. Il lui faut des outils compétitifs, des solutions d'hébergement stables, une documentation de qualité, des réseaux de partenaires et des avantages concrets pour les processus métiers allemands. L'approche Apache 2.0 facilite le développement d'un tel écosystème. Les éditeurs de logiciels et les groupes de recherche peuvent tester le modèle, l'adapter et l'intégrer à leurs propres produits. Cela augmente la probabilité que l'innovation ne soit pas l'apanage d'un seul fournisseur.
Parallèlement, le risque existe que les pondérations ouvertes soient exploitées par des plateformes mondiales sans que l'Allemagne ne bénéficie d'une part équivalente de la valeur ajoutée. L'ouverture ne saurait donc se substituer à une stratégie commerciale solide. Aleph Alpha et ses partenaires doivent proposer des services, des modèles opérationnels sécurisés, des solutions sectorielles et instaurer un climat de confiance institutionnelle. Ce modèle constitue un socle technologique et une passerelle, et non l'unique source de revenus.
Une évaluation réaliste de Hummingbird-1
Kolibri-1 ne constitue ni la preuve d'une indépendance européenne totale en matière d'IA, ni un modèle de niche insignifiant. Son importance se situe entre ces deux extrêmes. Techniquement, il combine une grande capacité globale avec une charge de calcul active relativement faible, une composante d'apprentissage en allemand particulièrement robuste, des contextes très longs, un raisonnement performant et l'appel d'outils. La licence ouverte offre un véritable champ d'action aux entreprises, aux intégrateurs et aux institutions publiques.
D'un point de vue économique, ce modèle est particulièrement avantageux là où convergent données sensibles, terminologie technique allemande et volumes d'utilisation importants. Les grandes entreprises industrielles, les administrations publiques, les banques, les compagnies d'assurance, les fournisseurs d'énergie, les organismes de recherche et les éditeurs de logiciels spécialisés figurent parmi les cibles privilégiées. Pour les PME ne disposant pas de leur propre infrastructure, l'hébergement direct est généralement moins pratique. Elles privilégieront plutôt Kolibri-1 via des services gérés, des solutions sectorielles ou des offres de cloud souverain.
Le principal atout ne réside pas dans 78 milliards de paramètres, mais dans la capacité à conjuguer maîtrise, adaptabilité et performance concurrentielle. Le principal inconvénient est que cette maîtrise a un coût et doit être gérée au sein de l'organisation. Quiconque exploite le modèle assume la responsabilité de l'infrastructure, de la sécurité, de l'évaluation et des mises à jour. C'est une liberté stratégique, certes, mais une liberté qui a un prix.
Le partenariat avec Cohere et Schwarz Digits pourrait transformer Kolibri-1 en un produit commercialisable à l'international. Il permettrait de conjuguer recherche, capital, ventes et puissance de calcul. Parallèlement, il exige une réévaluation approfondie du concept de souveraineté numérique. Une entreprise transatlantique, s'appuyant sur la recherche allemande et une infrastructure cloud européenne, pourrait constituer une alternative viable aux grandes plateformes américaines. Toutefois, il ne s'agit pas pour autant d'un système purement allemand ou entièrement contrôlé par l'Europe.
Le constat est donc clair : Kolibri-1 constitue un élément fondamental pour une économie européenne de l’IA, mais son succès n’est pas garanti. Il ne dépendra pas des classements de performance, mais des centres de données, des budgets d’acquisition et des processus métier concrets. Si l’avantage de la langue allemande, la licence libre et l’architecture experte performante se traduisent par des applications robustes, le modèle peut conquérir un marché important. En revanche, si l’hébergement, l’intégration et la distribution restent trop coûteux ou trop complexes, la qualité technologique à elle seule ne suffira pas.
Kolibri-1 illustre ainsi à la fois les opportunités et les difficultés de l'Europe. Le continent est capable de développer une IA performante, compte des clients industriels exigeants et développe ses infrastructures. Ce qui fait souvent défaut, c'est le passage rapide du modèle de recherche à un produit standard largement adopté. Le colibri peut sembler léger et n'utiliser qu'une petite partie de la puissance de ses ailes à la fois. Mais pour voler de manière rentable, il a besoin d'une base solide de capitaux, d'énergie, de puissance de calcul, de confiance et d'un réseau de distribution performant.
🎯🎯🎯 Plateforme B2B axée sur les données, une solution quasi interne

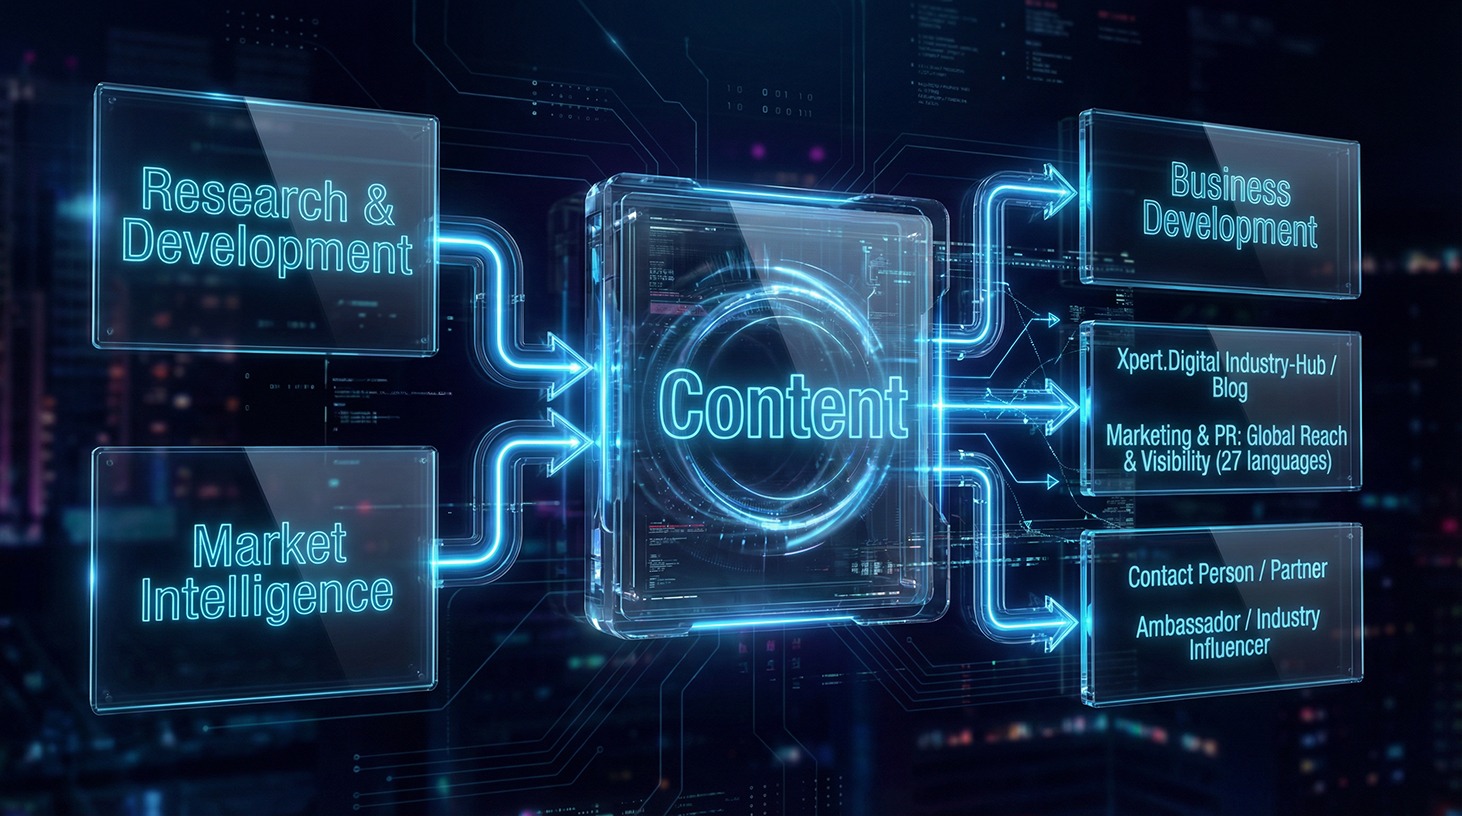
La solution quasi-interne : comment Xpert.Digital comble les lacunes opérationnelles du marketing et des ventes B2B – Entreprise axée sur le contenu intelligent – Image : Xpert.Digital
Xpert.Digital est une plateforme B2B axée sur les données, dirigée par Konrad Wolfenstein . L'entreprise propose aux partenaires industriels une solution externe quasi intégrée, comblant leurs lacunes opérationnelles en matière de marketing, de contenu et de ventes, sans nécessiter de ressources supplémentaires de leur côté.
Plus d'informations ici :
Votre partenaire mondial en marketing et développement commercial
☑️ Notre langue de travail est l'anglais ou l'allemand
☑️ NOUVEAU : Correspondance dans votre langue maternelle !

Konrad Wolfenstein
Mon équipe et moi-même sommes heureux de pouvoir vous accompagner en tant que conseiller personnel.
Vous pouvez me contacter en remplissant le formulaire de contact ici wolfenstein@xpert.digital :ou simplement m'appeler au +49 7348 4088 965. Mon adresse e-mail est
J'attends avec impatience notre projet commun.