Más que un chatbot: Cómo una capa semántica hace que la IA sea más fiable en las empresas: El factor de éxito subestimado para la IA empresarial
Versión preliminar de Xpert

Available in 27 languages 📢
Prefiere Xpert.Digital en GoogleⓘPublicado el: 1 de noviembre de 2026 / Actualizado el: 1 de noviembre de 2026 – Autor: Konrad Wolfenstein
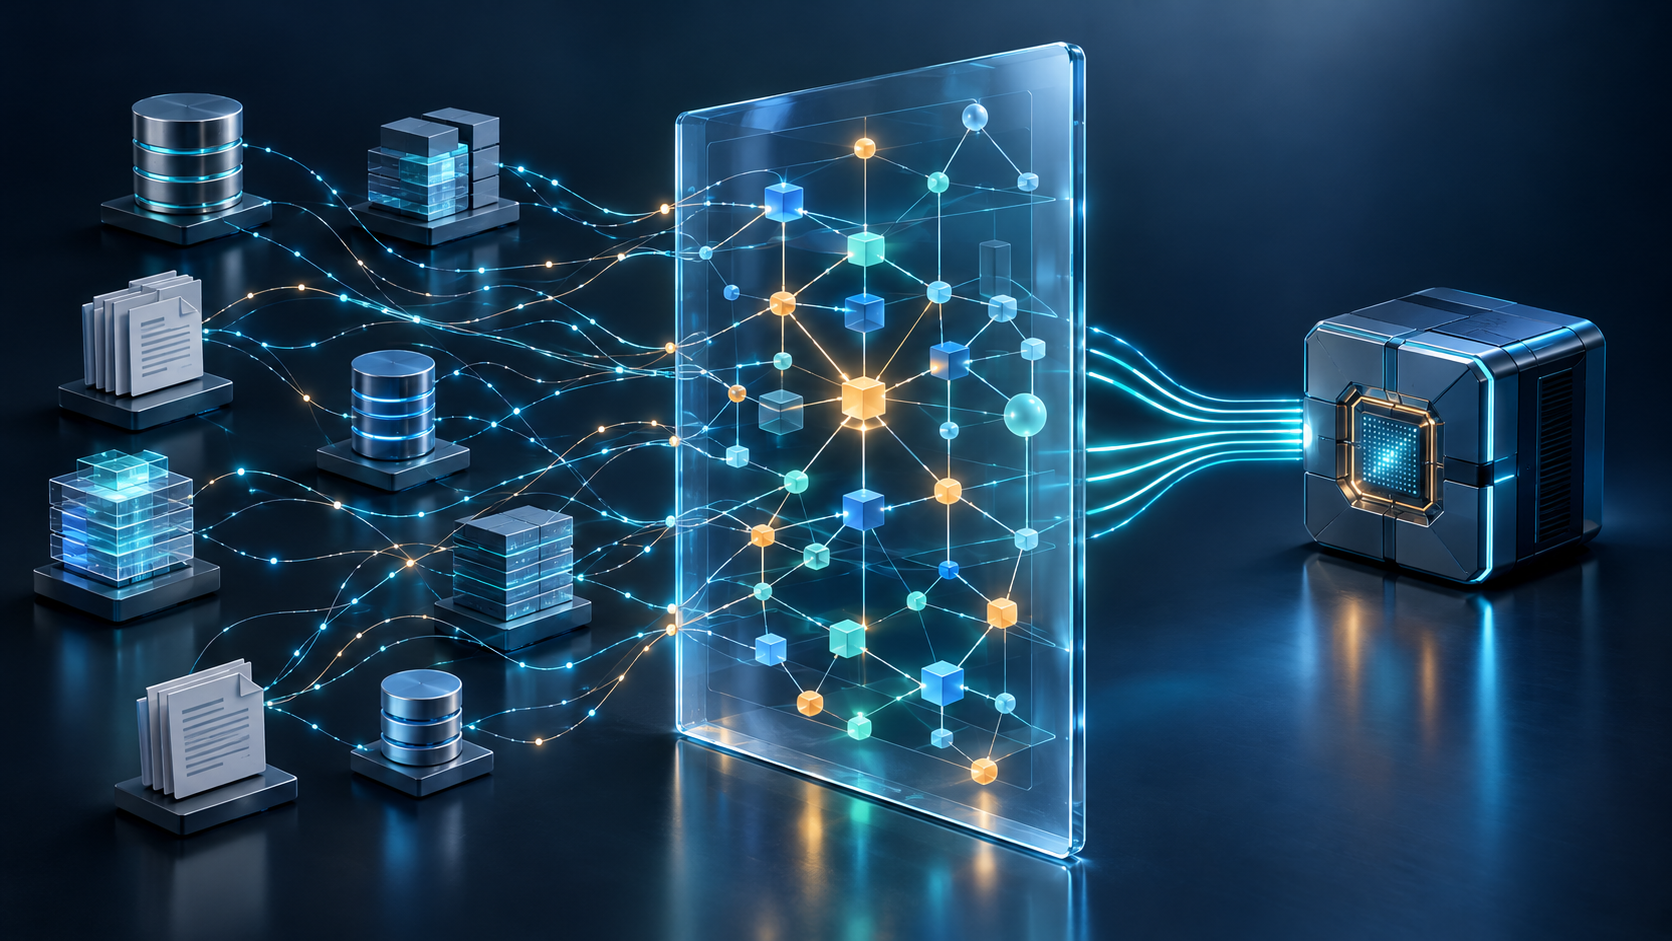
Más que un chatbot: Cómo una capa semántica hace que la IA sea más fiable en las empresas – El factor de éxito subestimado para la IA empresarial – Imagen creativa sobre el tema, con IA: Xpert.Digital
Inteligencia artificial en los negocios: por qué una terminología clara determina el éxito económico
Cuando la IA acelera el caos: por qué las empresas necesitan compartir conocimientos empresariales
Menos contradicciones, mejores decisiones: lo que una capa semántica puede hacer por las empresas
Las empresas están invirtiendo en inteligencia artificial para acelerar procesos y tomar mejores decisiones. Sin embargo, un modelo de lenguaje potente por sí solo no garantiza el éxito empresarial. Si los departamentos de ventas, finanzas y atención al cliente interpretan los términos clave de forma diferente, la IA puede ofrecer respuestas contradictorias y propagar errores con mayor rapidez. Una capa semántica busca solucionar este problema: hace que los términos, las relaciones y las reglas sean utilizables y comprensibles en diversas aplicaciones. Su valor reside no solo en mejores respuestas, sino también en la reducción de los esfuerzos de coordinación y en la reutilización del conocimiento de la empresa. No obstante, una capa semántica puede revelar ambigüedades organizativas, pero no las resolverá por sí sola. Por lo tanto, lo que importa es cómo las empresas mapean su realidad empresarial, definen las responsabilidades profesionales y miden los beneficios reales.
Relacionado con esto:
Capa semántica para la IA empresarial: por qué la relevancia para el negocio determina el retorno de la inversión en IA
Sin conceptos claros, la IA automatiza el caos
Una capa semántica permite compartir y verificar términos, relaciones y reglas comerciales para aplicaciones de IA. Su valor económico reside, por lo tanto, no solo en mejores respuestas, sino también en la posibilidad de reducir los esfuerzos de coordinación, reutilizar el conocimiento empresarial y tomar decisiones más controlables. Sin embargo, la limitación crucial es que dicha capa semántica puede revelar ambigüedades organizativas, pero no puede resolverlas por sí sola.
Para las empresas, esto cambia el enfoque estratégico. Ya no se trata solo de qué modelo de lenguaje es el más eficiente o con qué rapidez se puede desarrollar otro asistente. Lo que cobra mayor importancia es la realidad empresarial en la que se basan estos sistemas. Si ventas, finanzas y atención al cliente utilizan un mismo término de forma diferente, una IA técnicamente potente puede difundir resultados contradictorios aún más rápido y de forma más generalizada. El reto económico reside en transformar la información dispersa en una base sólida y permanentemente utilizable para la toma de decisiones.
La brecha entre el uso y el resultado
La adopción de la IA está en auge, pero su uso aún no ha demostrado tener un impacto económico. En 2025, el 19,95 % de las empresas de la UE encuestadas con diez o más empleados utilizaban al menos una tecnología de IA; esto representó un aumento de 6,47 puntos porcentuales con respecto a 2024. Existían diferencias significativas según el tamaño de las empresas: el porcentaje era del 17 % para las pequeñas empresas, del 30,36 % para las medianas y del 55,03 % para las grandes. La encuesta abarcó un amplio espectro de tecnologías de IA, desde el análisis de texto hasta las máquinas autónomas, pero no se centró específicamente en el uso de la IA generativa ni en las capas semánticas.
Una encuesta empresarial internacional realizada en 2026 ofrece una perspectiva diferente. En ella, el 80 % de los encuestados informó de una mejora en su productividad personal gracias a la IA, mientras que el 37 % indicó una contribución positiva a los beneficios antes de intereses e impuestos (EBIT) de su empresa. Tan solo un 6 % pertenecía a un grupo especialmente exitoso, que atribuía al menos el 5 % de su EBIT a la IA y, al mismo tiempo, reportaba beneficios significativos. La encuesta incluyó a 1719 participantes de 97 países y se basó en datos autodeclarados; por lo tanto, no es directamente comparable con las estadísticas empresariales europeas.
Las cifras no demuestran un efecto causal de una capa semántica. Más bien, ilustran el problema empresarial: entre la simplificación del trabajo individual y el éxito empresarial cuantificable se interpone un esfuerzo de traducción organizacional. Es precisamente en esta interfaz donde una capa de significado compartida cobra relevancia.
La importancia pasa a formar parte de la infraestructura operativa
Una capa semántica conecta las estructuras de datos técnicos con conceptos empresariales como cliente, contrato, reclamación o ingresos. Describe, por ejemplo, qué campos de datos pertenecen a un cliente, cómo se calcula un indicador clave de rendimiento (KPI) y bajo qué condiciones se aplica un estado específico. Esto permite que diferentes aplicaciones se basen en definiciones comunes en lugar de derivar sus propias interpretaciones a partir de etiquetas de tablas o documentos.
Un ejemplo sencillo ilustra las implicaciones. Una empresa podría definir a un cliente activo en ventas mediante conversaciones en curso, en finanzas mediante transacciones comerciales registradas y en servicio mediante reclamaciones de servicio existentes. Ninguna de estas perspectivas es necesariamente errónea. El problema surge cuando una IA las mezcla inadvertidamente o presenta una perspectiva como universalmente válida.
Por lo tanto, la solución económicamente viable no siempre consiste en una única definición para todos los fines. A menudo, se necesitan varias definiciones claras, profesionalmente responsables y con límites de aplicación inequívocos. Un nivel común de significado debe reflejar las diferencias de manera controlada, sin crear artificialmente una uniformidad que la empresa no posee en realidad. Su objetivo es una interpretación comprensible, no una homogeneización conceptual.
Del informe a la decisión operativa
Los modelos semánticos clásicos para la inteligencia empresarial se centran principalmente en indicadores clave, dimensiones, agregaciones y las relaciones entre objetos de datos. Sin embargo, sería una simplificación excesiva negarles por completo la lógica empresarial o las funciones de autorización: los sistemas de BI consolidados, por ejemplo, admiten relaciones, indicadores clave calculados y acceso a datos basado en roles. Por lo tanto, la frontera entre una capa semántica de BI y una capa semántica de IA no es una división tecnológica clara.
La principal diferencia radica en los requisitos. Un informe, por ejemplo, debe reflejar con precisión los ingresos. Una aplicación de IA operativa, en cambio, también debe ser capaz de determinar a qué proceso pertenece cada contrato, qué acuerdo especial tiene prioridad y si el siguiente paso requiere aprobación. Esto amplía la tarea, pasando del análisis sistemático al apoyo a la toma de decisiones en función del contexto.
Desde el punto de vista económico, esto incrementa tanto los beneficios potenciales como los riesgos. Un informe mal definido puede propiciar una decisión errónea. Un asistente práctico puede implementarla de inmediato. Cuanto más se acerca la IA a los pedidos, los pagos, los compromisos de precios o las decisiones de los clientes, más crucial se vuelve la distinción entre la interpretación plausible y la lógica de ejecución vinculante.
Los cuatro pilares del conocimiento empresarial
Una capa de significado integral para la IA empresarial debe considerar cuatro tipos de conocimiento: definiciones de entidades, relaciones, reglas de decisión y correcciones recopiladas. Las definiciones de entidades especifican qué constituye un objeto de negocio, como un cliente activo, un contrato crítico o un caso de alto riesgo. Las relaciones conectan dichos objetos, como una filial con una cuenta o una modificación de contrato con el contrato principal correspondiente.
Las reglas de decisión describen umbrales, excepciones, responsabilidades y condiciones de aprobación. El registro de correcciones documenta dónde los expertos en la materia han corregido resultados erróneos. Solo en conjunto se puede desarrollar esto para que sea más que una simple función de búsqueda: una base transparente sobre cómo se puede interpretar la información y dentro de qué marco.
Desde una perspectiva económica, estos tipos de conocimiento deben valorarse de forma diferente. La definición de un cliente puede reutilizarse en múltiples aplicaciones. En cambio, una decisión sobre una excepción solo se aplica a un contrato específico. Por lo tanto, una buena arquitectura no solo debe almacenar conocimiento, sino también limitar su alcance. De lo contrario, transforma una excepción local en una regla general y agrava el error que pretende evitar.
Por qué los documentos son cruciales para la gestión empresarial
Una capa semántica basada en IA debe ser capaz de vincular no solo datos estructurados, sino también contratos, correos electrónicos, informes y actas de reuniones con las transacciones comerciales correspondientes. La razón es evidente: una entrada en la base de datos podría contener el precio estándar acordado, mientras que un acuerdo complementario aprobado estipula condiciones diferentes. Quien se limite a analizar el conjunto de datos podría pasar por alto la excepción económicamente vinculante.
La dificultad no reside simplemente en encontrar una cláusula, sino en determinar su estatus. Un borrador no es un acuerdo firmado. Un memorando de una reunión interna no sustituye la aprobación. Un documento posterior puede complementar, reemplazar parcialmente o aplicarse a un ámbito diferente al de una norma anterior. Estas distinciones deben modelarse y revisarse explícitamente para cada caso de uso específico.
Esto nos lleva a una importante perspectiva económica: el valor del análisis documental no se mide por el número de páginas procesadas. Solo se manifiesta cuando permite extraer conclusiones fiables sobre reclamaciones, obligaciones, plazos o planes de acción. Un resumen rápido sin verificar el contenido, por otro lado, puede generar costes de auditoría adicionales y crear una falsa sensación de seguridad.
Cuatro fuentes de coste debidas a la ambigüedad semántica
El impacto económico puede entenderse a través de cuatro categorías de costos. Primero, los costos de búsqueda surgen cuando los empleados deben recopilar información y comprender su significado. Segundo, los costos de coordinación surgen cuando los departamentos explican y concilian diferentes análisis. Tercero, los costos de error surgen cuando clasificaciones o reglas incorrectas dan lugar a retrabajos y decisiones erróneas. Cuarto, los costos de repetición surgen cuando cada nuevo proyecto de IA requiere desarrollar nuevamente las mismas bases técnicas.
Esta clasificación constituye un marco de evaluación analítica, no una distribución de costos medida empíricamente. Sin embargo, ayuda a evitar una idea errónea común: el retorno de la inversión de una capa semántica no debería depender únicamente de la velocidad de respuesta de un asistente. Una respuesta puede aparecer en segundos y aun así resultar costosa si varios especialistas deben verificar posteriormente su precisión.
Por el contrario, una mejora aparentemente insignificante puede generar un valor considerable. Si una definición vinculante agiliza la coordinación entre el departamento de finanzas y el de ventas, el beneficio puede repercutir simultáneamente en numerosos informes y decisiones. Por lo tanto, la unidad económica relevante no siempre es el diálogo individual con la IA, sino todo el proceso empresarial, incluidos sus ciclos de control y corrección.
La reutilización genera economías de escala
Las definiciones comunes de indicadores clave de rendimiento (KPI) evitan la duplicación de esfuerzos de implementación y permiten que la misma lógica de negocio sea accesible en distintas aplicaciones. Aplicada a una arquitectura de IA más amplia, esta es la principal promesa de la escalabilidad: los términos, las relaciones y las reglas ya publicados deberían seguir siendo utilizables en otros casos de uso. Esto transforma la capa semántica en una posible inversión en infraestructura, en lugar de un componente de proyecto aislado.
La lógica económica es similar a la de un recurso compartido. Su creación inicial conlleva costes, mientras que otros usuarios pueden aprovechar los componentes existentes. Sin embargo, el beneficio solo aumenta si los nuevos casos de uso presentan una superposición de conocimientos suficiente. Otro asistente en la misma área de servicio puede recurrir a más conocimientos existentes que una aplicación para un sector empresarial completamente diferente.
Por lo tanto, sería poco realista esperar una disminución automática de los costos con cada proyecto de IA posterior. Los nuevos marcos legales, familias de productos o modelos de negocio pueden requerir ampliaciones. Las economías de escala fiables no residen en que los proyectos posteriores sean gratuitos, sino en que los asuntos ya aclarados no necesitan ser aclarados nuevamente sin una justificación objetiva.
La productividad necesita una evaluación objetiva
Un estudio realizado con 5172 empleados de atención al cliente reveló que el acceso a un asistente de IA generativa se tradujo en un aumento promedio de aproximadamente el 15 % en la resolución de solicitudes de clientes por hora. Sin embargo, el efecto fue desigual: los empleados con menos experiencia y menor cualificación se beneficiaron más, mientras que los empleados con mayor experiencia y alto rendimiento solo experimentaron leves mejoras en la velocidad y, en algunos casos, una ligera disminución en la calidad. Por lo tanto, el estudio demuestra un efecto concreto en la productividad dentro de un entorno laboral específico, en lugar del retorno de la inversión aislado de una capa semántica.
Esta distinción es crucial para la evaluación económica. Una implementación exitosa de IA no revela qué proporción del éxito se debió al modelo de lenguaje, la interfaz de usuario, el conocimiento disponible, la capacitación o los flujos de trabajo modificados. Quien extraiga promesas generalizadas de retorno de la inversión para un solo componente arquitectónico a partir de estos datos está sobrepasando su capacidad explicativa.
Además, la liberación de tiempo laboral no se traduce automáticamente en una reducción de costes correspondiente. Los beneficios económicos surgen, por ejemplo, cuando una empresa gestiona una mayor demanda, reduce los tiempos de espera, evita las horas extras o asigna a los trabajadores cualificados, aunque escasos, a tareas más exigentes. Sin estos cambios, un ahorro de tiempo cuantificable puede permanecer prácticamente sin aprovechar desde una perspectiva empresarial.
Un cálculo de retorno que incluya todos los costos
Para que un estudio de viabilidad sea viable, primero se debe analizar el proceso actual. Esto incluye el número de casos, los tiempos de procesamiento, las consultas, las correcciones, las escaladas y las consecuencias de las decisiones incorrectas. A continuación, es necesario determinar cuáles de estos factores probablemente se vean influenciados por un significado común. Solo entonces se podrán entablar conversaciones significativas sobre el alcance de la inversión y los beneficios esperados.
En cuanto a los costos, además del software y el uso del modelo, también deben considerarse la integración del sistema, la modelización del negocio, la verificación de identidad, la gestión de accesos, las pruebas y las actualizaciones continuas. La participación de profesionales experimentados, en particular, no es un gasto adicional gratuito. Su tiempo tiene un valor económico y no está disponible para otras tareas durante la implementación.
Una evaluación objetiva también considera las pérdidas iniciales y la incertidumbre. Al principio, una nueva aplicación puede requerir comprobaciones adicionales antes de que sus rutinas se estabilicen. Algunos beneficios solo se hacen evidentes con el uso continuado, mientras que otros no llegan a materializarse. Por lo tanto, un enfoque de inversión por fases con objetivos intermedios verificables suele ser más viable que una gran inversión inicial cuya justificación se basa principalmente en promesas de sinergias futuras.
La medida correcta del éxito
La métrica de éxito más importante es el gasto económico por transacción comercial completada correctamente y conforme a las normas. Esta perspectiva combina velocidad, calidad y control. Evita que una alta tasa de uso o un tiempo de respuesta corto se consideren un éxito si la aplicación genera trabajo adicional.
Para fines de medición, conviene distinguir los diferentes tipos de errores. Una métrica incorrecta es diferente de una excepción contractual pasada por alto. Una notificación incompleta es diferente de una divulgación no autorizada de datos. Asimismo, debe quedar claro si un sistema responde de forma fiable a una pregunta, la transmite legítimamente a un usuario o genera un resultado sin fundamento suficiente.
Una comparación significativa utiliza casos preaprobados y considera todo el proceso. Para procesos adecuados, las implementaciones por fases o los grupos de comparación controlados pueden ayudar a distinguir entre mejoras técnicas y cambios generales. La revisión también debe incluir excepciones poco frecuentes pero económicamente significativas. Un sistema que maneja bien los casos rutinarios pero pasa por alto las excepciones críticas puede resultar convincente en promedio, pero aun así ser inaceptable en la práctica.
La búsqueda vectorial no reemplaza un compromiso vinculante
Las bases de datos vectoriales permiten buscar textos similares relacionados por su contenido, haciendo comparable la información mediante representaciones numéricas llamadas incrustaciones. Los sistemas modernos también pueden utilizar filtros de metadatos, búsquedas por palabras clave y métodos de búsqueda combinados. Por lo tanto, sería incorrecto considerarlas repositorios fundamentalmente independientes del contexto y sin capacidades de filtrado.
Su función principal, sin embargo, responde a una pregunta distinta a la de la gobernanza operativa. La similitud sustantiva no indica automáticamente si un documento está vigente, es jurídicamente vinculante o aplicable a un caso específico. Un sistema de búsqueda puede considerar dichas propiedades si se almacenan de forma fiable y se integran correctamente en la consulta. Sin embargo, por sí solo no determina las decisiones empresariales necesarias.
Esto genera una lógica de inversión clara para las empresas. La mejora en la búsqueda y la ampliación de las capas de significado pueden complementarse. Sin embargo, los resultados de búsqueda adicionales no sustituyen la definición clara de responsabilidades y normas. Quienes intentan corregir todas las respuestas erróneas únicamente con un índice de búsqueda más potente corren el riesgo de proporcionar más información sin clarificar su validez temática.
Plataforma de IA administrada: soluciones de IA más rápidas, seguras e inteligentes con UNFRAME.AI

Plataforma de IA gestionada - Imagen: Xpert.Digital
Aquí aprenderá cómo su empresa puede implementar soluciones de IA personalizadas de forma rápida, segura y sin grandes barreras de entrada.
Una plataforma de IA gestionada es su solución integral y sin preocupaciones para la inteligencia artificial. En lugar de lidiar con tecnología compleja, infraestructura costosa y largos procesos de desarrollo, recibirá una solución lista para usar y adaptada a sus necesidades de un socio especializado, a menudo en tan solo unos días.
Las principales ventajas de un vistazo:
⚡ Implementación rápida: De la idea a la aplicación lista para usar en días, no meses. Ofrecemos soluciones prácticas que generan valor añadido inmediato.
🔒 Máxima seguridad de datos: Tus datos confidenciales permanecen contigo. Garantizamos un procesamiento seguro y conforme a la normativa sin compartirlos con terceros.
💸 Sin riesgo financiero: Solo pagas por resultados. Se eliminan por completo las altas inversiones iniciales en hardware, software y personal.
🎯 Concéntrese en su negocio principal: Concéntrese en lo que mejor sabe hacer. Nos encargamos de toda la implementación técnica, la operación y el mantenimiento de su solución de IA.
📈 A prueba de futuro y escalable: Tu IA crece contigo. Garantizamos la optimización y la escalabilidad continuas, y adaptamos los modelos con flexibilidad a las nuevas necesidades.
Más información aquí:
La influencia de los documentos en las decisiones empresariales
Los grafos de conocimiento pueden hacer mucho más que simplemente crear enlaces
Un grafo de conocimiento representa entidades y sus relaciones en una estructura de red y, por lo tanto, puede constituir un componente importante de una capa semántica. Asimismo, las ontologías formales y los métodos basados en ellas también pueden respaldar inferencias lógicas; estándares establecidos como OWL no se limitan a almacenar conexiones básicas. Por consiguiente, la afirmación categórica de que un grafo de conocimiento no puede representar reglas sería técnicamente incorrecta.
La cuestión crucial reside, en cambio, en qué capacidades combina realmente una solución específica. Un grafo que contiene objetos empresariales no posee automáticamente una gestión integral de derechos, un control de procesos probado ni un manejo profesionalmente aprobado de casos especiales. Por el contrario, una arquitectura de grafo diseñada adecuadamente puede satisfacer gran parte de estos requisitos.
Por lo tanto, una capa semántica debe entenderse menos como un producto necesariamente independiente y más como un conjunto de funciones necesarias. Algunas empresas pueden cubrir gran parte de esto con modelos de BI, catálogos de datos, sistemas de grafos y conjuntos de reglas existentes. Otras necesitan una plataforma adicional. Lo que es económicamente relevante es la brecha funcional comprobada, no la cantidad de nuevas categorías de productos introducidas.
Conectar en lugar de guardar todo de nuevo
Una capa semántica puede conectar los sistemas ERP y CRM existentes, las plataformas de datos y los repositorios de documentos sin necesidad de migrar previamente todos los datos de la empresa a una nueva ubicación de almacenamiento. Los modelos semánticos para los indicadores clave de rendimiento (KPI) también pueden basarse en las estructuras de datos existentes y derivar la lógica de consulta adecuada a partir de ellas. Por lo tanto, el significado compartido es fundamentalmente distinto del almacenamiento físico de los datos.
Sin embargo, esto no significa que dicha arquitectura pueda funcionar sin copiar datos. Los índices de búsqueda, la información extraída de los documentos, las cachés o los resultados precalculados pueden ser útiles para casos de uso específicos. La cuestión empresarial relevante es qué información se necesita almacenar, dónde y durante cuánto tiempo, no si se puede comercializar la promesa de una protección total contra copias.
Un sistema bien diseñado equilibra la puntualidad, el tiempo de respuesta, la disponibilidad, los costos y la privacidad de los datos. Los requisitos de puntualidad pueden variar según el estado del inventario o una cláusula contractual. Una consulta distribuida entre múltiples sistemas de origen puede ser flexible, pero también aumenta la dependencia de su disponibilidad. Por lo tanto, la mejor solución no es necesariamente la más centralizada ni la más distribuida, sino la que mejor se adapta al proceso de negocio.
La calidad de los datos sigue siendo una tarea aparte
Una capa de significado compartida no convierte automáticamente los datos de origen erróneos en correctos. Incluso los proveedores de sistemas de consulta semántica recomiendan abordar las tareas fundamentales de coherencia, como la normalización de objetos comunes y la limpieza de datos inadecuados, lo antes posible. La semántica empresarial y la calidad de los datos son complementarias; no son tareas intercambiables.
Un ejemplo particularmente ilustrativo es la identidad de un socio comercial. Diferentes grafías pueden referirse al mismo proveedor. Sin embargo, nombres similares también pueden pertenecer a distintas entidades legales. Una fusión apresurada de estas puede dar lugar a una asignación incorrecta de información de pago, datos de solvencia o relaciones contractuales. Por lo tanto, una buena arquitectura debe ser capaz de revelar qué asignaciones están confirmadas y cuáles son solo una suposición plausible.
Esto es económicamente importante porque los errores no siempre son visibles donde ocurren. Una coincidencia de identidad inexacta puede influir posteriormente en múltiples análisis y decisiones. Por lo tanto, la implementación debe centrarse no solo en la calidad de las respuestas individuales, sino también en la asignación fiable de los objetos subyacentes. De lo contrario, la reutilización no solo multiplica el conocimiento, sino también sus errores.
Las normas deben ser técnicamente efectivas
Una política plasmada en un documento no constituye un control obligatorio. En las aplicaciones de IA, los conceptos de seguridad distinguen explícitamente entre requisitos lingüísticos y medidas técnicas como funciones restringidas, permisos limitados y condiciones de ejecución verificables. La autonomía excesiva y los derechos de acceso demasiado amplios, en particular, pueden dar lugar a resultados de modelos erróneos o manipulados que desencadenen acciones perjudiciales.
Por lo tanto, una arquitectura robusta debe separar la interpretación de la ejecución. El modelo de lenguaje puede, por ejemplo, clasificar un proceso o sugerir una acción. En los procesos críticos, la verificación de si un importe se ha calculado correctamente, si se ha otorgado la aprobación o si se puede ejecutar una reserva debe estar respaldada, además, por una lógica verificable y los sistemas responsables.
Esto aclara una idea errónea común. Una capa semántica puede proporcionar la base empresarial para un comportamiento que cumpla con las reglas. Sin embargo, por sí sola no garantiza que un modelo de lenguaje probabilístico aplique todas las reglas de forma fiable. La solución económicamente viable surge de la interacción entre el significado, los permisos, las pruebas, los controles de proceso y los cursos de acción claramente definidos.
Los permisos son parte del significado
Al acceder al conocimiento de la empresa, no solo se debe verificar la relevancia, sino también la autorización de acceso. Los controles relacionados con los documentos pueden restringir los resultados de búsqueda según la identidad del usuario y los permisos asignados; su eficacia depende, entre otras cosas, de que la información de autorización esté correctamente sincronizada. Por lo tanto, una base de conocimiento compartida no implica que todos los usuarios puedan ver el mismo contenido.
En la práctica, la dimensión temporal es crucial. Un empleado puede cambiar de rol, un proyecto puede finalizar o un documento puede quedar restringido posteriormente. Si la capa de búsqueda y contexto utiliza permisos obsoletos, puede exponer contenido que ya no está disponible en el sistema de origen. Por lo tanto, el mantenimiento de los permisos debe incluirse explícitamente en los costos operativos.
Incluso preguntas con contenido similar pueden, con razón, recibir respuestas diferentes. Dos usuarios pueden pertenecer a distintas áreas de responsabilidad o tener acceso a diferentes conjuntos de datos. Por lo tanto, la coherencia no implica una redacción idéntica, sino la aplicación de las mismas normas profesionales en un contexto comparable. Una desviación solo constituye un problema de calidad si no puede explicarse por el tiempo, el rol, la disponibilidad de datos o la propia pregunta.
Las correcciones requieren un proceso estructurado
Capturar las correcciones del usuario es uno de los componentes de conocimiento previstos en una capa semántica orientada a la IA. En la gestión de riesgos de la IA, investigar las modificaciones humanas y sus causas también se considera una valiosa fuente de información para evaluar los sistemas implementados. Sin embargo, esto no significa que cada cambio del usuario deba convertirse automáticamente en una regla general.
Un resultado corregido puede tener causas muy diversas. Quizás se asignó incorrectamente un registro de datos. Quizás se aplicó una excepción contractual. Quizás la norma anterior de la empresa estaba desactualizada. O quizás el usuario simplemente ingresó una preferencia personal. Estos casos requieren respuestas diferentes y no deben incorporarse indiscriminadamente a una base de conocimientos compartida.
Un proceso de aprendizaje económicamente viable trata inicialmente la retroalimentación como sugerencias verificables. Los expertos en la materia deciden su alcance, su carácter vinculante y las pruebas necesarias. Solo entonces se pone a disposición un cambio aprobado para su posterior aplicación. Esto no requiere necesariamente volver a entrenar el modelo de lenguaje. Lo fundamental es evitar el error en el contexto adecuado en el futuro, sin introducir inadvertidamente nuevos errores en otros lugares.
El control de versiones protege contra las visiones retrospectivas erróneas
Las definiciones y reglas de negocio cambian; por lo tanto, una capa semántica debe gestionar las versiones de los cambios y asignarlas a expertos en la materia para su aprobación. Las plataformas semánticas existentes ya admiten definiciones versionadas o consultas de referencia validadas, incluyendo información sobre cuándo y quién las confirmó. Por consiguiente, un historial rastreable no es un añadido superfluo, sino una parte integral del uso controlado.
Sin embargo, para una revisión posterior, la norma vigente resulta insuficiente. También es relevante qué versión estaba en vigor en el momento de la transacción y qué información podía procesar el sistema en ese entonces. Una modificación contractual posterior no debe, por error, servir de base para evaluar una decisión anterior. De lo contrario, se crea una aparente claridad retrospectiva que no existía en el momento de la decisión.
Por lo tanto, las empresas deberían considerar conjuntamente el historial de reglas, las versiones de los documentos y el estado de los datos. La rentabilidad en este caso no radica tanto en ahorrar segundos como en reducir los costos de resolución de disputas. Quienes pueden reconstruir la base de una decisión dedican menos tiempo a recopilarla a partir de correos electrónicos, archivos individuales y recordatorios posteriores.
La libertad de modelo aún no implica la libertad del proveedor
El conocimiento empresarial debe organizarse de forma que un cambio en el modelo de lenguaje no requiera automáticamente una reescritura completa de los fundamentos del negocio. El argumento estratégico a favor de esto se ve respaldado por la dinámica técnica: entre noviembre de 2022 y octubre de 2024, el coste de las consultas al modelo se redujo en más de 280 veces con un nivel de rendimiento comparable al de GPT-3.5. Esta comparación se refiere a un nivel de referencia específico y no debe interpretarse como una reducción correspondiente en el coste total de una aplicación empresarial.
No obstante, la conclusión es plausible: cuando el rendimiento y los precios de un modelo cambian significativamente, la opción de cambiar de modelo se vuelve cada vez más valiosa. Un modelo técnico que se pueda utilizar de forma permanente puede evitar que cada actualización tecnológica desencadene un esfuerzo de traducción técnica exhaustivo. La independencia del modelo adquiere así el carácter de una opción estratégica.
Sin embargo, esto no elimina todas las dependencias. Las definiciones aún pueden estar vinculadas a formatos, interfaces o modelos operativos de plataformas propietarias. Por lo tanto, una empresa debe evaluar por separado si puede cambiar de modelo de lenguaje, exportar sus definiciones de conocimiento y continuar utilizando la solución completa con un proveedor diferente. Solo esta distinción permite una evaluación realista de los costos de cambio y del poder de negociación.
El mercado crece en conjunto
Actualmente, se ofrecen definiciones semánticas explícitas tanto para BI como para IA: Snowflake conecta las métricas de negocio y las relaciones entre entidades con consultas y agentes, mientras que dbt también proporciona sus métricas definidas centralmente a través de interfaces para herramientas de IA. Paralelamente, surgió Open Semantic Interchange como una iniciativa para el intercambio de metadatos semánticos independiente del proveedor. El proyecto fue aceptado en la Incubadora Apache en 2026 con el nombre de Apache Ossie.
Este avance tiene mayor relevancia económica que el anuncio de un nuevo producto. Si varias herramientas pueden usar las mismas definiciones, se reduce drásticamente la necesidad de crear nueva lógica de negocio en cada aplicación. Al mismo tiempo, las plataformas de datos consolidadas pueden asumir una mayor parte de la creación de valor que antes estaba reservada a soluciones complementarias especializadas.
Para los clientes, esto significa que, antes de realizar una nueva compra, se debe consultar el inventario. Los modelos de datos existentes, los catálogos de indicadores clave de rendimiento (KPI), los sistemas de autorización y las interfaces pueden cubrir algunos de los requisitos. Los formatos de intercambio abiertos son útiles en este sentido, pero no garantizan su eficacia. Es necesario evaluar si permiten transferir definiciones, reglas e información contextual entre los sistemas en uso sin que se pierda información relevante.
El tejido del conocimiento de Unframe, visto objetivamente
Unframe agrupa sus funciones semánticas bajo el nombre de Knowledge Fabric, conectando conceptos empresariales, lógica de negocio, relaciones y permisos. El objetivo es que los conjuntos de datos estructurados y el contenido de los documentos sean utilizables para casos de uso específicos y que la base de conocimiento se expanda gradualmente. La solución también se ofrece con diversos modelos de lenguaje y se integra con los sistemas empresariales existentes.
El atractivo económico de este concepto reside en la combinación de tareas que antes se realizaban por separado. Si la integración del sistema, el contexto empresarial y el uso controlado funcionan bien en conjunto, se puede reducir el esfuerzo necesario para aplicaciones adicionales. Sin embargo, la viabilidad de esta ventaja en una empresa específica no se puede deducir únicamente del nombre de la arquitectura. Se requieren resultados verificables de los propios procesos de la empresa.
Al mismo tiempo, la cuestión de la propiedad y la operación sigue siendo relevante: Unframe distingue entre los datos, los resultados y las configuraciones de la solución que pertenecen al cliente, por un lado, y la plataforma Knowledge Fabric y otros componentes de la plataforma operados por el proveedor, por otro. Por lo tanto, la libertad de elección del modelo no debe equipararse con una independencia total de la plataforma. Para una evaluación fiable, deben aclararse explícitamente las opciones de exportación, los derechos sobre las definiciones técnicas y la continuidad del sistema en caso de cambio de operador.
Empieza poco a poco, pero mantente adaptable
Un enfoque orientado a la aplicación limita el alcance del modelado y permite revisar las definiciones con los expertos pertinentes mediante tareas reales. En lugar de mapear inmediatamente toda la empresa, primero se capturan los sistemas, objetos, relaciones y reglas necesarios de un proceso claramente definido. Posteriormente, los componentes aprobados pueden ampliarse para incluir casos de uso relacionados.
Desde una perspectiva económica, un proceso con repeticiones frecuentes, resultados verificables y problemas de coordinación suficientemente significativos resulta especialmente adecuado. Un caso de uso demasiado simple podría demostrar únicamente que una ventana de chat puede conectarse a una fuente de datos. Por el contrario, una introducción demasiado compleja puede generar tantos casos especiales sin resolver que los beneficios solo se hacen evidentes después de mucho tiempo.
El equilibrio adecuado reside en un alcance limitado y una base reutilizable. Un proyecto piloto no debe ser un prototipo desechable. Al mismo tiempo, su potencial de integración no debe convertirse en una excusa para desarrollar un modelo de negocio integral antes de la primera mejora tangible. El criterio fundamental sigue siendo determinar qué componentes técnicos son realmente necesarios para el siguiente paso significativo.
La responsabilidad profesional determina la aceptación
La introducción de la IA no traslada la responsabilidad de las personas al software. Toda definición fundamental requiere una autoridad competente que pueda evaluar y aprobar los cambios. Incluso los marcos generales para una IA confiable enfatizan la importancia de definir claramente las funciones y responsabilidades humanas en el manejo de los sistemas de IA. Por lo tanto, la operación técnica y la autoridad experta no deben asignarse tácitamente al mismo rol.
Esto puede resultar inconveniente desde el punto de vista organizativo. Una definición compartida de ingresos, afiliación de clientes o riesgo puede afectar a los sistemas objetivo, las responsabilidades y las prácticas de evaluación existentes. Una capa semántica pone de manifiesto estas diferencias. No las resuelve mediante la elegancia técnica, sino que exige decisiones que antes se podían evitar.
Aquí reside también su valor a largo plazo. Cuando los conceptos y las reglas ya no se limitan al conocimiento de empleados individuales ni se encuentran dispersos en diversas aplicaciones, la empresa puede reducir su dependencia de monopolios de conocimiento informal. Sin embargo, esta ventaja presupone que los especialistas participan en el proceso de diseño y perciben la capa de significado como un apoyo. Si se introduce simplemente como un instrumento de control, la disposición a aportar valioso conocimiento empírico puede disminuir.
No todas las empresas necesitan la misma profundidad
Los datos de uso en Europa revelan diferencias significativas en la escala de implementación de la IA, sin que ello implique necesariamente la necesidad de una arquitectura específica. Además, entre las empresas que habían considerado usar IA pero que aún no lo hacían en 2025, el 70,89 % citó la falta de experiencia relevante como motivo para no usarla; el 52,52 % señaló las consecuencias legales poco claras y el 48,83 % las preocupaciones sobre la privacidad de los datos. Estas cifras se refieren específicamente a este subgrupo y no a todas las empresas.
Esto permite desarrollar una perspectiva de inversión diferenciada. Una pequeña empresa con pocos sistemas y procesos manejables puede requerir inicialmente indicadores clave de rendimiento (KPI) consistentes y bases de conocimiento bien mantenidas. Una corporación con numerosas filiales, líneas de productos y roles de acceso, por otro lado, puede beneficiarse de una infraestructura semántica más completa. El nivel de detalle adecuado depende de la complejidad y el riesgo, no del atractivo de un término tecnológico en particular.
Omitir ciertas tareas también puede resultar económicamente viable. Si una tarea se realiza con poca frecuencia, no tiene consecuencias importantes y puede completarse de forma fiable con un procedimiento sencillo, los costes de mantenimiento de una capa adicional pueden superar sus beneficios. Por lo tanto, un enfoque arquitectónico convincente debe explicar también cuándo no es necesario.
Importancia controlada como ventaja competitiva
La IA generativa puede presentar contenido erróneo de forma convincente; este riesgo figura entre las características y peligros descritos explícitamente para este tipo de sistemas. Incluso la información adicional de la empresa y los métodos de recuperación no eliminan todos los riesgos de seguridad, como los que plantean las instrucciones manipuladas en el contenido procesado. Por lo tanto, una capa semántica no garantiza la veracidad, la seguridad ni la rentabilidad.
Su justificada importancia estratégica reside en otro aspecto. Puede respaldar la transición del conocimiento empírico disperso a definiciones empresariales explícitas, reutilizables y responsables. Esto permite no solo implementar la IA de forma esporádica, sino también integrarla gradualmente en un sistema operativo controlado. El activo perdurable no es, por tanto, el asistente individual, sino la capacidad organizada para aprovechar de forma fiable el conocimiento de la empresa en nuevas tareas.
Por lo tanto, la ventaja competitiva decisiva no reside en tener el mayor número de agentes autónomos, sino en la capacidad de las empresas para reconocer con mayor rapidez qué información es válida, qué excepciones son relevantes y qué acciones siguen estando justificadas. Quienes dominan esta base pueden utilizar los modelos y herramientas cambiantes con mayor eficacia. Quienes la descuidan corren el riesgo, principalmente, de aumentar la velocidad de sus propios malentendidos con cada nueva aplicación de IA.
Consultoría - Planificación - Implementación

Konrad Wolfenstein
Estaré encantado de servir como su asesor personal.
Puedes contactarme en wolfenstein∂xpert.digital o
Llámame al +49 7348 4088 965 .