
Mere end en chatbot: Hvordan et semantisk lag gør AI mere pålidelig i virksomheder – Den undervurderede succesfaktor for virksomheds-AI
Xpert-forhåndsudgivelse

Tilgængelig på 27 sprog 📢
Foretræk Xpert.Digital på GoogleⓘUdgivet den: 1. november 2026 / Opdateret den: 1. november 2026 – Forfatter: Konrad Wolfenstein
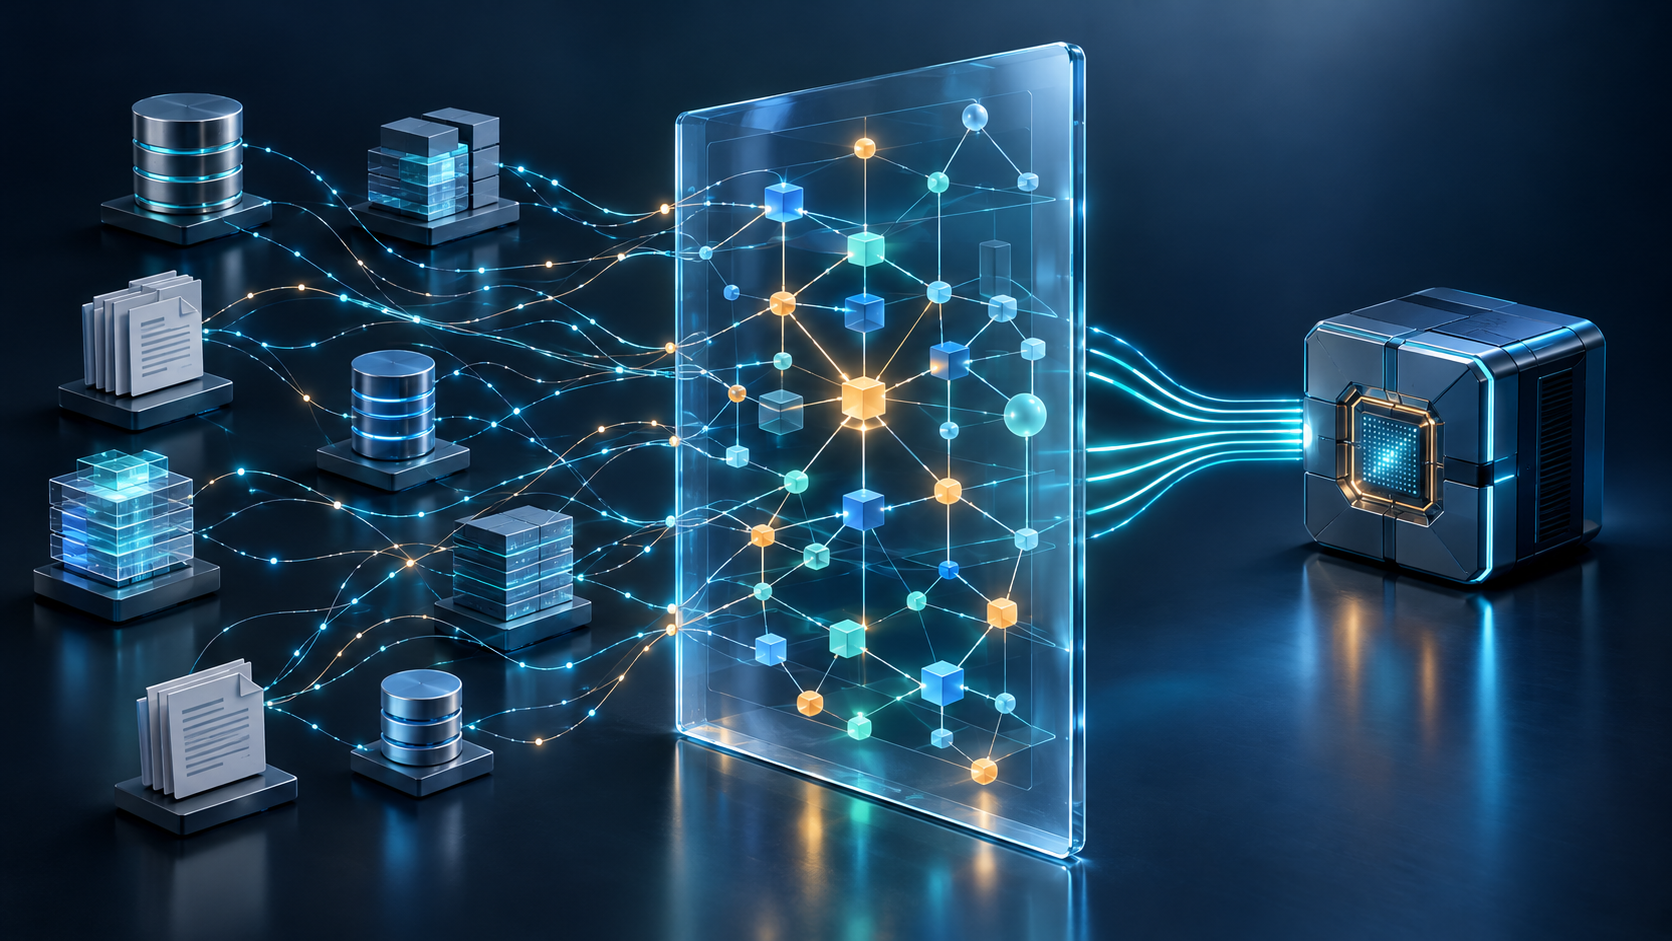
Mere end en chatbot: Hvordan et semantisk lag gør AI mere pålidelig i virksomheder – Den undervurderede succesfaktor for virksomheds-AI – Kreativt billede om emnet med AI: Xpert.Digital
AI i erhvervslivet: Hvorfor klar terminologi bestemmer økonomisk succes
Når AI accelererer kaos: Hvorfor virksomheder har brug for delt forretningsviden
Færre modsætninger, bedre beslutninger: Hvad et semantisk lag kan gøre for virksomheder
Virksomheder investerer i kunstig intelligens for at accelerere processer og træffe bedre beslutninger. Men en stærk sprogmodel alene garanterer ikke forretningsmæssig succes. Hvis salg, finans og kundeservice fortolker nøgleord forskelligt, kan AI levere modstridende svar – og sprede fejl hurtigere. Et semantisk lag sigter mod at løse dette: Det gør termer, relationer og regler brugbare og forståelige på tværs af forskellige applikationer. Dets værdi ligger ikke kun i bedre svar, men også i reduceret koordineringsindsats og genanvendelig virksomhedsviden. Et semantisk lag kan dog afsløre organisatoriske tvetydigheder, men det vil ikke løse dem alene. Derfor er det vigtige, hvordan virksomheder kortlægger deres forretningsvirkelighed, definerer professionelle ansvarsområder og måler de faktiske fordele.
Relateret til dette:
Semantisk lag for virksomheds-AI: Hvorfor forretningsrelevans bestemmer AI-investeringsafkast
Uden klare koncepter automatiserer AI kaos
Et semantisk lag gør forretningstermer, relationer og regler delte og verificerbare for AI-applikationer. Dets økonomiske værdi ligger derfor ikke kun i bedre svar, men også i udsigten til reduceret koordineringsindsats, genanvendelig forretningsviden og mere kontrollerbare beslutninger. Den afgørende begrænsning er imidlertid, at et sådant semantisk lag kan afsløre organisatorisk tvetydighed, men ikke kan løse den alene.
For virksomheder ændrer dette det strategiske spørgsmål. Det handler ikke længere udelukkende om, hvilken sprogmodel der er mest effektiv, eller hvor hurtigt en anden assistent kan udvikles. Det, der bliver vigtigere, er den forretningsmæssige virkelighed, disse systemer er baseret på. Hvis salg, finans og kundeservice bruger det samme udtryk forskelligt, kan en teknisk kraftfuld AI sprede modstridende resultater endnu hurtigere og mere bredt. Den økonomiske udfordring ligger i at omdanne spredt information til et robust, permanent brugbart grundlag for beslutningstagning.
Forskellen mellem brug og resultat
Udbredelsen af AI er stigende, men brugen af AI har endnu ikke vist sig at have en økonomisk effekt. I 2025 brugte 19,95 procent af de undersøgte EU-virksomheder med ti eller flere ansatte mindst én AI-teknologi; dette repræsenterede en stigning på 6,47 procentpoint i forhold til 2024. Der var betydelige forskelle mellem virksomhedsstørrelser: andelen var 17 procent for små virksomheder, 30,36 procent for mellemstore virksomheder og 55,03 procent for store virksomheder. Undersøgelsen omfattede et bredt spektrum af AI-teknologier, fra tekstanalyse til autonome maskiner, men fokuserede ikke specifikt på brugen af generativ AI eller semantiske lag.
Et andet billede tegner sig i en international virksomhedsundersøgelse foretaget i 2026. I denne undersøgelse rapporterede 80 procent af respondenterne forbedret personlig produktivitet på grund af AI, mens 37 procent angav et positivt bidrag til deres virksomheds indtjening før renter og skat (EBIT). Kun omkring 6 procent tilhørte en særlig succesfuld gruppe, der tilskrev mindst 5 procent af deres EBIT til AI og samtidig rapporterede betydelige fordele. Undersøgelsen omfattede 1.719 deltagere fra 97 lande og var baseret på selvrapporterede data; den er derfor ikke direkte sammenlignelig med europæisk virksomhedsstatistik.
Figurerne beviser ikke en årsagssammenhæng mellem et semantisk lag og et fælles lag. De illustrerer snarere forretningsproblemet: Mellem individuel arbejdsforenkling og målbar forretningssucces ligger en organisatorisk oversættelsesindsats. Det er netop i denne grænseflade, at et fælles lag af betydning bliver relevant.
Vigtighed bliver en del af den operationelle infrastruktur
Et semantisk lag forbinder tekniske datastrukturer med forretningskoncepter som kunde, kontrakt, krav eller omsætning. Det beskriver f.eks. hvilke datafelter der tilhører en kunde, hvordan en nøglepræstationsindikator (KPI) beregnes, og under hvilke betingelser en specifik status gælder. Dette giver forskellige applikationer mulighed for at stole på fælles definitioner i stedet for at udlede deres egne fortolkninger fra tabeletiketter eller dokumenter.
Et simpelt eksempel illustrerer implikationerne. En virksomhed kunne definere en aktiv kunde i salg ud fra løbende samtaler, i finans ud fra registrerede forretningstransaktioner og i service ud fra eksisterende servicekrav. Ingen af disse perspektiver er nødvendigvis forkerte. Problemet opstår, når en AI utilsigtet blander dem eller præsenterer ét perspektiv som universelt gyldigt.
Den økonomisk forsvarlige løsning består derfor ikke altid af én definition til alle formål. Ofte er der behov for flere klart navngivne, professionelt ansvarlige definitioner med utvetydige anvendelsesgrænser. Et fælles betydningslag bør afspejle forskelle på en kontrolleret måde, ikke kunstigt skabe en ensartethed, som virksomheden faktisk ikke besidder. Målet er forståelig fortolkning, ikke begrebsmæssig homogenisering.
Fra rapport til operationel beslutning
Klassiske semantiske modeller til business intelligence fokuserer primært på nøgletal, dimensioner, aggregeringer og relationerne mellem dataobjekter. Det ville dog være en forenkling helt at nægte dem forretningslogik eller autorisationsfunktioner: Etablerede BI-systemer, for eksempel, supportrelationer, beregnede nøgletal og rollebaseret dataadgang. Derfor er grænsen mellem et BI-semantisk lag og et AI-semantisk lag ikke en klar teknologisk skel.
Hovedforskellen ligger i kravene. En rapport skal for eksempel repræsentere omsætningen præcist. En operationel AI-applikation skal derimod også kunne bestemme, hvilken kontrakt der tilhører en proces, hvilken særlig aftale der har forrang, og om det næste trin kræver godkendelse. Dette udvider opgaven fra konsekvent analyse til kontekstafhængig beslutningsstøtte.
Økonomisk set øger dette både de potentielle fordele og potentialet for skade. En dårligt defineret rapport kan bane vejen for en fejlagtig beslutning. En handlingsrettet assistent kan implementere den med det samme. Jo tættere AI kommer på ordrer, betalinger, prisforpligtelser eller kundebeslutninger, desto mere afgørende bliver sondringen mellem plausibel fortolkning og bindende udførelseslogik.
De fire byggesten i forretningsviden
Et omfattende betydningslag for virksomhedens AI bør overveje fire typer af viden: entitetsdefinitioner, relationer, beslutningsregler og indsamlede rettelser. Enhedsdefinitioner specificerer, hvad der udgør et forretningsobjekt, såsom en aktiv kunde, en kritisk kontrakt eller en sag med høj risiko. Relationer forbinder sådanne objekter, såsom et datterselskab, med en konto eller en kontraktændring med den tilsvarende hovedkontrakt.
Beslutningsregler beskriver tærskler, undtagelser, ansvar og godkendelsesbetingelser. Indsamlede rettelser registrerer, hvor fageksperter har rettet fejlagtige resultater. Kun i kombination kan dette udvikles til mere end blot en bekvem søgefunktion: et transparent grundlag for, hvordan information kan fortolkes, og inden for hvilke rammer.
Fra et økonomisk perspektiv skal disse typer viden værdsættes forskelligt. En kundedefinition kan genbruges på tværs af mange applikationer. En undtagelsesbeslutning kan derimod kun gælde for en specifik kontrakt. En god arkitektur skal derfor ikke kun lagre viden, men også begrænse dens omfang. Ellers omdanner den en lokal undtagelse til en generel regel og forværrer netop den fejl, den er beregnet til at forhindre.
Hvorfor dokumenter er afgørende for virksomhedsledelse
Et AI-drevet semantisk lag skal ikke kun kunne forbinde strukturerede data, men også kontrakter, e-mails, rapporter og mødereferater med de tilsvarende forretningstransaktioner. Årsagen er umiddelbart indlysende: En databasepost kan indeholde den aftalte standardpris, mens en godkendt tillægsaftale fastsætter andre betingelser. Enhver, der kun analyserer datasættet, kan overse den økonomisk bindende undtagelse.
Den udfordrende del ligger ikke blot i at finde en klausul. Den ligger i at bestemme dens status. Et udkast er ikke en underskrevet aftale. Et internt mødenotat erstatter ikke godkendelse. Et senere dokument kan supplere, delvist erstatte eller gælde for et andet omfang end en tidligere regel. Disse sondringer skal eksplicit modelleres og gennemgås for hver specifik anvendelsesscenarie.
Dette fører til et vigtigt økonomisk perspektiv: Værdien af dokumentanalyse måles ikke i antallet af behandlede sider. Den opstår kun, når pålidelige udsagn om krav, forpligtelser, deadlines eller handlingsplaner kan udledes af den. Et hurtigt resumé uden verifikation af indholdet kan derimod medføre yderligere revisionsomkostninger og skabe en falsk følelse af sikkerhed.
Fire omkostningskilder på grund af semantisk tvetydighed
Den økonomiske effekt kan forstås gennem fire omkostningskategorier. For det første opstår søgeomkostninger, når medarbejdere skal indsamle information og forstå dens betydning. For det andet opstår koordineringsomkostninger, når afdelinger forklarer og afstemmer forskellige analyser. For det tredje opstår fejlomkostninger, når forkerte klassifikationer eller regler fører til omarbejdelse og mangelfulde beslutninger. For det fjerde opstår gentagelsesomkostninger, når hvert nyt AI-projekt kræver en ny udvikling af det samme tekniske grundlag.
Denne klassificering er en analytisk evalueringsramme, ikke en empirisk målt omkostningsfordeling. Den hjælper dog med at undgå en almindelig misforståelse: Investeringsafkastet for et semantisk lag bør ikke udelukkende afhænge af en assistents responshastighed. Et svar kan dukke op på få sekunder og stadig være dyrt, hvis flere specialister efterfølgende skal verificere dets nøjagtighed.
Omvendt kan en tilsyneladende ubetydelig forbedring skabe betydelig værdi. Hvis en bindende definition forkorter koordineringen mellem finansafdelingen og salg, kan fordelen påvirke adskillige rapporter og beslutninger samtidigt. Derfor er den relevante økonomiske enhed ikke altid den enkelte AI-dialog, men hele forretningsprocessen, inklusive dens kontrol- og korrektionsløkker.
Genbrug skaber stordriftsfordele
Fælles definitioner af nøglepræstationsindikatorer (KPI'er) kan undgå dobbelt implementering og gøre den samme forretningslogik tilgængelig på tværs af forskellige applikationer. Anvendt på en bredere AI-arkitektur er dette det centrale løfte om skalerbarhed: Allerede frigivne termer, relationer og regler bør fortsat kunne bruges til andre anvendelsesscenarier. Dette omdanner det semantiske lag til en potentiel infrastrukturinvestering snarere end en isoleret projektkomponent.
Den økonomiske logik ligner den for en delt ressource. Dens oprindelige oprettelse medfører omkostninger, mens yderligere brugere kan udnytte eksisterende komponenter. Fordelen øges dog kun, hvis de nye use cases rent faktisk udviser tilstrækkelig overlapning i ekspertise. En anden assistent inden for samme serviceområde kan trække på mere eksisterende viden end en applikation til et helt andet forretningsområde.
Derfor ville det være urealistisk at forvente automatisk faldende omkostninger med hvert efterfølgende AI-projekt. Nye juridiske rammer, produktfamilier eller forretningsmodeller kan kræve omfattende tilføjelser. De pålidelige stordriftsfordele ligger ikke i, at senere projekter bliver gratis, men snarere i, at allerede afklarede problemstillinger ikke behøver at afklares igen uden objektiv begrundelse.
Produktivitet kræver en nøgtern vurdering
En undersøgelse af 5.172 kundeservicemedarbejdere viste, at adgang til en generativ AI-assistent resulterede i en gennemsnitlig stigning på cirka 15 procent i løste kundehenvendelser i timen. Effekten var dog ujævnt fordelt: Mindre erfarne og lavtuddannede medarbejdere havde større gavn af det, mens meget erfarne og højtydende medarbejdere kun oplevede små stigninger i hastighed og i nogle tilfælde et lille fald i kvalitet. Undersøgelsen demonstrerer således en konkret produktivitetseffekt inden for et specifikt arbejdsmiljø snarere end det isolerede investeringsafkast fra et semantisk lag.
Denne sondring er afgørende for økonomisk evaluering. En vellykket implementering af AI afslører ikke, hvilken andel af succesen der kan tilskrives sprogmodellen, brugergrænsefladen, tilgængelig viden, træning eller ændrede arbejdsgange. Enhver, der udleder generelle løfter om investeringsafkast for en enkelt arkitektonisk komponent fra disse data, overskrider dens forklaringskraft.
Desuden resulterer frigjort arbejdstid ikke automatisk i en tilsvarende omkostningsreduktion. Økonomiske fordele opstår f.eks., når en virksomhed håndterer øget efterspørgsel, reducerer ventetider, undgår overarbejde eller indsætter knappe faglærte medarbejdere til mere krævende opgaver. Uden sådanne ændringer kan en målbar tidsbesparelse stort set forblive uudnyttet fra et forretningsperspektiv.
En afkastberegning inklusive alle omkostninger
En levedygtig business case bør først analysere den nuværende proces. Dette inkluderer sagsnumre, behandlingstider, forespørgsler, rettelser, eskaleringer og konsekvenserne af forkerte beslutninger. Dernæst er det nødvendigt at bestemme, hvilke af disse faktorer der sandsynligvis vil blive påvirket af et fælles betydningslag. Først derefter kan meningsfulde diskussioner om investeringsomfanget og de forventede fordele finde sted.
På omkostningssiden bør man, udover software- og modelbrug, også overveje systemintegration, forretningsmodellering, identitetsverifikation, adgangsstyring, test og løbende opdateringer. Især inddragelse af erfarne fagfolk er ikke en gratis ekstraudgift. Deres tid har økonomisk værdi og er ikke tilgængelig til andre opgaver under implementeringen.
En nøgtern vurdering tager også højde for opstartstab og usikkerhed. I starten kan en ny applikation kræve yderligere kontrol, før rutinerne stabiliseres. Nogle fordele bliver først tydelige med yderligere use cases, mens andre ikke realiseres. Derfor er en faseopdelt investeringstilgang med verificerbare mellemmål ofte mere plausibel end en stor forudgående investering, hvis begrundelse primært hviler på løfter om fremtidige synergier.
Det rette mål for succes
Den vigtigste succesmåling er de økonomiske udgifter pr. korrekt og overensstemmende gennemført forretningstransaktion. Dette perspektiv kombinerer hastighed, kvalitet og kontrol. Det forhindrer, at en høj udnyttelsesgrad eller en kort svartid betragtes som en succes, hvis applikationen genererer yderligere efterarbejde.
Der bør skelnes mellem forskellige typer fejl i forbindelse med målinger. En forkert måleenhed er forskellig fra en overset kontraktlig undtagelse. En ufuldstændig anmeldelse er forskellig fra en uautoriseret videregivelse af data. Ligeledes skal det være klart, om et system besvarer et spørgsmål pålideligt, legitimt videregiver det til et menneske eller udsender et resultat uden tilstrækkeligt grundlag.
En meningsfuld sammenligning bruger forhåndsgodkendte sager og tager hele processen i betragtning. For egnede processer kan fasede implementeringer eller kontrollerede sammenligningsgrupper hjælpe med at skelne mellem tekniske forbedringer og generelle ændringer. Gennemgangen bør også omfatte sjældne, men økonomisk betydelige undtagelser. Et system, der håndterer rutinesager godt, men overser kritiske undtagelser, kan i gennemsnit være overbevisende, men stadig være uacceptabelt i praksis.
Vektorsøgning erstatter ikke en bindende forpligtelse
Vektordatabaser understøtter søgningen efter indholdsrelaterede lignende tekster ved at gøre information sammenlignelig gennem numeriske repræsentationer kaldet indlejringer. Moderne systemer kan desuden bruge metadatafiltre, nøgleordssøgninger og kombinerede søgemetoder. Det ville derfor være forkert at fremstille dem som fundamentalt kontekstfrie arkiver uden filtreringsfunktioner.
Dets kernefunktion besvarer imidlertid et andet spørgsmål end spørgsmålet om operationel styring. Væsentlig lighed angiver ikke automatisk, om et dokument er aktuelt, juridisk bindende eller anvendeligt i en specifik sag. Et søgesystem kan tage sådanne egenskaber i betragtning, hvis de er pålideligt lagret og korrekt integreret i forespørgslen. Det bestemmer dog ikke selv de nødvendige forretningsbeslutninger.
Dette fører til en klar investeringslogik for virksomheder. Forbedret søgning og forbedrede betydningslag kan supplere hinanden. Yderligere søgeresultater kan dog ikke erstatte klart definerede ansvarsområder og regler. De, der forsøger at rette ethvert fejlagtigt svar udelukkende med et mere kraftfuldt søgeindeks, risikerer at levere mere materiale uden at præcisere dets emnemæssige gyldighed.
🤖🚀 Administreret AI-platform: Hurtigere, sikrere og smartere AI-løsninger med UNFRAME.AI

Administreret AI-platform - Billede: Xpert.Digital
Her lærer du, hvordan din virksomhed kan implementere skræddersyede AI-løsninger hurtigt, sikkert og uden høje adgangsbarrierer.
En administreret AI-platform er din altomfattende og bekymringsfri løsning til kunstig intelligens. I stedet for at skulle håndtere kompleks teknologi, dyr infrastruktur og langvarige udviklingsprocesser, får du en færdiglavet løsning skræddersyet til dine behov fra en specialiseret partner – ofte inden for få dage.
De vigtigste fordele på et overblik:
⚡ Hurtig implementering: Fra idé til brugsklar applikation på dage, ikke måneder. Vi leverer praktiske løsninger, der skaber øjeblikkelig merværdi.
🔒 Maksimal datasikkerhed: Dine følsomme data forbliver hos dig. Vi garanterer sikker og kompatibel behandling uden at dele data med tredjeparter.
💸 Ingen økonomisk risiko: Du betaler kun for resultater. Store forudgående investeringer i hardware, software eller personale elimineres fuldstændigt.
🎯 Fokuser på din kerneforretning: Koncentrer dig om det, du er bedst til. Vi tager os af hele den tekniske implementering, drift og vedligeholdelse af din AI-løsning.
📈 Fremtidssikret og skalerbar: Din AI vokser med dig. Vi sikrer løbende optimering og skalerbarhed og tilpasser modellerne fleksibelt til nye krav.
Mere information her:
Dokumenters indflydelse på forretningsbeslutninger
Vidensgrafer kan mere end blot links
En vidensgraf repræsenterer enheder og deres relationer i en netværksstruktur og kan derfor danne en vigtig komponent i et semantisk lag. Samtidig kan formelle ontologier og metoder, der er bygget på dem, også understøtte logiske inferenser; etablerede standarder som OWL er ikke begrænset til blot at lagre basale forbindelser. Den generelle påstand om, at en vidensgraf i princippet ikke kan repræsentere regler, ville derfor være teknisk unøjagtig.
Det afgørende spørgsmål er i stedet, hvilke funktioner en specifik løsning rent faktisk kombinerer. En graf, der indeholder virksomhedsobjekter, besidder ikke automatisk omfattende rettighedsstyring, testet proceskontrol eller en professionelt godkendt håndtering af særlige tilfælde. Omvendt kan en passende designet grafarkitektur opfylde betydelige dele af disse krav.
Et semantisk lag bør derfor forstås mindre som et nødvendigvis selvstændigt produkt og mere som en samling af nødvendige funktioner. Nogle virksomheder kan dække store dele af dette med eksisterende BI-modeller, datakataloger, grafsystemer og regelsæt. Andre har brug for en yderligere platform. Det økonomisk relevante er det dokumenterede funktionelle hul, ikke antallet af nyligt introducerede produktkategorier.
Opret forbindelse i stedet for at gemme alt igen
Et semantisk lag kan forbinde eksisterende ERP- og CRM-systemer, dataplatforme og dokumentlagre uden først at skulle migrere alle virksomhedsdata til en enkelt ny lagringsplacering. Semantiske modeller for nøglepræstationsindikatorer (KPI'er) kan også bygge på eksisterende datastrukturer og udlede den passende forespørgselslogik fra dem. Den fælles betydning er derfor fundamentalt forskellig fra den fysiske lagring af dataene.
Dette betyder dog ikke, at en sådan arkitektur kan fungere uden nogen form for datakopiering. Søgeindekser, udtrukne dokumentoplysninger, cacher eller forudberegnede resultater kan være nyttige til specifikke anvendelsesscenarier. Det relevante forretningsspørgsmål er, hvilke oplysninger der skal gemmes, hvor og hvor længe, ikke om løftet om fuldstændig kopibeskyttelse kan markedsføres.
Et veldesignet system balancerer aktualitet, svartid, tilgængelighed, omkostninger og databeskyttelse. Der kan gælde andre aktualitetskrav for en lagerstatus end for en kontraktklausul. En forespørgsel distribueret på tværs af mange kildesystemer kan være fleksibel, men den øger også afhængigheden af deres tilgængelighed. Derfor er den bedste løsning ikke nødvendigvis maksimalt centraliseret eller maksimalt distribueret, men snarere passende til forretningsprocessen.
Datakvalitet forbliver en separat opgave
Et fælles betydningslag gør ikke automatisk fejlagtige kildedata korrekte. Selv udbydere af semantiske forespørgselssystemer anbefaler at adressere grundlæggende konsistensopgaver, såsom normalisering af almindelige objekter og rensning af uegnede data, så tidligt som muligt. Forretningssemantik og datakvalitet er komplementære; de er ikke udskiftelige opgaver.
Et særligt illustrativt eksempel er identiteten af en forretningspartner. Forskellige stavemåder kan henvise til den samme leverandør. Imidlertid kan lignende navne også tilhøre forskellige juridiske enheder. En forhastet sammenlægning af disse kan derefter føre til forkert tildeling af betalingsoplysninger, kreditværdighedsdata eller kontraktforhold. En god arkitektur skal derfor kunne afsløre, hvilke tildelinger der er bekræftede, og hvor der kun er en plausibel antagelse.
Dette er økonomisk vigtigt, fordi fejl ikke altid er synlige, hvor de opstår. En unøjagtig identitetsmatch kan senere påvirke flere analyser og beslutninger. Derfor bør implementeringen ikke kun fokusere på kvaliteten af individuelle svar, men også på den pålidelige tildeling af de underliggende objekter. Ellers multiplicerer genbrug ikke kun viden, men også dens fejl.
Reglerne skal være teknisk effektive
En politik i et dokument udgør ikke tvungen kontrol. For AI-applikationer skelner sikkerhedskoncepter eksplicit mellem sproglige krav og tekniske foranstaltninger såsom begrænsede funktioner, begrænsede tilladelser og verificerbare udførelsesbetingelser. Især overdreven autonomi og for brede adgangsrettigheder kan føre til fejlbehæftede eller manipulerede modeloutput, der udløser skadelige handlinger.
En robust arkitektur bør derfor adskille fortolkning og udførelse. Sprogmodellen kan for eksempel klassificere en proces eller foreslå en handling. Om et beløb er beregnet korrekt, om godkendelse er givet, eller om en booking kan udføres, bør i kritiske processer yderligere sikres af verificerbar logik og de ansvarlige systemer.
Dette afklarer en almindelig misforståelse. Et semantisk lag kan danne det forretningsmæssige fundament for regelkompatibel adfærd. Det garanterer dog ikke i sig selv, at en probabilistisk sprogmodel pålideligt vil anvende alle regler. Den økonomisk rentable løsning opstår i samspillet mellem betydning, tilladelser, test, proceskontroller og klart definerede handlingsplaner.
Tilladelser er en del af betydningen
Når man tilgår virksomhedsviden, skal ikke kun relevansen, men også adgangsautorisationen kontrolleres. Dokumentrelaterede kontroller kan begrænse søgeresultater baseret på brugerens identitet og tildelte rettigheder; deres effektivitet afhænger blandt andet af korrekt synkroniserede autorisationsoplysninger. En delt vidensbase betyder derfor ikke, at alle brugere har tilladelse til at se det samme indhold.
I praksis er den tidsmæssige dimension afgørende. En medarbejder kan skifte rolle, et projekt kan afsluttes, eller et dokument kan efterfølgende begrænses. Hvis søge- og kontekstlaget bruger forældede tilladelser, kan det eksponere indhold, der ikke længere er tilgængeligt i kildesystemet. Derfor skal vedligeholdelse af tilladelser eksplicit inkluderes i driftsomkostningerne.
Selv spørgsmål med lignende indhold kan med god grund få forskellige svar. To brugere kan tilhøre forskellige ansvarsområder eller have adgang til forskellige datasæt. Konsistens betyder derfor ikke identisk formulering, men snarere de samme faglige regler i en sammenlignelig kontekst. En afvigelse udgør kun et kvalitetsproblem, hvis den ikke kan forklares med tid, rolle, datatilgængelighed eller selve spørgsmålet.
Rettelser kræver en struktureret proces
Registrering af brugerrettelser er en af de tilsigtede videnskomponenter i et AI-orienteret semantisk lag. Inden for AI-risikostyring betragtes undersøgelse af menneskelige overstyringer og deres årsager også som en værdifuld informationskilde til evaluering af implementerede systemer. Dette betyder dog ikke, at enhver brugerændring automatisk skal blive en generel regel.
Et korrigeret resultat kan have meget forskellige årsager. Måske blev en datapost forkert tildelt. Måske var der en kontraktmæssig undtagelse. Måske var den tidligere virksomhedsregel forældet. Eller måske har brugeren blot indtastet en personlig præference. Disse tilfælde kræver forskellige svar og bør ikke integreres vilkårligt i en delt vidensbase.
En økonomisk forsvarlig læringsproces behandler i første omgang feedback som verificerbare forslag. Fageksperter beslutter dens omfang, bindende karakter og de nødvendige tests. Først derefter stilles en godkendt ændring til rådighed for yderligere anvendelser. Dette kræver ikke nødvendigvis omskoling af sprogmodellen. Det afgørende er, at fejlen undgås i den relevante kontekst i fremtiden, uden utilsigtet at introducere nye fejl andre steder.
Versionsstyring beskytter mod falske retrospektive synspunkter
Forretningsdefinitioner og -regler ændres; derfor bør et semantisk lag versionskontrollere ændringer og tildele dem til fageksperter til godkendelse. Eksisterende semantiske platforme understøtter allerede versionsbaserede definitioner eller validerede referenceforespørgsler, herunder information om hvornår og af hvem de blev bekræftet. En sporbar historik er således ikke en dekorativ tilføjelse, men en integreret del af kontrolleret brug.
Til en senere gennemgang er den gældende regel dog utilstrækkelig. Det er også relevant, hvilken version der var gældende på tidspunktet for transaktionen, og hvilke oplysninger systemet rent faktisk var i stand til at behandle på det tidspunkt. En efterfølgende modtaget kontraktændring må ikke utilsigtet blive grundlaget for evaluering af en tidligere beslutning. Ellers opstår der i bakspejlet en form for klarhed, som ikke eksisterede på tidspunktet for beslutningen.
Virksomheder bør derfor se på regelhistorik, dokumentversioner og datastatus i et samlet perspektiv. Omkostningseffektiviteten her handler mindre om at spare sekunder end om at reducere omkostningerne ved at løse tvister. De, der kan rekonstruere grundlaget for en beslutning, bruger mindre tid på at sammensætte den ud fra e-mails, individuelle filer og efterfølgende påmindelser.
Modelfrihed er endnu ikke leverandørfrihed
Virksomhedsviden bør organiseres på en sådan måde, at en ændring i sprogmodellen ikke automatisk kræver en fuldstændig omskrivning af forretningsgrundlaget. Det strategiske argument for dette understøttes af den tekniske dynamik: Mellem november 2022 og oktober 2024 faldt omkostningerne ved modelforespørgsler med mere end en faktor 280 på et ydelsesniveau, der kan sammenlignes med GPT-3.5. Denne sammenligning refererer til et specifikt benchmarkniveau og bør ikke fortolkes som en tilsvarende reduktion i de samlede omkostninger ved en virksomhedsapplikation.
Ikke desto mindre er konklusionen plausibel: Når modelydelse og priser ændrer sig markant, bliver muligheden for at skifte stadig mere værdifuld. En permanent brugbar teknisk model kan forhindre, at enhver teknologisk opgradering udløser en omfattende teknisk oversættelsesindsats. Modeluafhængighed får således karakter af en strategisk mulighed.
Det eliminerer dog ikke alle afhængigheder. Definitioner kan stadig være knyttet til proprietære platformformater, grænseflader eller driftsmodeller. Derfor bør en virksomhed separat vurdere, om den kan skifte sprogmodel, eksportere sine videndefinitioner og fortsætte med at køre hele løsningen hos en anden udbyder. Kun denne sondring muliggør en realistisk evaluering af omkostninger til skift og forhandling af gearing.
Markedet vokser sammen
Semantiske definitioner tilbydes nu eksplicit for både BI og AI: Snowflake forbinder forretningsmålinger og entitetsrelationer med forespørgsler og agenter, mens dbt også leverer sine centralt definerede målinger via grænseflader til AI-værktøjer. Parallelt hermed opstod Open Semantic Interchange som et initiativ til leverandørneutral udveksling af semantiske metadata. Projektet blev accepteret i Apache Incubator i 2026 under navnet Apache Ossie.
Denne udvikling er mere økonomisk betydningsfuld end endnu en produktlancering. Hvis flere værktøjer kan bruge de samme definitioner, reduceres behovet for at skabe ny forretningslogik i hver applikation fundamentalt. Samtidig kan etablerede dataplatforme overtage større dele af den værdiskabelse, der tidligere var forbeholdt specialiserede tillægsløsninger.
For kunder betyder det: Før der foretages et nyt køb, bør der laves en opgørelse. Eksisterende datamodeller, KPI-kataloger (Key Performance Indicators), autorisationssystemer og grænseflader kan dække nogle af kravene. Åbne udvekslingsformater er nyttige i denne henseende, men de er ikke et fuldstændigt bevis på effektivitet. De skal bedømmes ud fra, hvilke definitioner, regler og kontekstuel information der kan overføres mellem de systemer, der faktisk er i brug, uden tab af mening.
Unframevidensstof, set objektivt
Unframe samler sine semantiske funktioner under navnet Knowledge Fabric, der forbinder virksomhedskoncepter, forretningslogik, relationer og tilladelser. Tilgangen sigter mod at gøre strukturerede datasæt og dokumentindhold brugbart til specifikke use cases og gradvist udvide vidensbasen. Løsningen tilbydes også med forskellige sprogmodeller og integration i eksisterende virksomhedssystemer.
Den økonomiske appel ved dette koncept ligger i kombinationen af tidligere adskilte opgaver. Hvis systemintegration, forretningskontekst og kontrolleret brug fungerer godt sammen, kan den nødvendige indsats til yderligere applikationer reduceres. Om denne fordel realiseres i en specifik virksomhed, kan dog ikke udledes alene af det arkitektoniske navn. Der er behov for verificerbare resultater fra virksomhedens egne processer.
Samtidig er spørgsmålet om ejerskab og drift fortsat relevant: Unframe skelner mellem kundeejede data, resultater og løsningskonfigurationer på den ene side og den udbyderdrevne Knowledge Fabric og andre platformkomponenter på den anden side. Derfor bør valgfrihed vedrørende modellen ikke sidestilles med fuldstændig uafhængighed af platformen. For en pålidelig vurdering bør eksportmuligheder, rettigheder til tekniske definitioner og systemets kontinuitet i tilfælde af et operatørskifte eksplicit præciseres.
Start småt, forbliv tilpasningsdygtig
En anvendelsesorienteret tilgang begrænser modelleringens omfang og giver mulighed for at gennemgå definitioner med de relevante fageksperter ved hjælp af opgaver fra den virkelige verden. I stedet for straks at kortlægge hele virksomheden, registreres først de nødvendige systemer, objekter, relationer og regler for en klart defineret proces. Godkendte komponenter kan derefter udvides til at omfatte relaterede use cases.
Fra et økonomisk perspektiv er en proces med hyppige gentagelser, verificerbare resultater og tilstrækkeligt betydelige koordineringsproblemer særligt velegnet. En alt for simpel use case kan muligvis kun demonstrere, at et chatvindue kan forbindes til en datakilde. Omvendt kan en alt for kompleks introduktion skabe så mange uløste særtilfælde, at fordelene først bliver tydelige efter lang tid.
Den rette balance ligger mellem et begrænset omfang og et genbrugeligt fundament. Et pilotprojekt bør ikke være en prototype, der bare smides væk. Samtidig bør dets integrationspotentiale ikke blive en undskyldning for at opbygge en omfattende forretningsmodel før den første målbare forbedring. Det afgørende er fortsat, hvilke tekniske byggesten der rent faktisk er nødvendige for det næste meningsfulde skridt.
Professionelt ansvar bestemmer accept
Introduktionen af AI flytter ikke ansvaret fra mennesker til software. Enhver central definition kræver en kompetent myndighed, der kan vurdere og godkende ændringer. Selv overordnede rammer for pålidelig AI understreger klart definerede menneskelige roller og ansvar i håndteringen af AI-systemer. Derfor bør teknisk drift og ekspertmyndighed ikke stiltiende tildeles den samme rolle.
Dette kan være organisatorisk ubelejligt. En fælles definition af omsætning, kundetilhørsforhold eller risiko kan påvirke målsystemer, ansvar og eksisterende evalueringspraksis. Et semantisk lag afslører sådanne forskelle. Det løser dem ikke gennem teknisk elegance, men nødvendiggør snarere beslutninger, der tidligere kunne være blevet undgået.
Det er også her, dens langsigtede værdi ligger. Når koncepter og regler ikke længere udelukkende er begrænset til de enkelte medarbejderes tanker eller spredt ud over forskellige applikationer, kan virksomheden blive mindre afhængig af uformelle vidensmonopoler. Denne fordel forudsætter dog, at specialister er involveret i designprocessen og oplever meningslaget som støttende. Hvis det blot introduceres som et kontrolinstrument, kan viljen til at bidrage med værdifuld erfaringsbaseret viden falde.
Ikke alle virksomheder har brug for den samme dybde
Europæiske brugsdata afslører betydelige forskelle i omfanget af implementering af AI, uden nødvendigvis at indikere et behov for en specifik arkitektur. Desuden angav 70,89 procent blandt virksomheder, der havde overvejet at bruge AI, men endnu ikke gjorde det i 2025, mangel på relevant ekspertise som en grund til ikke at bruge det; 52,52 procent pegede på uklare juridiske konsekvenser, og 48,83 procent på bekymringer om databeskyttelse. Disse tal refererer specifikt til denne undergruppe og ikke til alle virksomheder.
Dette muliggør udviklingen af et differentieret investeringsperspektiv. En lille virksomhed med få systemer og håndterbare processer kan i starten kræve ensartede nøglepræstationsindikatorer (KPI'er) og klart vedligeholdte vidensbaser. En virksomhed med adskillige datterselskaber, produktlinjer og adgangsroller kan derimod drage fordel af en mere omfattende semantisk infrastruktur. Det passende detaljeringsniveau afhænger af kompleksitet og risiko, ikke af et bestemt teknologisk udtryks attraktivitet.
Det kan også være økonomisk forsvarligt at undlade bestemte opgaver. Hvis en opgave forekommer sjældent, ikke har større konsekvenser og kan udføres pålideligt med en simpel procedure, kan vedligeholdelsesomkostningerne ved et ekstra lag opveje fordelene. En overbevisende arkitektonisk tilgang skal derfor også kunne forklare, hvor det ikke er nødvendigt.
Kontrolleret betydning som en konkurrencefordel
Generativ AI kan overbevisende præsentere mangelfuldt indhold; denne risiko er blandt de eksplicit beskrevne karakteristika og farer ved sådanne systemer. Selv yderligere virksomhedsinformation og hentningsmetoder eliminerer ikke alle sikkerhedsrisici, såsom dem, der udgøres af manipulerede instruktioner i bearbejdet indhold. Derfor er et semantisk lag ingen garanti for sandhed, sikkerhed eller omkostningseffektivitet.
Dens berettigede strategiske betydning ligger et andet sted. Den kan understøtte overgangen fra spredt erfaringsbaseret viden til eksplicitte, genanvendelige og ansvarlige forretningsdefinitioner. Dette gør det muligt ikke blot at anvende AI sporadisk, men gradvist at integrere den i et kontrolleret operationelt system. Det varige aktiv er så ikke den enkelte assistent, men den organiserede evne til pålideligt at udnytte virksomhedens viden til nye opgaver.
Den afgørende konkurrencefordel opstår derfor ikke i at have det største antal autonome agenter. Den opstår, hvor virksomheder hurtigere kan genkende, hvilke oplysninger der er gyldige, hvilke undtagelser der er relevante, og hvilke handlinger der fortsat er berettigede. De, der mestrer dette fundament, kan bruge skiftende modeller og værktøjer mere effektivt. De, der forsømmer det, risikerer primært at øge hastigheden af deres egne misforståelser med hver ny AI-applikation.
Rådgivning - Planlægning - Implementering

Konrad Wolfenstein
Jeg vil med glæde fungere som din personlige rådgiver.
Du kan kontakte mig på wolfenstein∂xpert.digital eller
Bare ring til mig på +49 7348 4088 965 .


