Více než chatbot: Jak sémantická vrstva zvyšuje spolehlivost umělé inteligence ve firmách – podceňovaný faktor úspěchu podnikové umělé inteligence
Předběžné vydání Xpertu

K dispozici ve 27 jazycích 📢
Preferujte Xpert.Digital na GoogluⓘPublikováno: 1. listopadu 2026 / Aktualizováno: 1. listopadu 2026 – Autor: Konrad Wolfenstein
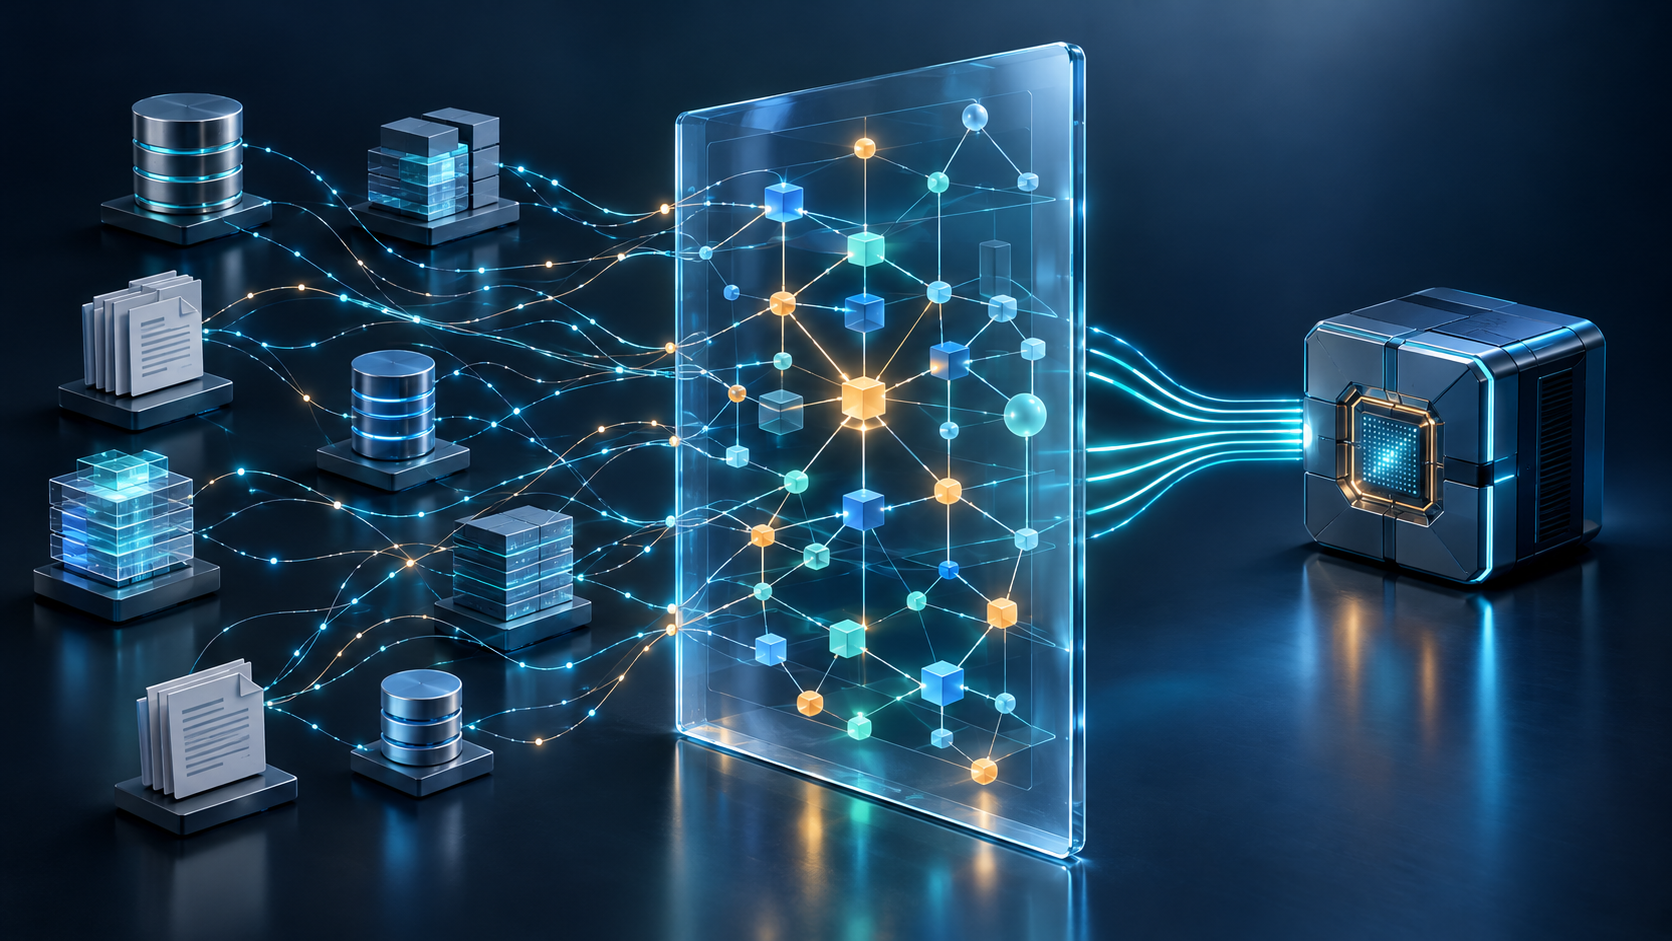
Více než chatbot: Jak sémantická vrstva zvyšuje spolehlivost umělé inteligence ve firmách – Podceňovaný faktor úspěchu podnikové umělé inteligence – Kreativní obrázek na toto téma s umělou inteligencí: Xpert.Digital
Umělá inteligence v podnikání: Proč jasná terminologie určuje ekonomický úspěch
Když umělá inteligence urychluje chaos: Proč firmy potřebují sdílené obchodní znalosti
Méně rozporů, lepší rozhodnutí: Co může sémantická vrstva udělat pro firmy
Firmy investují do umělé inteligence, aby zrychlily procesy a mohly činit lepší rozhodnutí. Samotný výkonný jazykový model však nezaručuje obchodní úspěch. Pokud prodej, finance a zákaznický servis interpretují klíčové termíny odlišně, může umělá inteligence poskytovat protichůdné odpovědi – a chyby šířit rychleji. Sémantická vrstva si klade za cíl tento problém řešit: Zpřístupňuje a srozumitelně používá termíny, vztahy a pravidla v různých aplikacích. Její hodnota nespočívá jen v lepších odpovědích, ale také ve snížení úsilí o koordinaci a opětovném využití firemních znalostí. Sémantická vrstva však může odhalit organizační nejasnosti, ale sama o sobě je nevyřeší. Důležité je proto, jak firmy mapují svou obchodní realitu, definují profesní odpovědnosti a měří skutečné přínosy.
Souvisí s tím:
Sémantická vrstva pro podnikovou umělou inteligenci: Proč obchodní relevance určuje návratnost investic do umělé inteligence
Bez jasných konceptů umělá inteligence automatizuje chaos
Sémantická vrstva umožňuje sdílení a ověřování obchodních termínů, vztahů a pravidel pro aplikace umělé inteligence. Její ekonomická hodnota proto nespočívá jen v lepších odpovědích, ale také v perspektivě snížení koordinačního úsilí, opětovného využití obchodních znalostí a kontrolovanějšího rozhodování. Zásadním omezením však je, že taková sémantická vrstva může odhalit organizační nejednoznačnost, ale sama o sobě ji nemůže vyřešit.
Pro firmy to posouvá strategickou otázku. Už nejde jen o to, který jazykový model je nejefektivnější nebo jak rychle lze vyvinout dalšího asistenta. Důležitější se stává obchodní realita, na které jsou tyto systémy založeny. Pokud prodej, finance a zákaznický servis používají stejný termín odlišně, technicky výkonná umělá inteligence může šířit protichůdné výsledky ještě rychleji a širšími prostředky. Ekonomická výzva spočívá v transformaci rozptýlených informací do robustního a trvale použitelného základu pro rozhodování.
Rozdíl mezi používáním a výsledkem
Zavádění umělé inteligence roste, ale její využití dosud neprokázalo ekonomický dopad. V roce 2025 používalo alespoň jednu technologii umělé inteligence 19,95 procenta dotázaných společností v EU s deseti a více zaměstnanci; to představuje nárůst o 6,47 procentního bodu ve srovnání s rokem 2024. Mezi velikostmi společností existovaly významné rozdíly: podíl byl 17 procent u malých společností, 30,36 procenta u středních společností a 55,03 procenta u velkých společností. Průzkum zachytil široké spektrum technologií umělé inteligence, od analýzy textu až po autonomní stroje, ale nezaměřil se konkrétně na využití generativní umělé inteligence nebo sémantických vrstev.
Odlišný obrázek vyplynul z mezinárodního obchodního průzkumu provedeného v roce 2026. V tomto průzkumu 80 procent respondentů uvedlo zlepšení osobní produktivity díky umělé inteligenci, zatímco 37 procent uvedlo pozitivní příspěvek k zisku své společnosti před úroky a zdaněním (EBIT). Pouze asi 6 procent patřilo do obzvláště úspěšné skupiny, přičemž alespoň 5 procent svého EBIT připisovalo umělé inteligenci a zároveň uvádělo významné přínosy. Průzkumu se zúčastnilo 1 719 účastníků z 97 zemí a byl založen na datech hlášených samotnými respondenty; nelze jej proto přímo srovnávat s evropskými obchodními statistikami.
Čísla neprokazují kauzální souvislost sémantické vrstvy. Spíše ilustrují obchodní problém: Mezi zjednodušením individuální práce a měřitelným obchodním úspěchem se nachází organizační překladatelské úsilí. Právě na tomto rozhraní se sdílená významová vrstva stává relevantní.
Důležitost se stává součástí provozní infrastruktury
Sémantická vrstva propojuje technické datové struktury s obchodními koncepty, jako je zákazník, smlouva, reklamace nebo výnos. Popisuje například, která datová pole patří zákazníkovi, jak se vypočítává klíčový ukazatel výkonnosti (KPI) a za jakých podmínek se uplatňuje konkrétní stav. To umožňuje různým aplikacím spoléhat se na společné definice, místo aby odvozovaly vlastní interpretace z popisků tabulek nebo dokumentů.
Jednoduchý příklad ilustruje důsledky. Společnost by mohla definovat aktivního zákazníka v prodeji na základě probíhajících konverzací, ve financích na základě zaznamenaných obchodních transakcí a v oblasti služeb na základě existujících reklamací. Žádná z těchto perspektiv nemusí být nutně špatná. Problém nastává, když je umělá inteligence neúmyslně smíchá nebo prezentuje jednu perspektivu jako univerzálně platnou.
Ekonomicky rozumné řešení proto ne vždy spočívá v jediné definici pro všechny účely. Často je zapotřebí několik jasně pojmenovaných, profesionálně odpovědných definic s jednoznačnými mezemi použití. Společná významová vrstva by měla kontrolovaným způsobem odrážet rozdíly, nikoli uměle vytvářet uniformitu, kterou podnik ve skutečnosti nemá. Jejím cílem je srozumitelná interpretace, nikoli pojmová homogenizace.
Od zprávy k operačnímu rozhodnutí
Klasické sémantické modely pro business intelligence se zaměřují především na klíčové ukazatele, dimenze, agregace a vztahy mezi datovými objekty. Bylo by však příliš zjednodušující zcela jim odepřít obchodní logiku nebo autorizační funkce: Zavedené systémy BI například podporují vztahy, vypočítané klíčové ukazatele a přístup k datům na základě rolí. Hranice mezi sémantickou vrstvou BI a sémantickou vrstvou AI proto není jasným technologickým rozdělením.
Hlavní rozdíl spočívá v požadavcích. Například zpráva by měla přesně reprezentovat příjmy. Provozní aplikace umělé inteligence na druhou stranu musí být také schopna určit, která smlouva patří do procesu, která zvláštní dohoda má přednost a zda další krok vyžaduje schválení. To rozšiřuje úkol z konzistentní analýzy na kontextově závislou podporu rozhodování.
Z ekonomického hlediska to zvyšuje jak potenciální přínosy, tak i potenciální škody. Špatně definovaná zpráva může vydláždit cestu k chybnému rozhodnutí. Akční asistent ji může okamžitě implementovat. Čím blíže se umělá inteligence dostává k objednávkám, platbám, cenovým závazkům nebo rozhodnutím zákazníků, tím důležitější se stává rozdíl mezi věrohodnou interpretací a závaznou logikou provedení.
Čtyři stavební kameny obchodních znalostí
Komplexní významová vrstva pro podnikovou umělou inteligenci by měla zohledňovat čtyři typy znalostí: definice entit, vztahy, rozhodovací pravidla a shromážděné opravy. Definice entit specifikují, co představuje obchodní objekt, například aktivního zákazníka, kritickou smlouvu nebo vysoce rizikový případ. Vztahy propojují takové objekty, jako je dceřiná společnost s účtem nebo dodatek smlouvy s odpovídající hlavní smlouvou.
Pravidla pro rozhodování popisují prahové hodnoty, výjimky, odpovědnosti a podmínky schvalování. Shromážděné opravy zaznamenávají, kde odborníci na danou problematiku opravili chybné výsledky. Pouze v kombinaci se lze z toho vyvinout více než jen pohodlnou vyhledávací funkci: transparentní základ pro to, jak a v jakém rámci lze informace interpretovat.
Z ekonomického hlediska je nutné tyto typy znalostí oceňovat odlišně. Definici zákazníka lze znovu použít v mnoha aplikacích. Rozhodnutí o výjimce se na druhou stranu může vztahovat pouze na konkrétní smlouvu. Dobrá architektura proto musí nejen ukládat znalosti, ale také omezovat jejich rozsah. V opačném případě transformuje lokální výjimku na obecné pravidlo a zhoršuje právě tu chybu, které má předcházet.
Proč jsou dokumenty klíčové pro řízení firmy
Sémantická vrstva řízená umělou inteligencí musí být schopna propojit nejen strukturovaná data, ale také smlouvy, e-maily, zprávy a zápisy ze schůzek s odpovídajícími obchodními transakcemi. Důvod je okamžitě zřejmý: Záznam v databázi může obsahovat dohodnutou standardní cenu, zatímco schválená dodatečná smlouva stanoví jiné podmínky. Kdokoli, kdo analyzuje pouze datovou sadu, by mohl přehlédnout výjimku ekonomicky závazné povahy.
Náročná část nespočívá jen v nalezení klauzule. Spočívá v určení jejího statusu. Návrh není podepsaná dohoda. Interní zápis ze schůze nenahrazuje schválení. Pozdější dokument může doplňovat, částečně nahrazovat nebo se vztahovat na jiný rozsah než dřívější pravidlo. Tyto rozdíly musí být explicitně modelovány a přezkoumány pro každý konkrétní případ použití.
To vede k důležitému ekonomickému hledisku: Hodnota analýzy dokumentů se neměří počtem zpracovaných stránek. Vzniká pouze tehdy, když z ní lze odvodit spolehlivá prohlášení o nárocích, povinnostech, termínech nebo postupu. Rychlé shrnutí bez ověření obsahu může naopak vést k dodatečným nákladům na audit a vytvořit falešný pocit bezpečí.
Čtyři zdroje nákladů v důsledku sémantické nejednoznačnosti
Ekonomický dopad lze chápat prostřednictvím čtyř kategorií nákladů. Zaprvé, náklady na vyhledávání vznikají, když zaměstnanci musí shromažďovat informace a chápat jejich význam. Zadruhé, náklady na koordinaci vznikají, když oddělení vysvětlují a slaďují různé analýzy. Zatřetí, náklady na chyby vznikají, když nesprávné klasifikace nebo pravidla vedou k přepracování a chybným rozhodnutím. Začtvrté, náklady na opakování vznikají, když každý nový projekt umělé inteligence vyžaduje nový vývoj stejných technických základů.
Tato klasifikace je analytickým hodnotícím rámcem, nikoli empiricky měřeným rozdělením nákladů. Pomáhá však vyhnout se časté mylné představě: Návratnost investic do sémantické vrstvy by neměla záviset pouze na rychlosti odezvy asistenta. Odpověď se může objevit během několika sekund a stále může být drahá, pokud její přesnost musí následně ověřovat několik specialistů.
Naopak, zdánlivě nevýznamné zlepšení může vytvořit značnou hodnotu. Pokud závazná definice zkrátí koordinaci mezi finančním oddělením a prodejem, může přínos ovlivnit řadu reportů a rozhodnutí současně. Relevantní ekonomickou jednotkou proto není vždy jednotlivý dialog s umělou inteligencí, ale celý obchodní proces, včetně jeho kontrolních a korekčních smyček.
Opětovné použití vytváří úspory z rozsahu
Společné definice klíčových ukazatelů výkonnosti (KPI) mohou zabránit duplicitnímu implementačnímu úsilí a zpřístupnit stejnou obchodní logiku napříč různými aplikacemi. V širší architektuře umělé inteligence je toto ústředním příslibem škálovatelnosti: Již vydané termíny, vztahy a pravidla by měly zůstat použitelné pro jiné případy použití. To transformuje sémantickou vrstvu spíše na potenciální investici do infrastruktury než na izolovanou součást projektu.
Ekonomická logika je podobná logike sdíleného zdroje. Jeho počáteční vytvoření s sebou nese náklady, zatímco další uživatelé mohou využívat stávající komponenty. Výhoda se však zvyšuje pouze tehdy, pokud nové případy užití skutečně vykazují dostatečný překryv v odborných znalostech. Jiný asistent ve stejné oblasti služeb může čerpat z více stávajících znalostí než aplikace pro zcela jinou obchodní oblast.
Bylo by proto nerealistické očekávat automatické snižování nákladů s každým dalším projektem umělé inteligence. Nové právní rámce, produktové řady nebo obchodní modely mohou vyžadovat rozsáhlé doplňky. Spolehlivé úspory z rozsahu nespočívají v tom, že se pozdější projekty stanou bezplatnými, ale spíše v tom, že již objasněné otázky není nutné znovu objasňovat bez objektivního odůvodnění.
Produktivita vyžaduje střízlivé zhodnocení
Studie provedená na 5 172 zaměstnancích zákaznického servisu zjistila, že přístup k generativnímu asistentovi s umělou inteligencí vedl k průměrnému nárůstu počtu vyřešených požadavků zákazníků za hodinu o přibližně 15 procent. Efekt však byl nerovnoměrně rozložen: Méně zkušení a méně kvalifikovaní zaměstnanci z toho měli větší prospěch, zatímco vysoce zkušení a vysoce výkonní zaměstnanci zaznamenali pouze mírné zvýšení rychlosti a v některých případech i mírné snížení kvality. Studie tak ukazuje konkrétní efekt produktivity v rámci specifického pracovního prostředí, spíše než izolovanou návratnost investic do sémantické vrstvy.
Toto rozlišení je klíčové pro ekonomické hodnocení. Úspěšná implementace umělé inteligence neodhaluje, jaký podíl úspěchu lze připsat jazykovému modelu, uživatelskému rozhraní, dostupným znalostem, školení nebo změněným pracovním postupům. Kdokoli, kdo z těchto dat odvozuje paušální sliby návratnosti investic pro jedinou architektonickou komponentu, překračuje jejich vypovídací sílu.
Uvolněná pracovní doba se navíc automaticky nepromítá do odpovídajícího snížení nákladů. Ekonomické výhody vznikají například tehdy, když společnost zvládne dodatečnou poptávku, zkrátí čekací doby, vyhne se přesčasům nebo nasadí nedostatkové kvalifikované pracovníky na náročnější úkoly. Bez takových změn může měřitelná úspora času z obchodního hlediska zůstat do značné míry nevyužitá.
Výpočet návratnosti včetně všech nákladů
Životaschopný obchodní případ by měl nejprve analyzovat současný proces. To zahrnuje počty případů, doby zpracování, dotazy, opravy, eskalace a důsledky nesprávných rozhodnutí. Dále je nutné určit, které z těchto faktorů budou pravděpodobně ovlivněny společnou významovou vrstvou. Teprve poté mohou proběhnout smysluplné diskuse o rozsahu investic a očekávaných přínosech.
Z hlediska nákladů je třeba kromě používání softwaru a modelů zvážit také systémovou integraci, obchodní modelování, ověřování identity, správu přístupů, testování a průběžné aktualizace. Zejména zapojení zkušených profesionálů není bezplatným dodatečným výdajem. Jejich čas má ekonomickou hodnotu a během implementace není k dispozici pro jiné úkoly.
Střízlivé posouzení zohledňuje také počáteční ztráty a nejistotu. Nová aplikace může zpočátku vyžadovat dodatečné kontroly, než se rutiny stabilizují. Některé výhody se projeví až s dalšími případy použití, zatímco jiné se neprojeví. Proto je postupný investiční přístup s ověřitelnými mezilehlými cíli často pravděpodobnější než velká počáteční investice, jejíž opodstatnění spočívá především na slibech budoucích synergií.
Správné měřítko úspěchu
Nejdůležitější metrikou úspěchu jsou ekonomické náklady na každou správně a v souladu s předpisy dokončenou obchodní transakci. Tato perspektiva kombinuje rychlost, kvalitu a kontrolu. Zabraňuje tomu, aby vysoká míra využití nebo krátká doba odezvy byly považovány za úspěch, pokud aplikace generuje dodatečné přepracování.
Pro účely měření je třeba rozlišovat různé typy chyb. Nesprávná metrika se liší od přehlédnuté smluvní výjimky. Neúplné oznámení se liší od neoprávněného zveřejnění dat. Stejně tak musí být jasné, zda systém spolehlivě odpovídá na otázku, legitimně ji předává člověku nebo vydává výsledek bez dostatečného podkladu.
Smysluplné srovnání využívá předem schválené případy a zohledňuje celý proces. U vhodných procesů mohou fázované implementace nebo kontrolované srovnávací skupiny pomoci rozlišit mezi technickými vylepšeními a obecnými změnami. Přehled by měl zahrnovat i vzácné, ale ekonomicky významné výjimky. Systém, který dobře zvládá rutinní případy, ale přehlíží kritické výjimky, může být v průměru přesvědčivý, ale v praxi stále nepřijatelný.
Vektorové vyhledávání nenahrazuje závazek
Vektorové databáze podporují vyhledávání textů s podobným obsahem tím, že umožňují porovnávání informací pomocí numerických reprezentací nazývaných embeddingy. Moderní systémy mohou navíc používat filtry metadat, vyhledávání pomocí klíčových slov a kombinované metody vyhledávání. Bylo by proto nesprávné prezentovat je jako v podstatě bezkontextové repozitáře bez možností filtrování.
Jeho základní funkce však odpovídá na jinou otázku než na otázku provozního řízení. Věcná podobnost automaticky neznamená, zda je dokument aktuální, právně závazný nebo použitelný pro konkrétní případ. Vyhledávací systém může takové vlastnosti zohlednit, pokud jsou spolehlivě uloženy a správně integrovány do dotazu. Sama o sobě však neurčuje nezbytná obchodní rozhodnutí.
To vede k jasné investiční logice pro firmy. Vylepšené vyhledávání a rozšířené významové vrstvy se mohou vzájemně doplňovat. Dodatečné výsledky vyhledávání však nenahradí jasně definované odpovědnosti a pravidla. Ti, kteří se snaží opravit každou chybnou odpověď pouze pomocí výkonnějšího vyhledávacího indexu, riskují, že poskytnou více materiálu, aniž by objasnili jeho věcnou platnost.
🤖🚀 Platforma spravované umělé inteligence: Rychlejší, bezpečnější a chytřejší řešení umělé inteligence s UNFRAME.AI

Platforma spravované umělé inteligence – obrázek: Xpert.Digital
Zde se dozvíte, jak může vaše společnost rychle, bezpečně a bez vysokých vstupních bariér implementovat řešení umělé inteligence na míru.
Spravovaná platforma umělé inteligence je vaším komplexním a bezstarostným řešením pro umělou inteligenci. Místo řešení složitých technologií, drahé infrastruktury a zdlouhavých vývojových procesů získáte hotové řešení šité na míru vašim potřebám od specializovaného partnera – často během několika dní.
Klíčové výhody na první pohled:
⚡ Rychlá implementace: Od nápadu k aplikaci připravené k použití během několika dnů, nikoli měsíců. Dodáváme praktická řešení, která vytvářejí okamžitou přidanou hodnotu.
🔒 Maximální zabezpečení dat: Vaše citlivá data zůstanou u vás. Garantujeme bezpečné a kompatibilní zpracování bez sdílení dat s třetími stranami.
💸 Žádné finanční riziko: Platíte pouze za výsledky. Vysoké počáteční investice do hardwaru, softwaru nebo personálu jsou zcela eliminovány.
🎯 Zaměřte se na své hlavní podnikání: Soustřeďte se na to, co děláte nejlépe. Postaráme se o kompletní technickou implementaci, provoz a údržbu vašeho řešení s umělou inteligencí.
📈 Připraveno na budoucnost a škálovatelné: Vaše umělá inteligence roste s vámi. Zajišťujeme neustálou optimalizaci a škálovatelnost a flexibilně přizpůsobujeme modely novým požadavkům.
Více informací zde:
Vliv dokumentů na obchodní rozhodnutí
Grafy znalostí mohou dělat víc než jen odkazy
Graf znalostí reprezentuje entity a jejich vztahy v síťové struktuře, a proto může tvořit důležitou součást sémantické vrstvy. Zároveň formální ontologie a metody na nich postavené mohou také podporovat logické závěry; zavedené standardy, jako je OWL, se neomezují pouze na ukládání základních spojení. Všeobecné tvrzení, že graf znalostí v principu nemůže reprezentovat pravidla, by proto bylo technicky nepřesné.
Klíčovou otázkou je, jaké funkce konkrétní řešení skutečně kombinuje. Graf obsahující podnikové objekty nemusí automaticky disponovat komplexní správou práv, testovaným řízením procesů ani profesionálně schváleným řešením speciálních případů. Naopak vhodně navržená architektura grafu může splňovat významnou část těchto požadavků.
Sémantickou vrstvu je proto třeba chápat méně jako nutně samostatný produkt a spíše jako balíček požadovaných funkcí. Některé společnosti dokáží pokrýt velkou část tohoto procesu stávajícími modely BI, datovými katalogy, grafovými systémy a sadami pravidel. Jiné potřebují další platformu. Ekonomicky relevantní je prokázaná funkční mezera, nikoli počet nově zavedených kategorií produktů.
Připojte se místo opětovného ukládání všeho
Sémantická vrstva může propojit stávající systémy ERP a CRM, datové platformy a úložiště dokumentů, aniž by bylo nutné nejprve migrovat veškerá firemní data do jednoho nového úložiště. Sémantické modely pro klíčové ukazatele výkonnosti (KPI) mohou také stavět na stávajících datových strukturách a odvozovat z nich příslušnou logiku dotazů. Sdílený význam se proto zásadně liší od fyzického uložení dat.
To však neznamená, že taková architektura může fungovat bez jakéhokoli kopírování dat. Indexy vyhledávání, extrahované informace o dokumentech, mezipaměti nebo předem vypočítané výsledky mohou být užitečné pro specifické případy použití. Relevantní obchodní otázkou je, jaké informace je třeba ukládat, kde a jak dlouho, nikoli to, zda lze slib úplné ochrany proti kopírování nabídnout na trhu.
Dobře navržený systém vyvažuje včasnost, dobu odezvy, dostupnost, náklady a ochranu osobních údajů. Na stav zásob se mohou vztahovat jiné požadavky na včasnost než na smluvní ustanovení. Dotaz distribuovaný mezi mnoho zdrojových systémů může být flexibilní, ale také zvyšuje závislost na jejich dostupnosti. Nejlepší řešení proto nemusí být nutně maximálně centralizované nebo maximálně distribuované, ale spíše vhodné pro daný obchodní proces.
Kvalita dat zůstává samostatným úkolem
Sdílená vrstva významu automaticky neznamená, že chybná zdrojová data jsou správná. Dokonce i poskytovatelé systémů sémantických dotazů doporučují co nejdříve řešit základní úkoly konzistence, jako je normalizace běžných objektů a čištění nevhodných dat. Obchodní sémantika a kvalita dat se vzájemně doplňují, nikoli jsou zaměnitelné.
Obzvláště ilustrativním příkladem je identita obchodního partnera. Různé hláskování se může vztahovat na stejného dodavatele. Podobné názvy však mohou patřit i různým právnickým osobám. Ukvapené sloučení těchto názvů pak může vést k nesprávnému přiřazení platebních informací, údajů o úvěruschopnosti nebo smluvních vztahů. Dobrá architektura proto musí být schopna odhalit, která přiřazení jsou potvrzena a kde existuje pouze věrohodný předpoklad.
To je ekonomicky důležité, protože chyby nejsou vždy viditelné tam, kde k nim dochází. Nepřesná shoda identity může později ovlivnit více analýz a rozhodnutí. Proto by se implementace měla zaměřit nejen na kvalitu jednotlivých odpovědí, ale také na spolehlivé přiřazení podkladových objektů. V opačném případě opakované použití nejen znásobuje znalosti, ale i jejich chyby.
Pravidla musí být technicky efektivní
Zásady v dokumentu nepředstavují vynucenou kontrolu. U aplikací umělé inteligence bezpečnostní koncepty explicitně rozlišují mezi jazykovými požadavky a technickými opatřeními, jako jsou omezené funkce, omezená oprávnění a ověřitelné podmínky provádění. Zejména nadměrná autonomie a příliš široká přístupová práva mohou vést k chybným nebo manipulovaným výstupům modelu, které spouštějí škodlivé akce.
Robustní architektura by proto měla oddělovat interpretaci a provádění. Jazykový model může například klasifikovat proces nebo navrhnout akci. Zda byla částka správně vypočítána, zda byl udělen souhlas nebo zda lze provést rezervaci, by mělo být v kritických procesech dodatečně zajištěno ověřitelnou logikou a odpovědnými systémy.
Toto objasňuje běžnou mylnou představu. Sémantická vrstva může poskytnout obchodní základ pro chování v souladu s pravidly. Sama o sobě však nezaručuje, že pravděpodobnostní jazykový model bude spolehlivě aplikovat každé pravidlo. Ekonomicky životaschopné řešení vyplývá ze souhry významu, oprávnění, testů, procesních kontrol a jasně definovaných postupů.
Oprávnění jsou součástí významu
Při přístupu k firemním znalostem je nutné kontrolovat nejen relevanci, ale i autorizaci přístupu. Kontroly související s dokumenty mohou omezit výsledky vyhledávání na základě identity uživatele a přiřazených práv; jejich účinnost závisí mimo jiné na správně synchronizovaných autorizačních informacích. Sdílená znalostní báze tedy neznamená, že každý uživatel může vidět stejný obsah.
V praxi je časový rozměr klíčový. Zaměstnanec může změnit roli, projekt může skončit nebo dokument může být následně omezen. Pokud vyhledávací a kontextová vrstva používá zastaralá oprávnění, může zveřejnit obsah, který již není ve zdrojovém systému přístupný. Proto musí být údržba oprávnění explicitně zahrnuta do provozních nákladů.
I otázky s podobným obsahem mohou z dobrého důvodu dostat různé odpovědi. Dva uživatelé mohou patřit do různých oblastí odpovědnosti nebo mít přístup k různým datovým souborům. Konzistence tedy neznamená shodné znění, ale spíše stejná profesní pravidla ve srovnatelném kontextu. Odchylka představuje problém s kvalitou pouze tehdy, pokud ji nelze vysvětlit časem, rolí, dostupností dat nebo samotnou otázkou.
Opravy vyžadují strukturovaný proces
Zachycování uživatelských oprav je jednou z zamýšlených znalostních složek sémantické vrstvy orientované na umělou inteligenci. V řízení rizik umělé inteligence je zkoumání lidských přepsání a jejich příčin také považováno za cenný zdroj informací pro hodnocení nasazených systémů. To však neznamená, že by se každá uživatelská změna měla automaticky stát obecným pravidlem.
Opravený výsledek může mít velmi odlišné příčiny. Možná byl datový záznam nesprávně přiřazen. Možná byla uplatněna smluvní výjimka. Možná bylo předchozí firemní pravidlo zastaralé. Nebo uživatel jednoduše zadal osobní preferenci. Tyto případy vyžadují odlišné reakce a neměly by být bez rozdílu začleňovány do sdílené znalostní báze.
Ekonomicky efektivní proces učení zpočátku zachází se zpětnou vazbou jako s ověřitelnými návrhy. Odborníci na danou problematiku rozhodují o jejím rozsahu, závazné povaze a potřebných testech. Teprve poté je schválená změna zpřístupněna pro další aplikace. To nutně nevyžaduje přetrénování jazykového modelu. Klíčové je, aby se chybě v budoucnu v příslušném kontextu předešlo, aniž by se neúmyslně zavedly nové chyby jinde.
Verzování chrání před falešnými retrospektivními pohledy
Obchodní definice a pravidla se mění, proto by sémantická vrstva měla provádět revize změn a přiřazovat je odborníkům ke schválení. Stávající sémantické platformy již podporují verzované definice nebo ověřené referenční dotazy, včetně informací o tom, kdy a kým byly potvrzeny. Sledovatelná historie tedy není dekorativním doplňkem, ale nedílnou součástí kontrolovaného používání.
Pro pozdější přezkum je však aktuálně platné pravidlo nedostatečné. Důležité je také, jaká verze byla platná v době transakce a jaké informace byl systém v té době skutečně schopen zpracovat. Dodatečně přijatý dodatek ke smlouvě se nesmí neúmyslně stát základem pro hodnocení dřívějšího rozhodnutí. Jinak zpětně vzniká zdání jasnosti, které v době rozhodnutí neexistovalo.
Firmy by proto měly společně zvažovat historii pravidel, verze dokumentů a stavy dat. Nákladová efektivita zde nespočívá ani tak v úspoře sekund, jako spíše ve snížení nákladů na řešení sporů. Ti, kteří dokáží zrekonstruovat základ rozhodnutí, stráví méně času jeho skládáním z e-mailů, jednotlivých souborů a následných upomínek.
Svoboda modelu ještě není svobodou dodavatele
Podnikové znalosti by měly být organizovány tak, aby změna jazykového modelu automaticky nevyžadovala kompletní přepsání základů podnikání. Strategický argument pro to je podpořen technickou dynamikou: Mezi listopadem 2022 a říjnem 2024 se náklady na dotazy k modelu snížily více než 280krát na úrovni výkonu srovnatelné s GPT-3.5. Toto srovnání se vztahuje ke konkrétní úrovni benchmarku a nemělo by být interpretováno jako odpovídající snížení celkových nákladů na podnikovou aplikaci.
Závěr je nicméně pravděpodobný: Když se výkon a ceny modelu výrazně změní, možnost přechodu se stává stále cennější. Trvale použitelný technický model může zabránit tomu, aby každá technologická aktualizace spustila rozsáhlé úsilí o technický překlad. Nezávislost na modelu tak nabývá charakteru strategické možnosti.
Neodstraňuje to však všechny závislosti. Definice mohou být stále vázány na proprietární formáty platformy, rozhraní nebo operační modely. Společnost by proto měla samostatně posoudit, zda může přejít na jiný jazykový model, exportovat definice znalostí a pokračovat v provozování celého řešení u jiného poskytovatele. Pouze toto rozlišení umožňuje realistické vyhodnocení nákladů na změnu a vyjednávací páky.
Trh roste společně
Sémantické definice jsou nyní explicitně nabízeny jak pro BI, tak pro AI: Snowflake propojuje obchodní metriky a vztahy mezi entitami s dotazy a agenty, zatímco dbt také poskytuje své centrálně definované metriky prostřednictvím rozhraní pro nástroje AI. Souběžně se objevila iniciativa Open Semantic Interchange jako iniciativa pro výměnu sémantických metadat neutrální vůči dodavatelům. Projekt byl v roce 2026 přijat do inkubátoru Apache pod názvem Apache Ossie.
Tento vývoj je ekonomicky významnější než oznámení jiného produktu. Pokud více nástrojů může používat stejné definice, zásadně se snižuje potřeba vytvářet novou obchodní logiku v každé aplikaci. Zároveň mohou zavedené datové platformy převzít větší část tvorby hodnoty, která byla dříve vyhrazena specializovaným doplňkovým řešením.
Pro zákazníky to znamená: Před novým nákupem by měla být provedena inventura. Stávající datové modely, katalogy klíčových ukazatelů výkonnosti (KPI), autorizační systémy a rozhraní mohou pokrýt některé požadavky. Otevřené formáty pro výměnu jsou v tomto ohledu užitečné, ale nejsou úplným důkazem efektivity. Musí být posouzeny podle toho, jaké definice, pravidla a kontextové informace lze přenášet mezi skutečně používanými systémy bez ztráty významu.
Objektivně vnímána znalostní tkanina Unframe
Unframe sdružuje své sémantické funkce pod názvem Knowledge Fabric, který propojuje podnikové koncepty, obchodní logiku, vztahy a oprávnění. Cílem tohoto přístupu je učinit strukturované datové sady a obsah dokumentů použitelnými pro specifické případy použití a postupně rozšiřovat znalostní bázi. Řešení je také nabízeno s různými jazykovými modely a integrací do stávajících podnikových systémů.
Ekonomická atraktivita tohoto konceptu spočívá v kombinaci dříve oddělených úkolů. Pokud systémová integrace, obchodní kontext a kontrolované využití dobře spolupracují, lze snížit úsilí potřebné pro další aplikace. Zda se však tato výhoda v konkrétní společnosti projeví, nelze odvodit pouze z názvu architektury. Jsou zapotřebí ověřitelné výsledky z vlastních procesů společnosti.
Zároveň zůstává relevantní otázka vlastnictví a provozu: Unframe rozlišuje mezi daty, výsledky a konfiguracemi řešení vlastněnými zákazníkem na jedné straně a Knowledge Fabric a dalšími komponentami platformy provozovanými poskytovatelem na straně druhé. Svoboda volby modelu by proto neměla být ztotožňována s úplnou nezávislostí na platformě. Pro spolehlivé posouzení by měly být explicitně vyjasněny možnosti exportu, práva k technickým definicím a kontinuita systému v případě změny provozovatele.
Začněte v malém, zůstaňte přizpůsobiví
Aplikačně orientovaný přístup omezuje rozsah modelování a umožňuje kontrolu definic s příslušnými odborníky na danou problematiku s využitím reálných úkolů. Místo okamžitého mapování celé společnosti se nejprve zachytí potřebné systémy, objekty, vztahy a pravidla jasně definovaného procesu. Schválené komponenty lze poté rozšířit o související případy užití.
Z ekonomického hlediska je obzvláště vhodný proces s častým opakováním, ověřitelnými výsledky a dostatečně významnými problémy s koordinací. Příliš jednoduchý případ užití může pouze demonstrovat, že okno chatu lze propojit se zdrojem dat. Naopak příliš složitý úvod může vytvořit tolik nevyřešených speciálních případů, že výhody se projeví až po dlouhé době.
Správná rovnováha spočívá mezi omezeným rozsahem a znovu použitelným základem. Pilotní projekt by neměl být prototypem na jedno použití. Zároveň by se jeho potenciál pro integraci neměl stát výmluvou pro budování komplexního obchodního modelu před prvním měřitelným zlepšením. Měřítkem zůstává, které technické stavební bloky jsou skutečně potřebné pro další smysluplný krok.
Profesní odpovědnost určuje přijetí
Zavedení umělé inteligence nepřesouvá odpovědnost z lidí na software. Každá centrální definice vyžaduje kompetentní orgán, který může posuzovat a schvalovat změny. Dokonce i zastřešující rámce pro důvěryhodnou umělou inteligenci zdůrazňují jasně definované lidské role a odpovědnosti při práci se systémy umělé inteligence. Technický provoz a odborná pravomoc by proto neměly být implicitně přiřazeny stejné roli.
To může být organizačně nepraktické. Společná definice příjmů, příslušnosti k zákazníkovi nebo rizika může ovlivnit cílové systémy, odpovědnosti a stávající postupy hodnocení. Sémantická vrstva tyto rozdíly odhaluje. Neřeší je technickou elegancí, ale spíše vyžaduje rozhodnutí, kterým se dříve dalo předejít.
V tom spočívá i jeho dlouhodobá hodnota. Když koncepty a pravidla již nejsou omezeny pouze na mysli jednotlivých zaměstnanců nebo rozptýleny v různých aplikacích, může se společnost stát méně závislou na neformálních znalostních monopolech. Tato výhoda však předpokládá, že se do procesu návrhu zapojují specialisté a vnímají významovou vrstvu jako podpůrnou. Pokud je zavedena pouze jako kontrolní nástroj, může se snížit ochota přispívat cennými zkušenostními znalostmi.
Ne každá společnost potřebuje stejnou hloubku
Data o používání v Evropě odhalují významné rozdíly v rozsahu nasazení umělé inteligence, aniž by nutně naznačovala potřebu specifické architektury. Navíc mezi společnostmi, které o využití umělé inteligence uvažovaly, ale v roce 2025 tak ještě neučinily, 70,89 procenta uvedlo jako důvod pro její nevyužívání nedostatek relevantních odborných znalostí; 52,52 procenta poukázalo na nejasné právní důsledky a 48,83 procenta na obavy o ochranu osobních údajů. Tato čísla se vztahují konkrétně na tuto podskupinu, a nikoli na všechny společnosti.
To umožňuje rozvoj diferencované investiční perspektivy. Malá společnost s malým počtem systémů a zvládnutelnými procesy může zpočátku vyžadovat konzistentní klíčové ukazatele výkonnosti (KPI) a jasně udržované znalostní báze. Korporace s řadou dceřiných společností, produktových řad a přístupových rolí může naopak těžit z komplexnější sémantické infrastruktury. Vhodná úroveň detailů závisí na složitosti a riziku, nikoli na atraktivitě konkrétního technologického termínu.
Vynechání určitých úkolů může být také ekonomicky výhodné. Pokud se úkol vyskytuje zřídka, nemá žádné závažné důsledky a lze jej spolehlivě provést jednoduchým postupem, mohou náklady na údržbu další vrstvy převážit její přínosy. Přesvědčivý architektonický přístup proto musí být schopen také vysvětlit, kde není potřeba.
Kontrolovaná významnost jako konkurenční výhoda
Generativní umělá inteligence dokáže přesvědčivě prezentovat chybný obsah; toto riziko patří mezi explicitně popsané vlastnosti a nebezpečí takových systémů. Ani dodatečné metody vyhledávání a vyhledávání firemních informací neodstraňují všechna bezpečnostní rizika, jako jsou ta, která představují manipulované instrukce ve zpracovávaném obsahu. Sémantická vrstva proto není zárukou pravdivosti, bezpečnosti ani nákladové efektivity.
Její oprávněný strategický význam spočívá jinde. Může podpořit přechod od rozptýlených zkušenostních znalostí k explicitním, opakovaně použitelným a odpovědným obchodním definicím. To umožňuje nejen sporadické nasazování umělé inteligence, ale i její postupné začleňování do řízeného operačního systému. Trvalým aktivem pak není individuální asistent, ale organizovaná schopnost spolehlivě využívat firemní znalosti pro nové úkoly.
Rozhodující konkurenční výhoda tedy nepramení z největšího počtu autonomních agentů. Vzniká tam, kde firmy dokáží rychleji rozpoznat, které informace jsou platné, které výjimky jsou relevantní a které akce zůstávají opodstatněné. Ti, kteří tento základ zvládnou, mohou efektivněji využívat měnící se modely a nástroje. Ti, kteří jej zanedbávají, riskují především zvýšení rychlosti vlastních nedorozumění s každou novou aplikací umělé inteligence.
Poradenství - Plánování - Implementace

Konrad Wolfenstein
Rád/a bych sloužil/a jako váš osobní poradce.
Můžete mě kontaktovat na adrese wolfenstein∂xpert.digital nebo
Zavolejte mi na +49 7348 4088 965 .