
Mer än en chatbot: Hur ett semantiskt lager gör AI mer tillförlitlig i företag – Den underskattade framgångsfaktorn för AI i företag
Xpert-förhandsversion

Available in 27 languages 📢
Föredra Xpert.Digital på GoogleⓘPublicerad den: 1 november 2026 / Uppdaterad den: 1 november 2026 – Författare: Konrad Wolfenstein
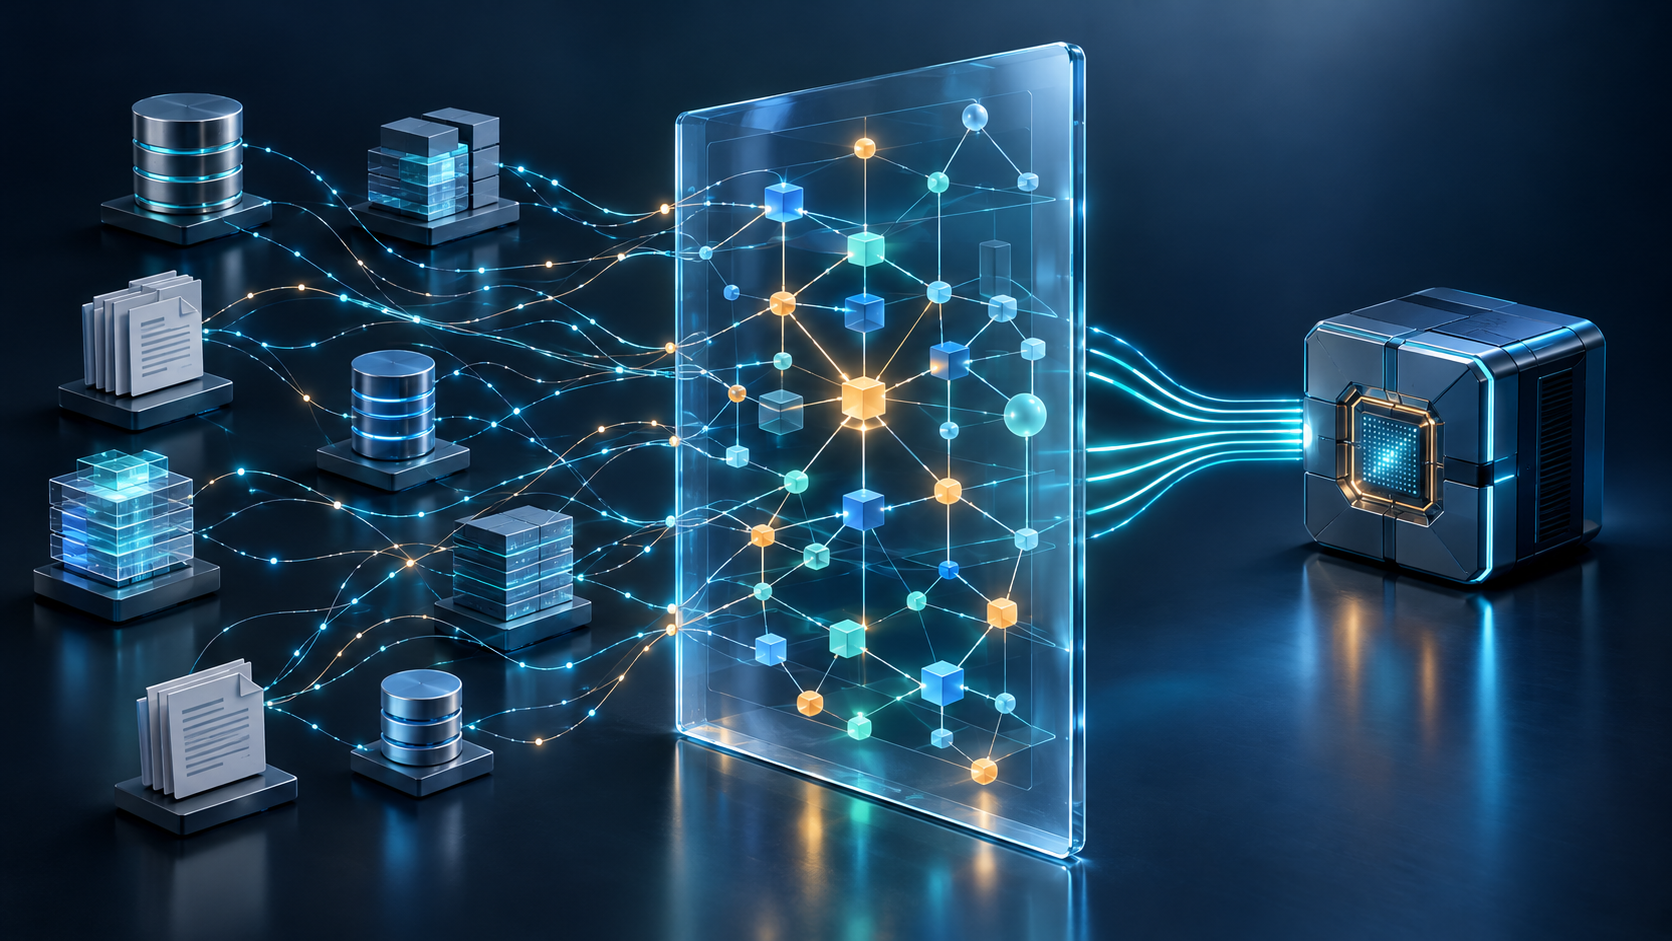
Mer än en chatbot: Hur ett semantiskt lager gör AI mer tillförlitlig i företag – Den underskattade framgångsfaktorn för företags-AI – Kreativ bild i ämnet, med AI: Xpert.Digital
AI i näringslivet: Varför tydlig terminologi avgör ekonomisk framgång
När AI accelererar kaos: Varför företag behöver delad affärskunskap
Färre motsägelser, bättre beslut: Vad ett semantiskt lager kan göra för företag
Företag investerar i artificiell intelligens för att accelerera processer och fatta bättre beslut. Men en kraftfull språkmodell ensam garanterar inte affärsframgång. Om försäljning, ekonomi och kundtjänst tolkar nyckeltermer på olika sätt kan AI leverera motstridiga svar – och sprida fel snabbare. Ett semantiskt lager syftar till att åtgärda detta: Det gör termer, relationer och regler användbara och begripliga i olika applikationer. Dess värde ligger inte bara i bättre svar utan också i minskade samordningsinsatser och återanvändbar företagskunskap. Ett semantiskt lager kan dock avslöja organisatoriska oklarheter, men det kommer inte att lösa dem på egen hand. Därför är det viktiga hur företag kartlägger sin affärsverklighet, definierar professionellt ansvar och mäter de faktiska fördelarna.
Relaterat till detta:
Semantiskt lager för företags-AI: Varför affärsrelevans avgör AI-avkastning på investering
Utan tydliga koncept automatiserar AI kaos
Ett semantiskt lager gör affärstermer, relationer och regler delade och verifierbara för AI-tillämpningar. Dess ekonomiska värde ligger därför inte bara i bättre svar, utan också i möjligheten till minskade samordningsinsatser, återanvändbar affärskunskap och mer kontrollerbara beslut. Den avgörande begränsningen är dock att ett sådant semantiskt lager kan avslöja organisatorisk tvetydighet, men inte kan lösa den på egen hand.
För företag förändrar detta den strategiska frågan. Det handlar inte längre enbart om vilken språkmodell som är mest effektiv eller hur snabbt en annan assistent kan utvecklas. Det som blir viktigare är den affärsverklighet som dessa system bygger på. Om försäljning, ekonomi och kundtjänst använder samma term på olika sätt kan en tekniskt kraftfull AI sprida motstridiga resultat ännu snabbare och mer brett. Den ekonomiska utmaningen ligger i att omvandla spridd information till en robust, permanent användbar grund för beslutsfattande.
Skillnaden mellan användning och resultat
Användningen av AI ökar, men dess användning har ännu inte visat sig ha någon ekonomisk inverkan. År 2025 använde 19,95 procent av de undersökta EU-företagen med tio eller fler anställda minst en AI-teknik; detta representerade en ökning med 6,47 procentenheter jämfört med 2024. Betydande skillnader fanns mellan företagsstorlekar: andelen var 17 procent för små företag, 30,36 procent för medelstora företag och 55,03 procent för stora företag. Undersökningen fångade upp ett brett spektrum av AI-tekniker, från textanalys till autonoma maskiner, men fokuserade inte specifikt på användningen av generativ AI eller semantiska lager.
En annan bild framträder i en internationell företagsundersökning som genomfördes 2026. I den undersökningen rapporterade 80 procent av de svarande förbättrad personlig produktivitet tack vare AI, medan 37 procent angav ett positivt bidrag till företagets resultat före räntor och skatter (EBIT). Endast cirka 6 procent tillhörde en särskilt framgångsrik grupp, som tillskrev minst 5 procent av sin EBIT till AI och samtidigt rapporterade betydande fördelar. Undersökningen omfattade 1 719 deltagare från 97 länder och baserades på självrapporterade data; den är därför inte direkt jämförbar med europeisk företagsstatistik.
Figurerna bevisar inte en kausal effekt av ett semantiskt lager. Snarare illustrerar de affärsproblemet: Mellan individuell arbetsförenkling och mätbar affärsframgång ligger en organisatorisk översättningsinsats. Det är just i detta gränssnitt som ett gemensamt betydelselager blir relevant.
Viktighet blir en del av den operativa infrastrukturen
Ett semantiskt lager kopplar samman tekniska datastrukturer med affärsbegrepp som kund, kontrakt, krav eller intäkt. Det beskriver till exempel vilka datafält som tillhör en kund, hur en nyckeltal (KPI) beräknas och under vilka villkor en specifik status gäller. Detta gör det möjligt för olika applikationer att förlita sig på gemensamma definitioner istället för att härleda sina egna tolkningar från tabelletiketter eller dokument.
Ett enkelt exempel illustrerar implikationerna. Ett företag skulle kunna definiera en aktiv kund inom försäljning genom pågående samtal, inom ekonomi genom registrerade affärstransaktioner och inom service genom befintliga serviceanspråk. Inget av dessa perspektiv är nödvändigtvis fel. Problemet uppstår när en AI oavsiktligt blandar dem eller presenterar ett perspektiv som universellt giltigt.
Den ekonomiskt sunda lösningen består därför inte alltid av en enda definition för alla ändamål. Ofta behövs flera tydligt namngivna, professionellt ansvarsfulla definitioner med entydiga tillämpningsgränser. Ett gemensamt betydelselager bör återspegla skillnader på ett kontrollerat sätt, inte artificiellt skapa en enhetlighet som verksamheten faktiskt inte besitter. Dess mål är begriplig tolkning, inte konceptuell homogenisering.
Från rapport till operativt beslut
Klassiska semantiska modeller för Business Intelligence fokuserar främst på nyckeltal, dimensioner, aggregeringar och relationerna mellan dataobjekt. Det vore dock en förenkling att helt och hållet neka dem affärslogik eller auktoriseringsfunktioner: Etablerade BI-system, till exempel, supportrelationer, beräknade nyckeltal och rollbaserad dataåtkomst. Därför är gränsen mellan ett BI-semantiskt lager och ett AI-semantiskt lager inte en tydlig teknologisk skiljelinje.
Den största skillnaden ligger i kraven. En rapport bör till exempel korrekt representera intäkter. En operativ AI-applikation måste å andra sidan också kunna avgöra vilket kontrakt som hör till en process, vilket särskilt avtal som har företräde och om nästa steg kräver godkännande. Detta utökar uppgiften från konsekvent analys till kontextberoende beslutsstöd.
Ekonomiskt sett ökar detta både de potentiella fördelarna och risken för skada. En dåligt definierad rapport kan bana väg för ett felaktigt beslut. En handlingskraftig assistent kan implementera den omedelbart. Ju närmare AI kommer ordrar, betalningar, prisåtaganden eller kundbeslut, desto viktigare blir skillnaden mellan rimlig tolkning och bindande exekveringslogik.
De fyra byggstenarna för affärskunskap
Ett heltäckande betydelselager för företags-AI bör beakta fyra typer av kunskap: entitetsdefinitioner, relationer, beslutsregler och insamlade korrigeringar. Enhetsdefinitioner specificerar vad som utgör ett affärsobjekt, såsom en aktiv kund, ett kritiskt kontrakt eller ett högriskärende. Relationer kopplar sådana objekt, såsom ett dotterbolag, till ett konto eller en kontraktstillägg till motsvarande huvudkontrakt.
Beslutsregler beskriver tröskelvärden, undantag, ansvarsområden och godkännandevillkor. Insamlade korrigeringar registrerar var ämnesexperter har korrigerat felaktiga resultat. Endast i kombination kan detta utvecklas till mer än bara en bekväm sökfunktion: en transparent grund för hur information kan tolkas och inom vilket ramverk.
Ur ett ekonomiskt perspektiv måste dessa typer av kunskap värderas på olika sätt. En kunddefinition kan återanvändas i många applikationer. Ett undantagsbeslut, å andra sidan, kan bara gälla för ett specifikt kontrakt. En bra arkitektur måste därför inte bara lagra kunskap utan också begränsa dess omfattning. Annars omvandlar den ett lokalt undantag till en generell regel och förvärrar just det fel som den är avsedd att förhindra.
Varför dokument är avgörande för affärsstyrning
Ett AI-drivet semantiskt lager måste kunna länka inte bara strukturerad data utan även kontrakt, e-postmeddelanden, rapporter och mötesprotokoll med motsvarande affärstransaktioner. Anledningen är omedelbart uppenbar: En databaspost kan innehålla det överenskomna standardpriset, medan ett godkänt tilläggsavtal anger andra villkor. Den som bara analyserar datamängden kan förbise det ekonomiskt bindande undantaget.
Den utmanande delen är inte bara att hitta en klausul. Den ligger i att fastställa dess status. Ett utkast är inte ett undertecknat avtal. Ett internt mötesprotokoll ersätter inte godkännande. Ett senare dokument kan komplettera, delvis ersätta eller gälla för ett annat omfång än en tidigare regel. Dessa distinktioner måste uttryckligen modelleras och granskas för varje specifikt användningsfall.
Detta leder till ett viktigt ekonomiskt perspektiv: Värdet av dokumentanalys mäts inte i antalet bearbetade sidor. Det uppstår endast när tillförlitliga uttalanden om påståenden, skyldigheter, deadlines eller handlingsplaner kan härledas från den. En snabb sammanfattning utan verifiering av innehållet kan å andra sidan medföra ytterligare revisionskostnader och skapa en falsk trygghetskänsla.
Fyra kostnadskällor på grund av semantisk tvetydighet
Den ekonomiska effekten kan förstås genom fyra kostnadskategorier. För det första uppstår sökkostnader när anställda måste samla in information och förstå dess betydelse. För det andra uppstår samordningskostnader när avdelningar förklarar och stämmer av olika analyser. För det tredje uppstår felkostnader när felaktiga klassificeringar eller regler leder till omarbetning och bristfälliga beslut. För det fjärde uppstår upprepningskostnader när varje nytt AI-projekt kräver att samma tekniska grunder utvecklas på nytt.
Denna klassificering är ett analytiskt utvärderingsramverk, inte en empiriskt uppmätt kostnadsfördelning. Den hjälper dock till att undvika en vanlig missuppfattning: Avkastningen på investeringen i ett semantiskt lager bör inte enbart bero på en assistents svarshastighet. Ett svar kan dyka upp på några sekunder och fortfarande vara dyrt om flera specialister i efterhand måste verifiera dess riktighet.
Omvänt kan en till synes obetydlig förbättring skapa avsevärt värde. Om en bindande definition förkortar samordningen mellan ekonomiavdelningen och försäljningen kan fördelen påverka ett flertal rapporter och beslut samtidigt. Därför är den relevanta ekonomiska enheten inte alltid den enskilda AI-dialogen, utan hela affärsprocessen, inklusive dess kontroll- och korrigeringsloopar.
Återanvändning skapar skalfördelar
Gemensamma definitioner av nyckeltal (KPI:er) kan undvika dubbla implementeringsinsatser och göra samma affärslogik tillgänglig i olika applikationer. Tillämpad på en bredare AI-arkitektur är detta det centrala löftet om skalbarhet: Redan släppta termer, relationer och regler bör kunna användas för andra användningsfall. Detta omvandlar det semantiska lagret till en potentiell infrastrukturinvestering snarare än en isolerad projektkomponent.
Den ekonomiska logiken liknar den för en delad resurs. Dess initiala skapande medför kostnader, medan ytterligare användare kan använda befintliga komponenter. Nyttan ökar dock bara om de nya användningsfallen faktiskt uppvisar tillräcklig överlappning i expertis. En annan assistent inom samma tjänsteområde kan dra nytta av mer befintlig kunskap än en applikation för ett helt annat affärsområde.
Därför vore det orealistiskt att förvänta sig automatiskt minskande kostnader med varje efterföljande AI-projekt. Nya rättsliga ramverk, produktfamiljer eller affärsmodeller kan kräva omfattande tillägg. De pålitliga skalfördelarna ligger inte i att senare projekt blir gratis, utan snarare i att redan klargjorda frågor inte behöver klargöras igen utan objektiv motivering.
Produktiviteten behöver en nykter bedömning
En studie av 5 172 kundtjänstmedarbetare fann att tillgång till en generativ AI-assistent resulterade i en genomsnittlig ökning på cirka 15 procent i lösta kundförfrågningar per timme. Effekten var dock ojämnt fördelad: Mindre erfarna och lågkvalificerade anställda gynnades mer, medan mycket erfarna och högpresterande anställda endast såg små vinster i hastighet och i vissa fall en liten minskning av kvaliteten. Studien visar således en konkret produktivitetseffekt inom en specifik arbetsmiljö, snarare än den isolerade avkastningen på investeringen från ett semantiskt lager.
Denna distinktion är avgörande för ekonomisk utvärdering. En framgångsrik AI-implementering avslöjar inte vilken andel av framgången som kan tillskrivas språkmodellen, användargränssnittet, tillgänglig kunskap, utbildning eller förändrade arbetsflöden. Den som härleder generella löften om avkastning på investeringen för en enda arkitekturkomponent från dessa data överskrider dess förklaringskraft.
Dessutom leder frigjord arbetstid inte automatiskt till motsvarande kostnadsminskning. Ekonomiska fördelar uppstår till exempel när ett företag hanterar ökad efterfrågan, minskar väntetider, undviker övertid eller använder en knapp kompetens för mer krävande uppgifter. Utan sådana förändringar kan en mätbar tidsbesparing i stort sett förbli outnyttjad ur ett affärsperspektiv.
En avkastningsberäkning inklusive alla kostnader
Ett hållbart affärsplan bör först analysera den nuvarande processen. Detta inkluderar ärendenummer, handläggningstider, frågor, korrigeringar, eskaleringar och konsekvenserna av felaktiga beslut. Därefter är det nödvändigt att fastställa vilka av dessa faktorer som sannolikt påverkas av ett gemensamt betydelselager. Först då kan meningsfulla diskussioner om investeringens omfattning och förväntade fördelar äga rum.
På kostnadssidan bör, utöver användning av programvara och modeller, även systemintegration, affärsmodellering, identitetsverifiering, åtkomsthantering, testning och löpande uppdateringar beaktas. Involvering av erfarna yrkespersoner är i synnerhet inte en gratis extrakostnad. Deras tid har ekonomiskt värde och är inte tillgänglig för andra uppgifter under implementeringen.
En nykter bedömning tar även hänsyn till förluster och osäkerhet vid uppstart. Inledningsvis kan en ny tillämpning kräva ytterligare kontroller innan rutinerna stabiliseras. Vissa fördelar blir bara uppenbara med ytterligare användningsfall, medan andra uteblir. Därför är en etappvis investeringsstrategi med verifierbara delmål ofta mer rimlig än en stor initial investering vars motivering främst vilar på löften om framtida synergier.
Rätt mått på framgång
Det viktigaste framgångsmåttet är den ekonomiska utgiften per korrekt och enligt gällande bestämmelser genomförd affärstransaktion. Detta perspektiv kombinerar hastighet, kvalitet och kontroll. Det förhindrar att en hög användningsgrad eller en kort svarstid anses vara en framgång om applikationen genererar ytterligare omarbetning.
Olika typer av fel bör särskiljas för mätändamål. Ett felaktigt mätvärde skiljer sig från ett förbisedd kontraktuellt undantag. En ofullständig anmälan skiljer sig från ett obehörigt utlämnande av data. Likaså måste det vara tydligt om ett system tillförlitligt svarar på en fråga, legitimt vidarebefordrar den till en människa eller matar ut ett resultat utan tillräcklig grund.
En meningsfull jämförelse använder förhandsgodkända fall och beaktar hela processen. För lämpliga processer kan fasade implementeringar eller kontrollerade jämförelsegrupper hjälpa till att skilja mellan tekniska förbättringar och generella förändringar. Granskningen bör också inkludera sällsynta men ekonomiskt betydande undantag. Ett system som hanterar rutinärenden väl men förbiser kritiska undantag kan vara övertygande i genomsnitt, men ändå oacceptabelt i praktiken.
Vektorsökning ersätter inte ett bindande åtagande
Vektordatabaser stöder sökningen efter innehållsrelaterade liknande texter genom att göra information jämförbar genom numeriska representationer som kallas inbäddningar. Moderna system kan dessutom använda metadatafilter, nyckelordssökningar och kombinerade sökmetoder. Det skulle därför vara felaktigt att framställa dem som i grunden kontextfria arkiv utan filtreringsmöjligheter.
Dess kärnfunktion besvarar emellertid en annan fråga än den om operativ styrning. Substanslikhet indikerar inte automatiskt om ett dokument är aktuellt, rättsligt bindande eller tillämpligt på ett specifikt ärende. Ett söksystem kan beakta sådana egenskaper om de lagras tillförlitligt och integreras korrekt i sökfrågan. Det fattar dock inte självt de nödvändiga affärsbesluten.
Detta leder till en tydlig investeringslogik för företag. Förbättrad sökning och utökade betydelselager kan komplettera varandra. Ytterligare sökresultat ersätter dock inte tydligt definierade ansvarsområden och regler. De som försöker korrigera varje felaktigt svar enbart med ett kraftfullare sökindex riskerar att tillhandahålla mer material utan att förtydliga dess sakliga giltighet.
🤖🚀 Hanterad AI-plattform: Snabbare, säkrare och smartare AI-lösningar med UNFRAME.AI

Hanterad AI-plattform - Bild: Xpert.Digital
Här får du lära dig hur ditt företag kan implementera skräddarsydda AI-lösningar snabbt, säkert och utan höga inträdesbarriärer.
En hanterad AI-plattform är din heltäckande och bekymmersfria lösning för artificiell intelligens. Istället för att behöva hantera komplex teknik, dyr infrastruktur och långa utvecklingsprocesser får du en färdig lösning skräddarsydd efter dina behov från en specialiserad partner – ofta inom bara några dagar.
De viktigaste fördelarna i korthet:
⚡ Snabb implementering: Från idé till färdig applikation på dagar, inte månader. Vi levererar praktiska lösningar som skapar omedelbart mervärde.
🔒 Maximal datasäkerhet: Dina känsliga uppgifter stannar hos dig. Vi garanterar säker och korrekt behandling utan att dela data med tredje part.
💸 Ingen ekonomisk risk: Du betalar bara för resultat. Höga initiala investeringar i hårdvara, mjukvara eller personal elimineras helt.
🎯 Fokusera på din kärnverksamhet: Koncentrera dig på det du gör bäst. Vi tar hand om hela den tekniska implementeringen, driften och underhållet av din AI-lösning.
📈 Framtidssäkert och skalbart: Din AI växer med dig. Vi säkerställer kontinuerlig optimering och skalbarhet, och anpassar modellerna flexibelt till nya krav.
Mer information här:
Dokumentens inverkan på affärsbeslut
Kunskapsdiagram kan göra mer än bara länkar
En kunskapsgraf representerar entiteter och deras relationer i en nätverksstruktur och kan därför utgöra en viktig komponent i ett semantiskt lager. Samtidigt kan formella ontologier och metoder som bygger på dem också stödja logiska slutsatser; etablerade standarder som OWL är inte begränsade till att enbart lagra grundläggande kopplingar. Det generella påståendet att en kunskapsgraf i princip inte kan representera regler skulle därför vara tekniskt felaktigt.
Den avgörande frågan är istället vilka funktioner en specifik lösning faktiskt kombinerar. En graf som innehåller företagsobjekt har inte automatiskt omfattande rättighetshantering, testad processkontroll eller en professionellt godkänd hantering av specialfall. Omvänt kan en lämpligt utformad grafarkitektur uppfylla betydande delar av dessa krav.
Ett semantiskt lager bör därför förstås mindre som en nödvändigtvis fristående produkt och mer som ett paket av nödvändiga funktioner. Vissa företag kan täcka stora delar av detta med befintliga BI-modeller, datakataloger, grafsystem och regeluppsättningar. Andra behöver en ytterligare plattform. Det som är ekonomiskt relevant är det bevisade funktionella gapet, inte antalet nyligen introducerade produktkategorier.
Anslut istället för att spara allt igen
Ett semantiskt lager kan koppla samman befintliga ERP- och CRM-system, dataplattformar och dokumentarkiv utan att först behöva migrera all företagsdata till en enda ny lagringsplats. Semantiska modeller för nyckeltal (KPI:er) kan också bygga vidare på befintliga datastrukturer och härleda lämplig frågelogik från dem. Den delade betydelsen är därför fundamentalt skild från den fysiska lagringen av data.
Detta betyder dock inte att en sådan arkitektur kan fungera utan någon datakopiering. Sökindex, extraherad dokumentinformation, cacher eller förberäknade resultat kan vara användbara för specifika användningsfall. Den relevanta affärsfrågan är vilken information som behöver lagras, var och hur länge, inte om löftet om fullständigt kopieringsskydd kan marknadsföras.
Ett väl utformat system balanserar aktualitet, svarstid, tillgänglighet, kostnader och datasekretess. Andra aktualitetskrav kan gälla för en lagerstatus än för en avtalsklausul. En fråga distribuerad över många källsystem kan vara flexibel, men den ökar också beroendet av deras tillgänglighet. Därför är den bästa lösningen inte nödvändigtvis maximalt centraliserad eller maximalt distribuerad, utan snarare lämplig för affärsprocessen.
Datakvalitet förblir en separat uppgift
Ett delat betydelselager gör inte automatiskt felaktiga källdata korrekta. Även leverantörer av semantiska frågesystem rekommenderar att man tar itu med grundläggande konsistensuppgifter, såsom att normalisera vanliga objekt och rensa olämpliga data, så tidigt som möjligt. Affärssemantik och datakvalitet kompletterar varandra; de är inte utbytbara uppgifter.
Ett särskilt illustrativt exempel är en affärspartners identitet. Olika stavningar kan hänvisa till samma leverantör. Liknande namn kan dock också tillhöra olika juridiska personer. En förhastad sammanslagning av dessa kan då leda till felaktig tilldelning av betalningsinformation, kreditvärdighetsdata eller avtalsförhållanden. En bra arkitektur måste därför kunna avslöja vilka tilldelningar som är bekräftade och var det bara finns ett rimligt antagande.
Detta är ekonomiskt viktigt eftersom fel inte alltid är synliga där de uppstår. En felaktig identitetsmatchning kan senare påverka flera analyser och beslut. Därför bör implementeringen fokusera inte bara på kvaliteten på individuella svar utan också på den tillförlitliga tilldelningen av de underliggande objekten. Annars mångfaldigar återanvändning inte bara kunskapen utan även dess fel.
Reglerna måste bli tekniskt effektiva
En policy i ett dokument utgör inte påtvingad kontroll. För AI-applikationer skiljer säkerhetskoncept uttryckligen mellan språkliga krav och tekniska åtgärder såsom begränsade funktioner, begränsade behörigheter och verifierbara exekveringsvillkor. Överdriven autonomi och alltför breda åtkomsträttigheter kan i synnerhet leda till felaktiga eller manipulerade modellutdata som utlöser skadliga åtgärder.
En robust arkitektur bör därför separera tolkning och utförande. Språkmodellen kan till exempel klassificera en process eller föreslå en åtgärd. Huruvida ett belopp har beräknats korrekt, om godkännande har beviljats eller om en bokning kan utföras bör i kritiska processer ytterligare säkras genom verifierbar logik och ansvariga system.
Detta klargör en vanlig missuppfattning. Ett semantiskt lager kan ge affärsgrunden för regelkompatibelt beteende. Det garanterar dock inte, i sig självt, att en probabilistisk språkmodell tillförlitligt kommer att tillämpa varje regel. Den ekonomiskt hållbara lösningen uppstår ur samspelet mellan betydelse, behörigheter, tester, processkontroller och tydligt definierade handlingsplaner.
Tillstånd är en del av betydelsen
Vid åtkomst till företagskunskap måste inte bara relevansen utan även åtkomstbehörigheten kontrolleras. Dokumentrelaterade kontroller kan begränsa sökresultaten baserat på användarens identitet och tilldelade rättigheter; deras effektivitet beror bland annat på korrekt synkroniserad behörighetsinformation. En delad kunskapsbas betyder därför inte att alla användare får se samma innehåll.
I praktiken är den tidsmässiga dimensionen avgörande. En anställd kan byta roll, ett projekt kan avslutas eller ett dokument kan därefter begränsas. Om sök- och kontextlagret använder föråldrade behörigheter kan det exponera innehåll som inte längre är tillgängligt i källsystemet. Därför måste underhåll av behörigheter uttryckligen inkluderas i driftskostnaderna.
Även frågor med liknande innehåll kan av goda skäl få olika svar. Två användare kan tillhöra olika ansvarsområden eller ha tillgång till olika datamängder. Konsekvens betyder därför inte identisk formulering, utan snarare samma yrkesregler i ett jämförbart sammanhang. En avvikelse utgör endast ett kvalitetsproblem om den inte kan förklaras av tid, roll, datatillgänglighet eller själva frågan.
Korrigeringar behöver en strukturerad process
Att registrera användarkorrigeringar är en av de avsedda kunskapskomponenterna i ett AI-orienterat semantiskt lager. Inom AI-riskhantering anses utredning av mänskliga överstyrningar och deras orsaker också vara en värdefull informationskälla för att utvärdera driftsatta system. Detta betyder dock inte att varje användarändring automatiskt ska bli en generell regel.
Ett korrigerat resultat kan ha väldigt olika orsaker. Kanske har en datapost tilldelats felaktigt. Kanske har ett kontraktuellt undantag tillämpats. Kanske har den tidigare företagsregeln varit föråldrad. Eller kanske har användaren helt enkelt angett en personlig preferens. Dessa fall kräver olika svar och bör inte urskillningslöst införlivas i en gemensam kunskapsbas.
En ekonomiskt sund inlärningsprocess behandlar initialt feedback som verifierbara förslag. Ämnesexperter beslutar om dess omfattning, bindande natur och nödvändiga tester. Först därefter görs en godkänd ändring tillgänglig för vidare tillämpningar. Detta kräver inte nödvändigtvis omskolning av språkmodellen. Det avgörande är att felet undviks i rätt sammanhang i framtiden, utan att oavsiktligt introducera nya fel någon annanstans.
Versionshantering skyddar mot falska retrospektiva vyer
Affärsdefinitioner och regler ändras; därför bör ett semantiskt lager versionskontrollera ändringar och tilldela dem till ämnesexperter för godkännande. Befintliga semantiska plattformar stöder redan versionsbaserade definitioner eller validerade referensfrågor, inklusive information om när och av vem de bekräftades. En spårbar historik är således inte ett dekorativt tillägg, utan en integrerad del av kontrollerad användning.
För en senare granskning är dock den nu gällande regeln otillräcklig. Det är också relevant vilken version som gällde vid tidpunkten för transaktionen och vilken information systemet faktiskt kunde behandla vid den tidpunkten. En senare mottagen avtalsändring får inte oavsiktligt bli grund för utvärdering av ett tidigare beslut. Annars uppstår en sken av klarhet i efterhand, som inte fanns vid tidpunkten för beslutet.
Företag bör därför beakta regelhistorik, dokumentversioner och datastatus tillsammans. Kostnadseffektiviteten här handlar mindre om att spara sekunder än om att minska kostnaderna för att lösa tvister. De som kan rekonstruera grunden för ett beslut lägger mindre tid på att pussla ihop det från e-postmeddelanden, individuella filer och efterföljande påminnelser.
Modellfrihet är ännu inte leverantörsfrihet
Företagskunskap bör organiseras på ett sådant sätt att en förändring av språkmodellen inte automatiskt kräver en fullständig omskrivning av affärsgrunden. Det strategiska argumentet för detta stöds av den tekniska dynamiken: Mellan november 2022 och oktober 2024 minskade kostnaden för modellfrågor med mer än en faktor 280 vid en prestandanivå jämförbar med GPT-3.5. Denna jämförelse avser en specifik riktmärkesnivå och bör inte tolkas som en motsvarande minskning av den totala kostnaden för en företagsapplikation.
Slutsatsen är dock rimlig: När modellens prestanda och priser förändras avsevärt blir möjligheten att byta alltmer värdefull. En permanent användbar teknisk modell kan förhindra att varje teknisk uppgradering utlöser en omfattande teknisk översättningsinsats. Modelloberoende får därmed karaktären av ett strategiskt alternativ.
Det eliminerar dock inte alla beroenden. Definitioner kan fortfarande vara knutna till proprietära plattformsformat, gränssnitt eller driftsmodeller. Därför bör ett företag separat bedöma om det kan byta språkmodell, exportera sina kunskapsdefinitioner och fortsätta köra hela lösningen med en annan leverantör. Endast denna åtskillnad möjliggör en realistisk utvärdering av byteskostnader och förhandling av hävstångseffekt.
Marknaden växer tillsammans
Semantiska definitioner erbjuds nu explicit för både BI och AI: Snowflake kopplar samman affärsmått och entitetsrelationer med frågor och agenter, medan dbt också tillhandahåller sina centralt definierade mätvärden via gränssnitt för AI-verktyg. Parallellt framkom Open Semantic Interchange som ett initiativ för leverantörsneutralt utbyte av semantiska metadata. Projektet accepterades i Apache Incubator 2026 under namnet Apache Ossie.
Denna utveckling är mer ekonomiskt betydelsefull än ytterligare ett produktmeddelande. Om flera verktyg kan använda samma definitioner minskas behovet av att skapa ny affärslogik i varje applikation fundamentalt. Samtidigt kan etablerade dataplattformar ta över större delar av det värdeskapande som tidigare reserverats för specialiserade tilläggslösningar.
För kunder innebär detta: Innan ett nytt köp görs bör en inventering göras. Befintliga datamodeller, kataloger över nyckeltal (KPI), auktoriseringssystem och gränssnitt kan täcka en del av kraven. Öppna utbytesformat är användbara i detta avseende, men de är inte ett fullständigt bevis på effektivitet. De måste bedömas utifrån vilka definitioner, regler och kontextuell information som kan överföras mellan de system som faktiskt används utan att förlora mening.
Unframekunskapsväv, objektivt sett
Unframe samlar sina semantiska funktioner under namnet Knowledge Fabric och kopplar samman företagskoncept, affärslogik, relationer och behörigheter. Metoden syftar till att göra strukturerade datamängder och dokumentinnehåll användbart för specifika användningsfall och att gradvis utöka kunskapsbasen. Lösningen erbjuds också med olika språkmodeller och integration i befintliga företagssystem.
Den ekonomiska fördelen med detta koncept ligger i kombinationen av tidigare separata uppgifter. Om systemintegration, affärskontext och kontrollerad användning fungerar väl tillsammans kan den ansträngning som krävs för ytterligare applikationer minskas. Huruvida denna fördel materialiseras i ett specifikt företag kan dock inte härledas enbart från det arkitektoniska namnet. Verifierbara resultat från företagets egna processer behövs.
Samtidigt är frågan om ägande och drift fortfarande relevant: Unframe skiljer mellan kundägda data, resultat och lösningskonfigurationer å ena sidan, och den leverantörsdrivna Knowledge Fabric och andra plattformskomponenter å andra sidan. Därför bör valfrihet gällande modell inte likställas med fullständigt oberoende från plattformen. För en tillförlitlig bedömning bör exportmöjligheter, rättigheter till tekniska definitioner och systemets kontinuitet vid ett operatörsbyte tydligt förtydligas.
Börja smått, förbli anpassningsbar
Ett tillämpningsorienterat tillvägagångssätt begränsar modelleringens omfattning och gör det möjligt att granska definitioner med relevanta ämnesexperter med hjälp av verkliga uppgifter. Istället för att omedelbart kartlägga hela företaget, registreras först nödvändiga system, objekt, relationer och regler för en tydligt definierad process. Godkända komponenter kan sedan utökas till att omfatta relaterade användningsfall.
Ur ett ekonomiskt perspektiv är en process med frekventa upprepningar, verifierbara resultat och tillräckligt betydande koordinationsproblem särskilt lämplig. Ett alltför enkelt användningsfall kan bara visa att ett chattfönster kan anslutas till en datakälla. Omvänt kan en alltför komplex introduktion skapa så många olösta specialfall att fördelarna först blir uppenbara efter lång tid.
Rätt balans ligger mellan en begränsad omfattning och en återanvändbar grund. Ett pilotprojekt bör inte vara en engångsprototyp. Samtidigt bör dess integrationspotential inte bli en ursäkt för att bygga en omfattande affärsmodell innan den första mätbara förbättringen. Riktmärket kvarstår vilka tekniska byggstenar som faktiskt behövs för nästa meningsfulla steg.
Professionellt ansvar avgör acceptans
Införandet av AI flyttar inte ansvaret från människor till programvara. Varje central definition kräver en behörig myndighet som kan bedöma och godkänna ändringar. Även övergripande ramverk för tillförlitlig AI betonar tydligt definierade mänskliga roller och ansvar i hanteringen av AI-system. Därför bör teknisk drift och expertbefogenheter inte underförstått tilldelas samma roll.
Detta kan vara organisatoriskt obekvämt. En gemensam definition av intäkter, kundtillhörighet eller risk kan påverka målsystem, ansvar och befintliga utvärderingsmetoder. Ett semantiskt lager exponerar sådana skillnader. Det löser dem inte genom teknisk elegans, utan kräver snarare beslut som tidigare kan ha undvikits.
Det är också här dess långsiktiga värde ligger. När koncept och regler inte längre enbart är begränsade till enskilda anställdas medvetanden eller spridda över olika tillämpningar, kan företaget bli mindre beroende av informella kunskapsmonopol. Denna fördel förutsätter dock att specialister är involverade i designprocessen och upplever meningslagret som stödjande. Om det enbart introduceras som ett kontrollinstrument kan viljan att bidra med värdefull erfarenhetskunskap minska.
Inte alla företag behöver samma djup
Europeiska användningsdata visar på betydande skillnader i omfattningen av AI-implementering, utan att nödvändigtvis indikera ett behov av en specifik arkitektur. Dessutom, bland företag som hade övervägt att använda AI men ännu inte gjorde det år 2025, angav 70,89 procent brist på relevant expertis som en anledning till att inte använda det; 52,52 procent pekade på oklara rättsliga konsekvenser och 48,83 procent på oro för dataskydd. Dessa siffror avser specifikt denna undergrupp och inte alla företag.
Detta möjliggör utveckling av ett differentierat investeringsperspektiv. Ett litet företag med få system och hanterbara processer kan initialt kräva konsekventa nyckeltal (KPI:er) och tydligt underhållna kunskapsbaser. Ett företag med många dotterbolag, produktlinjer och åtkomstroller kan å andra sidan dra nytta av en mer omfattande semantisk infrastruktur. Lämplig detaljnivå beror på komplexitet och risk, inte på hur attraktivt en viss teknologiterm är.
Att avstå från vissa uppgifter kan också vara ekonomiskt försvarbart. Om en uppgift inträffar sällan, inte har några större konsekvenser och kan utföras på ett tillförlitligt sätt med en enkel procedur, kan underhållskostnaderna för ett ytterligare lager överväga dess fördelar. En övertygande arkitektonisk metod måste därför också kunna förklara var den inte behövs.
Kontrollerad betydelse som en konkurrensfördel
Generativ AI kan övertygande presentera bristfälligt innehåll; denna risk är bland de uttryckligen beskrivna egenskaperna och farorna med sådana system. Inte ens ytterligare företagsinformation och hämtningsmetoder eliminerar alla säkerhetsrisker, såsom de som manipulerade instruktioner i bearbetat innehåll utgör. Därför är ett semantiskt lager ingen garanti för sanning, säkerhet eller kostnadseffektivitet.
Dess berättigade strategiska betydelse ligger någon annanstans. Den kan stödja övergången från spridd erfarenhetskunskap till explicita, återanvändbara och ansvarstagande affärsdefinitioner. Detta gör det möjligt att inte bara distribuera AI sporadiskt, utan att gradvis integrera den i ett kontrollerat operativt system. Den bestående tillgången är då inte den enskilda assistenten, utan den organiserade förmågan att på ett tillförlitligt sätt utnyttja företagets kunskap för nya uppgifter.
Den avgörande konkurrensfördelen uppstår därför inte i att ha det största antalet autonoma agenter. Den uppstår när företag snabbare kan identifiera vilken information som är giltig, vilka undantag som är relevanta och vilka handlingar som fortfarande är berättigade. De som behärskar denna grund kan använda förändrade modeller och verktyg mer effektivt. De som försummar den riskerar främst att öka hastigheten på sina egna missförstånd med varje ny AI-tillämpning.
Konsulttjänster - Planering - Implementering

Konrad Wolfenstein
Jag skulle gärna fungera som din personliga rådgivare.
Du kan kontakta mig på wolfenstein∂xpert.digital eller
Ring mig bara på +49 7348 4088 965 .


