Aleph Alpha och Kolibri-1: Tysklands AI-comeback mellan effektivitet, beroende och ett nytt maktblock – kreativ bild i ämnet, med AI: Xpert.Digital
78 miljarder parametrar och fortfarande effektiv: Kolibri-1 i fokus
Tyska och engelska: Kolibri-1 som en ekonomisk differentiator
Från chatbot till processautomation: Utvecklingen av Kolibri-1
Med lanseringen av Kolibri-1 presenterar Aleph Alpha en innovativ AI-modell som inte bara är skräddarsydd för tyska företags behov utan också kan sätta internationella standarder. Till skillnad från andra stora språkmodeller, som ofta domineras av amerikanska eller kinesiska företag, syftar Kolibri-1 till att tillhandahålla en kontrollerbar och effektiv AI-lösning, särskilt lämplig för känsliga data och komplexa dokument. Dess fokus på tyska och engelska, liksom dess integration i befintliga affärsprocesser, kan vara avgörande för många organisationer, särskilt på en marknad som i allt högre grad söker lösningar som är både högpresterande och datasäkra. I detta sammanhang uppstår frågan om Kolibri-1 bara är ett tekniskt experiment eller hörnstenen i ett nytt kapitel i europeisk AI-utveckling. De utmaningar och möjligheter som denna modell presenterar utforskas i detalj i följande avsnitt.
78 miljarder parametrar – och ändå är det i slutändan inte modellen som avgör, utan infrastrukturen
En modell som en ekonomisk-politisk signal
Med Kolibri-1 återvänder Aleph Alpha till en disciplin som det Heidelberg-baserade företaget till stor del verkade ha dragit sig ur: utvecklingen av stora, generellt tillämpliga språkmodeller. Det nya systemet är dock inte bara ett försök att replikera amerikanska eller kinesiska modeller. Det är utformat som en specialiserad tysk-engelsk grund för företag, offentliga förvaltningar och reglerade industrier. Kolibri-1 riktar sig således mindre till massmarknaden för gratis chatbotar och mer till en kommersiellt attraktiv, men mindre tillgänglig, marknad: kontrollerbar AI för känsliga data, långa dokument, interna kunskapsbaser, industriella processer och agentbaserade arbetsflöden.
Publikationen bör därför inte enbart ses som en teknisk händelse. Den berör tre centrala ekonomiska frågor i den europeiska AI-strategin. För det första handlar den om huruvida europeiska leverantörer kan utveckla tekniskt oberoende grundmodeller utan att bli permanent beroende av de stora plattformarna från USA och Kina. För det andra väcker den frågan om en högpresterande, öppet tillgänglig modell också genererar en livskraftig affärsmodell. För det tredje bestäms den ekonomiska nyttan inte av antalet parametrar, utan av huruvida företag kan driva modellen säkert till rimliga kostnader, integrera den i befintliga processer och hålla den kontinuerligt uppdaterad.
Kolibri-1 lanseras i en gynnsam marknadsmiljö. De tyska utgifterna för artificiell intelligens förväntas öka till 28,7 miljarder euro år 2026, vilket motsvarar en tillväxt på cirka 48 procent jämfört med föregående år. Generativ AI står redan för cirka 11,5 miljarder euro, eller cirka 40 procent av den totala marknaden. Samtidigt är dess praktiska tillämpning i tyska företag fortfarande betydligt mindre utbredd än vad de höga investeringssummorna antyder. Endast en bråkdel av företagen ger sina anställda direkt tillgång till generativa AI-applikationer. Särskilt mindre företag är tveksamma på grund av kostnader, oro för dataskydd, brist på kvalificerad arbetskraft och oklara integrationsvägar.
Detta skapar ett marknadsgap. Företag vill använda kraftfull AI, men de vill inte överföra känslig information till externa plattformar utan verifiering. De behöver transparenta verksamhetsmodeller, kontrollerbara dataflöden, tyskspråkig kvalitet och juridiskt sunda implementeringskoncept. Det är just här Kolibri-1 kommer in. Modellen är därför mindre av en attack mot de mest populära chatbotarna och mer av ett erbjudande till organisationer som vill bygga sin egen AI-infrastruktur av regulatoriska, strategiska eller ekonomiska skäl.
Ekonomisk aktivering istället för liten arkitektur
Kolibri-1 omfattar totalt cirka 78,1 miljarder parametrar. Denna siffra låter initialt som en mycket stor och motsvarande dyr modell. I själva verket fungerar systemet dock med en expertmix-arkitektur. Det betyder att inte alla parametrar aktiveras i varje bearbetningssteg. Istället bestämmer en router vilka specialiserade delnätverk som ansvarar för respektive token. Av de 78,1 miljarderna parametrar är endast cirka 3,46 miljarder aktiva per token. Detta motsvarar cirka 4,4 procent av den totala kapaciteten.
Arkitekturen består av 50 transformatorlager. Varje lager har 384 specialiserade experter. En gemensam expert är alltid aktiv, medan sex andra aktiveras beroende på innehållet i respektive token. Det underliggande konceptet är ekonomiskt attraktivt: Modellen besitter kunskapen och specialiseringskapaciteten hos ett mycket stort system, men kräver bara en bråkdel av de vanliga beräkningsoperationerna för ett enda beräkningssteg. Detta möjliggör grundläggande förbättringar av genomströmning och driftskostnader jämfört med en tät modell av liknande totalstorlek.
Denna effektivitet bör dock inte förväxlas med låga minneskrav. Alla modellvikter måste förbli tillgängliga i minnet eftersom routern kan aktivera olika experter beroende på indata. FP8-varianten kräver cirka 78 gigabyte grafikminne enbart för vikterna. Ytterligare minne behövs för kontexten (KV-cachen), temporära beräkningar, parallellisering och runtime-miljön. Därför är den rekommenderade lägsta konfigurationen två A100 GPU:er med 80 gigabyte vardera, två H100 SXM5 GPU:er eller en enda H200-, B200- eller B300 GPU. För stabil produktionsdrift rekommenderas kraftfullare eller redundanta konfigurationer.
Detta belyser den centrala spänningen som är inneboende i Kolibri-1. Beräkningsansträngningen per token är jämförelsevis låg, men tillgången till nödvändig hårdvara är fortfarande kapitalintensiv. För ett företag med befintlig GPU-infrastruktur kan modellen vara ekonomiskt attraktiv. För ett medelstort företag utan eget AI-kluster är dock direkt hosting sällan den mest kostnadseffektiva lösningen. Här kommer managed hosting-tjänster, suveräna molntjänster eller branschspecifika plattformar sannolikt att spela den avgörande rollen.
Den ekonomiska fördelen med en expertarkitektur är därför inte automatisk. Den är beroende av hög utnyttjandegrad. En dyr GPU som bara behandlar enstaka förfrågningar förblir oekonomisk även med en effektiv modell. Ju fler användare, dokumentprocesser och agentbaserade applikationer som samlas i en delad infrastruktur, desto bättre kan de fasta kostnaderna fördelas. För datacenteroperatörer, molnleverantörer och stora företag är Kolibri-1 därför betydligt mer attraktivt än för enskilda småföretag med låg utnyttjandegrad.
En miljon tokens är inte ett frikort
En viktig egenskap hos Kolibri-1 är dess förmåga att bearbeta mycket långa indata. Initial träning genomfördes med sekvenser om 16 384 tokens. I en efterföljande träningsfas ökades längden till 65 536 tokens. Den sista fasen med lång kontext arbetade med 262 144 tokens. Denna längd anses vara modellens ursprungliga kontext. Tekniskt sett kan systemet utökas utöver detta utan efterföljande positionsskalning. Kvaliteten och tillgängligheten verifierades upp till 1 048 576 tokens.
Beroende på språk, format och tokenisering kan en miljon tokens representera flera tusen sidor text. Detta öppnar upp applikationer för företag som endast i begränsad utsträckning är möjliga med traditionella chatbotar. Dessa inkluderar analys av omfattande kontrakt, tekniska manualer, underhållsdokumentation, juridiska samlingar, forskningsarkiv, leverantörsdokument och interna kunskapsbaser. Komplexa due diligence-granskningar, anbudsanalyser, compliance-jämförelser och utvärdering av långa ärenden förenklas också i princip.
Det ekonomiskt relevanta är dock inte bara den maximala kontextlängden, utan kostnaden per meningsfullt bearbetad information. En mycket lång kontext ökar minnesförbrukningen för CLU-cachen (Computational Logic), förlänger svarstiderna och kan avsevärt minska dataflödet. Dessutom garanterar inte ett stort kontextfönster att modellen på ett tillförlitligt sätt hittar all relevant information, viktar den korrekt och bearbetar den konsekvent. Ju längre inmatningen är, desto större är risken att viktiga detaljer går förlorade bland irrelevanta passager.
Därför ligger det ekonomiskt gångbara användningsområdet ofta under det tekniska maximumet. För komplexa uppgifter och latenskritiska applikationer rekommenderas en gräns på högst 262 144 tokens. I många företagsapplikationer förblir en betydligt mindre kontext, i kombination med hämtningsförstärkt generering, mer effektiv. I denna metod laddas inte alla tillgängliga dokument in i modellen samtidigt. Ett söksystem väljer först de förmodat relevanta avsnitten och skickar endast dessa till språkmodellen.
Kolibri-1 ersätter inte RAG. Snarare utökar dess stora kontextfönster möjligheterna för hybridarkitekturer. Till exempel kan ett företag först semantiskt söka i tusentals dokument, sedan ladda flera hundra relevanta sidor i kontexten och låta modellen generera en motiverad analys utifrån detta. Mervärdet uppstår genom kombinationen av sökning, dokumentförståelse, källattribution, strukturerad utdata och mänsklig granskning. Omvänt riskerar det höga kostnader med begränsade insikter att urskillningslöst placera hela dataområden i modellen.
Tyskan håller på att bli en ekonomisk differentiator
Det verkliga strategiska värdet av Kolibri-1 ligger i dess konsekventa fokus på tyska och engelska. Ungefär 62,5 procent av det grundläggande utbildningsmaterialet består av engelskt innehåll, cirka 23,9 procent av tyska texter och ungefär 13,6 procent av programkod. I senare utbildningsfaser integrerades dessutom instruktionsdata, resonemangsuppgifter, agentbaserade processer, ämnesinnehåll och långa dokument. Förutbildningsfasen omfattade totalt 20 biljoner tokens. Ytterligare 3,44 biljoner tokens användes i den mellersta utbildningsfasen, och 201 miljarder tokens investerades i att utöka kontextfönstret.
Den tyska komponenten är betydande jämfört med andra länder. Medan många globala modeller kan generera flytande tyska, tränades de huvudsakligen på engelsk data. Detta har en särskild inverkan på juridiska nyanser, administrativt språk, sammansatta facktermer, regionala uttryck och branschspecifika texttyper. Kolibri-1 använder sin egen tokenizer med 128 000 poster, vilket tar större hänsyn till morfologin och den sammansatta formationen av det tyska språket. Detta gör att tysk text kan bearbetas mer kompakt och effektivt.
Denna tekniska funktion har direkta ekonomiska konsekvenser. Färre tokens per tyskt dokument kan minska lagringskrav, handläggningstid och därmed kostnader. Kvaliteten i specialiserade applikationer är dock ännu viktigare. Mindre språkliga brister är ofta tolererbara i en kundtjänstchatt. Däremot kan oprecis terminologi i en kontraktsanalys, ett tekniskt säkerhetsdirektiv eller en administrativ process leda till betydande merkostnader.
Tyskland har stora arkiv med värdefulla men svåråtkomliga tekniska dokument. Industriföretag har arkiv med konstruktionsspecifikationer, underhållsrapporter, kvalitetsmeddelanden, standarder, kommentarer till stycklistor och leverantörskorrespondens som har vuxit under årtionden. Myndigheter hanterar omfattande filer, föreskrifter, officiella meddelanden och procedurdokumentation. Försäkringsbolag, banker, energileverantörer och vårdorganisationer arbetar med hårt reglerade textarkiv. En modell som bättre fångar detta innehåll språkligt och strukturellt kan generera produktivitetsvinster där allmänna chattrobotar når sina gränser.
Det tvåspråkiga fokuset är också en begränsning. Internationella företag kräver ofta enhetliga system för dussintals språk. I sådana fall kan en brett flerspråkig modell vara mer ekonomiskt fördelaktig, trots svagare tysk specialisering. Kolibri-1 är därför särskilt övertygande där tyska och engelska utgör majoriteten av den värdeskapande kommunikationen. Den avsiktliga begränsningen till två språk är inte en universell lösning, utan snarare ett strategiskt fokus på en tydligt definierad marknad.
Från chatbot till digital processarbetare
Kolibri-1 stöder ett explicit resonemangsläge. Användare eller applikationer kan ställa in resonemangsansträngningen till låg, medel eller hög, eller inaktivera det ytterligare resonemanget helt. Denna gradering är viktigare för företagsanvändning än den först verkar. Inte alla uppgifter kräver långvarig intern bearbetning. Enkel klassificering, snabb extrahering eller omformulering av text bör göras snabbt och kostnadseffektivt. Däremot kan komplex teknisk analys eller flerstegsplanering dra nytta av en högre resonemangsnivå.
Detta gör det möjligt att styra datorkraften baserat på en uppgifts ekonomiska värde. Ett företag kan utföra rutinprocesser med låg kognitiv ansträngning och endast avsätta extra beräkningstid för svåra fall. Detta liknar riskbaserad resurshantering: ju större de potentiella konsekvenserna av ett felaktigt svar är, desto högre ansträngning krävs för verifiering, hämtning och resonemang. Detta kräver dock att applikationen väljer denna komplexitetsnivå på lämpligt sätt och övervakar resultaten.
Ännu viktigare är dess förmåga att utföra verktygsanrop. Modellen kan generera strukturerade funktionsanrop, hämta information via programmeringsgränssnitt, komma åt söksystem, exekvera kod och mata ut data i fördefinierade format. Detta omvandlar en enkel textgenerator till en byggsten för agentbaserade arbetsflöden. Till exempel kan en assistent förstå en fråga, söka efter relevanta dokument, hämta data från ett ERP-system, utföra beräkningar och skapa ett utkast till beslutsmall.
Den ekonomiska hävstången ligger inte i automatiserad textgenerering, utan i att kombinera tidigare separata processteg. När en servicetekniker inte längre behöver söka i flera system efter artikelnummer, underhållshistorik och avtalsvillkor minskar handläggningstiden. När en inköpsavdelning automatiskt strukturerar leverantörsdokument, identifierar risker och förbereder jämförelsetabeller ökar kapaciteten utan en proportionell ökning av personalstyrkan. När en myndighet extraherar filinnehåll och skapar standardiserade utkast kan specialister ägna mer tid åt juridisk bedömning och medborgarengagemang.
Helt autonomt beslutsfattande kan dock inte härledas från detta. Kolibri-1 är utformat för system där människor granskar utgifter innan de vidtar åtgärder. I beslutsprocesser bör modellen samla in bevis, formulera alternativ och belysa motsägelser, men inte fatta bindande beslut utan tillsyn. Detta gäller särskilt personal, utlåning, medicin, offentliga tjänster, säkerhetsfrågor och andra områden med betydande individuella eller samhälleliga konsekvenser.
Öppet tillgängliga vikter förändrar förhandlingsstyrkan
Kolibri-1 släpptes under Apache 2.0-licensen. Företag kan ladda ner vikterna, köra dem på sin egen infrastruktur, anpassa dem och i princip använda dem kommersiellt. Jämfört med proprietära programmeringsgränssnitt minskar detta beroendet av en enda leverantör. Prissättning, användarvillkor eller produktstrategier hos en extern plattformsoperatör kan förändra ett företags eget system mindre abrupt när modellen verkar inom företagets egen ansvarssfär.
Denna öppenhet stärker kundernas förhandlingsposition gentemot moln- och mjukvaruleverantörer. Ett företag kan jämföra olika hostingpartners, byta infrastruktur eller köra särskilt känsliga applikationer helt internt. Branschspecifika anpassningar är också möjliga. Konsultföretag, integratörer och mjukvaruföretag kan utveckla sina egna lösningar baserade på modellen utan att behöva betala en proprietär modellavgift för varje förfrågan.
Öppen vikt betyder dock inte att hela systemet är öppen källkod i strikt bemärkelse. Modellvikter och konfigurationsfiler finns tillgängliga. Träningsdata, komplett träningskod, arkitekturutveckling och alla produktionsverktyg avslöjas inte automatiskt. Den publicerade licensen ger breda användningsrättigheter till de tillhandahållna komponenterna men tillåter inte en fullständig reproduktion av utvecklingsprocessen.
Inte ens gratis nedladdningsbara vikter eliminerar driftskostnaderna. Företag måste finansiera hårdvara, energi, datacenterutrymme, övervakning, säkerhet, uppdateringar och kvalificerad personal. Till detta kommer kostnader för dataförberedelse, vektordatabaser, åtkomstkontroller, utvärdering, loggning och applikationsskydd. I många fall är modelllicensen bara en liten del av den totala kostnaden.
Det ekonomiska beslutet är därför inte ett val mellan en gratismodell och ett betalt API. Det är ett val mellan fasta kostnader och rörliga kostnader. Proprietära API:er tar vanligtvis ut ett pris per bearbetad token eller per begäran. Intern hosting medför höga initial- och installationskostnader, men kan bli mer kostnadseffektivt med stor och konsekvent användning. Företag med fluktuerande eller låga volymer gynnas ofta av molnfakturering baserad på användning. Organisationer med konsekvent hög användning, strikta datakrav eller strategiska anpassningsbehov kan dra nytta av intern hosting.
En ny dimension av digital transformation med 'Managed AI' (Artificial Intelligence) - Plattform & B2B-lösning | Xpert Consulting

En ny dimension av digital transformation med 'Managed AI' (Artificial Intelligence) – Plattform & B2B-lösning | Xpert Consulting - Bild: Xpert.Digital
Här får du lära dig hur ditt företag kan implementera skräddarsydda AI-lösningar snabbt, säkert och utan höga inträdesbarriärer.
En hanterad AI-plattform är din heltäckande och bekymmersfria lösning för artificiell intelligens. Istället för att behöva hantera komplex teknik, dyr infrastruktur och långa utvecklingsprocesser får du en färdig lösning skräddarsydd efter dina behov från en specialiserad partner – ofta inom bara några dagar.
De viktigaste fördelarna i korthet:
⚡ Snabb implementering: Från idé till färdig applikation på dagar, inte månader. Vi levererar praktiska lösningar som skapar omedelbart mervärde.
🔒 Maximal datasäkerhet: Dina känsliga uppgifter stannar hos dig. Vi garanterar säker och korrekt behandling utan att dela data med tredje part.
💸 Ingen ekonomisk risk: Du betalar bara för resultat. Höga initiala investeringar i hårdvara, mjukvara eller personal elimineras helt.
🎯 Fokusera på din kärnverksamhet: Koncentrera dig på det du gör bäst. Vi tar hand om hela den tekniska implementeringen, driften och underhållet av din AI-lösning.
📈 Framtidssäkert och skalbart: Din AI växer med dig. Vi säkerställer kontinuerlig optimering och skalbarhet, och anpassar modellerna flexibelt till nya krav.
Mer information här:
Den verkliga kostnaden för Kolibri-1 i affärsverksamheten
Den riktiga beräkningen börjar efter nedladdningen
En sund ekonomisk analys för Kolibri-1 måste sträcka sig långt bortom GPU-köpet. På kapitalsidan inkluderar detta upphandling, finansiering, nätverksteknik, lagringssystem, kylning och potentiellt nödvändiga strukturella modifieringar. På driftssidan uppstår kostnader för el, underhåll, personal, programvarudrift och tillförlitlighet. Redundanta system krävs ofta för produktionsapplikationer. En enda server kan räcka för testning, men den utgör inte en pålitlig företagstjänst.
Utnyttjandegraden är den viktigaste kostnadsfaktorn. En internt driven modell kan teoretiskt sett uppnå låga marginalkostnader per ytterligare förfrågan. I praktiken måste dock infrastrukturen vara tillgänglig även under perioder med låg efterfrågan. Om den bara används med tio eller tjugo procents kapacitet sprids de fasta kostnaderna över ett litet antal tokens. En specialiserad hostingleverantör kan aggregera belastningen från olika kunder och därmed arbeta mycket mer effektivt. Detta talar för suveränt hanterade AI-erbjudanden, där datalagring, modelldrift och styrning kombineras i en kontrollerad europeisk infrastruktur.
Långsiktiga sammanhang förändrar också kostnadsstrukturen. Bearbetning av ett stort dokument binder upp lagrings- och bearbetningstid under en längre period. När flera användare samtidigt skickar in hundratusentals tokens minskar antalet förfrågningar som kan hanteras parallellt. Därför måste företag modellera inte bara den genomsnittliga förfrågan utan även toppbelastningar, svarstidskrav och prioriteringar. Ett system för nattlig batchbehandling kan fungera betydligt mer kostnadseffektivt med samma hårdvara än en interaktiv assistent med garanterade svarstider.
Anpassning till företagsdata medför extra kostnader. Ofta är fullständig finjustering inte nödvändig. Ett bra RAG-system, rena metadata och ett robust auktoriseringskoncept ger ofta större fördelar. Finjustering kan vara användbart när återkommande format, affärsspråk eller arbetsflöden behöver läras in på ett tillförlitligt sätt. Det ökar dock den ansträngning som krävs för datakvalitet, testning, versionshantering och omverifiering efter modelluppdateringar.
Den största dolda kostnadsfaktorn är kvalitetssäkring. En språkmodell kan ge övertygande resultat och ändå ha fel. Därför kräver produktiva system affärsrelaterade testfall, definierade feltoleranser och kontinuerlig utvärdering. För varje kritisk applikation måste företag mäta hur ofta modellen hittar korrekt information, när den genererar ogrundade slutsatser, om den följer åtkomsträttigheter och hur den reagerar på manipulerade dokument. Utan dessa kontroller är en låg tokenkostnad ekonomiskt värdelös eftersom även ett enda fel kan orsaka betydande skador.
950 megawattimmar och frågan om effektivitet
Energiförbrukningen för faserna före träning, mitten av träningen och långa kontexter uppskattas till cirka 950 megawattimmar. Denna siffra inkluderar energiförbrukningen för beräkningsnoderna och datacentrets overhead. Den inkluderar bland annat inte övervakad finjustering, förstärkningsinlärning, hjälpmodeller, testserier eller viloläge och topptillstånd. Den faktiska totala energiförbrukningen för utvecklingsprogrammet är därför högre än den publicerade siffran.
Förträningsfasen pågick i 21 dagar på 768 Nvidia B200 GPU:er fördelade över 96 HGX-system. Detta resulterade i cirka 392 000 GPU-timmar. Den efterföljande medellånga träningsfasen varade i cirka fem dagar och krävde ungefär 90 000 GPU-timmar. Den långsiktiga kontextfasen lade till ytterligare 10 000 GPU-timmar. Den rapporterade beräkningsansträngningen är 6,4 x 10^23 flyttaloperationer.
Siffran 950 megawattimmar verkar hög, men den måste tolkas i ekonomiska termer. Utbildning är en engångsinvestering i en återanvändbar digital tillgång. Den avgörande faktorn är hur intensivt modellen sedan används och vilka produktiva effekter den genererar. Om en modell används i tusentals tillämpningar under flera år fördelas utbildningsinsatsen över en stor mängd ekonomisk produktion. Omvänt, om det förblir ett tekniskt demonstrationsprojekt med låg användning, är resursproduktiviteten svag.
För miljökonsekvensbedömningen blir den pågående driften ofta mer betydelsefull på lång sikt än en engångsutbildning. Varje fråga förbrukar energi, och stora kontextfönster ökar denna efterfrågan. Samtidigt kan en effektiv expertmodell kräva färre beräkningar per token än en tät modell med jämförbar total kapacitet. Den avgörande jämförelsen är därför inte hög absolut förbrukning kontra ingen förbrukning, utan snarare energi per användbart resultat.
Europa har ett strategiskt incitament för effektivitet. Höga elpriser och begränsad datacenterkapacitet gör slösaktiga arkitekturer särskilt dyra. Modeller som Kolibri-1, som bara aktiverar en liten delmängd av sina parametrar, passar in i en europeisk strategi att kombinera teknisk prestanda med resursproduktivitet. Denna fördel motverkas dock delvis av de höga lagringskraven och den nödvändiga högpresterande hårdvaran.
Riktmärken visar styrka, men ingen tydlig vinnare
De publicerade jämförelsedatana positionerar Kolibri-1 som en högpresterande modell i sin storleks- och effektivitetsklass. Den uppnår ett totalt genomsnitt på 75,5 poäng i engelska och 70,8 poäng i tyska. Dess prestanda är särskilt stark i matematik och flerstegsresonemang. Den uppnår 96,0 procent i det engelska AIME-2026-testet och 90,0 procent i den tyska versionen. I det vetenskapligt krävande GPQA Diamond-testet uppnår modellen 84,3 procent i engelska och 81,3 procent i tyska.
Kolibri-1 visar även konkurrenskraftiga resultat inom programmeringsuppgifter, agentbaserade processer och industriella RAG-scenarier. Särskilt anmärkningsvärt är dess höga poäng inom områden som fordonsleveranser, halvledarteknik, den tyska offentliga sektorn och industriell drivteknik. Detta stöder dess positionering som en modell för kunskapsintensiva affärsprocesser. Lika betydande är förbättringen jämfört med en tidigare modellbaslinje: Efterutbildning har avsevärt stärkt resonemang, verktygsanvändning och instruktionerföljsamhet.
Kolibri-1 är dock inte ledande inom alla discipliner. Tätare och större konkurrerande modeller uppnår bättre resultat i flera kunskaps-, kod- och långkontexttester. Andra expertmodeller presterar också bättre i enskilda verktygsanrop eller hämtningsuppgifter. De tyska resultaten är starka, men inte genomgående överlägsna. Därför kan en tydlig ekonomisk fördel inte härledas enbart från en jämförelsetabell.
Riktmärken återspeglar endast definierade testförhållanden. I verkliga företag är dokumentkvalitet, behörigheter, formatdiversitet, teknisk jargong och konsekvenserna av fel betydligt mer komplexa. En modell kan prestera bra i ett standardiserat test men ändå misslyckas på grund av dåligt skannade PDF-filer, motstridiga äldre data eller interna förkortningar. Omvänt kan en modell med ett något lägre genomsnittligt resultat vara överlägsen i en välkonfigurerad företagsapplikation.
För upphandlings- och arkitekturbeslut är intern testning därför avgörande. Företag bör använda representativa dokument, utmanande kantfall och verkliga processdata. Mätningar måste omfatta inte bara svarsnoggrannhet utan även kostnad, latens, stabilitet, källreferens, felbeteende och underhållbarhet. Kolibri-1, med sina öppna vikter, är väl lämpad för sådana kontrollerade utvärderingar. Detta är en betydande fördel jämfört med system vars interna versioner och driftsförhållanden kan ändras utan kundens ingripande.
Säkerhet är en systemisk uppgift
Träningen av Kolibri-1 inkluderar åtgärder mot skadligt innehåll, personuppgifter och hallucinationer. Personligt identifierbar information togs delvis bort eller ersattes under förträningen. För övervakad finjustering lades data till för att försvara sig mot attacker på personlig information. Dessutom tränades modellen att avstå från att svara när den ställdes inför saknad eller motsägelsefull information.
Dessa åtgärder minskar riskerna, men eliminerar dem inte. Språkmodeller kan generera falsk information, anta politiska eller sociala partiskheter och reagera på manipulerad inmatning. Indirekta prompt injection-attacker är särskilt problematiska. I dessa attacker innehåller ett hämtat dokument dolda instruktioner som är utformade för att lura modellen att utföra oönskade åtgärder. Ju mer omfattande verktygsanrop och automatiserade processer används, desto större är den potentiella skadan från en sådan attack.
Säkra företagssystem kräver därför flera skyddslager. Åtkomst måste beviljas enligt principen om minsta behörighet. Verktygsanrop måste valideras, känsliga åtgärder kräver godkännande och utdata måste loggas. Modellen får inte ensam bestämma vilka data den får se eller vilka transaktioner den får utföra. Dess behörigheter måste vara tekniskt begränsade utanför modellen.
Det utökade sammanhanget skapar också nya risker. Stora volymer dokument kan innehålla konfidentiell information, personuppgifter eller motstridiga instruktioner. Den som hanterar hela datarum måste se till att användare endast får information som de har behörighet att komma åt. En central språkmodell över olika avdelningar utan konsekvent åtkomstseparation kan oavsiktligt bryta ner befintliga informationssilos.
Därför kräver implementering i reglerade branscher mer än en modell som utvecklats i Europa. Det kräver dokumenterade riskbedömningar, dataklassificering, mänsklig tillsyn, tekniska protokoll och tydliga ansvarsfördelningar. Suveränitet betyder inte bara att data finns i ett specifikt datacenter. Det betyder att en organisation kontrollerar hela det tekniska och juridiska beslutslandskapet.
Det transatlantiska maktblocket bakom modellen
Lanseringen av Kolibri-1 sammanfaller med en period av djupgående företagsomstrukturering. Aleph Alpha och det kanadensiska AI-företaget Cohere har ingått ett bindande avtal om sammanslagning. Transaktionen är fortfarande föremål för slutgiltiga myndighetsgodkännanden i början av oktober 2026. Det sammanslagna företaget kommer att verka globalt under varumärket Cohere, med huvudkontor i Toronto och Berlin. Heidelberg-anläggningen kommer att behållas som ett forskningscenter.
Denna konstellation förändrar klassificeringen av Kolibri-1. Även om modellen utvecklades i Tyskland, avgörs dess ekonomiska framtid i allt högre grad inom en transatlantisk organisation. Sammanslagningen kombinerar Aleph Alphas forskning, tyskspråkiga expertis och tillgång till den offentliga sektorn med Coheres internationella räckvidd, företagsprodukter och försäljningskapacitet. Detta kan påskynda kommersialiseringen men minskar föreställningen om en helt oberoende tysk AI-mästare.
Politiskt framställs partnerskapet som ett alternativ från Tyskland och Kanada till de dominerande amerikanska plattformsföretagen. Denna beskrivning är förståelig, men bara delvis tillräcklig. Även om Kanada är en nära partner till Europa, är det föremål för olika juridiska, kapitalmarknads- och säkerhetsstrukturer. Digital suveränitet uppstår inte automatiskt från de inblandade företagens nationalitet. Avgörande faktorer inkluderar ägarstrukturer, styrning, dataåtkomst, infrastrukturkontroll och europeiska kunders möjlighet att byta leverantör och plats.
Schwarz-gruppen spelar en nyckelroll i detta. De var redan en betydande investerare i Aleph Alpha och investerar ytterligare i det sammanslagna företaget. Genom Schwarz Digits och molnplattformen STACKIT kommer de att tillhandahålla datorkapacitet för suveräna AI-erbjudanden. Detta skapar en mer vertikalt integrerad struktur som omfattar modellutveckling, företagsprogramvara, molninfrastruktur och datacenterkapacitet.
Ur ett ekonomiskt perspektiv är denna konsolidering vettig. En enda modell ensam genererar inte marknadsmakt. Värdeskapande uppstår från försäljning, integration, hosting, dataplattformar och långsiktiga kundavtal. Den transatlantiska alliansen kan täcka dessa nivåer bättre än Aleph Alpha ensam. Samtidigt ökar detta beroendet av ett fåtal stora partners. Om STACKIT skulle bli den föredragna tekniska grunden skulle öppenheten i modellvikterna i praktiken kunna kompletteras av ett starkt engagemang för ett specifikt operativt ekosystem.
Europas suveränitet behöver skalas, inte symbolik
Europa investerar kraftigt i AI-infrastruktur. Nätverket av europeiska AI-fabriker växer, och miljarder har avsatts för AI-fabriker och relaterade strukturer. Dessutom planeras flera AI-gigafabriker. Målet är att ge europeiska företag, forskningsinstitutioner och myndigheter tillgång till högpresterande datorkapacitet. Denna infrastrukturpolitik är nödvändig eftersom moderna modeller inte kan utvecklas eller drivas ekonomiskt utan stora GPU-kluster.
Kolibri-1 visar dock att hårdvara ensam inte räcker. Europa behöver ett komplett industriellt ekosystem av modeller, datacenter, datarum, integratörer, specialiserad programvara, säkerhetstjänster och skickliga användare. Offentliga investeringar i datorkraft är bara effektiva om de leder till säljbara tillämpningar. Annars subventionerar Europa dyr infrastruktur medan de lönsamma programvaru- och plattformsföretagen förblir utanför kontinenten.
Efterfrågan är fundamentalt närvarande. En stor majoritet av tyska företag föredrar AI-lösningar från Tyskland. I den faktiska användningen dominerar dock amerikanska tjänster tydligt. Denna skillnad beror inte på bristande intresse för suveränitet, utan snarare på bekvämlighet, produktmognad, ekosystem och befintliga kontrakt. Företag väljer sällan en modell baserat på dess ursprung. De väljer en lösning om den är snabb att integrera, pålitlig, transparent prissatt och organisatoriskt hanterbar.
Kolibri-1 måste därför erbjuda mer än bara ett löfte av europeiskt ursprung. Det behöver konkurrenskraftiga verktyg, stabila hostingalternativ, bra dokumentation, partnernätverk och mätbara fördelar i tyska affärsprocesser. Apache 2.0-metoden underlättar utvecklingen av ett sådant ekosystem. Programvaruföretag och forskargrupper kan testa modellen, anpassa den och integrera den i sina egna produkter. Detta ökar sannolikheten för att innovation inte kommer att begränsas till en enda leverantör.
Samtidigt finns det en risk att öppna vikter utnyttjas av globala plattformar utan att motsvarande andel av mervärdet finns kvar i Tyskland. Öppenhet ersätter därför inte en sund affärsstrategi. Aleph Alpha och dess partners måste sälja tjänster, säkra verksamhetsmodeller, branschspecifika lösningar och institutionellt förtroende. Modellen fungerar som en teknologisk grund och en inkörsport, inte som den enda intäktskällan.
En realistisk bedömning av Hummingbird-1
Kolibri-1 är varken ett bevis på fullständigt europeiskt AI-oberoende eller en obetydlig nischmodell. Dess betydelse ligger mellan dessa ytterligheter. Tekniskt sett kombinerar den stor total kapacitet med en jämförelsevis låg aktiv beräkningsbelastning, en ovanligt stark tysk utbildningskomponent, mycket långa sammanhang, resonemang och verktygsanrop. Den öppna licensen skapar ett verkligt handlingsutrymme för företag, integratörer och offentliga institutioner.
Ekonomiskt sett är denna modell särskilt attraktiv där känsliga data, tysk fackterminologi och höga användningsvolymer sammanfaller. Stora industriföretag, myndigheter, banker, försäkringsbolag, energileverantörer, forskningsorganisationer och specialiserade programvaruleverantörer är bland de uppenbara målgrupperna. För småföretag utan egen infrastruktur är direkt hosting vanligtvis mindre praktiskt. De kommer mer sannolikt att använda Kolibri-1 via hanterade tjänster, branschspecifika lösningar eller suveräna molnerbjudanden.
Den största fördelen ligger inte i 78 miljarder parametrar, utan i förmågan att kombinera kontroll och anpassningsförmåga med konkurrenskraft. Den största nackdelen är att denna kontroll måste betalas för och hanteras organisatoriskt. Den som driver modellen tar själv ansvar för infrastruktur, säkerhet, utvärdering och uppdateringar. Detta är strategisk frihet, men inte frihet utan kostnad.
Partnerskapet med Cohere och Schwarz Digits skulle kunna omvandla Kolibri-1 till en internationellt marknadsförbar affärsprodukt. Det skulle kunna sammanföra forskning, kapital, försäljning och datorkraft. Samtidigt kräver det en nykter omvärdering av konceptet digital suveränitet. Ett transatlantiskt företag med tysk forskning och europeisk molninfrastruktur skulle kunna vara ett gångbart alternativ till de stora amerikanska plattformarna. Det är dock inte automatiskt ett rent tyskt eller helt europeiskt kontrollerat system.
Den tydliga utsikten är därför följande: Kolibri-1 är en viktig byggsten för en europeisk AI-ekonomi, men det är inte säkert. Dess framgång kommer inte att avgöras av jämförelsetabeller, utan av datacenter, upphandlingsbudgetar och konkreta affärsprocesser. Om den tyska språkfördelen, den öppna licensen och den effektiva expertarkitekturen kan översättas till robusta applikationer kan modellen erövra en kommersiellt betydande marknad. Om hosting, integration och distribution förblir för dyra eller för komplexa, kommer teknisk kvalitet ensam inte att räcka till.
Kolibri-1 illustrerar således både Europas möjligheter och dess problem. Kontinenten kan utveckla kraftfull AI, har krävande industriella kunder och bygger ut sin infrastruktur. Det som ofta saknas är den snabba uppskalningen från forskningsmodell till en allmänt använd standardprodukt. Kolibrin kan verka lätt och bara använda en liten del av sin vingkraft åt gången. Men för att den ska kunna flyga ekonomiskt behöver den en solid grund av kapital, energi, datorkraft, förtroende och distribution.
🎯🎯🎯 Datadriven B2B-branschhubb som en kvasi-intern lösning

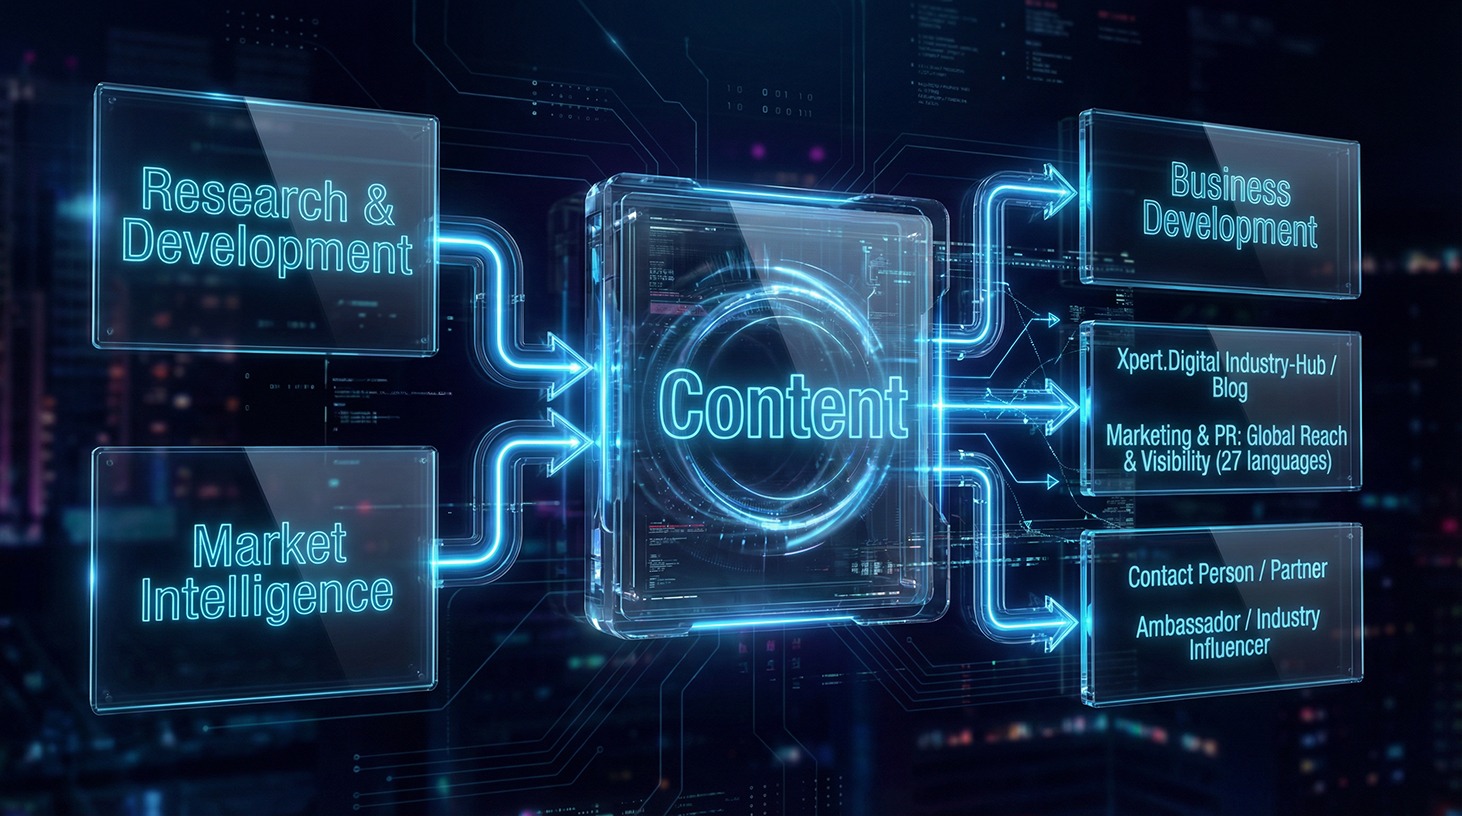
Den kvasi-interna lösningen: Hur Xpert.Digital stänger operativa luckor inom B2B-marknadsföring och -försäljning – Smart Content-Driven Business - Bild: Xpert.Digital
Xpert.Digital är en datadriven B2B-branschhubb som leds av Konrad Wolfenstein . Företaget fungerar som en extern, nästan intern lösning för industriella partners och täcker operativa luckor inom marknadsföring, innehåll och försäljning – utan att kräva ytterligare resurser från kundsidan.
Mer information här:
Din globala partner för marknadsföring och affärsutveckling
☑️ Vårt affärsspråk är engelska eller tyska
☑️ NYTT: Korrespondens på ditt modersmål!

Konrad Wolfenstein
Jag och mitt team står gärna till er förfogande som er personliga rådgivare.
Du kan kontakta mig genom att fylla i kontaktformuläret här wolfenstein@xpert.digital:eller helt enkelt ringa mig på +49 7348 4088 965. Min e-postadress är
Jag ser fram emot vårt gemensamma projekt.