Више од четбота: Како семантички слој чини вештачку интелигенцију поузданијом у компанијама – Потцењени фактор успеха за вештачку интелигенцију у предузећима – Креативна слика на тему, са вештачком интелигенцијом: Xpert.Digital
Вештачка интелигенција у пословању: Зашто јасна терминологија одређује економски успех
Када вештачка интелигенција убрзава хаос: Зашто је компанијама потребно заједничко пословно знање
Мање контрадикција, боље одлуке: Шта семантички слој може да учини за компаније
Компаније улажу у вештачку интелигенцију како би убрзале процесе и доносиле боље одлуке. Али сам по себи моћан језички модел не гарантује пословни успех. Ако продаја, финансије и корисничка служба различито тумаче кључне појмове, вештачка интелигенција може да пружи контрадикторне одговоре – и брже шири грешке. Семантички слој има за циљ да реши овај проблем: чини појмове, односе и правила употребљивим и разумљивим у различитим апликацијама. Његова вредност не лежи само у бољим одговорима, већ и у смањеним напорима координације и поновној употреби знања компаније. Међутим, семантички слој може открити организационе двосмислености, али их неће сам по себи решити. Стога је важно како компаније мапирају своју пословну стварност, дефинишу професионалне одговорности и мере стварне користи.
У вези са овим:
Семантички слој за пословну вештачку интелигенцију: Зашто пословна релевантност одређује повраћај инвестиције у вештачку интелигенцију
Без јасних концепата, вештачка интелигенција аутоматизује хаос
Семантички слој омогућава дељење и проверу пословних термина, односа и правила за примене вештачке интелигенције. Његова економска вредност стога не лежи само у бољим одговорима, већ и у изгледима смањења координационих напора, вишекратне употребе пословног знања и контролисанијих одлука. Међутим, кључно ограничење је то што такав семантички слој може открити организациону двосмисленост, али је не може сам решити.
За компаније, ово помера стратешко питање. Више се не ради само о томе који је језички модел најефикаснији или колико брзо се може развити други асистент. Оно што постаје важније је пословна реалност на којој се ови системи заснивају. Ако продаја, финансије и корисничка служба користе исти термин различито, технички моћна вештачка интелигенција може да шири контрадикторне резултате још брже и шире. Економски изазов лежи у трансформисању расутих информација у робусну, трајно употребљиву основу за доношење одлука.
Разлика између употребе и резултата
Усвајање вештачке интелигенције расте, али њена употреба још увек није доказала да има економски утицај. У 2025. години, 19,95 одсто анкетираних компанија у ЕУ са десет или више запослених користило је барем једну технологију вештачке интелигенције; ово представља повећање од 6,47 процентних поена у поређењу са 2024. годином. Постојале су значајне разлике између величина компанија: удео је био 17 одсто за мале компаније, 30,36 одсто за средње компаније и 55,03 одсто за велике компаније. Анкета је обухватила широк спектар технологија вештачке интелигенције, од анализе текста до аутономних машина, али се није посебно фокусирала на употребу генеративне вештачке интелигенције или семантичких слојева.
Другачија слика се појављује из међународног пословног истраживања спроведеног 2026. године. У том истраживању, 80% испитаника је пријавило побољшану личну продуктивност захваљујући вештачкој интелигенцији, док је 37% навело позитиван допринос заради пре камата и пореза (EBIT) њихове компаније. Само око 6% припадало је посебно успешној групи, приписујући најмање 5% своје EBIT-а вештачкој интелигенцији и истовремено пријављујући значајне користи. Истраживање је обухватило 1.719 учесника из 97 земаља и засновано је на самопријављеним подацима; стога се не може директно упоредити са европском пословном статистиком.
Бројке не доказују узрочни ефекат семантичког слоја. Уместо тога, оне илуструју пословни проблем: између поједностављења индивидуалног рада и мерљивог пословног успеха налази се организациони преводилачки напор. Управо на овом споју заједнички слој значења постаје релевантан.
Значај постаје део оперативне инфраструктуре
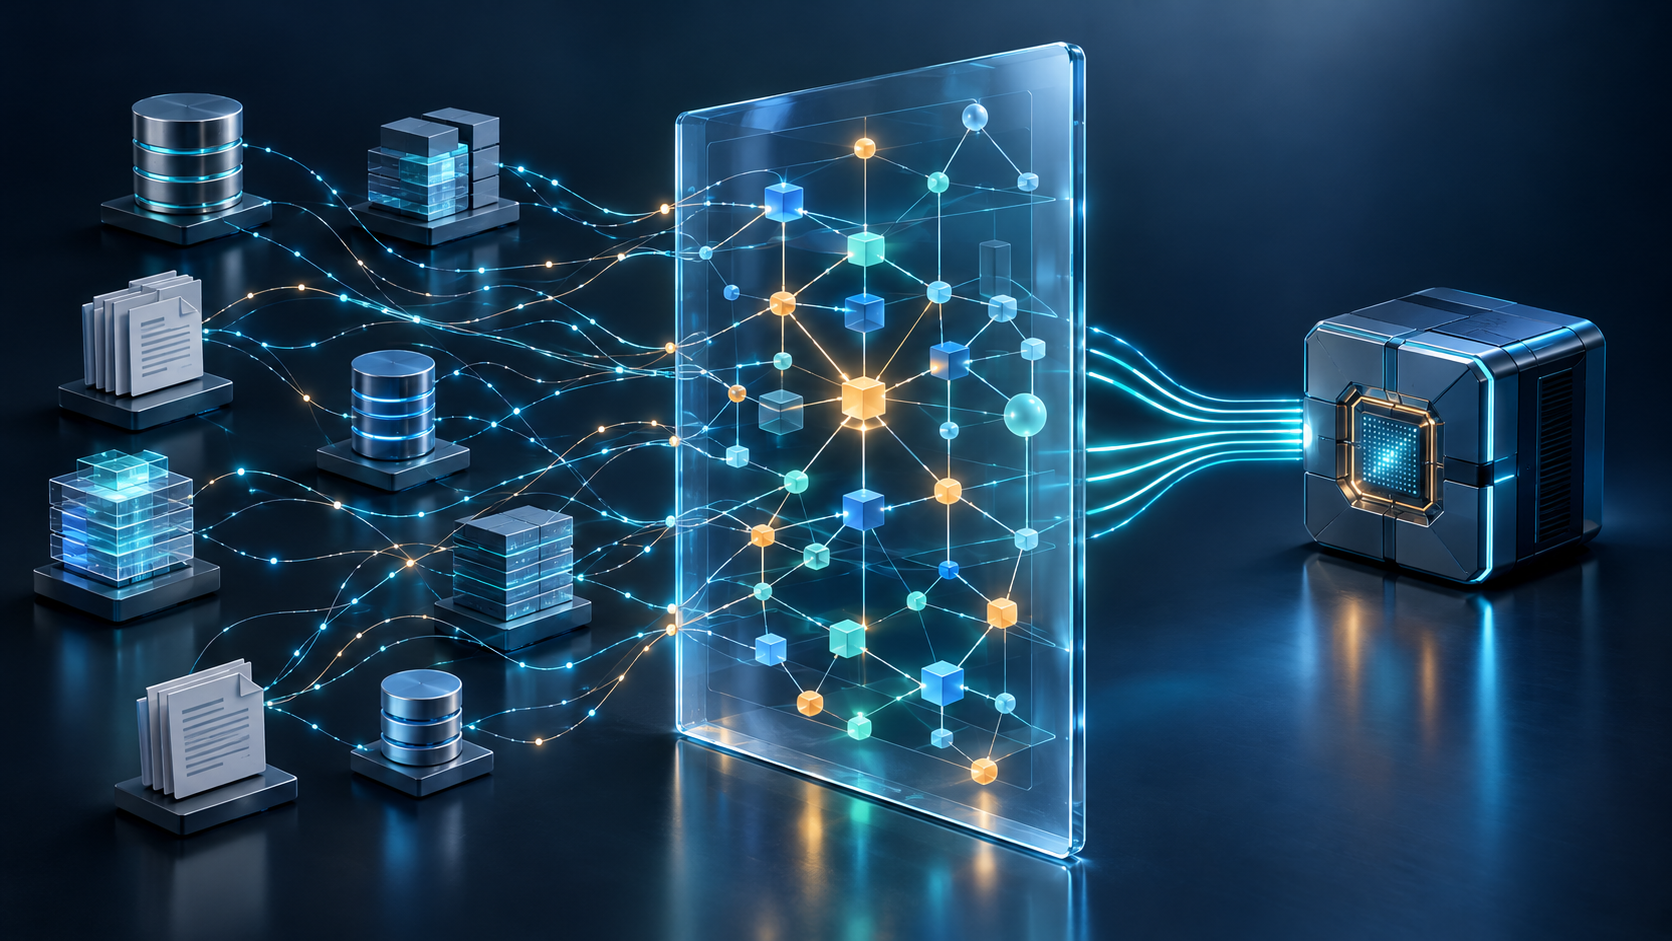
Семантички слој повезује техничке структуре података са пословним концептима као што су купац, уговор, потраживање или приход. Он описује, на пример, која поља података припадају купцу, како се израчунава кључни индикатор учинка (KPI) и под којим условима се примењује одређени статус. Ово омогућава различитим апликацијама да се ослањају на заједничке дефиниције уместо да изводе сопствена тумачења из ознака табела или докумената.
Једноставан пример илуструје импликације. Компанија би могла да дефинише активног купца у продаји на основу текућих разговора, у финансијама на основу забележених пословних трансакција, а у услузи на основу постојећих захтева за услугу. Ниједна од ових перспектива није нужно погрешна. Проблем настаје када вештачка интелигенција ненамерно помеша ове перспективе или представи једну перспективу као универзално валидну.
Економски исправно решење, дакле, не састоји се увек од једне дефиниције за све сврхе. Често је потребно неколико јасно именованих, професионално одговорних дефиниција са недвосмисленим границама примене. Заједнички слој значења треба да одражава разлике на контролисан начин, а не да вештачки ствара униформност коју пословање заправо не поседује. Његов циљ је разумљиво тумачење, а не концептуална хомогенизација.
Од извештаја до оперативне одлуке
Класични семантички модели за пословну интелигенцију првенствено се фокусирају на кључне бројке, димензије, агрегације и односе између објеката података. Међутим, било би превише поједностављења потпуно им ускратити пословну логику или функције ауторизације: успостављени BI системи, на пример, подржавају односе, израчунате кључне бројке и приступ подацима заснован на улогама. Стога, граница између BI семантичког слоја и AI семантичког слоја није јасна технолошка подела.
Главна разлика лежи у захтевима. Извештај, на пример, треба тачно да приказује приход. С друге стране, оперативна апликација вештачке интелигенције такође мора бити у стању да утврди који уговор припада процесу, који посебан споразум има предност и да ли следећи корак захтева одобрење. Ово проширује задатак са доследне анализе на подршку у доношењу одлука зависних од контекста.
Економски гледано, ово повећава и потенцијалне користи и потенцијалну штету. Лоше дефинисан извештај може отворити пут погрешној одлуци. Акционоспособан асистент може је одмах имплементирати. Што се вештачка интелигенција више приближава поруџбинама, плаћањима, обавезама у погледу цена или одлукама купаца, то је кључнија разлика између веродостојног тумачења и обавезујуће логике извршења.
Четири градивна блока пословног знања
Свеобухватни слој значења за пословну вештачку интелигенцију требало би да узме у обзир четири врсте знања: дефиниције ентитета, односе, правила одлучивања и прикупљене корекције. Дефиниције ентитета одређују шта представља пословни објекат, као што је активни купац, критични уговор или случај високог ризика. Односи повезују такве објекте, као што је подружница са налогом или измена уговора са одговарајућим главним уговором.
Правила одлучивања описују прагове, изузетке, одговорности и услове одобравања. Прикупљене исправке бележе где су стручњаци за предметну област исправили погрешне резултате. Само у комбинацији ово се може развити у више од пуке практичне функције претраживања: транспарентну основу за то како се информације могу тумачити и у ком оквиру.
Са економске перспективе, ове врсте знања морају се вредновати другачије. Дефиниција купца може се поново користити у многим апликацијама. С друге стране, одлука о изузетку може се применити само на одређени уговор. Добра архитектура стога не мора само да чува знање већ и да ограничи његов обим. У супротном, она трансформише локални изузетак у опште правило и погоршава управо грешку коју треба да спречи.
Зашто су документи кључни за управљање пословањем
Семантички слој вођен вештачком интелигенцијом мора бити у стању да повеже не само структуриране податке, већ и уговоре, имејлове, извештаје и записнике са састанака са одговарајућим пословним трансакцијама. Разлог је одмах очигледан: Унос у базу података може да садржи договорену стандардну цену, док одобрени додатни уговор предвиђа другачије услове. Свако ко анализира само скуп података може превидети економски обавезујући изузетак.
Најтежи део није само проналажење клаузуле. Већ је у одређивању њеног статуса. Нацрт није потписан споразум. Интерни меморандум са састанка не замењује одобрење. Каснији документ може допунити, делимично заменити или се применити на другачији обим од ранијег правила. Ове разлике морају бити експлицитно моделиране и прегледане за сваки конкретан случај употребе.
Ово води до важне економске перспективе: Вредност анализе докумената не мери се бројем обрађених страница. Она се јавља само када се из ње могу извући поуздане изјаве о потраживањима, обавезама, роковима или начинима деловања. С друге стране, брзи резиме без провере садржаја може проузроковати додатне трошкове ревизије и створити лажни осећај сигурности.
Четири извора трошкова због семантичке двосмислености
Економски утицај се може разумети кроз четири категорије трошкова. Прво, трошкови претраживања настају када запослени морају да прикупе информације и разумеју њихов значај. Друго, трошкови координације настају када одељења објашњавају и усклађују различите анализе. Треће, трошкови грешака настају када погрешне класификације или правила доводе до прераде и погрешних одлука. Четврто, трошкови понављања настају када сваки нови пројекат вештачке интелигенције захтева нови развој истих техничких основа.
Ова класификација је аналитички оквир за процену, а не емпиријски измерена расподела трошкова. Међутим, помаже да се избегне уобичајена заблуда: повраћај инвестиције у семантички слој не би требало да зависи искључиво од брзине одзива асистента. Одговор се може појавити за неколико секунди и даље бити скуп ако неколико стручњака накнадно мора да провери његову тачност.
Насупрот томе, наизглед безначајно побољшање може створити значајну вредност. Ако обавезујућа дефиниција скрати координацију између финансијског одељења и продаје, корист може истовремено утицати на бројне извештаје и одлуке. Стога, релевантна економска јединица није увек појединачни дијалог вештачке интелигенције, већ цео пословни процес, укључујући његове контролне и корекционе петље.
Поновна употреба ствара економију обима
Заједничке дефиниције кључних индикатора учинка (KPI) могу избећи дуплирање напора у имплементацији и учинити исту пословну логику доступном у различитим апликацијама. Примењено на ширу архитектуру вештачке интелигенције, ово је централно обећање скалабилности: већ објављени термини, односи и правила требало би да остану употребљиви за друге случајеве употребе. Ово трансформише семантички слој у потенцијалну инвестицију у инфраструктуру, а не у изоловану компоненту пројекта.
Економска логика је слична логици дељеног ресурса. Његово почетно креирање подразумева трошкове, док додатни корисници могу да користе постојеће компоненте. Међутим, корист се повећава само ако нови случајеви употребе заиста покажу довољно преклапања у стручности. Други асистент у истој области услуге може да користи више постојећег знања него апликација за потпуно другу пословну област.
Стога би било нереално очекивати аутоматско смањење трошкова са сваким наредним вештачком интелигенцијом. Нови правни оквири, породице производа или пословни модели могу захтевати опсежне допуне. Поуздана економија обима не лежи у томе да каснији пројекти постану бесплатни, већ у чињеници да већ разјашњена питања не морају поново да се разјашњавају без објективног оправдања.
Продуктивности је потребна трезна процена
Студија спроведена на 5.172 запослена у корисничкој служби показала је да је приступ генеративном вештачком интелигенцијском асистенту резултирао просечним повећањем од приближно 15 процената у решеним захтевима купаца по сату. Међутим, ефекат је био неравномерно распоређен: мање искусни и мање квалификовани запослени су имали више користи, док су високо искусни и висококвалификовани запослени видели само незнатно повећање брзине, а у неким случајевима и благо смањење квалитета. Студија стога показује конкретан ефекат продуктивности унутар одређеног радног окружења, а не изоловани повраћај инвестиције семантичког слоја.
Ова разлика је кључна за економску процену. Успешна имплементација вештачке интелигенције не открива који део успеха се може приписати језичком моделу, корисничком интерфејсу, расположивом знању, обуци или измењеним радним процесима. Свако ко из ових података извлачи општа обећања о повраћају инвестиције за једну архитектонску компоненту превазилази њихову објашњавајућу моћ.
Штавише, ослобођено радно време не значи аутоматски одговарајуће смањење трошкова. Економске користи настају, на пример, када компанија управља додатном потражњом, смањује време чекања, избегава прековремени рад или ангажује оскудне квалификоване раднике за захтевније задатке. Без таквих промена, мерљива уштеда времена може остати углавном неискоришћена са пословне тачке гледишта.
Обрачун поврата који укључује све трошкове
Одржив пословни случај треба прво да анализира тренутни процес. То укључује број предмета, време обраде, упите, исправке, ескалације и последице погрешних одлука. Затим, потребно је утврдити који од ових фактора могу бити под утицајем заједничког слоја значења. Тек тада се могу водити смислене дискусије о обиму инвестиције и очекиваним користима.
Са стране трошкова, поред коришћења софтвера и модела, требало би размотрити и системску интеграцију, пословно моделирање, верификацију идентитета, управљање приступом, тестирање и континуирана ажурирања. Укључивање искусних стручњака, посебно, није бесплатан додатни трошак. Њихово време има економску вредност и није доступно за друге задатке током имплементације.
Трезвена процена такође узима у обзир почетне губитке и неизвесност. У почетку, нова апликација може захтевати додатне провере пре него што се рутине стабилизују. Неке користи постају очигледне тек са даљим случајевима употребе, док се друге не материјализују. Стога је фазни инвестициони приступ са проверљивим међуциљевима често вероватнији од велике почетне инвестиције чије оправдање почива првенствено на обећањима будућих синергија.
Права мера успеха
Најважнија метрика успеха су економски трошкови по исправно и у складу са прописима завршеној пословној трансакцији. Ова перспектива комбинује брзину, квалитет и контролу. Спречава да се висока стопа коришћења или кратко време одзива сматрају успехом ако апликација генерише додатне прераде.
Различите врсте грешака треба разликовати у сврху мерења. Нетачна метрика се разликује од превиђеног уговорног изузетка. Непотпуно обавештење се разликује од неовлашћеног откривања података. Исто тако, мора остати јасно да ли систем поуздано одговара на питање, легитимно га прослеђује човеку или даје резултат без довољног основа.
Смислено поређење користи претходно одобрене случајеве и разматра цео процес. За одговарајуће процесе, фазне имплементације или контролисане групе за поређење могу помоћи у разликовању техничких побољшања од општих промена. Преглед би требало да укључи и ретке, али економски значајне изузетке. Систем који добро обрађује рутинске случајеве, али превиђа критичне изузетке, може бити убедљив у просеку, али ипак бити неприхватљив у пракси.
Векторска претрага не замењује обавезујућу обавезу
Векторске базе података подржавају претрагу сличних текстова повезаних са садржајем тако што омогућавају упоређивање информација путем нумеричких репрезентација које се називају уграђивања. Модерни системи могу додатно користити филтере метаподатака, претраге кључних речи и комбиноване методе претраге. Стога би било нетачно представити их као фундаментално контекстно-слободна спремишта без могућности филтрирања.
Међутим, његова основна функција одговара на другачије питање од питања оперативног управљања. Суштинска сличност не указује аутоматски на то да ли је документ актуелан, правно обавезујући или применљив на одређени случај. Систем претраге може узети у обзир таква својства ако су поуздано сачувана и правилно интегрисана у упит. Међутим, он сам по себи не одређује неопходне пословне одлуке.
Ово доводи до јасне инвестиционе логике за компаније. Побољшана претрага и проширени слојеви значења могу се међусобно допуњавати. Међутим, додатни резултати претраге нису замена за јасно дефинисане одговорности и правила. Они који покушавају да поправе сваки погрешан одговор искључиво снажнијим индексом претраге ризикују да пруже више материјала без разјашњења његове предметне валидности.
🤖🚀 Управљана AI платформа: Брже, безбедније и паметније AI решењима уз UNFRAME.AI

Управљана AI платформа - Слика: Xpert.Digital
Овде ћете сазнати како ваша компанија може брзо, безбедно и без високих баријера за улазак имплементирати прилагођена решења за вештачку интелигенцију.
Управљана AI платформа је ваше свеобухватно и безбрижно решење за вештачку интелигенцију. Уместо да се бавите сложеном технологијом, скупом инфраструктуром и дуготрајним процесима развоја, добијате готово решење прилагођено вашим потребама од специјализованог партнера – често у року од само неколико дана.
Кључне предности на први поглед:
⚡ Брза имплементација: Од идеје до апликације спремне за употребу за дане, а не месеци. Нудимо практична решења која стварају тренутну додату вредност.
🔒 Максимална безбедност података: Ваши осетљиви подаци остају код вас. Гарантујемо безбедну и усклађену обраду без дељења података са трећим лицима.
💸 Без финансијског ризика: Плаћате само за резултате. Велика почетна улагања у хардвер, софтвер или особље су потпуно елиминисана.
🎯 Фокусирајте се на свој основни посао: Концентришите се на оно што најбоље радите. Ми се бринемо о целокупној техничкој имплементацији, раду и одржавању вашег вештачке интелигенције.
📈 Спремно за будућност и скалабилно: Ваша вештачка интелигенција расте са вама. Обезбеђујемо континуирану оптимизацију и скалабилност и флексибилно прилагођавамо моделе новим захтевима.
Више информација овде:
Утицај докумената на пословне одлуке
Графови знања могу да ураде више од само линкова
Граф знања представља ентитете и њихове односе у умреженој структури и стога може бити важан део семантичког слоја. Истовремено, формалне онтологије и методе изграђене на њима такође могу подржати логичке закључке; успостављени стандарди попут OWL-а нису ограничени на једноставно чување основних веза. Општа тврдња да граф знања у принципу не може да представља правила стога би била технички нетачна.
Кључно питање је, уместо тога, које могућности одређено решење заправо комбинује. Граф који садржи пословне објекте не поседује аутоматски свеобухватно управљање правима, тестирану контролу процеса или професионално одобрено руковање посебним случајевима. Насупрот томе, одговарајуће дизајнирана архитектура графа може испунити значајне делове ових захтева.
Семантички слој стога треба схватити мање као нужно самостални производ, а више као скуп потребних функција. Неке компаније могу покрити велике делове овога постојећим BI моделима, каталозима података, графичким системима и скуповима правила. Другима је потребна додатна платформа. Оно што је економски релевантно јесте доказани функционални јаз, а не број новоуведених категорија производа.
Повежите се уместо да поново све чувате
Семантички слој може повезати постојеће ERP и CRM системе, платформе података и складишта докумената без претходног премештања свих података компаније на једну нову локацију за складиштење. Семантички модели за кључне индикаторе учинка (KPI) такође могу да се надовезују на постојеће структуре података и из њих изводе одговарајућу логику упита. Заједничко значење је стога фундаментално различито од физичког складиштења података.
Међутим, то не значи да таква архитектура може да функционише без икаквог копирања података. Индекси претраге, издвојене информације о документима, кеш меморије или унапред израчунати резултати могу бити корисни за специфичне случајеве употребе. Релевантно пословно питање је које информације треба чувати, где и колико дуго, а не да ли се обећање потпуне заштите од копирања може продати.
Добро осмишљен систем уравнотежује благовременост, време одзива, доступност, трошкове и приватност података. Различити захтеви за благовременост могу се применити на статус залиха него на уговорну клаузулу. Упит дистрибуиран преко многих изворних система може бити флексибилан, али такође повећава зависност од њихове доступности. Стога, најбоље решење није нужно максимално централизовано или максимално дистрибуирано, већ је прикладно пословном процесу.
Квалитет података остаје посебан задатак
Заједнички слој значења не значи аутоматски да погрешни изворни подаци буду исправни. Чак и добављачи система семантичких упита препоручују решавање основних задатака конзистентности, као што су нормализација уобичајених објеката и чишћење неодговарајућих података, што је раније могуће. Пословна семантика и квалитет података су комплементарни; они нису заменљиви задаци.
Посебно илустративан пример је идентитет пословног партнера. Различити начини писања могу се односити на истог добављача. Међутим, слична имена могу припадати и различитим правним ентитетима. Брзоплето спајање ових имена може довести до погрешног додељивања информација о плаћању, података о кредитној способности или уговорних односа. Добра архитектура стога мора бити у стању да открије које су доделе потврђене, а где постоји само вероватна претпоставка.
Ово је економски важно јер грешке нису увек видљиве тамо где се појаве. Нетачно подударање идентитета може касније утицати на вишеструке анализе и одлуке. Стога, имплементација треба да се фокусира не само на квалитет појединачних одговора, већ и на поуздано додељивање основних објеката. У супротном, поновна употреба не само да умножава знање већ и његове грешке.
Правила морају постати технички ефикасна
Политика у документу не представља принудну контролу. За вештачку интелигенцију, безбедносни концепти експлицитно разликују језичке захтеве и техничке мере као што су ограничене функције, ограничене дозволе и проверљиви услови извршавања. Прекомерна аутономија и преширока права приступа, посебно, могу довести до неисправних или манипулисаних излаза модела што покреће штетне радње.
Робусна архитектура би стога требало да раздвоји интерпретацију и извршење. Језички модел може, на пример, класификовати процес или предложити акцију. Да ли је износ исправно израчунат, да ли је одобрење дато или да ли се резервација може извршити, у критичним процесима, требало би додатно да буде обезбеђено проверљивом логиком и одговорним системима.
Ово разјашњава уобичајену заблуду. Семантички слој може да обезбеди пословну основу за понашање у складу са правилима. Међутим, он сам по себи не гарантује да ће пробабилистички језички модел поуздано применити свако правило. Економски исплативо решење произилази из међусобног деловања значења, дозвола, тестова, контрола процеса и јасно дефинисаних токова деловања.
Дозволе су део значења
Приликом приступања знању компаније, мора се проверити не само релевантност већ и овлашћење за приступ. Контроле везане за документе могу ограничити резултате претраге на основу идентитета корисника и додељених права; њихова ефикасност зависи, између осталог, од исправно синхронизованих информација о овлашћењу. Дељена база знања стога не значи да је сваком кориснику дозвољено да види исти садржај.
У пракси, временска димензија је кључна. Запослени може променити улогу, пројекат може бити завршен или документ може бити накнадно ограничен. Ако слој претраге и контекста користи застареле дозволе, може открити садржај који више није доступан у изворном систему. Стога, одржавање дозвола мора бити експлицитно укључено у оперативне трошкове.
Чак и питања са сличним садржајем могу, са добрим разлогом, добити различите одговоре. Два корисника могу припадати различитим областима одговорности или имати приступ различитим скуповима података. Конзистентност, дакле, не значи идентичне формулације, већ иста професионална правила у упоредивом контексту. Одступање представља проблем квалитета само ако се не може објаснити временом, улогом, доступношћу података или самим питањем.
Исправке захтевају структуриран процес
Бележење корисничких корекција једна је од предвиђених компоненти знања семантичког слоја оријентисаног на вештачку интелигенцију. У управљању ризицима везаним за вештачку интелигенцију, истраживање људских преусмеравања и њихових узрока такође се сматра вредним извором информација за процену имплементираних система. Међутим, то не значи да свака корисничка промена треба аутоматски да постане опште правило.
Исправљени резултат може имати веома различите узроке. Можда је запис података погрешно додељен. Можда је примењен уговорни изузетак. Можда је претходно правило компаније било застарело. Или је можда корисник једноставно унео личну преференцију. Ови случајеви захтевају различите одговоре и не би требало да се без разлике укључују у заједничку базу знања.
Економски исправан процес учења у почетку третира повратне информације као проверљиве сугестије. Стручњаци за предметну област одлучују о њеном обиму, обавезујућој природи и потребним тестовима. Тек тада се одобрена промена ставља на располагање за даље примене. Ово не захтева нужно поновну обуку језичког модела. Кључна ствар је да се грешка избегне у одговарајућем контексту у будућности, без ненамерног увођења нових грешака негде другде.
Верзирање штити од лажних ретроспективних приказа
Пословне дефиниције и правила се мењају; стога би семантички слој требало да верзионише измене и додели их стручњацима за предметну област на одобрење. Постојеће семантичке платформе већ подржавају верзиоване дефиниције или валидиране референтне упите, укључујући информације о томе када и од кога су потврђене. Историја која се може пратити стога није декоративни додатак, већ саставни део контролисане употребе.
Међутим, за каснији преглед, тренутно важеће правило није довољно. Такође је релевантно која је верзија била на снази у време трансакције и које информације је систем заправо могао да обради у том тренутку. Накнадно примљена измена уговора не сме ненамерно постати основа за процену раније одлуке. У супротном, ретроспективно се јавља привид јасноће, који није постојао у време доношења одлуке.
Компаније би стога требало заједно да разматрају историју правила, верзије докумената и статусе података. Исплативост се овде мање односи на уштеду секунди, а више на смањење трошкова решавања спорова. Они који могу да реконструишу основу одлуке троше мање времена склапајући је из имејлова, појединачних датотека и накнадних подсетника.
Слобода модела још увек није слобода добављача
Пословно знање треба да буде организовано на такав начин да промена језичког модела не захтева аутоматски потпуно преписивање пословних основа. Стратешки аргумент за ово поткрепљен је техничком динамиком: између новембра 2022. и октобра 2024. године, трошкови упита модела смањени су за више од 280 пута на нивоу перформанси упоредивом са GPT-3.5. Ово поређење се односи на одређени референтни ниво и не треба га тумачити као одговарајуће смањење укупних трошкова пословне апликације.
Ипак, закључак је вероватан: Када се перформансе модела и цене значајно промене, опција преласка постаје све вреднија. Трајно употребљив технички модел може спречити да свака технолошка надоградња покрене свеобухватни напор техничког превођења. Независност модела тако добија карактер стратешке опције.
Међутим, то не елиминише све зависности. Дефиниције могу и даље бити везане за власничке формате платформи, интерфејсе или оперативне моделе. Стога, компанија треба посебно да процени да ли може да промени језичке моделе, извезе своје дефиниције знања и настави да користи целокупно решење са другим добављачем. Само ова разлика омогућава реалну процену трошкова преласка и преговарачке полуге.
Тржиште расте заједно
Семантичке дефиниције су сада експлицитно понуђене и за пословну интелигенцију (BI) и за вештачку интелигенцију (AI): Snowflake повезује пословне метрике и односе ентитета са упитима и агентима, док dbt такође пружа своје централно дефинисане метрике путем интерфејса за AI алате. Паралелно са тим, Open Semantic Interchange се појавила као иницијатива за размену семантичких метаподатака неутралну од стране добављача. Пројекат је прихваћен у Apache Incubator 2026. године под називом Apache Ossie.
Овај развој је економски значајнији од још једне најаве производа. Ако више алата може да користи исте дефиниције, потреба за креирањем нове пословне логике у свакој апликацији је фундаментално смањена. Истовремено, успостављене платформе података могу преузети већи део стварања вредности који је раније био резервисан за специјализована додатна решења.
За купце, то значи: Пре него што се изврши нова куповина, треба направити инвентар. Постојећи модели података, каталози кључних индикатора учинка (KPI), системи ауторизације и интерфејси могу покрити неке од захтева. Отворени формати размене су корисни у том погледу, али нису потпуни доказ ефикасности. Морају се проценити на основу тога које дефиниције, правила и контекстуалне информације се могу преносити између система који су заправо у употреби без губитка значења.
Unframe-ова тканина знања, објективно посматрана
Unframe обједињује своје семантичке функције под називом Knowledge Fabric, повезујући пословне концепте, пословну логику, односе и дозволе. Циљ овог приступа је да структуриране скупове података и садржај докумената учини употребљивим за специфичне случајеве употребе и да постепено прошири базу знања. Решење се такође нуди са различитим језичким моделима и интеграцијом у постојеће пословне системе.
Економска привлачност овог концепта лежи у комбинацији претходно одвојених задатака. Ако системска интеграција, пословни контекст и контролисана употреба добро функционишу заједно, напор потребан за додатне апликације може се смањити. Међутим, да ли се ова предност материјализује у одређеној компанији не може се закључити само из архитектонског назива. Потребни су проверљиви резултати из сопствених процеса компаније.
Истовремено, питање власништва и рада остаје релевантно: Unframe прави разлику између података, резултата и конфигурација решења у власништву купаца, с једне стране, и Knowledge Fabric-а којим управља добављач и других компоненти платформе, с друге стране. Стога, слобода избора у вези са моделом не би требало да се изједначава са потпуном независношћу од платформе. За поуздану процену, опције извоза, права на техничке дефиниције и континуитет система у случају промене оператера треба експлицитно разјаснити.
Почните мало, останите прилагодљиви
Приступ оријентисан на апликације ограничава обим моделирања и омогућава преглед дефиниција са релевантним стручњацима за предметну област користећи задатке из стварног света. Уместо да се одмах мапира цела компанија, прво се бележе неопходни системи, објекти, односи и правила јасно дефинисаног процеса. Одобрене компоненте се затим могу проширити тако да укључују повезане случајеве употребе.
Са економске перспективе, процес са честим понављањима, проверљивим резултатима и довољно значајним проблемима координације је посебно погодан. Превише једноставан случај употребе може само показати да се прозор за ћаскање може повезати са извором података. Насупрот томе, превише сложен увод може створити толико нерешених посебних случајева да предности постају очигледне тек након дужег времена.
Права равнотежа лежи између ограниченог обима и темеља за вишекратну употребу. Пилот пројекат не би требало да буде прототип за једнократну употребу. Истовремено, његов потенцијал за интеграцију не би требало да постане изговор за изградњу свеобухватног пословног модела пре првог мерљивог побољшања. Референтна тачка остаје који су технички градивни блокови заправо потребни за следећи значајан корак.
Професионална одговорност одређује прихватање
Увођење вештачке интелигенције не пребацује одговорност са људи на софтвер. Свака централна дефиниција захтева надлежни орган који може да процени и одобри промене. Чак и свеобухватни оквири за поуздану вештачку интелигенцију наглашавају јасно дефинисане људске улоге и одговорности у раду са системима вештачке интелигенције. Стога, техничке операције и стручна овлашћења не би требало прећутно доделити истој улози.
Ово може бити организационо незгодно. Заједничка дефиниција прихода, припадности купцима или ризика може утицати на циљне системе, одговорности и постојеће праксе евалуације. Семантички слој открива такве разлике. Он их не решава техничком елеганцијом, већ захтева одлуке које су можда раније биле избегнуте.
Ту лежи и његова дугорочна вредност. Када концепти и правила више нису ограничени само на умове појединачних запослених или расути по различитим апликацијама, компанија може постати мање зависна од неформалних монопола знања. Међутим, ова предност претпоставља да су стручњаци укључени у процес дизајнирања и да слој значења доживљавају као подршку. Ако се уведе само као инструмент контроле, спремност за допринос вредним искуственим знањем може се смањити.
Није свакој компанији потребна иста дубина
Подаци о коришћењу у Европи откривају значајне разлике у обиму примене вештачке интелигенције, без нужног указивања на потребу за специфичном архитектуром. Штавише, међу компанијама које су разматрале коришћење вештачке интелигенције, али то још нису чиниле 2025. године, 70,89% је навело недостатак релевантне стручности као разлог зашто је не користе; 52,52% је указало на нејасне правне последице, а 48,83% на забринутост у вези са приватношћу података. Ове бројке се односе посебно на ову подгрупу, а не на све компаније.
Ово омогућава развој диференциране инвестиционе перспективе. Мала компанија са мало система и управљивим процесима може у почетку захтевати конзистентне кључне индикаторе учинка (KPI) и јасно одржаване базе знања. Корпорација са бројним подружницама, производним линијама и улогама приступа, с друге стране, може имати користи од свеобухватније семантичке инфраструктуре. Одговарајући ниво детаља зависи од сложености и ризика, а не од атрактивности одређеног технолошког термина.
Изостављање одређених задатака може бити и економски исплативо. Ако се задатак ретко дешава, нема веће последице и може се поуздано обавити једноставним поступком, трошкови одржавања додатног слоја могу надмашити његове користи. Убедљив архитектонски приступ стога мора бити у стању да објасни и где није потребан.
Контролисани значај као конкурентска предност
Генеративна вештачка интелигенција може убедљиво представити неисправан садржај; овај ризик је међу експлицитно описаним карактеристикама и опасностима таквих система. Чак ни додатне методе за претраживање и проналажење информација о компанији не елиминишу све безбедносне ризике, попут оних које представљају манипулисане инструкције у обрађеном садржају. Стога, семантички слој није гаранција истинитости, безбедности или исплативости.
Његов оправдани стратешки значај лежи негде другде. Може подржати прелазак са распршеног искуственог знања на експлицитне, поново употребљиве и одговорне пословне дефиниције. Ово омогућава не само спорадично примењивање вештачке интелигенције, већ и њено постепено уграђивање у контролисани оперативни систем. Трајна предност тада није појединачни асистент, већ организована способност поузданог искоришћавања знања компаније за нове задатке.
Одлучујућа конкурентска предност, дакле, не произилази из поседовања највећег броја аутономних агената. Она настаје тамо где компаније могу брже да препознају које су информације валидне, који изузеци су релевантни и које акције остају оправдане. Они који савладају ову основу могу ефикасније да користе променљиве моделе и алате. Они који је занемарују ризикују првенствено повећање брзине сопствених неспоразума са сваком новом применом вештачке интелигенције.
Консалтинг - Планирање - Имплементација

Konrad Wolfenstein
Било би ми драго да вам будем лични саветник.
Можете ме контактирати на wolfenstein∂xpert.digital или
Само ме позовите на +49 7348 4088 965 .