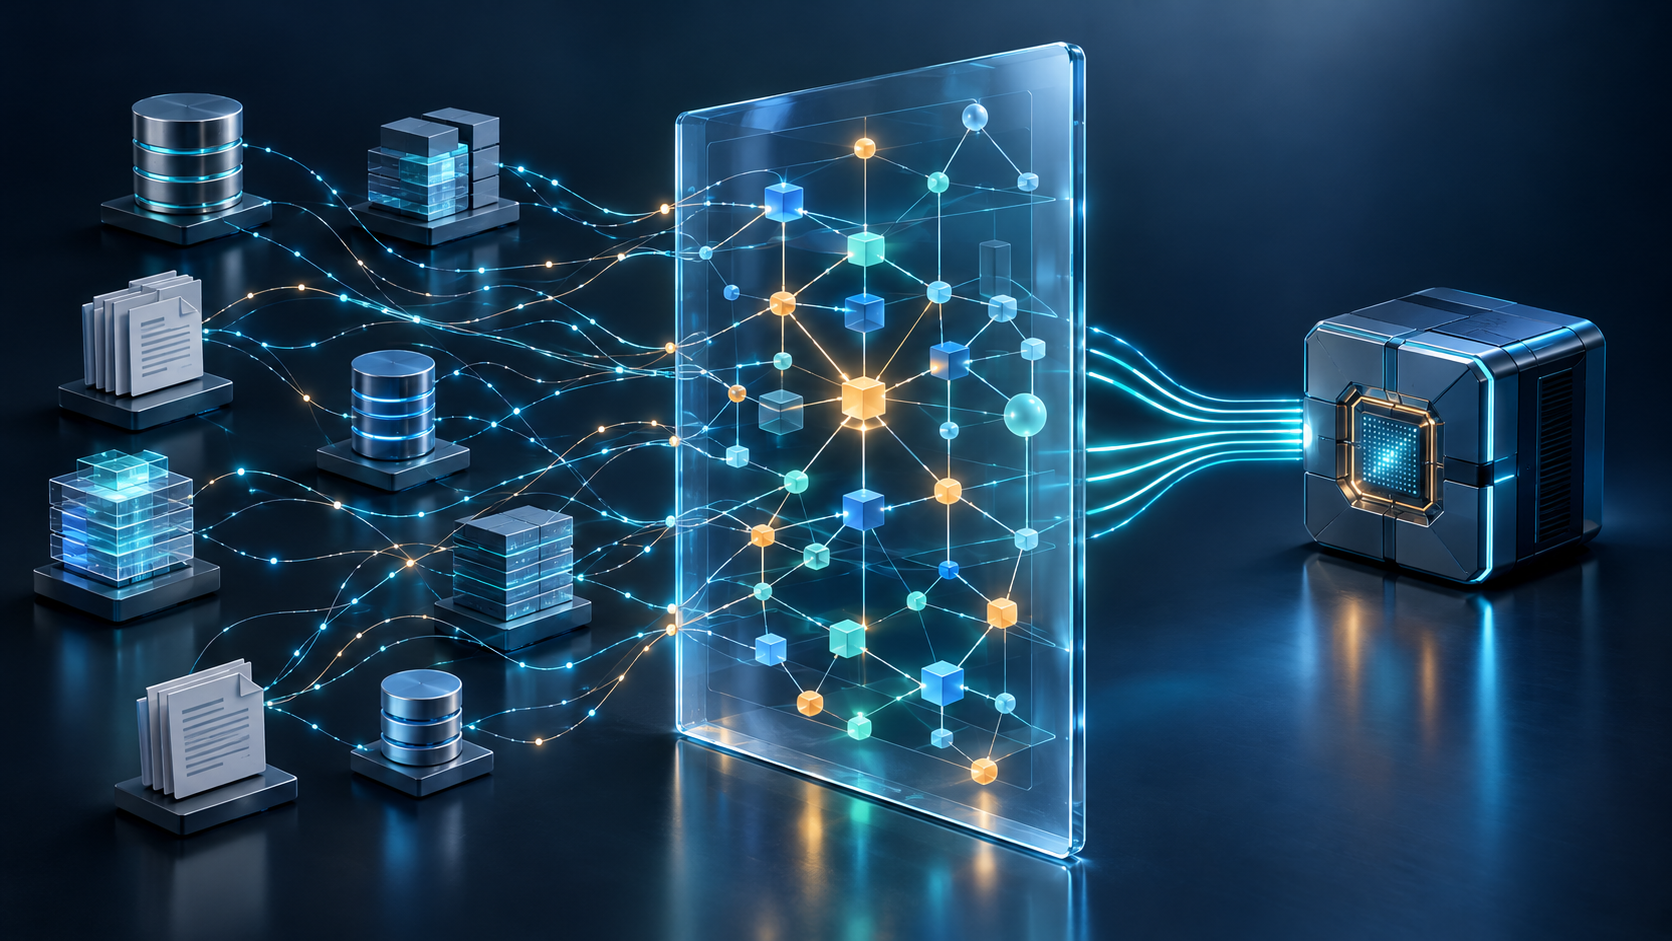
Mehr als ein Chatbot: Wie eine Semantic Layer KI im Unternehmen verlässlicher macht – Der unterschätzte Erfolgsfaktor für Enterprise AI – Kreativbild zum Thema, mit KI: Xpert.Digital
KI im Unternehmen: Warum klare Begriffe über den wirtschaftlichen Erfolg entscheiden
Wenn KI das Chaos beschleunigt: Warum Unternehmen gemeinsames Geschäftswissen brauchen
Weniger Widersprüche, bessere Entscheidungen: Was eine Semantic Layer für Unternehmen leisten kann
Unternehmen investieren in künstliche Intelligenz, um Abläufe zu beschleunigen und bessere Entscheidungen zu treffen. Doch ein leistungsfähiges Sprachmodell allein garantiert keinen wirtschaftlichen Erfolg. Wenn Vertrieb, Finanzabteilung und Kundenservice zentrale Begriffe unterschiedlich auslegen, kann KI widersprüchliche Antworten liefern – und Fehler schneller verbreiten. Eine Semantic Layer soll hier ansetzen: Sie macht Begriffe, Beziehungen und Regeln für verschiedene Anwendungen gemeinsam nutzbar und nachvollziehbar. Ihr Wert liegt nicht nur in besseren Antworten, sondern auch in weniger Abstimmungsaufwand und wiederverwendbarem Unternehmenswissen. Allerdings kann eine Bedeutungsschicht organisatorische Unklarheiten sichtbar machen, sie aber nicht von selbst beseitigen. Entscheidend ist daher, wie Unternehmen ihre Geschäftswirklichkeit abbilden, fachliche Verantwortung regeln und den tatsächlichen Nutzen messen.
Passend dazu:
Semantic Layer für Enterprise AI: Warum Geschäftsbedeutung über die KI-Rendite entscheidet
Ohne klare Begriffe automatisiert KI das Chaos
Eine Semantic Layer macht geschäftliche Begriffe, Beziehungen und Regeln für KI-Anwendungen gemeinsam nutzbar und überprüfbar. Ihr wirtschaftlicher Wert liegt deshalb nicht allein in besseren Antworten, sondern in der Aussicht auf weniger Abstimmungsaufwand, wiederverwendbares Unternehmenswissen und kontrollierbarere Entscheidungen. Die entscheidende Einschränkung lautet jedoch: Eine solche Bedeutungsschicht kann organisatorische Unklarheit sichtbar machen, aber nicht eigenständig beseitigen.
Für Unternehmen verschiebt sich damit die strategische Frage. Es geht nicht mehr ausschließlich darum, welches Sprachmodell am leistungsfähigsten ist oder wie schnell sich ein weiterer Assistent entwickeln lässt. Wichtiger wird, welche Geschäftswirklichkeit diese Systeme zugrunde legen. Wenn Vertrieb, Finanzabteilung und Kundenservice denselben Begriff unterschiedlich verwenden, kann eine technisch leistungsfähige KI widersprüchliche Ergebnisse sogar schneller und in größerem Umfang verbreiten. Die ökonomische Herausforderung besteht darin, aus verstreuten Informationen ein belastbares, dauerhaft nutzbares Entscheidungsfundament zu machen.
Die Lücke zwischen Nutzung und Ergebnis
Die Verbreitung von KI wächst, doch ihre Nutzung ist noch kein Nachweis wirtschaftlicher Wirkung. 2025 verwendeten 19,95 Prozent der erfassten EU-Unternehmen ab zehn Beschäftigten mindestens eine KI-Technologie; gegenüber 2024 entsprach das einem Anstieg um 6,47 Prozentpunkte. Zwischen den Größenklassen bestanden erhebliche Unterschiede: Der Anteil betrug bei kleinen Unternehmen 17 Prozent, bei mittleren 30,36 Prozent und bei großen 55,03 Prozent. Erfasst wurde dabei ein breites Spektrum von Textanalyse bis zu autonomen Maschinen, nicht speziell der Einsatz generativer KI oder semantischer Bedeutungsschichten.
Ein anderes Bild liefert eine internationale Unternehmensbefragung von 2026. Dort berichteten 80 Prozent der Befragten von einer verbesserten persönlichen Produktivität durch KI, während 37 Prozent einen positiven Beitrag zum Ergebnis vor Zinsen und Steuern ihres Unternehmens angaben. Nur ungefähr 6 Prozent gehörten zu einer besonders erfolgreichen Gruppe, die KI mindestens 5 Prozent ihres EBIT zuschrieb und zugleich einen erheblichen Nutzen meldete. Die Befragung umfasste 1.719 Teilnehmende aus 97 Ländern und beruhte auf Selbstauskünften; sie ist daher nicht unmittelbar mit der europäischen Unternehmensstatistik vergleichbar.
Die Zahlen beweisen keine ursächliche Wirkung einer Semantic Layer. Sie veranschaulichen vielmehr das betriebswirtschaftliche Problem: Zwischen individueller Arbeitserleichterung und messbarem Unternehmenserfolg liegt eine organisatorische Übersetzungsleistung. Genau an dieser Schnittstelle ist eine gemeinsame Bedeutungsschicht interessant.
Bedeutung wird zur betrieblichen Infrastruktur
Eine Semantic Layer verbindet technische Datenstrukturen mit fachlichen Konzepten wie Kunde, Vertrag, Schadenfall oder Umsatz. Sie beschreibt beispielsweise, welche Datenfelder zu einem Kunden gehören, wie eine Kennzahl berechnet wird und unter welchen Bedingungen ein bestimmter Status gilt. Dadurch können verschiedene Anwendungen auf gemeinsam festgelegte Definitionen zurückgreifen, statt ihre eigene Interpretation aus Tabellenbezeichnungen oder Dokumenten abzuleiten.
Ein einfaches Beispiel verdeutlicht die Tragweite. Ein Unternehmen könnte einen aktiven Kunden im Vertrieb über laufende Gespräche definieren, im Finanzbereich über gebuchte Geschäftsvorfälle und im Service über bestehende Leistungsansprüche. Keine dieser Sichtweisen muss falsch sein. Problematisch wird es, wenn eine KI sie unbemerkt vermischt oder eine Perspektive als allgemeingültig ausgibt.
Die wirtschaftlich sinnvolle Lösung besteht deshalb nicht immer in einer einzigen Definition für alle Zwecke. Häufig braucht es mehrere sauber benannte, fachlich verantwortete Definitionen mit eindeutigen Anwendungsgrenzen. Eine gemeinsame Bedeutungsschicht sollte Unterschiede kontrolliert abbilden, nicht künstlich eine Einheitlichkeit herstellen, die das Geschäft tatsächlich nicht besitzt. Ihr Ziel ist nachvollziehbare Interpretation, nicht begriffliche Gleichmacherei.
Vom Bericht zur operativen Entscheidung
Klassische semantische Modelle für Business Intelligence konzentrieren sich vor allem auf Kennzahlen, Dimensionen, Aggregationen und die Beziehungen zwischen Datenobjekten. Allerdings wäre es verkürzt, ihnen grundsätzlich Geschäftslogik oder Berechtigungsfunktionen abzusprechen: Etablierte BI-Systeme unterstützen beispielsweise Beziehungen, berechnete Kennzahlen und rollenabhängige Datenzugriffe. Die Grenze zwischen einer BI-Semantic-Layer und einer KI-Semantic-Layer ist deshalb kein sauberer technologischer Schnitt.
Der Unterschied liegt vor allem im Anspruch. Ein Bericht soll beispielsweise einen korrekt abgegrenzten Umsatz darstellen. Eine operative KI-Anwendung muss zusätzlich herausfinden können, welcher Vertrag zu einem Vorgang gehört, welche Sondervereinbarung Vorrang hat und ob der nächste Schritt einer Freigabe bedarf. Damit erweitert sich die Aufgabe von konsistenter Analyse zu kontextabhängiger Entscheidungsunterstützung.
Ökonomisch steigt dadurch sowohl der mögliche Nutzen als auch das Schadenspotenzial. Ein falsch abgegrenzter Bericht kann eine Fehlentscheidung vorbereiten. Ein handlungsfähiger Assistent kann sie unmittelbar umsetzen. Je näher KI an Bestellungen, Zahlungen, Preiszusagen oder Kundenentscheidungen heranrückt, desto wichtiger wird die Trennung zwischen plausibler Interpretation und verbindlicher Ausführungslogik.
Die vier Bausteine des Geschäftswissens
Eine umfassende Bedeutungsschicht für Unternehmens-KI sollte vier Wissensarten berücksichtigen: Entitätsdefinitionen, Beziehungen, Entscheidungsregeln und gesammelte Korrekturen. Entitätsdefinitionen legen fest, was ein fachliches Objekt ausmacht, beispielsweise ein aktiver Kunde, ein wesentlicher Vertrag oder ein risikoreicher Fall. Beziehungen verbinden solche Objekte miteinander, etwa eine Tochtergesellschaft mit einem Konto oder einen Vertragsnachtrag mit dem zugehörigen Hauptvertrag.
Entscheidungsregeln beschreiben Schwellenwerte, Ausnahmen, Zuständigkeiten und Freigabebedingungen. Gesammelte Korrekturen halten fest, an welchen Stellen Fachanwender fehlerhafte Ergebnisse berichtigt haben. Erst im Zusammenspiel lässt sich daraus mehr als eine komfortable Suchfunktion entwickeln: eine nachvollziehbare Grundlage dafür, welche Informationen wie interpretiert und in welchem Rahmen genutzt werden dürfen.
Aus ökonomischer Sicht sind diese Wissensarten unterschiedlich zu bewerten. Eine Kundendefinition kann über viele Anwendungen hinweg wiederverwendbar sein. Eine Ausnahmeentscheidung kann dagegen nur für einen bestimmten Vertrag gelten. Eine gute Architektur muss daher nicht nur Wissen speichern, sondern dessen Reichweite begrenzen. Sonst verwandelt sie einen lokalen Sonderfall in eine allgemeine Regel und vergrößert gerade den Fehler, den sie verhindern soll.
Warum Dokumente betriebswirtschaftlich entscheidend sind
Eine KI-orientierte Bedeutungsschicht muss neben strukturierten Daten auch Verträge, E-Mails, Berichte und Gesprächsprotokolle mit den zugehörigen Geschäftsvorgängen verbinden können. Der Grund ist unmittelbar einleuchtend: Ein Datenbankeintrag kann den vereinbarten Standardpreis enthalten, während eine freigegebene Zusatzvereinbarung eine andere Kondition festlegt. Wer nur den Datensatz auswertet, übersieht möglicherweise die wirtschaftlich verbindliche Ausnahme.
Der anspruchsvolle Teil besteht nicht allein darin, eine Klausel zu finden. Er liegt darin, ihren Status zu bestimmen. Ein Entwurf ist keine unterschriebene Vereinbarung. Eine interne Gesprächsnotiz ersetzt keine Freigabe. Ein späteres Dokument kann eine frühere Regel ergänzen, teilweise verdrängen oder für einen anderen Geltungsbereich bestimmt sein. Diese Unterschiede müssen im jeweiligen Anwendungsfall ausdrücklich modelliert und geprüft werden.
Daraus ergibt sich eine wichtige wirtschaftliche Perspektive: Der Wert von Dokumentenerschließung bemisst sich nicht an der Zahl verarbeiteter Seiten. Er entsteht erst, wenn sich daraus belastbare Aussagen über Ansprüche, Verpflichtungen, Fristen oder Handlungsoptionen ableiten lassen. Eine schnelle Zusammenfassung ohne Verbindlichkeitsprüfung kann dagegen zusätzliche Prüfkosten verursachen und falsche Sicherheit erzeugen.
Vier Kostenquellen semantischer Unklarheit
Die betriebswirtschaftliche Wirkung lässt sich über vier Kostenarten erschließen. Erstens entstehen Suchkosten, wenn Beschäftigte Informationen und ihre Bedeutung zusammensuchen müssen. Zweitens entstehen Abstimmungskosten, wenn Fachbereiche unterschiedliche Auswertungen erklären und abgleichen. Drittens entstehen Fehlerkosten, wenn falsche Zuordnungen oder Regeln zu Nacharbeit und Fehlentscheidungen führen. Viertens entstehen Wiederholungskosten, wenn jedes neue KI-Projekt dieselben fachlichen Grundlagen erneut entwickelt.
Diese Einteilung ist ein analytischer Bewertungsrahmen, keine empirisch gemessene Kostenverteilung. Sie hilft jedoch, einen häufigen Denkfehler zu vermeiden: Die Rendite einer Semantic Layer sollte nicht allein an der Antwortgeschwindigkeit eines Assistenten hängen. Eine Antwort kann in Sekunden erscheinen und dennoch teuer sein, wenn anschließend mehrere Fachkräfte ihre Richtigkeit prüfen müssen.
Umgekehrt kann eine scheinbar unspektakuläre Verbesserung erheblichen Wert schaffen. Wenn eine verbindliche Definition die Abstimmung zwischen Finanzabteilung und Vertrieb verkürzt, betrifft der Nutzen möglicherweise zahlreiche Berichte und Entscheidungen zugleich. Die relevante wirtschaftliche Einheit ist deshalb nicht immer der einzelne KI-Dialog, sondern der gesamte Geschäftsprozess einschließlich seiner Kontroll- und Korrekturschleifen.
Wiederverwendung schafft Skaleneffekte
Gemeinsame Kennzahlendefinitionen können doppelte Implementierungsarbeit vermeiden und dieselbe Geschäftslogik für verschiedene Anwendungen zugänglich machen. Auf eine umfassendere KI-Architektur übertragen, liegt darin das zentrale Skalierungsversprechen: Bereits freigegebene Begriffe, Beziehungen und Regeln sollen für weitere Anwendungsfälle nutzbar bleiben. Das macht die Bedeutungsschicht zu einer möglichen Infrastrukturinvestition statt zu einer isolierten Projektkomponente.
Die ökonomische Logik ähnelt einem gemeinsam genutzten Betriebsmittel. Seine erstmalige Erstellung verursacht Aufwand, während zusätzliche Nutzer vorhandene Bestandteile mitverwenden können. Der Vorteil wächst allerdings nur, wenn die neuen Anwendungsfälle tatsächlich genügend fachliche Überschneidungen aufweisen. Ein weiterer Assistent im selben Servicebereich kann auf mehr vorhandenes Wissen zurückgreifen als eine Anwendung für einen völlig anderen Geschäftsbereich.
Daher wäre es unrealistisch, bei jedem weiteren KI-Projekt automatisch sinkende Kosten zu erwarten. Neue Rechtsräume, Produktfamilien oder Geschäftsmodelle können umfangreiche Ergänzungen verlangen. Der belastbare Skaleneffekt besteht nicht darin, dass spätere Projekte kostenlos werden, sondern darin, dass bereits geklärte Sachverhalte nicht ohne sachlichen Grund erneut geklärt werden müssen.
Produktivität braucht eine nüchterne Einordnung
Eine Untersuchung mit 5.172 Kundenservice-Beschäftigten ermittelte durch den Zugang zu einem generativen KI-Assistenten durchschnittlich rund 15 Prozent mehr gelöste Kundenanliegen pro Stunde. Die Wirkung war jedoch ungleich verteilt: Weniger erfahrene und geringer qualifizierte Beschäftigte profitierten stärker, während besonders erfahrene und leistungsstarke Beschäftigte nur geringe Geschwindigkeitsgewinne und teilweise leichte Qualitätseinbußen verzeichneten. Die Untersuchung belegt damit einen konkreten Produktivitätseffekt in einem bestimmten Arbeitsumfeld, nicht die isolierte Rendite einer Semantic Layer.
Für die wirtschaftliche Bewertung ist diese Abgrenzung wesentlich. Aus einem erfolgreichen KI-Einsatz lässt sich nicht ableiten, welcher Anteil des Erfolgs auf das Sprachmodell, die Benutzerführung, das verfügbare Wissen, Schulungen oder veränderte Arbeitsabläufe entfiel. Wer daraus pauschale Renditeversprechen für eine einzelne Architekturkomponente ableitet, überschreitet die Aussagekraft der Daten.
Außerdem ist freigesetzte Arbeitszeit nicht gleichbedeutend mit einer entsprechenden Kostensenkung. Wirtschaftlicher Nutzen entsteht beispielsweise dann, wenn ein Unternehmen zusätzliche Nachfrage bewältigt, Wartezeiten verkürzt, Überstunden vermeidet oder knappe Fachkräfte für anspruchsvollere Aufgaben einsetzt. Ohne solche Veränderungen kann ein messbarer Zeitgewinn betriebswirtschaftlich weitgehend ungenutzt bleiben.
Eine Renditerechnung mit vollständigen Kosten
Ein tragfähiger Business Case sollte zunächst den heutigen Prozess erfassen. Dazu gehören Fallzahlen, Bearbeitungszeiten, Rückfragen, Korrekturen, Eskalationen und die Folgen fehlerhafter Entscheidungen. Anschließend ist zu bestimmen, welche dieser Größen eine gemeinsame Bedeutungsschicht voraussichtlich beeinflussen kann. Erst danach lässt sich sinnvoll über Investitionsumfang und erwarteten Nutzen sprechen.
Auf der Kostenseite sollten neben Software und Modellnutzung auch Systemanbindung, fachliche Modellierung, Identitätsabgleich, Berechtigungspflege, Tests und laufende Aktualisierung berücksichtigt werden. Gerade die Mitwirkung erfahrener Fachkräfte ist kein kostenloser Nebenaufwand. Ihre Zeit hat einen wirtschaftlichen Wert und steht während der Einführung nicht für andere Aufgaben zur Verfügung.
Eine nüchterne Rechnung berücksichtigt zudem Anlaufverluste und Unsicherheit. Zu Beginn kann eine neue Anwendung zusätzliche Kontrollen erfordern, bevor sich Routinen stabilisieren. Manche Vorteile werden erst bei weiteren Anwendungsfällen sichtbar, andere bleiben aus. Deshalb ist ein gestufter Investitionsansatz mit überprüfbaren Zwischenzielen häufig plausibler als eine große Vorabinvestition, deren Rechtfertigung hauptsächlich auf späteren Synergieversprechen beruht.
Der richtige Maßstab für Erfolg
Der wichtigste Erfolgsmaßstab ist der wirtschaftliche Aufwand je korrekt und regelkonform abgeschlossenem Geschäftsvorgang. Diese Perspektive verbindet Geschwindigkeit, Qualität und Kontrolle. Sie verhindert, dass eine hohe Nutzungszahl oder eine kurze Antwortzeit als Erfolg gilt, obwohl die Anwendung zusätzliche Nacharbeit erzeugt.
Für die Messung sollten unterschiedliche Fehlerarten getrennt werden. Eine falsche Kennzahl ist etwas anderes als eine nicht beachtete Vertragsausnahme. Ein unvollständiger Hinweis unterscheidet sich von einer unberechtigten Datenoffenlegung. Ebenso muss erkennbar bleiben, ob ein System eine Frage zuverlässig beantwortet, berechtigt an einen Menschen übergibt oder ohne ausreichende Grundlage dennoch ein Ergebnis ausgibt.
Ein aussagekräftiger Vergleich nutzt vorab fachlich geprüfte Fälle und betrachtet den gesamten Ablauf. Bei geeigneten Prozessen können zeitlich gestaffelte Einführungen oder kontrollierte Vergleichsgruppen helfen, technische Verbesserungen von allgemeinen Veränderungen zu unterscheiden. Dabei sollte die Prüfung auch seltene, aber wirtschaftlich wichtige Ausnahmen einschließen. Ein System, das Routinefälle gut bearbeitet und kritische Sonderfälle übersieht, kann im Durchschnitt überzeugend und im Geschäft dennoch unvertretbar sein.
Vektorsuche ersetzt keine Verbindlichkeit
Vektordatenbanken unterstützen die Suche nach inhaltlich ähnlichen Texten, indem sie Informationen über numerische Repräsentationen, sogenannte Embeddings, vergleichbar machen. Moderne Systeme können zusätzlich Metadatenfilter, Schlüsselwortsuche und kombinierte Suchverfahren verwenden. Es wäre deshalb falsch, sie als grundsätzlich kontextfreie Speicher ohne Filtermöglichkeiten darzustellen.
Ihre Kernleistung beantwortet dennoch eine andere Frage als die betriebliche Governance. Inhaltliche Ähnlichkeit sagt nicht automatisch aus, ob ein Dokument aktuell, verbindlich oder für den konkreten Fall anwendbar ist. Ein Suchsystem kann solche Eigenschaften berücksichtigen, wenn sie verlässlich hinterlegt und korrekt in die Abfrage eingebunden werden. Es legt die dafür notwendigen Geschäftsentscheidungen jedoch nicht selbst fest.
Für Unternehmen folgt daraus eine klare Investitionslogik. Eine bessere Suche und eine bessere Bedeutungsschicht können sich ergänzen. Zusätzliche Suchtreffer sind aber kein Ersatz für geklärte Zuständigkeiten und Regeln. Wer jede fehlerhafte Antwort ausschließlich mit einem leistungsfähigeren Suchindex beheben will, riskiert, mehr Material bereitzustellen, ohne dessen fachliche Geltung zu klären.
🤖🚀 Managed-AI-Platform: Schneller, sicherer & smarter zur KI-Lösung mit UNFRAME.AI

Managed AI Platform - Bild: Xpert.Digital
Hier erfahren Sie, wie Ihr Unternehmen maßgeschneiderte KI-Lösungen schnell, sicher und ohne hohe Einstiegshürden realisieren kann.
Eine Managed AI Platform ist Ihr Rundum-Sorglos-Paket für künstliche Intelligenz. Anstatt sich mit komplexer Technik, teurer Infrastruktur und langwierigen Entwicklungsprozessen zu befassen, erhalten Sie von einem spezialisierten Partner eine fertige, auf Ihre Bedürfnisse zugeschnittene Lösung – oft innerhalb weniger Tage.
Die zentralen Vorteile auf einen Blick:
⚡ Schnelle Umsetzung: Von der Idee zur einsatzbereiten Anwendung in Tagen, nicht Monaten. Wir liefern praxisnahe Lösungen, die sofort Mehrwert schaffen.
🔒 Maximale Datensicherheit: Ihre sensiblen Daten bleiben bei Ihnen. Wir garantieren eine sichere und konforme Verarbeitung ohne Datenweitergabe an Dritte.
💸 Kein finanzielles Risiko: Sie zahlen nur für Ergebnisse. Hohe Vorabinvestitionen in Hardware, Software oder Personal entfallen komplett.
🎯 Fokus auf Ihr Kerngeschäft: Konzentrieren Sie sich auf das, was Sie am besten können. Wir übernehmen die gesamte technische Umsetzung, den Betrieb und die Wartung Ihrer KI-Lösung.
📈 Zukunftssicher & Skalierbar: Ihre KI wächst mit Ihnen. Wir sorgen für die laufende Optimierung, Skalierbarkeit und passen die Modelle flexibel an neue Anforderungen an.
Mehr dazu hier:
Der Einfluss von Dokumenten auf betriebswirtschaftliche Entscheidungen
Wissensgraphen können mehr als Verknüpfungen
Ein Knowledge Graph stellt Entitäten und ihre Beziehungen in einer vernetzten Struktur dar und kann damit einen wichtigen Bestandteil einer Semantic Layer bilden. Zugleich können formale Ontologien und darauf aufbauende Verfahren auch logische Schlussfolgerungen unterstützen; etablierte Standards wie OWL sind nicht auf das bloße Speichern einfacher Verbindungen beschränkt. Die pauschale Behauptung, ein Wissensgraph könne grundsätzlich keine Regeln abbilden, wäre daher technisch unzutreffend.
Die entscheidende Frage lautet stattdessen, welche Fähigkeiten eine konkrete Lösung tatsächlich vereint. Ein Graph mit Unternehmensobjekten besitzt nicht automatisch eine vollständige Rechteverwaltung, eine getestete Prozesssteuerung oder eine fachlich freigegebene Behandlung von Sonderfällen. Umgekehrt kann eine entsprechend ausgestaltete Grapharchitektur erhebliche Teile dieser Anforderungen erfüllen.
Eine Semantic Layer sollte deshalb weniger als zwingend eigenständiges Produkt verstanden werden, sondern als Bündel benötigter Funktionen. Manche Unternehmen können große Teile davon mit vorhandenen BI-Modellen, Datenkatalogen, Graphsystemen und Regelwerken abdecken. Andere benötigen eine zusätzliche Plattform. Wirtschaftlich relevant ist die nachgewiesene Funktionslücke, nicht die Zahl neu eingeführter Produktkategorien.
Verbinden statt alles neu speichern
Eine Bedeutungsschicht kann bestehende ERP- und CRM-Systeme, Datenplattformen und Dokumentenablagen anbinden, ohne zunächst sämtliche Unternehmensdaten in einen einzigen neuen Speicher zu verlagern. Auch semantische Modelle für Kennzahlen können auf vorhandenen Datenstrukturen aufbauen und die passende Abfragelogik daraus ableiten. Die gemeinsame Bedeutung ist damit grundsätzlich von der physischen Ablage der Daten unterscheidbar.
Daraus folgt allerdings nicht, dass eine solche Architektur ohne jede Datenkopie auskommt. Suchindizes, extrahierte Dokumentinformationen, Zwischenspeicher oder vorberechnete Ergebnisse können für den jeweiligen Anwendungsfall sinnvoll sein. Die betriebswirtschaftlich relevante Frage ist, welche Informationen wo und wie lange vorgehalten werden müssen, nicht ob sich das Versprechen vollständiger Kopierfreiheit vermarkten lässt.
Ein sinnvoller Entwurf wägt Aktualität, Antwortzeit, Verfügbarkeit, Kosten und Datenschutz gegeneinander ab. Für einen Bestandsstatus können andere Aktualitätsanforderungen gelten als für eine Vertragsklausel. Eine über viele Quellsysteme verteilte Abfrage kann flexibel sein, erhöht aber auch die Abhängigkeit von deren Verfügbarkeit. Die beste Lösung ist deshalb nicht zwangsläufig maximal zentral oder maximal verteilt, sondern dem Geschäftsprozess angemessen.
Datenqualität bleibt eine eigene Aufgabe
Eine gemeinsame Bedeutungsschicht macht fehlerhafte Ausgangsdaten nicht automatisch richtig. Auch Anbieter semantischer Abfragesysteme empfehlen, grundlegende Konsistenzaufgaben wie die Normalisierung gemeinsamer Objekte und die Bereinigung ungeeigneter Daten möglichst bereits vorgelagert anzugehen. Fachliche Semantik und Datenqualität ergänzen sich, sie sind keine austauschbaren Aufgaben.
Ein besonders anschauliches Beispiel ist die Identität eines Geschäftspartners. Unterschiedliche Schreibweisen können denselben Lieferanten bezeichnen. Ähnliche Namen können aber auch zu verschiedenen Rechtsträgern gehören. Eine vorschnelle Zusammenführung kann dann Zahlungsinformationen, Bonitätsmerkmale oder Vertragsbeziehungen falsch zuordnen. Eine gute Architektur muss daher offenlegen können, welche Zuordnung gesichert ist und wo lediglich eine plausible Vermutung besteht.
Ökonomisch ist das wichtig, weil Fehler nicht immer dort sichtbar werden, wo sie entstehen. Ein unzutreffender Identitätsabgleich kann später mehrere Auswertungen und Entscheidungen beeinflussen. Deshalb sollte die Einführung nicht nur auf die Qualität einzelner Antworten schauen, sondern auch auf die belastbare Zuordnung der zugrunde liegenden Objekte. Wiederverwendung vervielfacht sonst nicht nur Wissen, sondern ebenso dessen Fehler.
Regeln müssen technisch wirksam werden
Eine Richtlinie in einem Dokument ist noch keine durchgesetzte Kontrolle. Für KI-Anwendungen unterscheiden Sicherheitskonzepte ausdrücklich zwischen sprachlichen Vorgaben und technischen Maßnahmen wie eingeschränkten Funktionen, begrenzten Berechtigungen und überprüfbaren Ausführungsbedingungen. Gerade übermäßige Autonomie und zu weitreichende Zugriffsrechte können dazu führen, dass fehlerhafte oder manipulierte Modellausgaben schädliche Aktionen auslösen.
Eine robuste Architektur sollte deshalb Interpretation und Ausführung trennen. Das Sprachmodell kann beispielsweise einen Vorgang einordnen oder eine Handlung vorschlagen. Ob ein Betrag korrekt berechnet wurde, eine Freigabe vorliegt oder eine Buchung ausgeführt werden darf, sollte bei kritischen Prozessen zusätzlich durch überprüfbare Logik und die zuständigen Systeme abgesichert sein.
Das begrenzt ein verbreitetes Missverständnis. Eine Semantic Layer kann die fachlichen Grundlagen für regelgerechtes Verhalten bereitstellen. Sie garantiert aber nicht allein, dass ein probabilistisches Sprachmodell jede Regel zuverlässig anwendet. Die wirtschaftlich tragfähige Lösung entsteht durch das Zusammenspiel aus Bedeutung, Berechtigungen, Tests, Prozesskontrollen und klar begrenzten Handlungsmöglichkeiten.
Berechtigungen sind Teil der Bedeutung
Beim Zugriff auf Unternehmenswissen muss nicht nur die Relevanz, sondern auch die Zugriffsberechtigung geprüft werden. Dokumentenbezogene Kontrollen können Suchergebnisse anhand der Identität des Nutzers und der hinterlegten Rechte einschränken; ihre Wirksamkeit hängt dabei unter anderem von korrekt synchronisierten Berechtigungsinformationen ab. Eine gemeinsame Wissensbasis bedeutet folglich nicht, dass jeder Anwender dieselben Inhalte sehen darf.
Für die Praxis ist die zeitliche Dimension entscheidend. Ein Beschäftigter kann eine Rolle wechseln, ein Projekt kann enden oder ein Dokument kann nachträglich eingeschränkt werden. Wenn die Such- und Kontextschicht veraltete Rechte verwendet, kann sie Inhalte offenlegen, auf die im Ursprungssystem kein Zugriff mehr erlaubt ist. Deshalb muss die Pflege der Berechtigungen ausdrücklich in den Betriebsaufwand eingehen.
Auch inhaltlich ähnliche Fragen dürfen aus guten Gründen unterschiedliche Antworten erhalten. Zwei Nutzer können verschiedenen Zuständigkeitsbereichen angehören oder auf unterschiedliche Datenstände zugreifen. Konsistenz bedeutet daher nicht Wortgleichheit, sondern dieselben fachlichen Regeln bei vergleichbarem Kontext. Eine Abweichung ist erst dann ein Qualitätsproblem, wenn sie nicht durch Zeit, Rolle, Datenlage oder Fragestellung erklärbar ist.
Korrekturen brauchen einen geregelten Weg
Die Erfassung von Nutzerkorrekturen gehört zu den vorgesehenen Wissensbausteinen einer KI-orientierten Semantic Layer. Auch im KI-Risikomanagement gilt die Untersuchung menschlicher Übersteuerungen und ihrer Gründe als nützliche Informationsquelle für die Bewertung eingesetzter Systeme. Daraus folgt jedoch nicht, dass jede Änderung eines Anwenders automatisch zu einer allgemeinen Regel werden sollte.
Ein korrigiertes Ergebnis kann sehr unterschiedliche Ursachen haben. Vielleicht war ein Datensatz falsch zugeordnet. Vielleicht galt eine Vertragsausnahme. Vielleicht war die bisherige Unternehmensregel überholt. Oder der Anwender hat lediglich eine persönliche Präferenz eingetragen. Diese Fälle erfordern verschiedene Reaktionen und dürfen nicht unterschiedslos in einen gemeinsamen Wissensbestand übernommen werden.
Ein wirtschaftlich sinnvoller Lernprozess behandelt Rückmeldungen zunächst als prüfbare Vorschläge. Fachverantwortliche entscheiden über ihren Geltungsbereich, ihre Verbindlichkeit und die erforderlichen Tests. Erst danach wird eine freigegebene Änderung für weitere Anwendungen verfügbar. Dafür ist nicht zwingend ein erneutes Training des Sprachmodells nötig. Entscheidend ist, dass der Fehler künftig im passenden Kontext vermieden wird, ohne unbemerkt neue Fehler an anderer Stelle einzuführen.
Versionierung schützt vor falscher Rückschau
Geschäftliche Definitionen und Regeln verändern sich; eine Semantic Layer sollte Änderungen deshalb versionieren und fachlichen Verantwortlichen zur Freigabe zuordnen. Auch bestehende semantische Plattformen unterstützen bereits versionierte Definitionen oder geprüfte Referenzabfragen mit Angaben darüber, wann und durch wen sie bestätigt wurden. Eine nachvollziehbare Historie ist damit kein dekoratives Zusatzmerkmal, sondern ein Bestandteil kontrollierter Nutzung.
Für eine spätere Prüfung reicht die aktuell gültige Regel allerdings nicht aus. Relevant ist auch, welche Fassung zum Zeitpunkt des Vorgangs galt und welche Informationen das System damals tatsächlich verarbeiten konnte. Ein später eingegangener Vertragsnachtrag darf nicht unbemerkt zur Bewertungsgrundlage einer früheren Entscheidung werden. Sonst entsteht im Rückblick eine scheinbare Eindeutigkeit, die im Entscheidungszeitpunkt nicht vorhanden war.
Unternehmen sollten deshalb Regelhistorie, Dokumentversionen und Datenstände gemeinsam betrachten. Die Wirtschaftlichkeit zeigt sich hier weniger in Sekundenersparnissen als in geringeren Aufklärungskosten bei strittigen Vorgängen. Wer die Grundlage einer Entscheidung rekonstruieren kann, muss weniger Zeit darauf verwenden, sie aus E-Mails, Einzeldateien und nachträglichen Erinnerungen zusammenzusetzen.
Modellfreiheit ist noch keine Anbieterfreiheit
Unternehmenswissen sollte so organisiert sein, dass ein Wechsel des Sprachmodells nicht automatisch eine vollständige Neuerstellung der fachlichen Grundlagen erfordert. Das strategische Argument dafür wird durch die technische Dynamik gestützt: Zwischen November 2022 und Oktober 2024 sanken die Kosten für Modellabfragen bei einem mit GPT-3.5 vergleichbaren Leistungsniveau um mehr als den Faktor 280. Dieser Vergleich bezieht sich auf ein bestimmtes Benchmark-Niveau und darf nicht als entsprechende Senkung der Gesamtkosten einer Unternehmensanwendung gelesen werden.
Trotzdem ist die Folgerung plausibel: Wenn Modellleistungen und Preise sich stark verändern, gewinnt die Möglichkeit zum Wechsel an Wert. Ein dauerhaft nutzbares Fachmodell kann verhindern, dass jede technische Modernisierung erneut eine umfassende fachliche Übersetzungsarbeit auslöst. Modellunabhängigkeit besitzt damit den Charakter einer strategischen Handlungsoption.
Sie beseitigt aber nicht jede Abhängigkeit. Definitionen können weiterhin an proprietäre Plattformformate, Schnittstellen oder Betriebsmodelle gebunden sein. Deshalb sollte ein Unternehmen getrennt prüfen, ob es das Sprachmodell wechseln, seine Wissensdefinitionen exportieren und die gesamte Lösung bei einem anderen Betreiber weiterführen kann. Erst diese Unterscheidung erlaubt eine realistische Bewertung von Wechselkosten und Verhandlungsspielraum.
Der Markt wächst zusammen
Semantische Definitionen werden inzwischen ausdrücklich sowohl für BI als auch für KI angeboten: Snowflake verbindet Geschäftskennzahlen und Entitätsbeziehungen mit Abfragen und Agenten, während dbt seine zentral definierten Kennzahlen auch über Schnittstellen für KI-Werkzeuge bereitstellt. Parallel entstand mit Open Semantic Interchange eine Initiative für einen herstellerneutralen Austausch semantischer Metadaten. Das Projekt wurde 2026 unter dem Namen Apache Ossie in den Apache-Inkubator aufgenommen.
Diese Entwicklung ist wirtschaftlich bedeutsamer als eine weitere Produktankündigung. Wenn mehrere Werkzeuge dieselben Definitionen nutzen können, sinkt grundsätzlich der Zwang, Fachlogik in jeder Anwendung neu anzulegen. Gleichzeitig können etablierte Datenplattformen dadurch größere Teile der Wertschöpfung übernehmen, die zuvor spezialisierten Zusatzlösungen vorbehalten waren.
Für Kunden bedeutet das: Vor einer Neuanschaffung sollte eine Bestandsaufnahme stehen. Bereits vorhandene Datenmodelle, Kennzahlenkataloge, Berechtigungssysteme und Schnittstellen können einen Teil der Anforderungen abdecken. Offene Austauschformate sind dabei hilfreich, aber kein vollständiger Wirksamkeitsnachweis. Sie müssen sich daran messen lassen, welche Definitionen, Regeln und Kontextinformationen zwischen den tatsächlich eingesetzten Systemen ohne Bedeutungsverlust übertragbar sind.
Unframes Knowledge Fabric sachlich betrachtet
Unframe bündelt seine semantischen Funktionen unter der Bezeichnung Knowledge Fabric und verbindet dabei Unternehmensbegriffe, Geschäftslogik, Beziehungen und Berechtigungen. Der Ansatz sieht vor, strukturierte Datensätze ebenso wie Dokumenteninhalte für den jeweiligen Anwendungsfall nutzbar zu machen und die Wissensbasis schrittweise zu erweitern. Die Lösung wird zudem mit unterschiedlichen Sprachmodellen und einer Einbindung in bestehende Unternehmenssysteme angeboten.
Die wirtschaftliche Attraktivität dieses Konzepts liegt in der Kombination bislang getrennter Aufgaben. Wenn Systemanbindung, fachlicher Kontext und kontrollierte Nutzung gut zusammenarbeiten, kann sich der Aufwand für zusätzliche Anwendungen verringern. Ob dieser Vorteil im konkreten Unternehmen eintritt, lässt sich jedoch nicht aus der Architekturbezeichnung ableiten. Dafür braucht es überprüfbare Ergebnisse im eigenen Prozess.
Zugleich bleibt die Eigentums- und Betriebsfrage relevant: Unframe unterscheidet zwischen kundeneigenen Daten, Ergebnissen und Lösungskonfigurationen einerseits sowie der vom Anbieter betriebenen Knowledge Fabric und weiteren Plattformkomponenten andererseits. Modellwahlfreiheit ist deshalb nicht mit vollständiger Unabhängigkeit von der Plattform gleichzusetzen. Für eine belastbare Bewertung sollten Exportmöglichkeiten, Rechte an fachlichen Definitionen und die Fortführbarkeit bei einem Betreiberwechsel ausdrücklich geklärt werden.
Klein beginnen, anschlussfähig bleiben
Ein anwendungsbezogener Start begrenzt den Modellierungsumfang und ermöglicht es, Definitionen mit den zuständigen Fachverantwortlichen an realen Aufgaben zu überprüfen. Statt sofort das gesamte Unternehmen abzubilden, werden zunächst die benötigten Systeme, Objekte, Beziehungen und Regeln eines klar abgegrenzten Prozesses erfasst. Anschließend können freigegebene Bestandteile für fachlich benachbarte Anwendungsfälle erweitert werden.
Ökonomisch eignet sich dafür besonders ein Prozess mit häufigen Wiederholungen, nachvollziehbaren Ergebnissen und ausreichend bedeutsamen Abstimmungsproblemen. Ein zu einfacher Anwendungsfall beweist möglicherweise nur, dass sich ein Chatfenster an eine Datenquelle anschließen lässt. Ein zu komplexer Einstieg kann dagegen so viele ungeklärte Sonderfälle bündeln, dass der Nutzen erst nach langer Zeit sichtbar wird.
Die richtige Balance liegt zwischen begrenzter Aufgabe und wiederverwendbarem Fundament. Ein Pilot sollte nicht als Wegwerfprototyp entstehen. Zugleich sollte seine Anschlussfähigkeit nicht zur Ausrede werden, vor der ersten messbaren Verbesserung ein umfassendes Unternehmensmodell aufzubauen. Der Maßstab bleibt, welche fachlichen Bausteine für den nächsten sinnvollen Schritt tatsächlich benötigt werden.
Fachliche Verantwortung entscheidet über Akzeptanz
Die Einführung verschiebt Verantwortung nicht von Menschen auf Software. Jede zentrale Definition benötigt eine fachlich zuständige Stelle, die Änderungen beurteilen und freigeben kann. Auch übergreifende Rahmenwerke für vertrauenswürdige KI betonen klar beschriebene menschliche Rollen und Zuständigkeiten im Umgang mit KI-Systemen. Technischer Betrieb und fachliche Geltung sollten deshalb nicht stillschweigend derselben Rolle zugeschlagen werden.
Das kann organisatorisch unbequem sein. Eine gemeinsame Definition von Umsatz, Kundenzugehörigkeit oder Risiko berührt unter Umständen Zielsysteme, Zuständigkeiten und bestehende Bewertungspraxis. Eine Semantic Layer legt solche Unterschiede offen. Sie löst sie nicht durch technische Eleganz, sondern macht Entscheidungen erforderlich, die bislang möglicherweise vermieden wurden.
Darin liegt zugleich ihr langfristiger Wert. Wenn Begriffe und Regeln nicht mehr allein in den Köpfen einzelner Beschäftigter oder in verstreuten Anwendungen stecken, kann das Unternehmen unabhängiger von informellen Wissensmonopolen werden. Dieser Vorteil setzt allerdings voraus, dass Fachkräfte an der Gestaltung beteiligt werden und die Bedeutungsschicht als Unterstützung erleben. Wird sie lediglich als Kontrollinstrument eingeführt, kann die Bereitschaft sinken, wertvolles Erfahrungswissen einzubringen.
Nicht jedes Unternehmen braucht dieselbe Tiefe
Die europäischen Nutzungsdaten zeigen erhebliche Größenunterschiede beim KI-Einsatz, ohne daraus die Notwendigkeit einer bestimmten Architektur abzuleiten. Zudem nannten 2025 unter den Unternehmen ohne KI-Nutzung, die einen Einsatz bereits erwogen hatten, 70,89 Prozent fehlende einschlägige Fachkenntnisse als Hinderungsgrund; 52,52 Prozent verwiesen auf unklare rechtliche Folgen und 48,83 Prozent auf Datenschutzbedenken. Diese Werte beziehen sich ausdrücklich auf diese Teilgruppe und nicht auf sämtliche Unternehmen.
Daraus lässt sich eine differenzierte Investitionsperspektive entwickeln. Ein kleiner Betrieb mit wenigen Systemen und überschaubaren Prozessen benötigt möglicherweise zunächst konsistente Kennzahlen und klar gepflegte Wissensbestände. Ein Konzern mit zahlreichen Tochtergesellschaften, Produktlinien und Zugriffsrollen kann dagegen von einer umfangreicheren semantischen Infrastruktur profitieren. Die richtige Tiefe richtet sich nach Komplexität und Risiko, nicht nach der Attraktivität eines Technologiebegriffs.
Auch Verzicht kann wirtschaftlich vernünftig sein. Wenn eine Aufgabe selten vorkommt, keine größeren Folgen hat und sich mit einem einfachen Verfahren zuverlässig erledigen lässt, kann der Pflegeaufwand einer zusätzlichen Schicht ihren Nutzen übersteigen. Ein überzeugender Architekturansatz muss deshalb ebenso erklären können, wo er nicht gebraucht wird.
Kontrollierte Bedeutung als Wettbewerbsvorteil
Generative KI kann fehlerhafte Inhalte überzeugend formulieren; dieses Risiko gehört zu den ausdrücklich beschriebenen Eigenschaften und Gefahren solcher Systeme. Auch zusätzliche Unternehmensinformationen und Retrieval-Verfahren beseitigen nicht sämtliche Sicherheitsrisiken, etwa durch manipulierte Anweisungen in verarbeiteten Inhalten. Eine Semantic Layer ist daher keine Garantie für Wahrheit, Sicherheit oder Wirtschaftlichkeit.
Ihre begründete strategische Bedeutung liegt an anderer Stelle. Sie kann den Übergang von verstreutem Erfahrungswissen zu expliziten, wiederverwendbaren und verantworteten Geschäftsdefinitionen unterstützen. Dadurch wird es möglich, KI nicht nur punktuell einzusetzen, sondern schrittweise in ein kontrolliertes betriebliches System einzubetten. Der dauerhafte Vermögenswert ist dann nicht der einzelne Assistent, sondern die organisierte Fähigkeit, Unternehmenswissen zuverlässig für neue Aufgaben nutzbar zu machen.
Der entscheidende Wettbewerbsvorteil entsteht folglich nicht durch die größte Zahl autonomer Agenten. Er entsteht dort, wo Unternehmen schneller erkennen, welche Informationen gelten, welche Ausnahmen relevant sind und welche Handlungen verantwortbar bleiben. Wer diese Grundlage beherrscht, kann wechselnde Modelle und Werkzeuge gezielter einsetzen. Wer sie vernachlässigt, riskiert, mit jeder neuen KI-Anwendung vor allem die Geschwindigkeit seines eigenen Missverständnisses zu erhöhen.
Beratung - Planung - Umsetzung

Konrad Wolfenstein
Gerne stehe ich Ihnen als persönlicher Berater zur Verfügung.
Sie können mit mir unter wolfenstein∂xpert.digital Kontakt aufnehmen oder
mich einfach unter +49 7348 4088 965 anrufen.