Новая цифровая видимость – расшифровка SEO, LLMO, GEO, AIO и AEO – Одного SEO уже недостаточно – Изображение: Xpert.Digital
Стратегическое руководство по оптимизации генеративных движков (GEO) и оптимизации больших языковых моделей (LLMO) (Время чтения: 30 мин / Без рекламы / Без платного доступа)
Смена парадигмы: от поисковой оптимизации к генеративной поисковой оптимизации
Переосмысление цифровой прозрачности в эпоху искусственного интеллекта
В настоящее время цифровое информационное пространство переживает самую глубокую трансформацию со времен появления графического веб-поиска. Традиционный механизм, в котором поисковые системы представляют список потенциальных ответов в виде синих ссылок и оставляют пользователю возможность самостоятельно отбирать, сравнивать и синтезировать релевантную информацию, все чаще заменяется новой парадигмой. Ее заменяет модель «запрос-получение», основанная на генеративных системах искусственного интеллекта. Эти системы выполняют работу по синтезу информации за пользователя, предоставляя прямой, тщательно отобранный и понятный ответ на заданный вопрос.
Этот фундаментальный сдвиг имеет далеко идущие последствия для определения цифровой видимости. Успех больше не сводится к простому появлению на первой странице результатов поиска; он все чаще определяется как неотъемлемая часть ответа, сгенерированного искусственным интеллектом, — будь то прямо цитируемый источник, упомянутый бренд или основа для синтезированной информации. Это развитие ускоряет существующую тенденцию к «поиску без кликов», когда пользователи удовлетворяют свои информационные потребности непосредственно на странице результатов поиска, не посещая веб-сайт. Поэтому для бизнеса и создателей контента крайне важно понимать новые правила игры и соответствующим образом адаптировать свои стратегии.
В связи с этим:

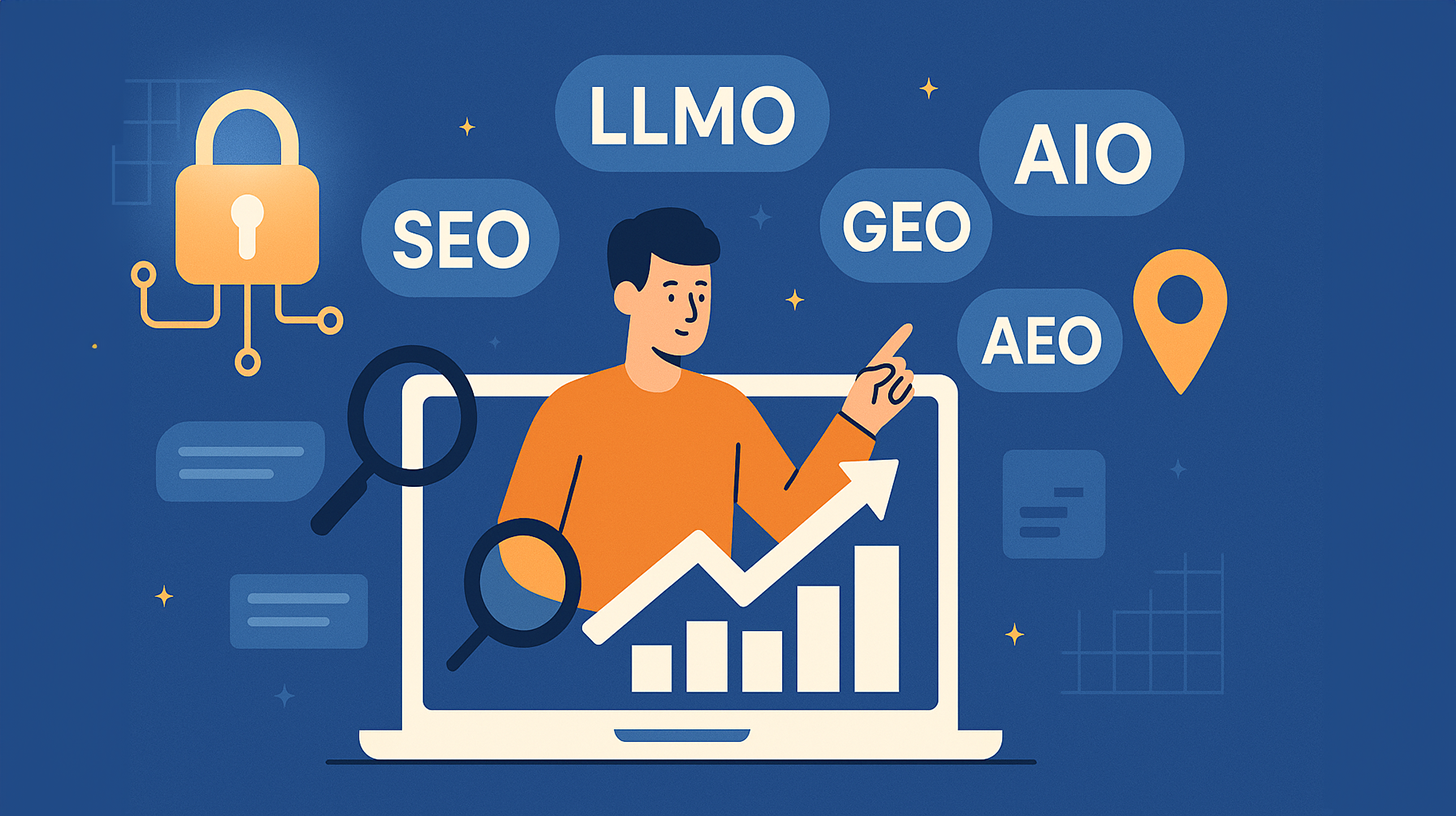
Новый словарь оптимизации: расшифровка SEO, LLMO, GEO, AIO и AEO
С появлением этих новых технологий сформировался сложный и зачастую запутанный словарь. Четкое определение этих терминов имеет важное значение для целенаправленной стратегии.
SEO (поисковая оптимизация): это устоявшаяся, фундаментальная дисциплина оптимизации веб-контента для традиционных поисковых систем, таких как Google и Bing. Главная цель — достижение высоких позиций в традиционных, основанных на ссылках, страницах результатов поиска (SERP). SEO остается крайне важным даже в эпоху искусственного интеллекта, поскольку оно закладывает основу для всей дальнейшей оптимизации.
LLMO (оптимизация больших языковых моделей): Этот точный технический термин описывает оптимизацию контента таким образом, чтобы он мог эффективно пониматься, обрабатываться и цитироваться текстовыми большими языковыми моделями (LLM), такими как ChatGPT от OpenAI или Gemini от Google. Цель состоит уже не в ранжировании, а в включении в качестве достоверного источника в ответы, генерируемые ИИ.
GEO (Generative Engine Optimization): несколько более широкий термин, часто используемый как синоним LLMO. GEO фокусируется на оптимизации всей генеративной системы или «движка» (например, Perplexity, Google AI Overviews), генерирующего ответ, а не только самой языковой модели. Речь идёт об обеспечении точного представления и распространения сообщения бренда по этим новым каналам.
AIO (оптимизация с помощью ИИ): это общий термин с множеством значений, что может привести к путанице. В контексте оптимизации контента AIO относится к общей стратегии адаптации контента для любого типа систем ИИ. Однако этот термин может также относиться к технической оптимизации самих моделей ИИ или к использованию ИИ для автоматизации бизнес-процессов. Эта неоднозначность делает его менее точным для конкретной контентной стратегии.
AEO (оптимизация поисковых систем): специализированное подразделение GEO/LLMO, которое фокусируется на оптимизации функций, позволяющих получать прямые ответы в поисковых системах, таких как те, что представлены в обзорах искусственного интеллекта Google.
В целях данного отчета термины GEO и LLMO используются в качестве основных для обозначения новых стратегий оптимизации контента, поскольку они наиболее точно описывают это явление и все чаще становятся отраслевым стандартом.
Почему традиционная SEO-оптимизация является основополагающей, но уже недостаточной
Распространенное заблуждение заключается в том, что новые дисциплины оптимизации заменят SEO. На самом деле, LLMO и GEO дополняют и расширяют традиционную поисковую оптимизацию. Их взаимоотношения носят симбиотический характер: без прочной основы SEO эффективная оптимизация для генеративного ИИ практически невозможна.
SEO как основа: Ключевые аспекты технического SEO — такие как быстрая загрузка страниц, чистая архитектура сайта и обеспечение индексируемости — абсолютно необходимы для того, чтобы системы искусственного интеллекта могли вообще находить, читать и обрабатывать веб-сайт. Аналогично, такие устоявшиеся сигналы качества, как высококачественный контент и тематически релевантные обратные ссылки, остаются решающими для того, чтобы считаться надежным источником.
Связь с RAG: Многие генеративные поисковые системы используют технологию, называемую Retrieval-Augmented Generation (RAG), для обогащения своих ответов актуальной информацией из интернета. Они часто используют лучшие результаты традиционных поисковых систем. Таким образом, высокий рейтинг в традиционном поиске напрямую увеличивает вероятность того, что ИИ использует его в качестве источника для сгенерированного ответа.
Недостаток SEO как такового: несмотря на свою фундаментальную важность, одного SEO уже недостаточно. Высокий рейтинг больше не гарантирует видимость или трафик, поскольку сгенерированный ИИ ответ часто затмевает традиционные результаты и напрямую отвечает на запрос пользователя. Новая цель — выявить и обобщить релевантную информацию в этом сгенерированном ИИ ответе. Это требует дополнительного уровня оптимизации, ориентированного на машинную читаемость, контекстную глубину и доказуемую авторитетность — аспекты, выходящие за рамки традиционной оптимизации ключевых слов.
Фрагментация терминологии — это не просто семантическая дискуссия; это симптом сдвига парадигмы на ранних стадиях. Различные аббревиатуры отражают разные точки зрения, стремящиеся определить новую область — от технической (AIO, LLMO) до маркетинговой (GEO, AEO). Эта неоднозначность и отсутствие четко установленного стандарта создают стратегическое окно возможностей. В то время как более крупные, разрозненные организации все еще обсуждают терминологию и стратегию, более гибкие компании могут перенять основные принципы машиночитаемого, авторитетного контента и обеспечить себе значительное преимущество первопроходца. Нынешняя неопределенность — это не барьер, а возможность.
Сравнение дисциплин оптимизации
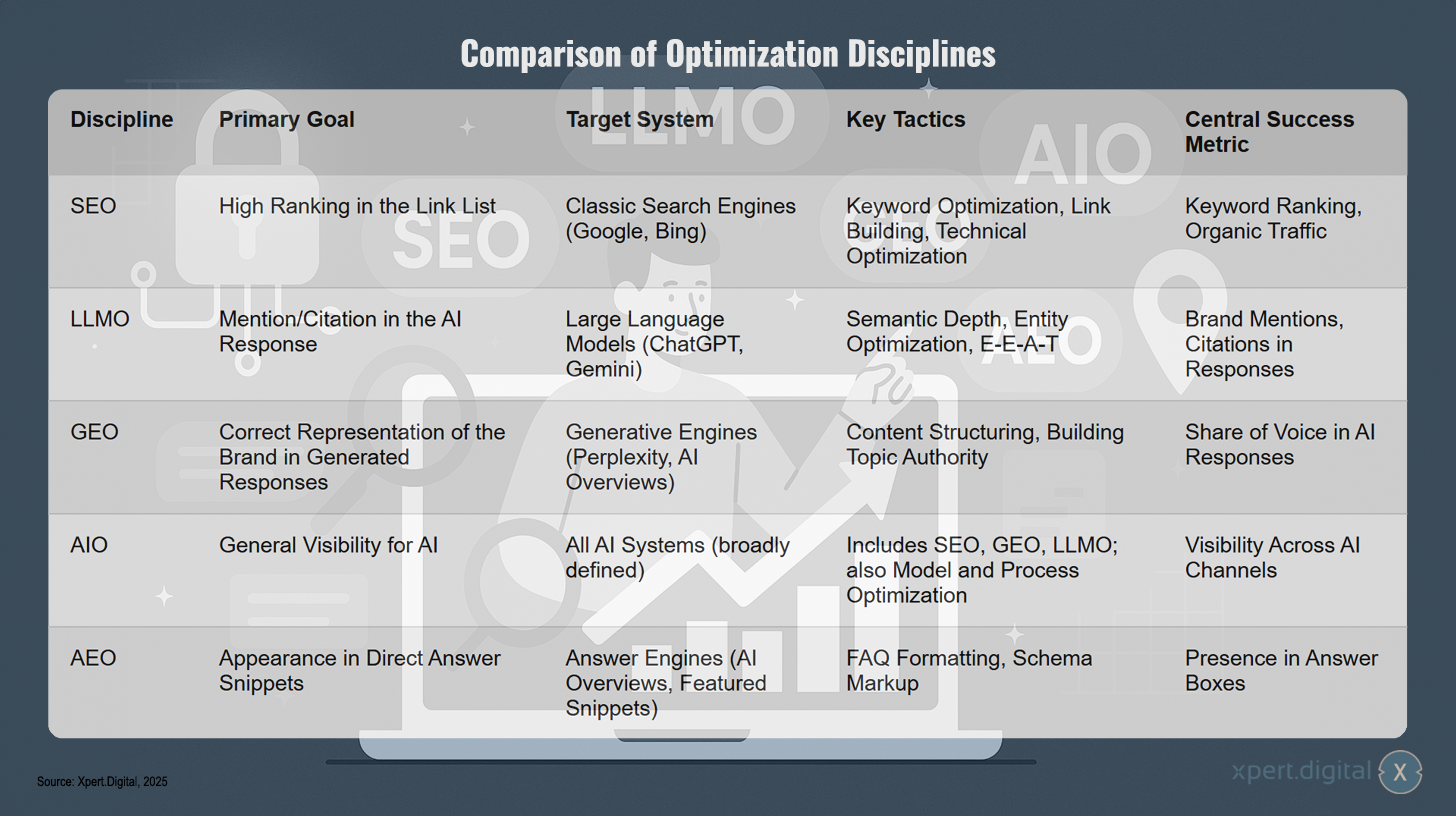
Сравнение методов оптимизации – Изображение: Xpert.Digital
Различные дисциплины оптимизации преследуют разные цели и стратегии. SEO фокусируется на достижении высоких позиций в традиционных поисковых системах, таких как Google и Bing, за счет оптимизации ключевых слов, построения ссылок и технических улучшений, а успех измеряется позициями по ключевым словам и органическим трафиком. LLMO, с другой стороны, стремится к упоминанию или цитированию в ответах ИИ от крупных языковых моделей, таких как ChatGPT или Gemini, используя семантическую глубину, оптимизацию сущностей и факторы EEAT — успех отражается в упоминаниях и цитированиях бренда. GEO стремится к правильному представлению бренда в ответах, генерируемых такими поисковыми системами, как Perplexity или AI Overviews, уделяя приоритетное внимание структурированию контента и повышению авторитета темы, а доля голоса в ответах ИИ служит мерой успеха. AIO преследует наиболее всеобъемлющую цель: общую видимость во всех системах ИИ. Она объединяет SEO, GEO и LLMO с дополнительной оптимизацией моделей и процессов, измеряемой видимостью в различных каналах ИИ. В конечном итоге, AEO фокусируется на появлении в прямых фрагментах ответов из поисковых систем посредством форматирования часто задаваемых вопросов и разметки схемы, при этом присутствие в блоках ответов определяет успех.
«Двигатель»: анализ технологий, лежащих в основе поиска с использованием искусственного интеллекта
Для эффективной оптимизации контента для систем искусственного интеллекта необходимо фундаментальное понимание лежащих в его основе технологий. Эти системы — не волшебные «чёрные ящики», а основаны на конкретных технических принципах, определяющих их функциональность и, следовательно, требования к обрабатываемому контенту.
Большие языковые модели (БЯМ): основные механизмы
Генеративный ИИ фокусируется на больших языковых моделях (LLM).
- Предварительное обучение на больших массивах данных: LLM-модели обучаются на огромных текстовых массивах данных, полученных из таких источников, как Википедия, весь общедоступный интернет (например, через набор данных Common Crawl) и цифровые книжные коллекции. Анализируя триллионы слов, эти модели изучают статистические закономерности, грамматические структуры, фактические знания и семантические связи в человеческом языке.
- Проблема ограничения знаний: важнейшим ограничением LLM является то, что их знания заморожены на уровне обучающих данных. У них есть так называемая «дата ограничения знаний», и они не могут получить доступ к информации, созданной после этой даты. LLM, обученный до 2023 года, не знает, что произошло вчера. Это фундаментальная проблема, которую необходимо решить для поисковых приложений.
- Токенизация и вероятностная генерация: LLM-ы не обрабатывают текст пословно, а разбивают его на более мелкие единицы, называемые «токенами». Их основная функция — предсказать наиболее вероятный следующий токен на основе существующего контекста, тем самым последовательно генерируя связный текст. Они представляют собой высокоразвитые статистические системы распознавания образов и не обладают человеческим сознанием или пониманием.
Генерация с расширенными возможностями поиска (Retrieval-Augmented Generation, RAG): мост к веб-пространству в реальном времени
Технология Retrieval-Augmented Generation (RAG) — это ключевая технология, позволяющая моделям на основе линейных языков функционировать как современные поисковые системы. Она устраняет разрыв между статическими, предварительно обученными знаниями модели и динамической информацией интернета.
Процесс RAG можно разделить на четыре этапа:
- Запрос: Пользователь задает системе вопрос.
- Поиск: Вместо немедленного ответа система активирует компонент «поиска». Этот компонент, часто представляющий собой семантическую поисковую систему, осуществляет поиск в внешней базе знаний — как правило, в индексе крупной поисковой системы, такой как Google или Bing, — документов, релевантных запросу. Именно здесь становится очевидной важность высоких позиций в традиционной SEO-оптимизации: контент, занимающий высокие позиции в классических результатах поиска, с большей вероятностью будет найден системой RAG и выбран в качестве потенциального источника.
- Расширение: из полученных документов извлекается наиболее релевантная информация, которая добавляется к исходному запросу пользователя в качестве дополнительного контекста. Это создает «обогащенный запрос».
- Генерация: Этот расширенный запрос передается в LLM. Теперь модель генерирует свой ответ, который основывается не только на устаревших знаниях, полученных в ходе обучения, но и на актуальных, извлеченных фактах.
Этот процесс снижает риск «галлюцинаций» (выдумывания фактов), позволяет указывать источники и гарантирует, что ответы будут более актуальными и фактически точными.
Семантический поиск и векторные представления: язык искусственного интеллекта
Чтобы понять, как работает этап «Извлечение» в RAG, необходимо понимать концепцию семантического поиска.
- От ключевых слов к смыслу: Традиционный поиск основан на сопоставлении ключевых слов. Семантический поиск, с другой стороны, направлен на понимание намерения и контекста запроса. Например, поиск по запросу «теплые зимние перчатки» может также выдать результаты по запросу «шерстяные варежки», поскольку система распознает семантическую связь между этими понятиями.
- В основе механизма лежат векторные представления: технической базой для этого являются векторные представления. Специальная «модель встраивания» преобразует текстовые единицы (слова, предложения, целые документы) в числовое представление – вектор в многомерном пространстве.
- Пространственная близость как семантическое сходство: в этом векторном пространстве семантически схожие понятия представлены точками, расположенными близко друг к другу. Вектор, представляющий «короля», имеет такое же отношение к вектору «королевы», как вектор «мужчины» к вектору «женщины».
- Применение в процессе RAG: Запрос пользователя также преобразуется в вектор. Затем система RAG выполняет поиск в своей базе данных векторов, чтобы найти векторы документов, наиболее близкие к вектору запроса. Таким образом, извлекается наиболее семантически релевантная информация для обогащения запроса.
Модели мышления и мыслительные процессы: следующий этап эволюции
В авангарде развития LLM находятся так называемые когнитивные модели, которые обещают еще более продвинутую форму обработки информации.
- Выходя за рамки простых ответов: в то время как стандартные логические модели мышления генерируют ответ за один проход, модели мышления разбивают сложные проблемы на ряд логических промежуточных шагов, так называемую «цепочку мыслей».
- Как это работает: Эти модели обучаются с помощью обучения с подкреплением, где успешные многоэтапные пути решения вознаграждаются. По сути, они «думают вслух» внутри себя, формулируя и отбрасывая различные подходы, прежде чем прийти к окончательному, часто более надежному и точному ответу.
- Последствия для оптимизации: Хотя эта технология все еще находится на начальной стадии развития, она предполагает, что будущие поисковые системы смогут обрабатывать гораздо более сложные и многогранные запросы. Контент, предлагающий четкие, логичные пошаговые инструкции, подробные описания процессов или хорошо структурированные цепочки рассуждений, идеально подходит для использования этими продвинутыми моделями в качестве высококачественного источника информации.
Технологическая архитектура современных поисковых систем на основе ИИ — сочетание LLM, RAG и семантического поиска — создает мощную, самоподдерживающуюся петлю обратной связи между «старой сетью» ранжированных страниц и «новой сетью» ответов, сгенерированных ИИ. Высококачественный, авторитетный контент, хорошо работающий в традиционном SEO, индексируется и ранжируется на высоком уровне. Высокий рейтинг делает его идеальным кандидатом для поиска системами RAG. Когда ИИ ссылается на этот контент, он еще больше укрепляет свой авторитет, что может привести к повышению вовлеченности пользователей, увеличению количества обратных ссылок и, в конечном итоге, к еще более сильным сигналам традиционного SEO. Это создает «благотворный круг авторитета». И наоборот, низкокачественный контент игнорируется как традиционными поисковыми системами, так и системами RAG, становясь все более незаметным. Таким образом, разрыв между «имущими» и «неимущими» в цифровом пространстве будет экспоненциально увеличиваться. Стратегический вывод заключается в том, что инвестиции в фундаментальное SEO и наращивание авторитета контента больше не сосредоточены исключительно на ранжировании; Они обеспечивают себе постоянное место за столом переговоров в контексте будущего синтеза информации, основанного на искусственном интеллекте.
🎯🎯🎯 Воспользуйтесь обширным пятисторонним опытом Xpert.Digital в одном комплексном пакете услуг | Развитие бизнеса, НИОКР, XR, PR и оптимизация цифровой видимости
Воспользуйтесь обширным пятисторонним опытом Xpert.Digital в рамках комплексного пакета услуг | НИОКР, XR, PR и оптимизация цифровой видимости - Изображение: Xpert.Digital
Компания Xpert.Digital обладает глубокими знаниями в различных отраслях. Это позволяет нам разрабатывать индивидуальные стратегии, точно соответствующие требованиям и задачам вашего конкретного сегмента рынка. Благодаря постоянному анализу рыночных тенденций и мониторингу отраслевых разработок мы можем действовать на опережение и предлагать инновационные решения. Сочетание опыта и экспертных знаний создает добавленную стоимость и обеспечивает нашим клиентам решающее конкурентное преимущество.
Более подробная информация здесь:
Формирование цифрового авторитета: почему традиционного SEO больше недостаточно для поисковых систем, использующих искусственный интеллект
Три столпа оптимизации генеративного движка
Технические знания, полученные в Части I, формируют основу для конкретной, действенной стратегической модели. Для достижения успеха в новой эре поиска с использованием ИИ усилия по оптимизации должны опираться на три центральных столпа: стратегический контент для машинного понимания, передовая техническая оптимизация для краулеров ИИ и проактивное управление цифровым авторитетом.
В связи с этим:

Первый столп: Стратегическое содержание для машинного понимания
Способ создания и структурирования контента нуждается в коренных изменениях. Цель состоит уже не только в том, чтобы убедить читателя-человека, но и в том, чтобы предоставить машине наилучшую основу для извлечения и синтеза информации.
Авторитетность темы как новая граница
В стратегии контент-маркетинга акцент смещается с оптимизации отдельных ключевых слов на формирование всестороннего тематического авторитета.
- Создание центров знаний: вместо создания отдельных статей по ключевым словам, цель состоит в создании целостных «тематических кластеров». Они состоят из центральной, всеобъемлющей «основной статьи», охватывающей широкую тему, и многочисленных связанных между собой подстатьь, посвященных конкретным нишевым аспектам и детальным вопросам. Такая структура сигнализирует системам искусственного интеллекта о том, что веб-сайт является авторитетным и исчерпывающим источником информации по конкретной предметной области.
- Комплексный охват: LLM-системы обрабатывают информацию в семантическом контексте. Веб-сайт, который всесторонне освещает тему, включая все соответствующие аспекты, вопросы пользователей и связанные понятия, повышает вероятность того, что ИИ будет использовать его в качестве основного источника. Система находит всю необходимую информацию в одном месте и ей не приходится собирать ее по крупицам из множества менее полных источников.
- Практическое применение: Исследование ключевых слов больше не используется для поиска отдельных поисковых запросов, а для составления карты всего спектра вопросов, подвопросов и связанных тем, относящихся к ключевой области компетенции.
EEAT как алгоритмический сигнал
Концепция EEAT (Experience, Expertise, Authoritativeness, Trustworthiness) от Google эволюционирует от простого руководства для экспертов по оценке качества до набора машиночитаемых сигналов, используемых для оценки источников контента.
Стратегическое построение доверия: Компании должны активно внедрять и отображать эти сигналы на своих веб-сайтах:
- Опыт и квалификация: Авторы должны быть четко указаны, в идеале с подробными биографиями, демонстрирующими их квалификацию и практический опыт. Содержание должно предлагать уникальные идеи из реальной практики, выходящие за рамки простого изложения фактов.
- Авторитетность: Создание контекстно релевантных обратных ссылок с других авторитетных веб-сайтов по-прежнему имеет важное значение. Однако упоминания бренда в авторитетных источниках, на которые нет ссылок, также приобретают все большее значение.
- Достоверность: Четкая и легкодоступная контактная информация, ссылки на авторитетные источники, публикация оригинальных данных или исследований, а также регулярное обновление и корректировка контента являются важнейшими признаками доверия.
Контент-стратегия, основанная на сущностях: оптимизация для объектов, а не для строк
Современные поисковые системы основывают свое понимание мира на «графе знаний». Этот граф состоит не из слов, а из реальных объектов (людей, мест, брендов, концепций) и связей между ними.
- Повышение статуса вашего бренда до уровня отдельной сущности: Стратегическая цель состоит в том, чтобы позиционировать ваш бренд как четко определенную и узнаваемую сущность в рамках этой структуры, однозначно связанную с конкретной областью деятельности. Это достигается за счет последовательного именования, использования структурированных данных (см. раздел 4) и частого совместного появления с другими релевантными сущностями.
- Практическое применение: контент должен быть структурирован вокруг четко определенных сущностей. Важные технические термины можно пояснить в глоссариях или блоках с определениями. Ссылки на признанные источники сущностей, такие как Википедия или Викиданные, могут помочь Google установить правильные связи и укрепить тематическую классификацию.
Искусство создания сниппетов: структурирование контента для прямого извлечения
Контент должен быть отформатирован таким образом, чтобы машины могли легко его разбирать и использовать повторно.
- Оптимизация на уровне фрагментов текста: системы искусственного интеллекта часто извлекают не целые статьи, а отдельные, идеально сформулированные «фрагменты» или разделы — абзац, элемент списка, строку таблицы — для ответа на конкретную часть запроса. Поэтому веб-сайт следует проектировать как набор таких легко извлекаемых фрагментов информации.
- Передовые методы структурного проектирования:
- Написание текста с сначала ответа: Абзацы должны начинаться с краткого, прямого ответа на неявный вопрос, за которым следуют пояснительные детали.
- Использование списков и таблиц: Сложную информацию следует представлять в виде перечислений, нумерованных списков и таблиц, поскольку эти форматы особенно легко обрабатываются системами искусственного интеллекта.
- Стратегическое использование заголовков: Четкие, описательные заголовки H2 и H3, часто сформулированные в виде вопросов, должны логически структурировать содержание. Каждый раздел должен быть посвящен одной конкретной идее.
- Раздел часто задаваемых вопросов (FAQ) идеально подходит, поскольку он напрямую отражает разговорный формат вопросов и ответов в чатах с использованием ИИ.
Мультимодальность и естественный язык
- Разговорный тон: контент должен быть написан в естественном, человеческом стиле. Модели ИИ обучаются на аутентичном человеческом языке и предпочитают тексты, которые читаются как настоящий разговор.
- Оптимизация визуального контента: Современный ИИ также способен обрабатывать визуальную информацию. Поэтому изображениям необходимы содержательные альтернативные тексты и подписи. Видеоролики должны сопровождаться расшифровками. Это делает мультимедийный контент индексируемым и пригодным для цитирования в целях искусственного интеллекта.
Сближение этих контентных стратегий — авторитетность темы, EEAT, оптимизация сущностей и структурирование сниппетов — приводит к глубокому пониманию: наиболее эффективный контент для ИИ одновременно является наиболее полезным, понятным и заслуживающим доверия контентом для людей. Эпоха «писания для алгоритма», которая часто приводила к неестественно звучащим текстам, подходит к концу. Новый алгоритм требует лучших практик, ориентированных на человека. Стратегический вывод заключается в том, что инвестиции в подлинную экспертизу, высококачественное письмо, четкий информационный дизайн и прозрачные ссылки на источники — это уже не просто «хорошая практика», а наиболее прямая и устойчивая форма технической оптимизации для генеративной эпохи.
Второй компонент: Усовершенствованная техническая оптимизация для веб-краулеров на основе ИИ
В то время как стратегическое содержание определяет «что» нужно оптимизировать, техническая оптимизация обеспечивает «как» — она гарантирует, что системы искусственного интеллекта смогут получить доступ к этому контенту, интерпретировать его и правильно обрабатывать. Без прочной технической основы даже самый лучший контент останется незаметным.
Техническая SEO-оптимизация: сохраняющаяся важность ключевых показателей
Основы технической поисковой оптимизации актуальны не только для GEO, но и приобретают все большее значение.
- Доступность для сканирования и индексации: это абсолютно фундаментально. Если краулер на основе ИИ — будь то известный Googlebot или специализированные боты, такие как ClaudeBot и GPTBot — не может получить доступ к странице или отобразить её, значит, для системы ИИ она не существует. Необходимо обеспечить, чтобы соответствующие страницы возвращали HTTP-статус-код 200 и не блокировались (непреднамеренно) файлом robots.txt.
- Скорость загрузки страниц и время рендеринга: веб-краулеры с искусственным интеллектом часто работают с очень короткими окнами рендеринга страницы, иногда всего 1-5 секунд. Медленно загружаемые страницы, особенно те, которые содержат много JavaScript-кода, рискуют быть пропущены или обработаны лишь частично. Поэтому оптимизация основных параметров веб-поиска и общей скорости загрузки страниц имеет решающее значение.
- Рендеринг JavaScript: Хотя поисковый робот Google теперь очень хорошо справляется с рендерингом страниц, интенсивно использующих JavaScript, это не относится ко многим другим поисковым роботам на основе искусственного интеллекта. Для обеспечения универсальной доступности критически важный контент должен быть уже включен в исходный HTML-код страницы, а не загружаться на стороне клиента.
Стратегическая задача Schema.org: создать сетевую диаграмму знаний
Schema.org — это стандартизированный словарь для структурированных данных. Он позволяет владельцам веб-сайтов явно указывать поисковым системам, о чём их контент и как связаны различные фрагменты информации. Веб-сайт, размеченный с помощью Schema, по сути, становится машиночитаемой базой данных.
- Почему схема данных имеет решающее значение для ИИ: Структурированные данные устраняют неоднозначность. Они позволяют системам ИИ с высокой степенью достоверности извлекать такие факты, как цены, даты, местоположения, рейтинги или пошаговые инструкции. Это делает контент гораздо более надежным источником для генерации ответов, чем неструктурированный текст.
- Основные типы схем для GEO:
- Организация и личность: Четко определить собственный бренд и авторов как субъектов.
- FAQPage и HowTo: Для структурирования контента с прямыми ответами и пошаговыми инструкциями, которые предпочитают системы искусственного интеллекта.
- Статья: Для передачи важных метаданных, таких как автор и дата публикации, с целью усиления сигналов EEAT.
- Продукт: Для электронной коммерции крайне важно сделать данные о ценах, наличии товаров и рейтингах машиночитаемыми.
- Рекомендации по оптимизации — Взаимосвязанные сущности: оптимизация должна выходить за рамки простого добавления изолированных блоков схемы. Используя атрибут @id, можно связать различные сущности на странице и на всем веб-сайте (например, связать статью с ее автором и издателем). Это создает целостный внутренний граф знаний, который делает семантические связи явными для машин.
Новый стандарт llms.txt: прямая линия связи с моделями искусственного интеллекта
llms.txt — это предлагаемый новый стандарт, призванный обеспечить прямую и эффективную связь с моделями искусственного интеллекта.
- Назначение и функция: Это простой текстовый файл, написанный в формате Markdown и размещенный в корневом каталоге веб-сайта. Он предоставляет тщательно отобранную «карту» наиболее важного контента веб-сайта, очищенную от отвлекающего HTML, JavaScript и рекламных баннеров. Это делает его чрезвычайно эффективным для моделей искусственного интеллекта в поиске и обработке наиболее релевантной информации.
- Отличие от robots.txt и sitemap.xml: В то время как robots.txt указывает поисковым роботам, какие разделы им не следует посещать, а sitemap.xml предоставляет неаннотированный список всех URL-адресов, llms.txt предлагает структурированное и контекстуализированное руководство по наиболее ценным контентным ресурсам веб-сайта.
- Описание и формат: Файл использует простой синтаксис Markdown. Обычно он начинается с заголовка H1 (заголовок страницы), за которым следует краткое описание в блоке цитат. Заголовки H2 затем группируют списки ссылок на важные ресурсы, такие как документация или руководства. Существуют также варианты, такие как llms-full.txt, которые объединяют все текстовое содержимое веб-сайта в один файл.
- Реализация и инструменты: Создание может осуществляться вручную или с помощью постоянно растущего числа генераторов, таких как FireCrawl, Markdowner, или специализированных плагинов для систем управления контентом, таких как WordPress и Shopify.
- Дискуссия вокруг его принятия: Понимание текущих споров вокруг этого стандарта имеет решающее значение. В официальной документации Google говорится, что такие файлы не являются необходимыми для отображения в обзорах ИИ. Ведущие эксперты Google, такие как Джон Мюллер, выразили скептицизм, сравнивая его полезность с устаревшим метатегом ключевых слов. Однако другие крупные компании, занимающиеся ИИ, такие как Anthropic, уже активно используют этот стандарт на своих веб-сайтах, и его принятие в сообществе разработчиков растет.
Дискуссия вокруг llms.txt и расширенных схем выявляет важнейшее стратегическое противоречие: между оптимизацией для одной доминирующей платформы (Google) и оптимизацией для более широкой, гетерогенной экосистемы ИИ. Полагаться исключительно на рекомендации Google («Вам это не нужно») — рискованная стратегия, которая лишает контроля и потенциальной видимости на других быстрорастущих платформах, таких как ChatGPT, Perplexity и Claude. Наиболее устойчивым подходом является перспективная, «полигамная» стратегия оптимизации, которая придерживается основных принципов Google, одновременно внедряя общеэкосистемные стандарты, такие как llms.txt и комплексные схемы. Она рассматривает Google как основного, но не единственного, машинного потребителя контента компании. Это форма стратегической диверсификации и снижения рисков для цифровых активов компании.
Третий столп: Управление цифровым авторитетом
Возникновение новой дисциплины
Третий и, пожалуй, наиболее стратегически важный столп генеративной оптимизации выходит за рамки простой оптимизации контента и технических аспектов. Он фокусируется на формировании и управлении общим цифровым авторитетом бренда. В мире, где системы искусственного интеллекта пытаются оценить достоверность источников, алгоритмически измеримый авторитет становится важнейшим фактором ранжирования.
Концепция «управления цифровым авторитетом» была в значительной степени сформирована отраслевым экспертом Олафом Коппом и описывает новую, необходимую дисциплину в цифровом маркетинге.
Мост между силосами
В эпоху EEAT и ИИ сигналы, формирующие алгоритмическое доверие — такие как репутация бренда, упоминания в СМИ и авторитет автора — генерируются в рамках деятельности, традиционно осуществляемой отдельными отделами, такими как PR, бренд-маркетинг и социальные сети. SEO само по себе часто оказывает ограниченное влияние на эти области. Управление цифровым авторитетом устраняет этот пробел, объединяя эти усилия с SEO под единым стратегическим руководством.
Главная цель – сознательное и активное развитие узнаваемого в цифровом пространстве и авторитетного бренда, который легко идентифицируется алгоритмами и классифицируется как заслуживающий доверия.
Помимо обратных ссылок: значение упоминаний и их совместного появления
- Упоминания как сигнал: Не связанные с брендом упоминания в авторитетных источниках приобретают огромное значение. Системы искусственного интеллекта собирают эти упоминания со всего интернета, чтобы оценить узнаваемость и репутацию бренда.
- Совместное упоминание и контекст: системы искусственного интеллекта анализируют, какие объекты (бренды, люди, темы) часто упоминаются вместе. Стратегическая цель должна заключаться в создании прочной и устойчивой связи между брендом и его ключевыми компетенциями во всем цифровом пространстве.
Создание узнаваемого в цифровом пространстве бренда
- Последовательность — ключ к успеху: абсолютное единообразие в написании названия бренда, имен авторов и описаний компании на всех цифровых платформах имеет важное значение — от вашего собственного веб-сайта и профилей в социальных сетях до отраслевых справочников. Несоответствия создают неоднозначность для алгоритмов и ослабляют имидж компании.
- Авторитет на разных платформах: Генеративные поисковые системы комплексно оценивают присутствие бренда. Единый стиль и последовательная коммуникация по всем каналам (веб-сайт, LinkedIn, гостевые посты, форумы) укрепляют воспринимаемый авторитет. Ключевой тактикой здесь является повторное использование и адаптация успешного контента для различных форматов и платформ.
Роль цифрового PR и управления репутацией
- Стратегические связи с общественностью: усилия в области цифрового PR должны быть сосредоточены на получении упоминаний в изданиях, которые не только актуальны для целевой аудитории, но и классифицируются моделями искусственного интеллекта как авторитетные источники.
- Управление репутацией: крайне важно активно продвигать и отслеживать положительные отзывы на авторитетных платформах. Не менее важно активное участие в соответствующих дискуссиях на таких платформах, как Reddit и Quora, поскольку системы искусственного интеллекта часто используют их в качестве источников достоверных мнений и опыта.
Новая роль SEO
- Управление цифровым авторитетом коренным образом меняет роль SEO в организации. Оно поднимает SEO с тактического уровня, ориентированного на оптимизацию одного канала (веб-сайта), на стратегический уровень, отвечающий за координацию всего цифрового присутствия компании для алгоритмической интерпретации.
- Это подразумевает значительные изменения в организационной структуре и необходимых навыках. «Менеджер по цифровому авторитету» — это новая гибридная роль, сочетающая аналитическую точность SEO с навыками построения повествования и отношений, присущими бренд-стратегу и PR-специалисту. Компании, которым не удастся создать эту интегрированную функцию, обнаружат, что их разрозненные цифровые сигналы не смогут конкурировать с конкурентами, которые представляют единый, авторитетный образ для систем искусственного интеллекта.
Закупки B2B: цепочки поставок, торговля, торговые площадки и поиск поставщиков на основе искусственного интеллекта
Закупки B2B: цепочки поставок, торговля, торговые площадки и поиск поставщиков на основе ИИ с ACCIO.com - Изображение: Xpert.Digital
Более подробная информация здесь:
От SEO к GEO: новые метрики для измерения успеха в эпоху искусственного интеллекта
Конкурентная среда и оценка эффективности
После определения стратегических направлений оптимизации акцент смещается на практическое применение в условиях современной конкуренции. Это требует анализа наиболее важных платформ поиска с использованием ИИ на основе данных, а также внедрения новых методов и инструментов для измерения производительности.
В связи с этим:
Деконструкция выбора источников: сравнительный анализ
Различные платформы поиска с использованием ИИ работают по-разному. Они используют разные источники данных и алгоритмы для получения результатов. Понимание этих различий имеет решающее значение для определения приоритетов в мерах по оптимизации. Приведенный ниже анализ основан на обобщении ведущих отраслевых исследований, в частности, всестороннего исследования SE Ranking, дополненного качественным анализом и документацией по конкретным платформам.
Обзор Google AI: Преимущества устоявшейся системы
- Профиль источника: Google придерживается довольно консервативного подхода. Обзоры ИИ в значительной степени опираются на существующий Граф знаний, устоявшиеся сигналы EEAT и лучшие органические результаты поиска. Исследования показывают значительную, хотя и не полную, корреляцию с 10 лучшими позициями в традиционном поиске.
- Статистические данные: Google приводит в среднем 9,26 ссылок на каждый ответ и демонстрирует высокое разнообразие: в проанализированном исследовании представлено 2909 уникальных доменов. Наблюдается явное предпочтение более старым, устоявшимся доменам (49% цитируемых доменов старше 15 лет), в то время как очень молодые домены рассматриваются реже.
- Стратегическое значение: Успех в обзорах Google AI неразрывно связан с сильным, традиционным авторитетом в области SEO. Это экосистема, где успех порождает дальнейший успех.
ChatGPT Search: конкурент, ориентированный на пользовательский контент и Bing
- Профиль источника: ChatGPT использует индекс Microsoft Bing для веб-поиска, но применяет собственную логику для фильтрации и сортировки результатов. Платформа явно отдает предпочтение контенту, созданному пользователями (UGC), особенно с YouTube, который является одним из наиболее часто цитируемых источников, а также сообществам на таких платформах, как Reddit.
- Данные показывают, что ChatGPT приводит наибольшее количество ссылок (в среднем 10,42) и упоминает наибольшее число уникальных доменов (4034). В то же время платформа демонстрирует самый высокий показатель множественных упоминаний одного и того же домена в одном ответе (71%), что указывает на целесообразность стратегии углубленного анализа с использованием одного надежного источника.
- Стратегическое значение: Для повышения видимости в ChatGPT необходима многоплатформенная стратегия, включающая не только оптимизацию для индекса Bing, но и активное создание присутствия на важных платформах с пользовательским контентом.
Perplexity.ai: Прозрачный исследователь в режиме реального времени
- Профиль источника: Perplexity разработан для выполнения веб-поиска в реальном времени по каждому запросу, обеспечивая актуальность информации. Платформа отличается высокой прозрачностью и предоставляет четкие ссылки на источники в своих ответах. Уникальной особенностью является функция «Фокус», которая позволяет пользователям ограничить поиск заранее определенным набором источников (например, только научные статьи, Reddit или определенные веб-сайты).
- Данные показывают: выбор источников очень последователен; почти все ответы содержат ровно 5 ссылок. Ответы Perplexity демонстрируют наибольшее семантическое сходство с ответами ChatGPT (0,82), что указывает на схожие предпочтения в выборе контента.
- Стратегический вывод: ключ к успеху на Perplexity заключается в том, чтобы стать «целевым источником» — веб-сайтом, настолько авторитетным, что пользователи сознательно включают его в свои целенаправленные поисковые запросы. Работа платформы в режиме реального времени также поощряет особенно актуальный и фактически точный контент.
Различные стратегии поиска поставщиков на основных платформах ИИ создают новую форму «алгоритмического арбитража». Бренд, изо всех сил пытающийся закрепиться в высококонкурентной, основанной на авторитете экосистеме Google AI Overview, может найти более простой путь к видимости через ChatGPT, сосредоточившись на SEO для Bing и активном присутствии на YouTube и Reddit. Аналогично, узкоспециализированный эксперт может обойти основных конкурентов, став важным источником для целевых поисковых запросов на Perplexity. Стратегический вывод заключается не в том, чтобы сражаться на каждом фронте, а в том, чтобы проанализировать различные «барьеры для входа» на каждой платформе ИИ и согласовать усилия по созданию контента и наращиванию авторитета с платформой, которая наилучшим образом соответствует сильным сторонам бренда.
Сравнительный анализ платформ поиска на основе искусственного интеллекта
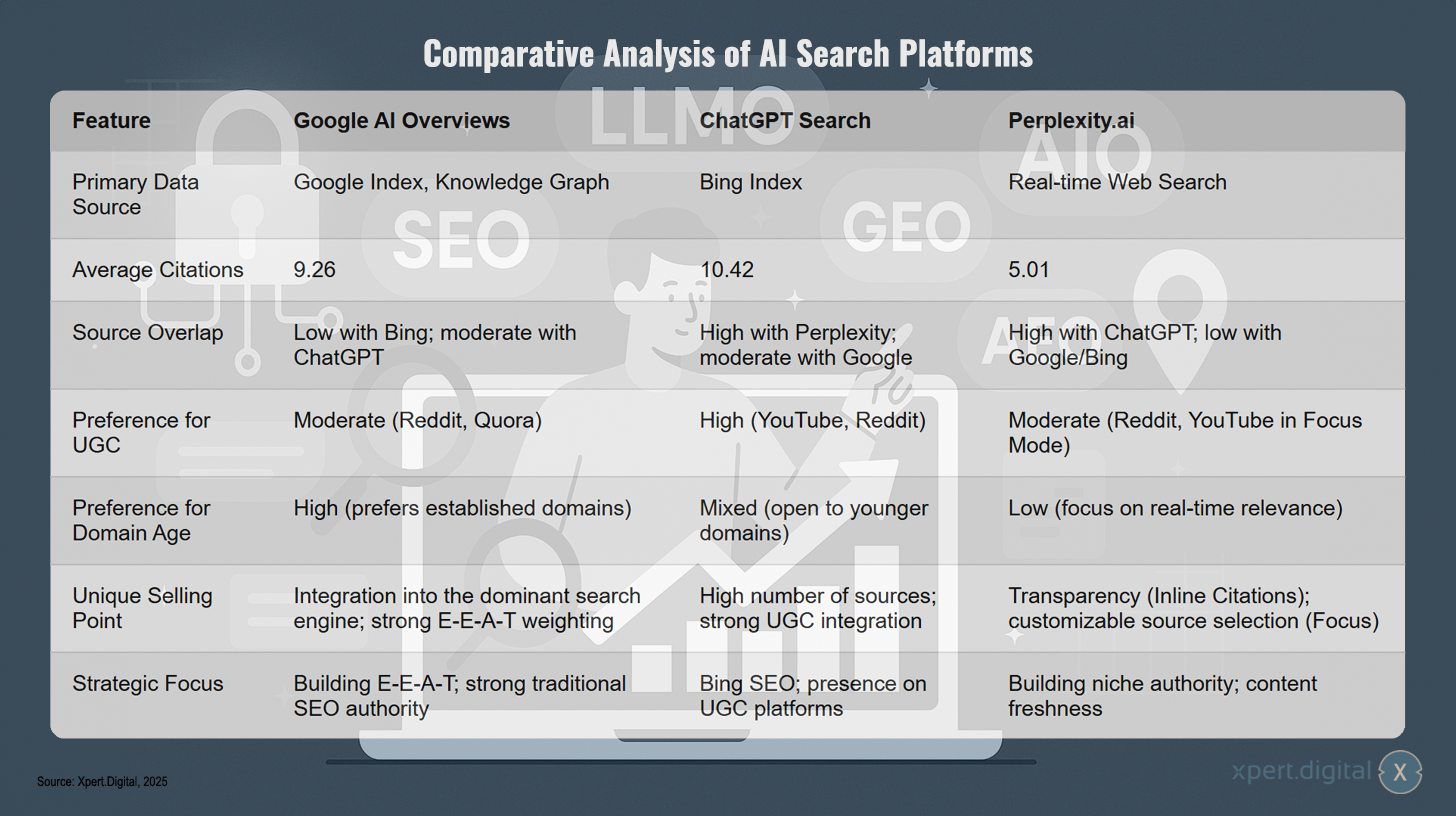
Сравнительный анализ платформ поиска с использованием ИИ – Изображение: Xpert.Digital
Сравнительный анализ платформ поиска на основе ИИ выявляет существенные различия между Google AI Overviews, ChatGPT Search и Perplexity.ai. Google AI Overviews использует Google Index и Knowledge Graph в качестве основного источника данных, выдает в среднем 9,26 упоминаний и демонстрирует низкое совпадение источников с Bing и умеренное совпадение с ChatGPT. Платформа проявляет умеренное предпочтение к контенту, создаваемому пользователями, такому как Reddit и Quora, но отдает предпочтение хорошо зарекомендовавшим себя, более старым доменам. Ее уникальное преимущество заключается в интеграции с доминирующей поисковой системой и сильном акценте на ранжировании EEAT (Ever After Appearance), со стратегическим упором на повышение EEAT и укрепление традиционного авторитета в SEO.
ChatGPT Search использует индекс Bing в качестве основного источника данных и генерирует наибольшее количество упоминаний, в среднем 10,42. Платформа демонстрирует высокую степень пересечения с Perplexity и умеренное пересечение с Google. Особо следует отметить ее явное предпочтение пользовательскому контенту, особенно с YouTube и Reddit. Оценка возраста доменов показывает смешанные результаты, с явным предпочтением более молодых доменов. Ее уникальное преимущество заключается в большом количестве упоминаний и сильной интеграции с пользовательским контентом, в то время как ее стратегическая направленность сосредоточена на SEO для Bing и присутствии на платформах с пользовательским контентом.
Perplexity.ai выделяется тем, что использует поиск в реальном времени в качестве основного источника данных и предоставляет наименьшее количество цитирований — в среднем 5,01. Пересечение источников велико с ChatGPT, но низкое с Google и Bing. Платформа демонстрирует умеренное предпочтение пользовательскому контенту, отдавая предпочтение Reddit и YouTube в режиме Focus. Возраст домена играет незначительную роль из-за ориентации на релевантность в реальном времени. Уникальные преимущества Perplexity.ai включают прозрачность благодаря встроенным цитированиям и настраиваемый выбор источников с помощью функции Focus. Стратегический фокус компании — на создании авторитета в нише и обеспечении актуальности контента.
Новая аналитика: измерение и мониторинг видимости LLM
Переход от поисковой оптимизации к оптимизации на основе отклика требует фундаментальной корректировки методов измерения успеха. Традиционные SEO-метрики теряют свою актуальность, когда клики по сайту перестают быть основной целью. Необходимы новые метрики и инструменты для количественной оценки влияния и присутствия бренда в среде генеративного искусственного интеллекта.
Сдвиг парадигмы в измерении: от кликов к влиянию
- Старые метрики: Успех традиционного SEO оценивается в первую очередь по непосредственно измеримым показателям, таким как позиции ключевых слов в поисковой выдаче, органический трафик и коэффициент кликабельности (CTR).
- Новые показатели: успех GEO/LLMO будет измеряться показателями влияния и присутствия, которые зачастую носят косвенный характер:
- Показатель видимости бренда LLM / упоминания бренда: измеряет, как часто бренд упоминается в соответствующих ответах ИИ. Это наиболее важный новый показатель.
- Доля голоса / Доля модели: Количественно определяет процент упоминаний собственного бренда по сравнению с конкурентами для определенной группы поисковых запросов (подсказок).
- Цитирования: Отслеживает, как часто ваш собственный веб-сайт упоминается в качестве источника.
- Анализ настроения и качества упоминаний: оценивается тон (позитивный, нейтральный, негативный) и фактическая точность упоминаний.
Новый набор инструментов: платформы для отслеживания упоминаний ИИ
- Как это работает: Эти инструменты автоматически и в больших масштабах запрашивают информацию у различных моделей ИИ с помощью заранее определенных запросов. Они регистрируют, какие бренды и источники фигурируют в ответах, анализируют тональность и отслеживают динамику изменений во времени.
- Ведущие инструменты: Рынок молодой и фрагментированный, но уже зарекомендовало себя несколько специализированных платформ. К ним относятся такие инструменты, как Profound, Peec.ai, RankScale и Otterly.ai, которые различаются по набору функций и целевой аудитории (от малых и средних предприятий до крупных корпораций).
- Адаптация традиционных инструментов: признанные поставщики программного обеспечения для мониторинга бренда (например, Sprout Social, Mention) и комплексных SEO-пакетов (например, Semrush, Ahrefs) также начинают интегрировать функции анализа видимости с помощью ИИ в свои продукты.
Устранение разрыва в атрибуции: интеграция аналитики LLM в отчетность
Одна из самых больших проблем — это установление связи между бизнес-результатами и упоминанием в ответе ИИ, поскольку это часто не приводит к прямому переходу по ссылке. Необходим многоэтапный метод анализа:
- Отслеживание реферального трафика: Первый и самый простой шаг — анализ прямого реферального трафика с платформ ИИ с помощью инструментов веб-аналитики, таких как Google Analytics 4. Создавая пользовательские группы каналов на основе источников реферального трафика (например, perplexity.ai, bing.com для поиска в ChatGPT), можно выделить и оценить этот трафик.
- Мониторинг косвенных сигналов: более продвинутый подход включает корреляционный анализ. Аналитикам необходимо отслеживать тенденции в косвенных показателях, таких как увеличение прямого трафика на веб-сайт и рост количества брендовых поисковых запросов в Google Search Console. Затем эти тенденции необходимо сопоставить с развитием видимости LLM, измеряемым с помощью новых инструментов мониторинга.
- Анализ логов ботов: Для технически подкованных команд анализ файлов журналов сервера предоставляет ценную информацию. Выявляя и отслеживая действия краулеров ИИ (например, GPTBot, ClaudeBot), можно определить, какие страницы используются системами ИИ для сбора информации.
Разработка ключевых показателей эффективности
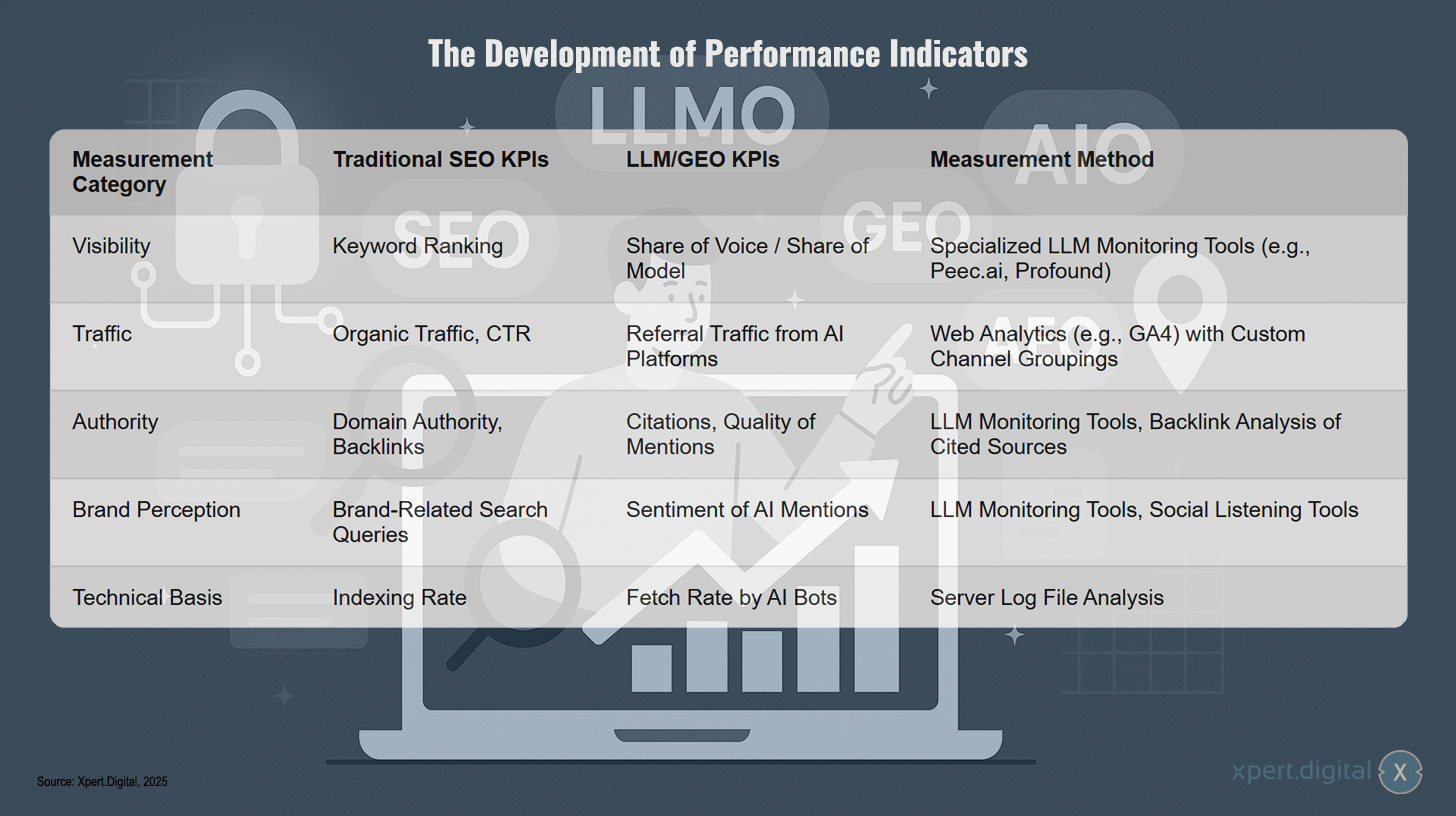
Разработка ключевых показателей эффективности – Изображение: Xpert.Digital
Эволюция ключевых показателей эффективности (KPI) демонстрирует явный сдвиг от традиционных SEO-метрик к метрикам, основанным на искусственном интеллекте. Видимость смещается от классического ранжирования по ключевым словам к доле голоса и доле модели, измеряемым специализированными инструментами мониторинга LLM, такими как Peec.ai или Profound. Что касается трафика, то реферальный трафик с платформ ИИ дополняет органический трафик и коэффициент кликабельности (CTR), при этом инструменты веб-аналитики, такие как Google Analytics 4 (GA4), используют пользовательские группы каналов. Авторитет веб-сайта больше не определяется исключительно авторитетом домена и обратными ссылками, но также включает цитирования и качество упоминаний в системах ИИ, измеряемые с помощью инструментов мониторинга LLM и анализа обратных ссылок цитируемых источников. Восприятие бренда расширяется от поисковых запросов, связанных с брендом, до включения тональности упоминаний ИИ, фиксируемой инструментами мониторинга LLM и инструментами социального мониторинга. На техническом уровне, помимо традиционного показателя индексации, существует показатель извлечения ботами ИИ, который определяется с помощью анализа файлов журналов сервера.
Передовые инструменты мониторинга и анализа GEO/LLMO
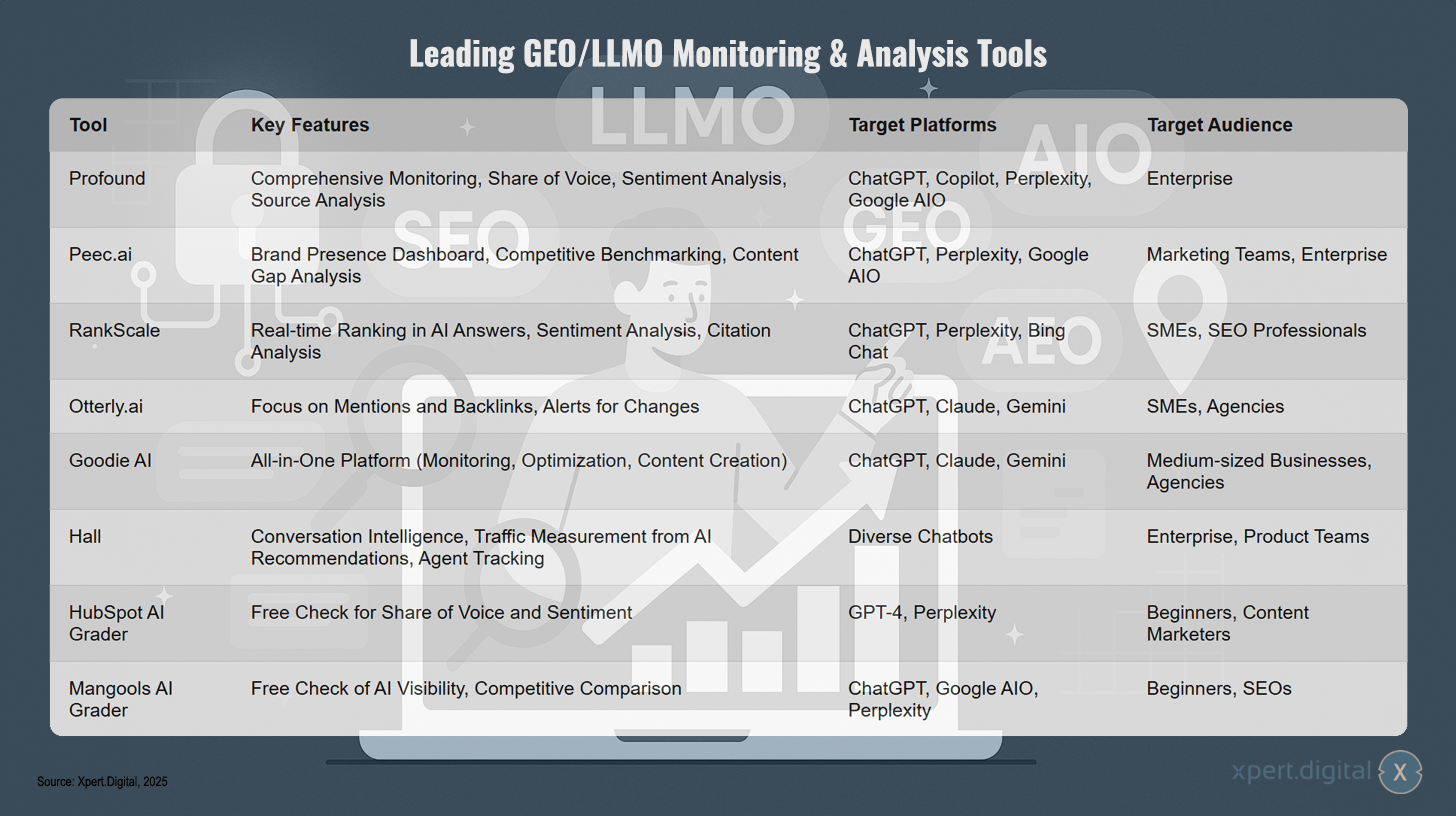
Передовые инструменты мониторинга и анализа GEO/LLMO – Изображение: Xpert.Digital
На рынке ведущих инструментов мониторинга и аналитики GEO/LLMO представлен широкий выбор специализированных решений для различных целевых групп. Profound — это комплексное корпоративное решение, обеспечивающее мониторинг, анализ доли голоса, анализ настроений и анализ источников для ChatGPT, Copilot, Perplexity и Google AIO. Peec.ai также ориентирован на маркетинговые команды и корпоративных клиентов, предлагая панель мониторинга присутствия бренда, сравнительный анализ конкурентов и анализ пробелов в контенте для ChatGPT, Perplexity и Google AIO.
Для малых и средних предприятий (МСП) и SEO-специалистов RankScale предлагает анализ ранжирования в реальном времени на основе ответов, сгенерированных ИИ, анализ настроений и анализ цитирований на платформах ChatGPT, Perplexity и Bing Chat. Otterly.ai фокусируется на упоминаниях и обратных ссылках с оповещениями об изменениях и обслуживает МСП и агентства через ChatGPT, Claude и Gemini. Goodie AI позиционирует себя как универсальная платформа для мониторинга, оптимизации и создания контента на одних и тех же платформах и ориентирована на МСП и агентства.
Hall предлагает специализированное решение для корпоративных и продуктовых команд, включающее анализ диалогов, измерение трафика на основе рекомендаций ИИ и отслеживание действий агентов для различных чат-ботов. Для начинающих доступны бесплатные инструменты: HubSpot AI Grader предоставляет бесплатную проверку доли голоса и тональности на GPT-4 и Perplexity, а Mangools AI Grader предлагает бесплатную проверку видимости ИИ и сравнение с конкурентами на ChatGPT, Google AIO и Perplexity для начинающих и SEO-специалистов.
Полная структура действий GEO: 5 этапов для оптимальной видимости ИИ
Формирование авторитета в сфере ИИ будущего: почему EEAT — ключ к успеху
После детального анализа технологических основ, стратегических направлений и конкурентной среды, в заключительной части подводятся итоги в виде практической модели действий и рассматриваются перспективы развития поисковых систем.
Работоспособная система действий
Сложность оптимизации генеративных движков требует структурированного и итеративного подхода. Приведенный ниже контрольный список обобщает рекомендации из предыдущих разделов в виде практического рабочего процесса, который может служить руководством для внедрения.
Этап 1: Аудит и оценка исходных данных
- Проведите технический SEO-аудит: проанализируйте основные технические требования, такие как доступность для индексаторов, индексируемость, скорость загрузки страниц (Core Web Vitals) и оптимизация для мобильных устройств. Выявите проблемы, которые могут блокировать работу поисковых роботов (например, медленная загрузка страниц, зависимости JavaScript).
- Проверьте разметку Schema.org: проведите аудит существующей разметки структурированных данных на предмет полноты, корректности и использования сетевых сущностей (@id).
- Проведите контент-аудит: оцените существующий контент с точки зрения сигналов EEAT (указаны ли авторы, цитируются ли источники?), семантической глубины и авторитетности темы. Выявите пробелы в тематических группах.
- Определите базовый уровень видимости LLM: используйте специализированные инструменты мониторинга или ручные запросы на соответствующих платформах ИИ (Google AIO, ChatGPT, Perplexity), чтобы оценить текущее состояние видимости вашего бренда и ваших основных конкурентов.
Этап 2: Стратегия и оптимизация контента
- Разработайте карту тематических кластеров: на основе исследования ключевых слов и тем создайте стратегическую карту тем и подтем, которые необходимо осветить, отражающую вашу собственную экспертизу.
- Создание и оптимизация контента: Создание нового контента и доработка существующего с явным упором на оптимизацию для извлечения информации (структура фрагментов, списки, таблицы, часто задаваемые вопросы) и охвата сущностей.
- Усиление сигналов EEAT: внедрение или улучшение страниц авторов, добавление ссылок и цитирований, включение уникальных отзывов и оригинальных данных.
Этап 3: Техническая реализация
- Внедрение/обновление разметки Schema.org: реализация релевантной и взаимосвязанной разметки Schema на всех важных страницах, особенно для продуктов, часто задаваемых вопросов, руководств и статей.
- Создайте и предоставьте файл llms.txt: Создайте файл llms.txt, содержащий ссылки на наиболее важный и релевантный контент для систем искусственного интеллекта, и поместите его в корневой каталог веб-сайта.
- Устранить проблемы с производительностью: устранить проблемы, выявленные в ходе технического аудита, касающиеся времени загрузки и отображения.
Этап 4: Формирование авторитета и продвижение
- Проведение цифрового PR и информационно-просветительской работы: целевые кампании для получения высококачественных обратных ссылок и, что более важно, упоминаний бренда в авторитетных, тематически релевантных изданиях.
- Активно участвуйте в сообществах: принимайте активное и полезное участие в дискуссиях на таких платформах, как Reddit и Quora, чтобы позиционировать бренд как полезный и компетентный источник информации.
Этап 5: Измерение и итерация
- Настройка аналитики: Настройка инструментов веб-аналитики для отслеживания реферального трафика из источников ИИ и мониторинга косвенных сигналов, таких как прямой трафик и брендированный поиск.
- Постоянно отслеживайте видимость LLM: регулярно используйте инструменты мониторинга для отслеживания динамики вашей собственной видимости и видимости ваших конкурентов.
- Адаптируйте стратегию: используйте полученные данные для постоянного совершенствования контентной и авторитетной стратегии, а также для реагирования на изменения в сфере искусственного интеллекта.
Будущее поиска: от сбора информации до взаимодействия со знаниями
Интеграция генеративного ИИ — это не мимолетная тенденция, а начало новой эры взаимодействия человека и компьютера. Это развитие выйдет за рамки современных систем и коренным образом изменит способ доступа к информации.
Развитие ИИ в поисковой оптимизации
- Гиперперсонализация: будущие системы искусственного интеллекта будут адаптировать ответы не только к явному запросу, но и к неявному контексту пользователя — его истории поиска, местоположению, предпочтениям и даже предыдущему взаимодействию с системой.
- Рабочие процессы, аналогичные работе агентов: ИИ эволюционирует от простого предоставления ответов к проактивному помощнику, способному выполнять многоэтапные задачи от имени пользователя – от исследования и обобщения до бронирования или покупки.
- Конец метафоры «поиска»: концепция активного «поиска» все чаще заменяется непрерывным, диалого-ориентированным взаимодействием с вездесущим интеллектуальным помощником. Поиск превращается в разговор.
Подготовка к будущему: построение устойчивой, перспективной стратегии
В заключение следует отметить, что принципы, изложенные в этом отчете — построение подлинного авторитета, создание высококачественного структурированного контента и управление единым цифровым присутствием — не являются краткосрочными тактиками для нынешнего поколения ИИ. Это фундаментальные принципы построения бренда, способного процветать в любой будущей среде, где информация будет передаваться через интеллектуальные системы.
Основное внимание должно быть сосредоточено на том, чтобы стать источником достоверной информации, из которого захотят учиться как люди, так и их ИИ-помощники. Компании, инвестирующие в знания, эмпатию и ясность, не только будут заметны в сегодняшних результатах поиска, но и будут существенно влиять на формирование представлений о своей отрасли в завтрашнем мире, управляемом искусственным интеллектом.
Мы здесь для вас — Консультации — Планирование — Внедрение — Управление проектами
☑️ Поддержка малых и средних предприятий в области стратегии, консалтинга, планирования и реализации проектов
☑️ Разработка или корректировка цифровой стратегии и цифровизации
☑️ Расширение и оптимизация международных процессов продаж
☑️ Глобальные и цифровые торговые платформы B2B
☑️ Развитие новаторского бизнеса

Konrad Wolfenstein
Я с удовольствием стану вашим личным консультантом.
Вы можете связаться со мной, заполнив форму обратной связи ниже, или просто позвонить мне по номеру +49 7348 4088 965 .
Я с нетерпением жду начала нашего совместного проекта.
Напишите мне


Xpert.Digital - Konrad Wolfenstein
Xpert.Digital — это центр для предприятий, специализирующийся на цифровизации, машиностроении, логистике/внутрипроизводственной логистике и фотовольтаике.
С помощью нашего комплексного решения для развития бизнеса мы поддерживаем известные компании на всех этапах, от привлечения новых клиентов до послепродажного обслуживания.
Анализ рынка, маркетинговый маркетинг, автоматизация маркетинга, разработка контента, PR, почтовые рассылки, персонализированные кампании в социальных сетях и работа с потенциальными клиентами — все это входит в число наших цифровых инструментов.
Более подробную информацию можно найти по ссылкам: www.xpert.digital - www.xpert.solar - www.xpert.plus
Поддерживать связь