Aleph Alpha и Kolibri-1: Возвращение ИИ в Германию на арену эффективности, зависимости и нового властного блока – креативное изображение на эту тему, созданное с использованием ИИ: Xpert.Digital
78 миллиардов параметров и при этом высокая эффективность: Kolibri-1 в центре внимания
Немецкий и английский: Kolibri-1 как фактор экономического дифференцирования
От чат-бота к автоматизации процессов: разработка Kolibri-1
Компания Aleph Alpha представляет Kolibri-1 — инновационную модель искусственного интеллекта, которая не только адаптирована к потребностям немецких компаний, но и может установить международные стандарты. В отличие от других крупных языковых моделей, в которых часто доминируют американские или китайские компании, Kolibri-1 стремится предоставить управляемое и эффективное решение на основе ИИ, особенно подходящее для работы с конфиденциальными данными и сложными документами. Ориентация на немецкий и английский языки, а также интеграция в существующие бизнес-процессы могут иметь решающее значение для многих организаций, особенно на рынке, все чаще нуждающемся в высокопроизводительных и безопасных для данных решениях. В этом контексте возникает вопрос: является ли Kolibri-1 всего лишь технологическим экспериментом или краеугольным камнем новой главы в развитии европейского ИИ? Вызовы и возможности, предоставляемые этой моделью, подробно рассматриваются в следующих разделах.
78 миллиардов параметров – и все же в конечном итоге решение принимает не модель, а инфраструктура
Модель как сигнал экономической политики
С Kolibri-1 компания Aleph Alpha возвращается к дисциплине, от которой, казалось, в значительной степени отошла из Гейдельберга: разработке больших, общеприменимых языковых моделей. Однако новая система — это не просто попытка воспроизвести американские или китайские модели. Она разработана как специализированная немецко-английская основа для бизнеса, государственных администраций и регулируемых отраслей. Таким образом, Kolibri-1 ориентирована не столько на массовый рынок бесплатных чат-ботов, сколько на коммерчески привлекательный, но менее доступный рынок: управляемый ИИ для работы с конфиденциальными данными, объемными документами, внутренними базами знаний, производственными процессами и рабочими процессами на основе агентов.
Поэтому данную публикацию не следует рассматривать исключительно как техническое событие. Она затрагивает три ключевых экономических вопроса европейской стратегии в области ИИ. Во-первых, она касается того, могут ли европейские поставщики разрабатывать технологически независимые базовые модели, не становясь при этом постоянно зависимыми от основных платформ из США и Китая. Во-вторых, она поднимает вопрос о том, может ли высокопроизводительная, открыто доступная модель также создавать жизнеспособную бизнес-модель. В-третьих, экономическая выгода определяется не количеством параметров, а тем, могут ли компании безопасно эксплуатировать модель с разумными затратами, интегрировать ее в существующие процессы и постоянно обновлять.
Запуск Kolibri-1 происходит в благоприятной рыночной среде. Ожидается, что расходы Германии на искусственный интеллект вырастут до 28,7 млрд евро в 2026 году, что представляет собой рост примерно на 48 процентов по сравнению с предыдущим годом. На долю генеративного ИИ уже приходится около 11,5 млрд евро, или примерно 40 процентов всего рынка. В то же время его практическое применение в немецких компаниях все еще значительно менее распространено, чем можно было бы предположить, исходя из высоких сумм инвестиций. Лишь небольшая часть компаний предоставляет своим сотрудникам прямой доступ к приложениям генеративного ИИ. В частности, небольшие компании проявляют осторожность из-за стоимости, проблем с конфиденциальностью данных, нехватки квалифицированных кадров и неясных путей интеграции.
Это создает рыночную нишу. Компании хотят использовать мощный ИИ, но не хотят передавать конфиденциальную информацию на внешние платформы без проверки. Им нужны прозрачные операционные модели, контролируемые потоки данных, качество на немецком языке и юридически обоснованные концепции развертывания. Именно здесь на помощь приходит Kolibri-1. Таким образом, эта модель представляет собой не столько атаку на самые популярные чат-боты, сколько предложение для организаций, которые хотят создать собственную инфраструктуру ИИ по регуляторным, стратегическим или экономическим причинам.
Экономичная активизация вместо маломасштабной архитектуры
Kolibri-1 содержит в общей сложности приблизительно 78,1 миллиарда параметров. На первый взгляд, это число кажется очень большим и, соответственно, дорогостоящим показателем. Однако на самом деле система работает с архитектурой, включающей в себя смешанный состав экспертов. Это означает, что не все параметры активируются на каждом этапе обработки. Вместо этого маршрутизатор определяет, какие специализированные подсети отвечают за соответствующий токен. Из 78,1 миллиарда параметров на каждый токен активны лишь около 3,46 миллиарда. Это соответствует примерно 4,4 процента от общей емкости.
Архитектура состоит из 50 слоев преобразователей. Каждый слой содержит 384 специализированных эксперта. Один общий эксперт всегда активен, а шесть других активируются в зависимости от содержимого соответствующего токена. Базовая концепция экономически привлекательна: модель обладает знаниями и возможностями специализации очень большой системы, но при этом требует лишь доли обычных вычислительных операций для одного шага расчета. Это позволяет добиться существенного улучшения пропускной способности и снижения эксплуатационных расходов по сравнению с плотной моделью аналогичного общего размера.
Однако эту эффективность не следует путать с низкими требованиями к памяти. Все веса модели должны оставаться доступными в памяти, поскольку маршрутизатор может активировать разных экспертов в зависимости от входных данных. Вариант FP8 требует приблизительно 78 гигабайт графической памяти только для весов. Дополнительная память необходима для контекста (кэша ключ-значение), временных вычислений, распараллеливания и среды выполнения. Поэтому рекомендуемая минимальная конфигурация включает две видеокарты A100 по 80 гигабайт каждая, две видеокарты H100 SXM5 или одну видеокарту H200, B200 или B300. Для стабильной работы в производственной среде целесообразны более мощные или резервные конфигурации.
Это подчеркивает основное противоречие, присущее Kolibri-1. Вычислительные затраты на один токен сравнительно невелики, но доступ к необходимому оборудованию остается капиталоемким. Для компании с существующей инфраструктурой GPU эта модель может быть экономически привлекательной. Однако для среднего предприятия без собственного кластера ИИ прямой хостинг редко является наиболее экономически выгодным решением. В этом случае решающую роль, вероятно, сыграют управляемые хостинговые услуги, суверенные облачные сервисы или отраслевые платформы.
Таким образом, экономическое преимущество экспертной архитектуры не является автоматическим. Оно зависит от высокой степени использования. Дорогостоящий графический процессор, обрабатывающий лишь эпизодические запросы, остается неэкономичным даже при использовании эффективной модели. Чем больше пользователей, процессов обработки документов и приложений на основе агентов объединены в общей инфраструктуре, тем лучше распределяются фиксированные затраты. Поэтому для операторов центров обработки данных, облачных провайдеров и крупных корпораций Kolibri-1 значительно привлекательнее, чем для отдельных малых предприятий с низкой степенью использования.
Миллион токенов — это не пропуск без оплаты
Ключевой особенностью Kolibri-1 является его способность обрабатывать очень длинные входные данные. Первоначальное обучение проводилось с последовательностями из 16 384 токенов. На последующем этапе обучения длина была увеличена до 65 536 токенов. На заключительном этапе обработки длинного контекста использовалось 262 144 токена. Эта длина считается собственным контекстом модели. Технически, система может быть расширена за пределы этого диапазона без последующего масштабирования по положению. Качество и доступность были проверены до 1 048 576 токенов.
В зависимости от языка, формата и токенизации, один миллион токенов может представлять несколько тысяч страниц текста. Это открывает для компаний возможности, которые в ограниченной степени доступны только с помощью традиционных чат-ботов. К ним относятся анализ обширных контрактов, технических руководств, документации по техническому обслуживанию, юридических документов, исследовательских архивов, документов поставщиков и внутренних баз знаний. Также в принципе упрощается проведение сложных проверок благонадежности, анализ тендерных предложений, сравнение соответствия требованиям и оценка объемных материалов дел.
Однако с экономической точки зрения важна не только максимальная длина контекста, но и стоимость обработки каждого фрагмента осмысленной информации. Очень длинный контекст увеличивает потребление памяти кэшем вычислительной логики (CLU), удлиняет время отклика и может значительно снизить пропускную способность. Кроме того, большое контекстное окно не гарантирует, что модель надежно найдет всю релевантную информацию, правильно ее взвесит и обработает согласованно. Чем длиннее входные данные, тем выше риск потери важных деталей среди нерелевантных фрагментов.
Поэтому экономически целесообразный диапазон использования часто находится ниже технического максимума. Для сложных задач и приложений, критически важных с точки зрения задержки, рекомендуется ограничение не более чем 262 144 токенов. Во многих корпоративных приложениях значительно меньший контекст в сочетании с генерацией, дополненной поиском, остается более эффективным. При таком подходе не все доступные документы загружаются в модель одновременно. Система поиска сначала выбирает предположительно релевантные разделы и передает в языковую модель только их.
Kolibri-1 не заменяет RAG. Скорее, его большое контекстное окно расширяет возможности гибридных архитектур. Например, компания может сначала выполнить семантический поиск по тысячам документов, затем загрузить несколько сотен релевантных страниц в контекст, и модель сгенерирует на основе этого обоснованный анализ. Дополнительная ценность возникает благодаря сочетанию поиска, понимания документов, атрибуции источников, структурированного вывода и проверки человеком. И наоборот, неизбирательное загрузочное использование целых пространств данных в модель чревато высокими затратами при ограниченном объеме получаемой информации.
Германия становится экономическим конкурентным преимуществом
Истинная стратегическая ценность Kolibri-1 заключается в его последовательной ориентации на немецкий и английский языки. Примерно 62,5% базового учебного материала составляют тексты на английском языке, около 23,9% — на немецком, и примерно 13,6% — программный код. На более поздних этапах обучения дополнительно были интегрированы данные инструкций, задачи на рассуждение, процессы на основе агентов, тематический контент и длинные документы. На этапе предварительного обучения было использовано в общей сложности 20 триллионов токенов. Еще 3,44 триллиона токенов были использованы на среднем этапе обучения, а 201 миллиард токенов был инвестирован в расширение контекстного окна.
Немецкий компонент имеет существенное значение по сравнению с другими странами. Хотя многие глобальные модели могут генерировать беглый немецкий текст, они преимущественно обучались на англоязычных данных. Это особенно влияет на юридические нюансы, административный язык, сложные технические термины, региональные выражения и отраслевые типы текста. Kolibri-1 использует собственный токенизатор с 128 000 записей, который более полно учитывает морфологию и образование сложных слов немецкого языка. Это позволяет обрабатывать немецкий текст более компактно и эффективно.
Эта техническая особенность имеет прямые экономические последствия. Меньшее количество токенов на немецкий документ может снизить требования к хранению, время обработки и, следовательно, затраты. Однако качество в специализированных приложениях еще важнее. Незначительные языковые недочеты часто допустимы в чате службы поддержки клиентов. Напротив, неточная терминология в анализе контракта, директиве по технической безопасности или административном процессе может привести к значительным дополнительным затратам.
Германия обладает обширными хранилищами ценных, но труднодоступных технических документов. Промышленные компании хранят архивы проектной документации, отчетов о техническом обслуживании, уведомлений о качестве, стандартов, комментариев к спискам деталей и переписки с поставщиками, которые накапливались десятилетиями. Государственные органы управляют обширными файлами, нормативными актами, официальными уведомлениями и процедурной документацией. Страховые компании, банки, поставщики энергии и организации здравоохранения работают с текстовыми хранилищами, содержание которых строго регламентировано. Модель, которая лучше отражает этот контент на лингвистическом и структурном уровне, может обеспечить повышение производительности там, где обычные чат-боты достигают своих пределов.
Двуязычная направленность также является ограничением. Международным корпорациям часто требуются унифицированные системы для десятков языков. В таких случаях широко многоязычная модель может быть более экономически выгодной, несмотря на более слабую специализацию на немецком языке. Поэтому Kolibri-1 особенно привлекателен там, где немецкий и английский языки составляют большую часть коммуникации, создающей добавленную стоимость. Преднамеренное ограничение двумя языками не является универсальным решением, а скорее стратегическим акцентом на четко определенном рынке.
От чат-бота до цифрового работника процесса
Kolibri-1 поддерживает режим явного логического вывода. Пользователи или приложения могут установить уровень логического вывода на низкий, средний или высокий, либо полностью отключить дополнительный вывод. Эта градация важнее для корпоративного использования, чем кажется на первый взгляд. Не каждая задача требует длительной внутренней обработки. Простая классификация, быстрое извлечение информации или перефразирование текста должны выполняться быстро и экономично. Напротив, сложный технический анализ или многоэтапное планирование могут выиграть от более высокого уровня логического вывода.
Это позволяет контролировать вычислительную мощность в зависимости от экономической ценности задачи. Компания может выполнять рутинные процессы с минимальными когнитивными затратами и выделять дополнительное вычислительное время только для сложных случаев. Это похоже на управление ресурсами на основе оценки рисков: чем больше потенциальных последствий неверного ответа, тем больше усилий выделяется на проверку, поиск и анализ. Однако это требует, чтобы приложение соответствующим образом выбирало этот уровень сложности и отслеживало результаты.
Ещё более важной является его способность вызывать инструменты. Модель может генерировать структурированные вызовы функций, получать информацию через программные интерфейсы, получать доступ к поисковым системам, выполнять код и выводить данные в предопределённых форматах. Это превращает простой генератор текста в строительный блок для рабочих процессов на основе агентов. Например, ассистент может понять запрос, найти соответствующие документы, получить данные из ERP-системы, выполнить вычисления и создать черновой шаблон решения.
Экономический эффект заключается не в автоматической генерации текста, а в объединении ранее разрозненных этапов процесса. Когда сервисному специалисту больше не нужно искать номера деталей, историю обслуживания и условия контрактов в нескольких системах, время обработки сокращается. Когда отдел закупок автоматически структурирует документы поставщиков, выявляет риски и готовит сравнительные таблицы, производительность увеличивается без пропорционального увеличения штата. Когда государственное учреждение извлекает содержимое файлов и создает стандартизированные проекты, специалисты могут уделять больше времени юридической оценке и взаимодействию с гражданами.
Однако полностью автономное принятие решений на основе этого невозможно. Kolibri-1 предназначен для систем, в которых люди анализируют расходы перед принятием решения. В процессах принятия решений модель должна собирать доказательства, формулировать варианты и выявлять противоречия, но не принимать обязательные решения без контроля. Это особенно актуально для кадровой политики, кредитования, медицины, государственных услуг, вопросов безопасности и других областей, имеющих значительные индивидуальные или социальные последствия.
Наличие общедоступных данных о весе изменяет переговорную силу
Kolibri-1 был выпущен под лицензией Apache 2.0. Компании могут загружать веса, запускать их на собственной инфраструктуре, настраивать и, в принципе, использовать в коммерческих целях. По сравнению с проприетарными программными интерфейсами это снижает зависимость от одного поставщика. Ценообразование, условия обслуживания или продуктовые стратегии внешнего оператора платформы могут менее резко изменить собственную систему компании, если модель работает в рамках собственной сферы ответственности компании.
Такая открытость укрепляет переговорные позиции клиентов с поставщиками облачных и программных решений. Компания может сравнивать различных партнеров по хостингу, менять инфраструктуру или запускать особо важные приложения полностью собственными силами. Также возможны отраслевые настройки. Консалтинговые фирмы, интеграторы и компании-разработчики программного обеспечения могут создавать собственные решения на основе этой модели, не оплачивая комиссию за использование проприетарной модели для каждого запроса.
Однако Open Weight не означает, что вся система является открытым исходным кодом в строгом смысле этого слова. Веса модели и файлы конфигурации доступны. Данные для обучения, полный код обучения, разработка архитектуры и все инструменты для производства не раскрываются автоматически. Опубликованная лицензия предоставляет широкие права на использование предоставленных компонентов, но не разрешает полное воспроизведение процесса разработки.
Даже бесплатные загружаемые версии не исключают эксплуатационных расходов. Компаниям приходится финансировать оборудование, электроэнергию, аренду помещений в дата-центрах, мониторинг, безопасность, обновления и квалифицированный персонал. К этому добавляются расходы на подготовку данных, векторные базы данных, контроль доступа, оценку, ведение журналов и защиту приложений. Во многих случаях лицензия на модель составляет лишь небольшую часть общей стоимости.
Таким образом, экономическое решение — это не выбор между бесплатной моделью и платным API. Это выбор между фиксированными и переменными затратами. Проприетарные API обычно взимают плату за обработанный токен или за запрос. Собственный хостинг влечет за собой высокие первоначальные и наладочные затраты, но может стать более экономически выгодным при большом и стабильном использовании. Компании с колеблющимися или низкими объемами часто выигрывают от облачной тарификации, основанной на использовании. Организации с постоянно высоким уровнем использования, строгими требованиями к данным или потребностями в стратегической адаптации могут получить преимущества от собственного хостинга.
Новое измерение цифровой трансформации с помощью «управляемого ИИ» (искусственного интеллекта) — платформа и B2B-решение | Xpert Consulting

Новое измерение цифровой трансформации с помощью «управляемого ИИ» (искусственного интеллекта) – платформа и B2B-решение | Xpert Consulting - Изображение: Xpert.Digital
Здесь вы узнаете, как ваша компания может быстро, безопасно и без высоких барьеров для входа внедрить индивидуальные решения на основе искусственного интеллекта.
Управляемая платформа искусственного интеллекта — это комплексное и беззаботное решение для вашего бизнеса в сфере искусственного интеллекта. Вместо того чтобы возиться со сложными технологиями, дорогостоящей инфраструктурой и длительными процессами разработки, вы получаете готовое решение, адаптированное под ваши потребности, от специализированного партнера — зачастую всего за несколько дней.
Основные преимущества с первого взгляда:
⚡ Быстрая реализация: от идеи до готового к использованию приложения за считанные дни, а не месяцы. Мы предлагаем практические решения, которые создают немедленную добавленную стоимость.
🔒 Максимальная безопасность данных: Ваши конфиденциальные данные остаются с вами. Мы гарантируем безопасную и соответствующую законодательству обработку данных без их передачи третьим лицам.
💸 Отсутствие финансового риска: вы платите только за результат. Полностью исключаются высокие первоначальные инвестиции в оборудование, программное обеспечение или персонал.
🎯 Сосредоточьтесь на своем основном бизнесе: сконцентрируйтесь на том, что у вас получается лучше всего. Мы берем на себя всю техническую реализацию, эксплуатацию и обслуживание вашего решения на основе ИИ.
📈 Перспективность и масштабируемость: ваш ИИ растет вместе с вами. Мы обеспечиваем непрерывную оптимизацию и масштабируемость, а также гибко адаптируем модели к новым требованиям.
Более подробная информация здесь:
Реальная стоимость препарата Колибри-1 в бизнес-операциях
Реальный расчёт начинается после загрузки
Для обоснованного экономического анализа проекта Kolibri-1 необходимо выйти далеко за рамки покупки графического процессора. В капитальную сторону это включает закупку, финансирование, сетевые технологии, системы хранения данных, охлаждение и, возможно, необходимые структурные модификации. В операционную сторону входят затраты на электроэнергию, техническое обслуживание, персонал, эксплуатацию программного обеспечения и обеспечение надежности. Для производственных приложений часто требуются резервные системы. Одного сервера может быть достаточно для тестирования, но он не является надежным корпоративным сервисом.
Наиболее важным фактором затрат является коэффициент использования. Теоретически, модель с внутренним управлением может обеспечить низкие предельные издержки на каждый дополнительный запрос. Однако на практике инфраструктура должна быть доступна и в периоды низкого спроса. Если она используется только на 10 или 20 процентов мощности, фиксированные издержки распределяются на небольшое количество токенов. Специализированный хостинг-провайдер может агрегировать нагрузки различных клиентов и, таким образом, работать гораздо эффективнее. Это говорит в пользу суверенных управляемых предложений в области ИИ, где хранение данных, работа с моделями и управление объединены в контролируемой европейской инфраструктуре.
Долгосрочные контексты также изменяют структуру затрат. Обработка большого документа занимает место в хранилище и время обработки в течение длительного периода. Когда несколько пользователей одновременно отправляют сотни тысяч токенов, количество запросов, которые можно обработать параллельно, уменьшается. Поэтому компаниям необходимо моделировать не только средний запрос, но и пиковые нагрузки, требования к времени отклика и приоритеты. Система для ночной пакетной обработки может работать значительно экономичнее с тем же оборудованием, чем интерактивный помощник с гарантированным временем отклика.
Адаптация к корпоративным данным влечет за собой дополнительные затраты. Зачастую полная тонкая настройка не требуется. Хорошая система RAG, чистые метаданные и надежная концепция авторизации часто приносят большую пользу. Тонкая настройка может быть полезна, когда необходимо надежно изучить повторяющиеся форматы, языки ведения бизнеса или рабочие процессы. Однако она увеличивает трудозатраты на обеспечение качества данных, тестирование, версионирование и повторную проверку после обновления модели.
Самый большой скрытый фактор затрат — это обеспечение качества. Языковая модель может выдавать убедительные результаты, но при этом быть ошибочной. Поэтому для эффективных систем необходимы тестовые примеры, соответствующие бизнес-задачам, определенные допуски на ошибки и непрерывная оценка. Для каждого критически важного приложения компании должны измерять, как часто модель находит правильную информацию, когда она выдает необоснованные выводы, соблюдает ли она права доступа и как реагирует на измененные документы. Без этих мер контроля низкая стоимость токена экономически бесполезна, поскольку даже одна ошибка может нанести значительный ущерб.
950 мегаватт-часов и вопрос эффективности
Потребление энергии на этапах предварительного обучения, обучения в середине процесса и длительного контекста оценивается примерно в 950 мегаватт-часов. Эта цифра включает в себя потребление энергии вычислительными узлами и накладные расходы центра обработки данных. Она не включает, среди прочего, контролируемую тонкую настройку, обучение с подкреплением, вспомогательные модели, тестовые серии, а также режимы простоя и пиковой нагрузки. Таким образом, фактическое общее потребление энергии в рамках программы разработки выше, чем опубликованная цифра.
Этап предварительного обучения длился 21 день на 768 графических процессорах Nvidia B200, распределенных по 96 системам HGX. Это привело к затратам примерно 392 000 часов работы графических процессоров. Последующий этап обучения средней сложности длился около пяти дней и потребовал примерно 90 000 часов работы графических процессоров. Этап долговременного контекста добавил еще 10 000 часов работы графических процессоров. Заявленные вычислительные затраты составляют 6,4 x 10^23 операций с плавающей запятой.
Цифра в 950 мегаватт-часов кажется высокой, но её необходимо рассматривать в экономическом контексте. Обучение — это единовременная инвестиция в многократно используемый цифровой актив. Решающим фактором является интенсивность последующего использования модели и то, какие продуктивные эффекты она генерирует. Если модель используется в тысячах приложений в течение нескольких лет, затраты на обучение распределяются на значительную часть экономического результата. И наоборот, если она остаётся технологическим демонстрационным проектом с низким уровнем использования, производительность ресурсов оказывается низкой.
При оценке воздействия на окружающую среду текущая эксплуатация часто оказывается более значимой в долгосрочной перспективе, чем разовая сессия обучения. Каждый запрос потребляет энергию, а большие контекстные окна увеличивают эту потребность. В то же время эффективная экспертная модель может требовать меньше вычислений на токен, чем плотная модель с сопоставимой общей производительностью. Поэтому решающее сравнение заключается не в высоком абсолютном потреблении энергии по сравнению с его отсутствием, а в энергии на один пригодный для использования результат.
В Европе существует стратегический стимул к повышению эффективности. Высокие цены на электроэнергию и ограниченная мощность центров обработки данных делают неэффективные архитектуры особенно дорогими. Такие модели, как Kolibri-1, которые активируют лишь небольшую часть своих параметров, соответствуют европейской стратегии, сочетающей технологическую производительность с эффективностью использования ресурсов. Однако это преимущество частично нивелируется высокими требованиями к хранению данных и необходимостью использования высокопроизводительного оборудования.
Результаты контрольных показателей демонстрируют устойчивость, но явного лидера нет
Опубликованные сравнительные данные показывают, что Kolibri-1 — высокоэффективная модель в своем классе по размеру и эффективности. Она набирает в среднем 75,5 баллов на английском языке и 70,8 баллов на немецком. Особенно высока ее производительность в математических вычислениях и многоэтапном рассуждении. В англоязычном тесте AIME-2026 она набирает 96,0%, а в немецкой версии — 90,0%. В научно сложном тесте GPQA Diamond модель набирает 84,3% на английском языке и 81,3% на немецком.
Kolibri-1 также демонстрирует конкурентоспособные результаты в задачах программирования, агентно-ориентированных процессах и промышленных сценариях RAG. Особо следует отметить высокие показатели в таких областях, как автомобильная промышленность, полупроводниковые технологии, немецкий государственный сектор и промышленные приводные технологии. Это подтверждает его позиционирование как модели для наукоемких бизнес-процессов. Не менее значительным является улучшение по сравнению с предыдущей базовой моделью: после обучения значительно улучшились навыки рассуждения, использования инструментов и соблюдения инструкций.
Тем не менее, Kolibri-1 не является лидером во всех областях. Более плотные и крупные конкурирующие модели показывают лучшие результаты в ряде тестов, касающихся знаний, кода и длинного контекста. Другие экспертные модели также превосходят конкурентов в отдельных задачах вызова инструментов или поиска информации. Результаты, полученные в Германии, убедительны, но не демонстрируют стабильного превосходства. Поэтому явное экономическое преимущество нельзя вывести исключительно на основе сравнительной таблицы.
Бенчмарки отражают только определенные условия тестирования. В реальных компаниях качество документов, права доступа, разнообразие форматов, технический жаргон и последствия ошибок значительно сложнее. Модель может хорошо показать себя в стандартизированном тесте, но при этом потерпеть неудачу из-за плохо отсканированных PDF-файлов, противоречивых устаревших данных или внутренних сокращений. И наоборот, модель с немного меньшим средним баллом может оказаться лучше в хорошо настроенном корпоративном приложении.
Поэтому для принятия решений по закупкам и архитектуре крайне важно проводить внутреннее тестирование. Компаниям следует использовать репрезентативные документы, сложные граничные случаи и данные о реальных процессах. Измерения должны охватывать не только точность отклика, но и стоимость, задержку, стабильность, исходный код, поведение при отказах и ремонтопригодность. Kolibri-1, благодаря открытым весам, хорошо подходит для таких контролируемых оценок. Это существенное преимущество по сравнению с системами, внутренние версии и условия эксплуатации которых могут изменяться без вмешательства заказчика.
Обеспечение безопасности — это системная задача
Обучение Kolibri-1 включает меры защиты от вредоносного контента, персональных данных и галлюцинаций. В ходе предварительного обучения часть персонально идентифицирующей информации была удалена или заменена. Для контролируемой тонкой настройки были добавлены данные, защищающие от атак на персональную информацию. Кроме того, модель была обучена воздерживаться от реагирования при наличии отсутствующей или противоречивой информации.
Эти меры снижают риски, но не устраняют их полностью. Языковые модели могут генерировать ложную информацию, перенимать политические или социальные предубеждения и реагировать на измененные входные данные. Особенно проблематичны атаки с использованием косвенного внедрения подсказок. В таких атаках полученный документ содержит скрытые инструкции, предназначенные для того, чтобы обманом заставить модель выполнить нежелательные действия. Чем шире используются вызовы инструментов и автоматизированные процессы, тем больше потенциальный ущерб от такой атаки.
Таким образом, для обеспечения безопасности корпоративных систем требуется многоуровневая защита. Доступ должен предоставляться в соответствии с принципом минимальных привилегий. Вызовы инструментов должны проверяться, конфиденциальные действия требуют одобрения, а результаты должны регистрироваться. Модель не должна самостоятельно решать, какие данные ей разрешено видеть или какие транзакции ей разрешено выполнять. Ее права доступа должны быть технически ограничены за пределами модели.
Расширенный контекст также создает новые риски. Большие объемы документов могут содержать конфиденциальную информацию, персональные данные или противоречивые инструкции. Любой, кто управляет целыми виртуальными комнатами данных, должен гарантировать, что пользователи получают только ту информацию, к которой у них есть разрешение на доступ. Централизованная языковая модель, используемая различными отделами без последовательного разделения доступа, может непреднамеренно разрушить существующие информационные барьеры.
Следовательно, внедрение в регулируемых отраслях требует большего, чем просто модель, разработанная в Европе. Оно предполагает документированную оценку рисков, классификацию данных, человеческий контроль, технические протоколы и четкое распределение ответственности. Суверенитет означает не просто хранение данных в конкретном центре обработки данных. Он означает, что организация контролирует всю техническую и юридическую сферу принятия решений.
Трансатлантический блок держав, стоящий за этой моделью
Выпуск Kolibri-1 совпадает с периодом масштабной корпоративной реструктуризации. Компания Aleph Alpha и канадская компания Cohere, занимающаяся разработкой искусственного интеллекта, заключили обязывающее соглашение о слиянии. Сделка еще подлежит окончательному одобрению регулирующих органов в начале октября 2026 года. Объединенная компания будет работать по всему миру под брендом Cohere, с головными офисами в Торонто и Берлине. Площадка в Гейдельберге будет сохранена в качестве исследовательского центра.
Эта конфигурация меняет классификацию Kolibri-1. Хотя модель была разработана в Германии, ее экономическое будущее все больше определяется в рамках трансатлантической организации. Слияние объединяет исследования Aleph Alpha, немецкоязычную экспертизу и доступ к государственному сектору с международным охватом, корпоративными продуктами и возможностями продаж Cohere. Это может ускорить коммерциализацию, но снижает представление о полностью независимом немецком лидере в области ИИ.
В политическом плане партнерство представляется как альтернатива со стороны Германии и Канады доминирующим американским платформенным компаниям. Это описание понятно, но лишь частично достаточно. Хотя Канада является близким партнером Европы, она подчиняется иным правовым, рыночным и структурам безопасности. Цифровой суверенитет не возникает автоматически из-за гражданства участвующих компаний. К важнейшим факторам относятся структуры собственности, управление, доступ к данным, контроль над инфраструктурой и возможность европейских клиентов менять поставщиков и местоположение.
В этом ключевую роль играет Schwarz Group. Она уже была крупным инвестором в Aleph Alpha и продолжает инвестировать в объединенную компанию. Через Schwarz Digits и облачную платформу STACKIT она будет предоставлять вычислительные мощности для собственных проектов в области ИИ. Это создаст более вертикально интегрированную структуру, охватывающую разработку моделей, корпоративное программное обеспечение, облачную инфраструктуру и мощности центров обработки данных.
С экономической точки зрения, такая консолидация имеет смысл. Одна-единственная модель сама по себе не обеспечивает рыночной власти. Создание ценности происходит за счет продаж, интеграции, хостинга, платформ данных и долгосрочных контрактов с клиентами. Трансатлантический альянс может охватить эти уровни лучше, чем Aleph Alpha в одиночку. В то же время это увеличивает зависимость от нескольких крупных партнеров. Если STACKIT станет предпочтительной технической основой, открытость весовых коэффициентов модели может быть на практике дополнена твердой приверженностью конкретной операционной экосистеме.
Суверенитет Европы нуждается в расширении масштабов, а не в символике
Европа вкладывает значительные средства в инфраструктуру искусственного интеллекта. Сеть европейских фабрик по разработке ИИ растет, и миллиарды долларов уже вложены в эти фабрики и связанные с ними структуры. Кроме того, планируется строительство нескольких гигафабрик по разработке ИИ. Цель состоит в том, чтобы предоставить европейским компаниям, исследовательским институтам и государственным органам доступ к высокопроизводительным вычислительным мощностям. Эта инфраструктурная политика необходима, поскольку современные модели не могут быть разработаны или эксплуатированы экономически целесообразно без крупных кластеров графических процессоров.
Однако проект Kolibri-1 демонстрирует, что одного лишь оборудования недостаточно. Европе необходима полноценная промышленная экосистема, включающая модели, центры обработки данных, виртуальные комнаты данных, интеграторов, специализированное программное обеспечение, службы безопасности и квалифицированных пользователей. Государственные инвестиции в вычислительные мощности эффективны только в том случае, если они приводят к созданию коммерчески востребованных приложений. В противном случае Европа субсидирует дорогостоящую инфраструктуру, в то время как прибыльные компании, занимающиеся разработкой программного обеспечения и платформ, остаются за пределами континента.
Спрос, безусловно, существует. Подавляющее большинство немецких компаний предпочитают решения в области ИИ, разработанные в Германии. Однако на практике американские сервисы явно доминируют. Это расхождение объясняется не отсутствием интереса к суверенитету, а скорее удобством, зрелостью продукта, экосистемами и существующими контрактами. Компании редко выбирают модель, основываясь на ее происхождении. Они выбирают решение, если оно быстро интегрируется, надежно, имеет прозрачную ценовую политику и управляемо с организационной точки зрения.
Таким образом, Kolibri-1 должен предлагать нечто большее, чем просто обещание европейского происхождения. Ему необходимы конкурентоспособные инструменты, стабильные варианты хостинга, хорошая документация, партнерские сети и измеримые преимущества в немецких бизнес-процессах. Подход Apache 2.0 способствует развитию такой экосистемы. Компании-разработчики программного обеспечения и исследовательские группы могут тестировать модель, адаптировать ее и интегрировать в свои собственные продукты. Это повышает вероятность того, что инновации не будут ограничены одним поставщиком.
В то же время существует риск того, что открытые весовые коэффициенты будут использоваться глобальными платформами без соответствующей доли добавленной стоимости, остающейся в Германии. Поэтому открытость не может заменить продуманную бизнес-стратегию. Aleph Alpha и ее партнеры должны продавать услуги, безопасные операционные модели, отраслевые решения и институциональное доверие. Модель служит технологической основой и шлюзом, а не единственным источником дохода.
Реалистичная оценка Hummingbird-1
Kolibri-1 не является ни доказательством полной независимости европейского ИИ, ни незначительной нишевой моделью. Его важность находится между этими крайностями. С технической точки зрения, он сочетает в себе большую общую мощность со сравнительно низкой активной вычислительной нагрузкой, необычайно сильным немецким компонентом обучения, очень длинными контекстами, рассуждениями и вызовом инструментов. Открытая лицензия открывает реальные возможности для компаний, интеграторов и государственных учреждений.
С экономической точки зрения, эта модель особенно привлекательна там, где сходятся конфиденциальные данные, немецкая техническая терминология и большие объемы использования. К очевидным целевым группам относятся крупные промышленные компании, государственные учреждения, банки, страховые компании, поставщики энергии, исследовательские организации и специализированные разработчики программного обеспечения. Для малых предприятий, не имеющих собственной инфраструктуры, прямой хостинг обычно менее практичен. Они, скорее всего, будут использовать Kolibri-1 через управляемые сервисы, отраслевые решения или суверенные облачные сервисы.
Главное преимущество заключается не в 78 миллиардах параметров, а в способности сочетать контроль и адаптивность с конкурентоспособными показателями. Главный недостаток состоит в том, что этот контроль должен оплачиваться и управляться на организационном уровне. Тот, кто управляет моделью, берет на себя ответственность за инфраструктуру, безопасность, оценку и обновления. Это стратегическая свобода, но не свобода без затрат.
Партнерство с Cohere и Schwarz Digits может превратить Kolibri-1 в коммерчески успешный продукт, востребованный на международном рынке. Оно может объединить исследования, капитал, продажи и вычислительные мощности. В то же время это требует серьезной переоценки концепции цифрового суверенитета. Трансатлантическая корпорация с немецкими исследованиями и европейской облачной инфраструктурой может стать жизнеспособной альтернативой крупным американским платформам. Однако это не означает автоматически, что это будет чисто немецкая или полностью европейская система.
Таким образом, очевидная перспектива такова: Kolibri-1 — это серьезный строительный блок для европейской экономики искусственного интеллекта, но это не гарантированный успех. Его успех будет определяться не таблицами бенчмарков, а центрами обработки данных, бюджетами на закупки и конкретными бизнес-процессами. Если преимущество немецкого языка, открытая лицензия и эффективная экспертная архитектура смогут быть преобразованы в надежные приложения, модель сможет завоевать коммерчески значимый рынок. Если же хостинг, интеграция и распространение останутся слишком дорогими или слишком сложными, одного лишь технологического качества будет недостаточно.
Таким образом, Kolibri-1 иллюстрирует как возможности Европы, так и ее проблемы. Континент способен разрабатывать мощные системы искусственного интеллекта, имеет требовательных промышленных заказчиков и расширяет свою инфраструктуру. Часто не хватает быстрого масштабирования от исследовательской модели до широко распространенного стандартного продукта. Колибри может казаться легкой и использовать лишь небольшую часть мощности своих крыльев в любой момент времени. Но для того, чтобы летать экономично, ей необходима прочная основа из капитала, энергии, вычислительных мощностей, доверия и распределения.
🎯🎯🎯 Центр B2B-индустрии, основанный на данных, как своего рода внутреннее решение

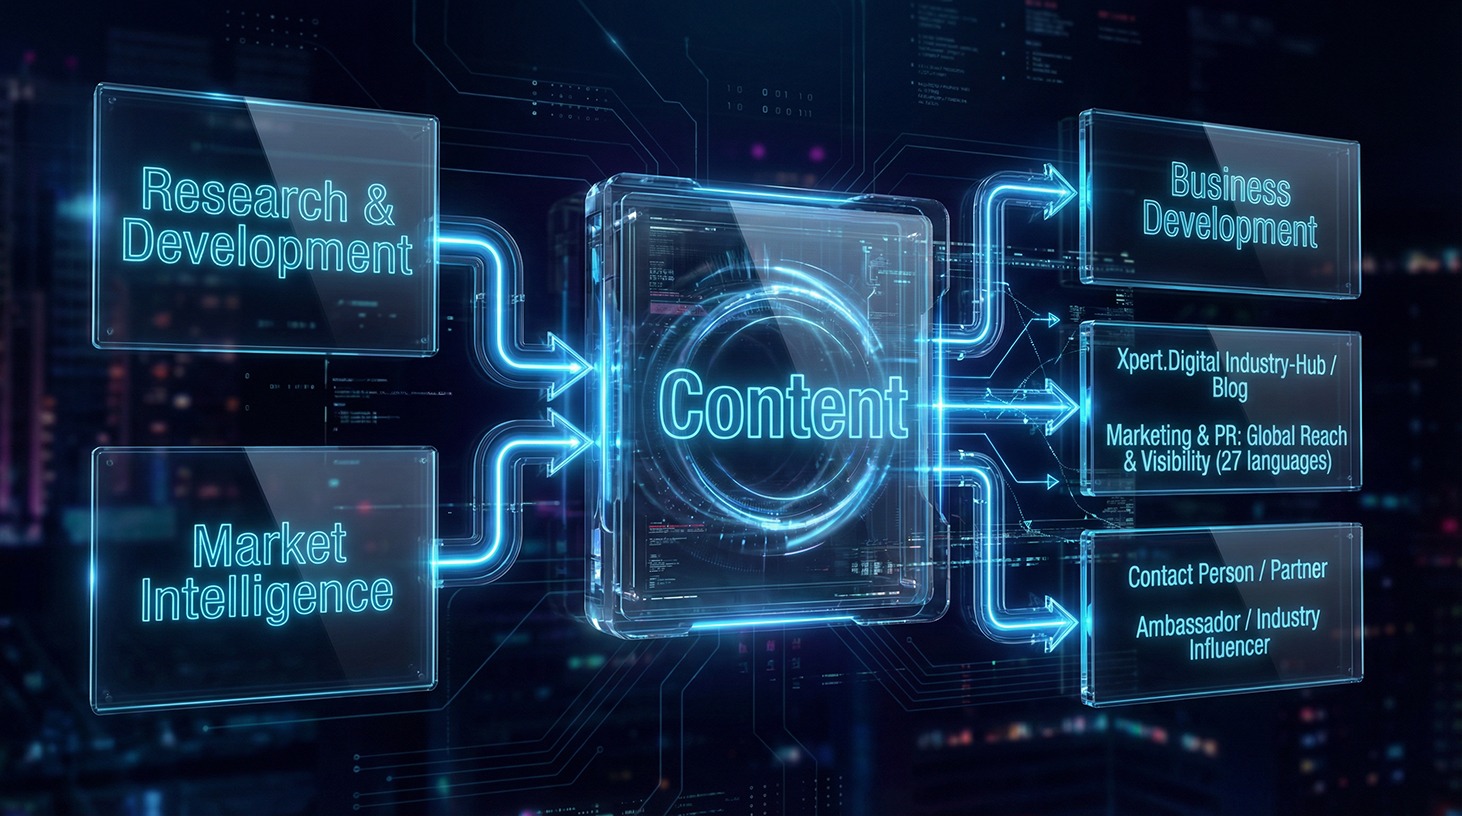
Практически внутреннее решение: как Xpert.Digital устраняет операционные пробелы в B2B-маркетинге и продажах – Умный бизнес, основанный на контенте - Изображение: Xpert.Digital
Xpert.Digital — это ориентированный на данные B2B-индустрионный центр, возглавляемый Konrad Wolfenstein . Компания выступает в качестве внешнего, частично внутреннего решения для отраслевых партнеров, устраняя операционные пробелы в маркетинге, контенте и продажах — без необходимости привлечения дополнительных ресурсов со стороны клиента.
Более подробная информация здесь:
Ваш глобальный партнер по маркетингу и развитию бизнеса
☑️ Язык ведения нашего бизнеса — английский или немецкий
☑️ НОВИНКА: Переписка на вашем родном языке!

Konrad Wolfenstein
Я и моя команда будем рады быть вашими личными консультантами.
Вы можете связаться со мной, заполнив контактную форму здесь wolfenstein@xpert.digital:или просто позвонив по номеру +49 7348 4088 965. Мой адрес электронной почты
Я с нетерпением жду начала нашего совместного проекта.