Искусственный интеллект для предприятий начинается там, где заканчивается чат-бот
Предварительная версия Xpert

Доступно на 27 языках 📢
Предпочитаю Xper.Digital в GoogleⓘОпубликовано: 2 октября 2026 г. / Обновлено: 2 октября 2026 г. – Автор: Konrad Wolfenstein
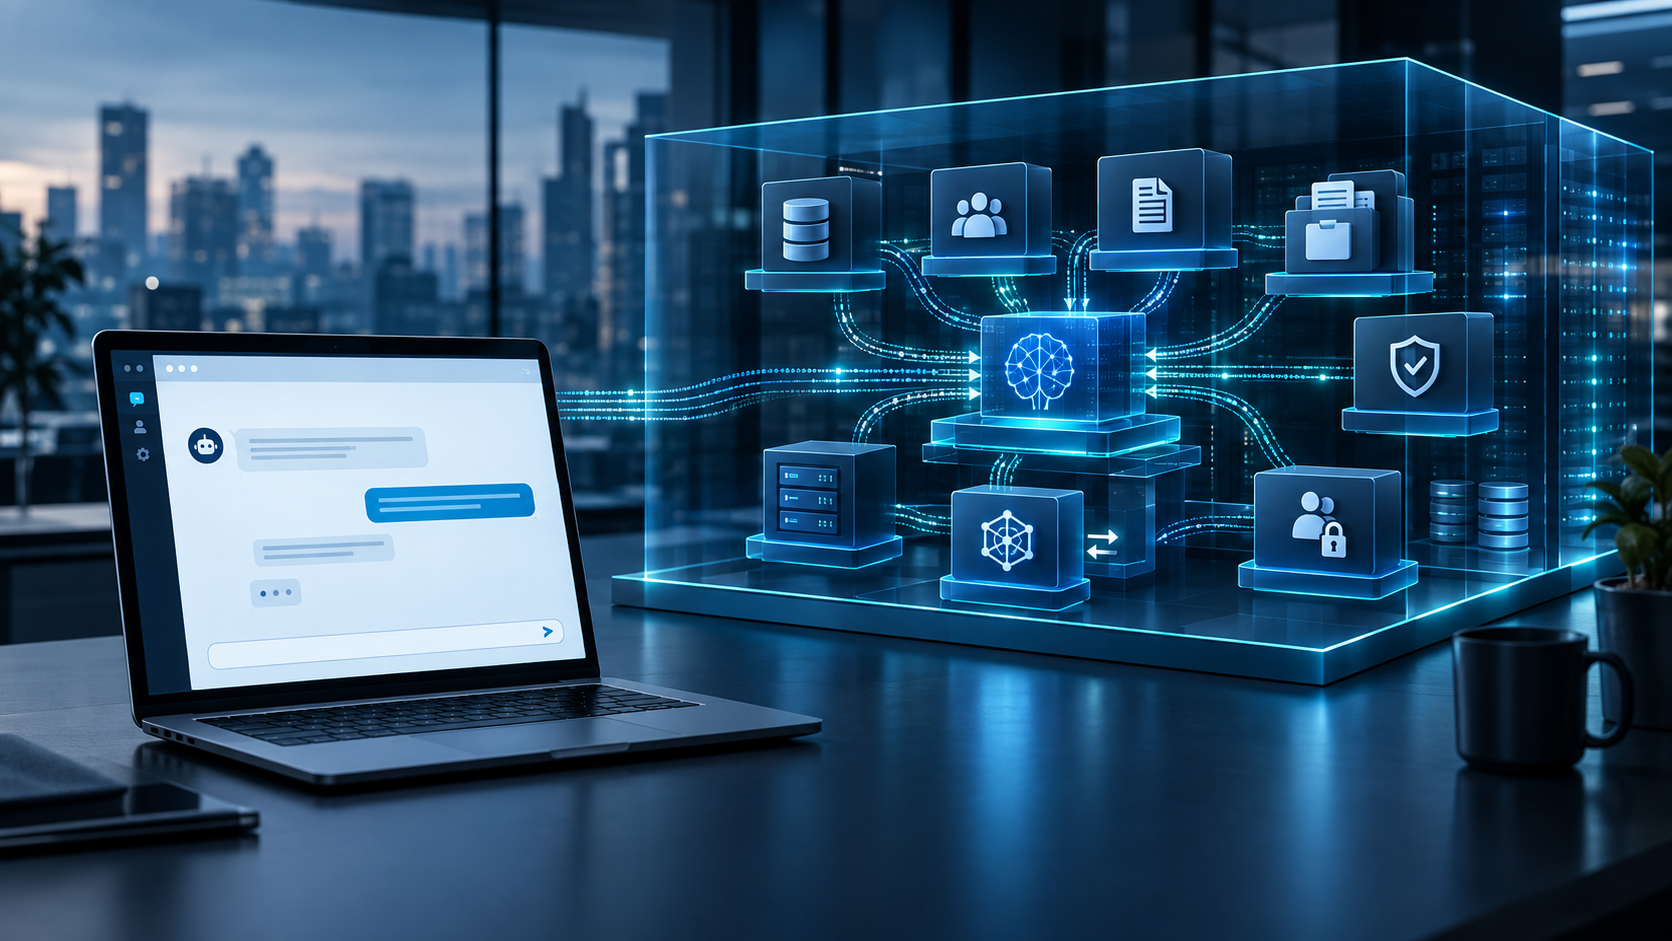
Искусственный интеллект в корпоративной среде начинается там, где заканчивается чат-бот – креативное изображение на эту тему, демонстрирующее возможности ИИ: Xpert.Digital
От лицензии к ответственности: как компаниям следует переосмыслить свою стратегию в области ИИ
Таким образом компании сокращают разрыв между надеждами на искусственный интеллект и реальностью
Важность контекстного слоя для эффективного использования ИИ в корпоративной среде
В современном цифровом пространстве интеграция искусственного интеллекта (ИИ) в бизнес-процессы приобретает все большее значение. Однако многие компании сталкиваются с проблемой, когда их сотрудники часто полагаются на несанкционированные, частные сервисы ИИ — практика, известная как теневой ИИ. Это явление выявляет критический разрыв между решениями, предоставляемыми компаниями, и реальными потребностями пользователей на рабочем месте. Хотя корпоративные лицензии на существующие инструменты ИИ считаются базовой мерой, сами по себе они недостаточны для удовлетворения сложных требований и специфических условий бизнеса. Для создания настоящего генеративного корпоративного ИИ необходима хорошо продуманная системная архитектура, включающая модели, доступ к данным, логику процессов и подотчетность. В этой статье мы рассмотрим основные аспекты, которые компании должны учитывать, чтобы в полной мере использовать потенциал ИИ и эффективно бороться с теневым ИИ.
В связи с этим:
Простая раздача лицензий не оцифровывает компанию — она оцифровывает проблему ее теневого искусственного интеллекта
Во многих компаниях будущее генеративного искусственного интеллекта решается не на стратегическом совещании, а в незаметный момент на работе: сотрудник копирует клиентский договор, расчет или внутреннее электронное письмо в общедоступный сервис ИИ, потому что используемый в частном порядке инструмент кажется быстрее, понятнее и мощнее, чем официально утвержденное компанией решение. С точки зрения сотрудника, это часто не преднамеренное нарушение правил, а прагматичная реакция на неэффективные процессы. С точки зрения компании, это указывает на опасный разрыв между техническим одобрением и реальным удобством использования.
Распространенная попытка устранить этот пробел путем приобретения общекорпоративной лицензии на известного ИИ-помощника оказывается неэффективной. Такая лицензия может обеспечить важные гарантии, административные функции и договорные обязательства. Однако она не превращает автоматически обычного помощника в систему, которая понимает продукты компании, клиентов, контракты, роли, границы утверждения и рабочие процессы. Она также не дает автоматически ответов на такие вопросы, как где обрабатываются конфиденциальные данные, кто несет ответственность за некорректные результаты или можно ли разработать дальнейшие процессы с разумными предельными затратами после первоначального использования.
Таким образом, центральный экономический тезис заключается в следующем: истинный генеративный корпоративный ИИ — это не отдельная модель или окно чата с логотипом компании. Это операционная система, состоящая из моделей, точек доступа к данным, контекста, идентификаторов, разрешений, логики процессов, контроля качества, обязанностей и надежной архитектуры затрат. Реальная ценность возникает не из доступа к ИИ, а из его контролируемой интеграции в организацию. Именно здесь продуктивный бизнес-компонент отличается от удобного потребительского продукта с корпоративным входом в систему.
Лицензия на деятельность компании — это фундамент, но ещё не здание
Корпоративные версии основных ИИ-помощников решают реальные задачи. Как правило, поставщики по умолчанию обязуются не использовать бизнес-данные для обучения своих универсальных моделей. Дополнительные функции включают централизованное управление пользователями, единый вход в систему, управление доступом на основе ролей, ведение журналов, шифрование, отчеты об использовании, соглашения об обработке данных и частично настраиваемые сроки хранения. Кроме того, существующие права доступа, политики и механизмы безопасности могут быть использованы в рамках существующих офисных платформ. Для многих организаций это представляет собой значительное улучшение по сравнению с личными учетными записями.
Ошибка заключается не в приобретении таких лицензий. Ошибка состоит в том, что их объем защиты ошибочно принимают за полноценное корпоративное решение. Обязательство не использовать данные клиентов для общего обучения моделей отвечает лишь на один из нескольких вопросов, связанных с данными. Место обработки, хранение входных и выходных данных, срок хранения, участие субподрядчиков, обработка телеметрии и применимые юрисдикции — все это может оставаться открытым вопросом. Кроме того, чат-продукт, программный интерфейс, встроенный офисный помощник и облачный экземпляр, разработанный специально для клиента, часто значительно различаются. Поэтому общий релиз, основанный на торговой марке, недостаточен как с точки зрения бизнеса, так и с точки зрения регулирования.
Прежде всего, сама лицензия лишена институциональной памяти. Модель не знает автоматически специфического значения названия продукта для компании, истории жалоб или того, какая из нескольких клиентских систем является авторитетной для конкретного процесса. Она не учитывает неформальные исключения или матрицу утверждения и не может самостоятельно определить, применима ли устаревшая политика или ее преемница. Доступ к модели приобретается; однако операционная надежность должна постоянно создаваться, тестироваться и поддерживаться.
Shadow AI — это рыночная оценка, сделанная собственными сотрудниками компании
Использование закрытых учетных записей ИИ часто рассматривается как вопрос дисциплины или обучения. Это слишком упрощенный подход. Когда сотрудники прибегают к несанкционированным инструментам, несмотря на запреты, они непреднамеренно оставляют обратную связь с рынком: разрешенный вариант проигрывает в прямом сравнении по скорости, удобству использования, качеству модели или практической интеграции в рабочие процессы. Запреты могут снизить риски в краткосрочной перспективе, но они не устраняют спрос на лучшее решение.
Масштаб проблемы значителен. Согласно отчетам, к 2026 году 47 процентов сотрудников, использующих генеративный ИИ на рабочем месте, по-прежнему будут использовать личные, неуправляемые учетные записи. Одновременно с этим количество зарегистрированных инцидентов, связанных с передачей конфиденциальных данных в приложения ИИ, удвоилось. В среднем на одну организацию в месяц фиксировалось 223 таких нарушения политики; для компаний, особенно пострадавших от этого, бремя было во много раз выше. На долю регулируемых персональных, финансовых и медицинских данных приходилась особенно большая доля этих нарушений. Такие показатели отражают только видимые инциденты и вряд ли в полной мере отражают фактическое использование.
С экономической точки зрения, централизованные ИТ-системы конкурируют с бесплатными или финансируемыми из частных источников альтернативами. Эти альтернативы отличаются низкими барьерами для входа, удобным пользовательским интерфейсом и часто представляют собой новейшую модель. Внутренняя альтернатива выигрывает не только за счет соответствия требованиям, но и только в том случае, если она как минимум столь же удобна и предлагает дополнительную ценность для бизнеса. Она должна обеспечивать поиск необходимой информации, быть доступной в существующих приложениях, избегать ненужного копирования и контекстуализировать ответы в рамках рабочего процесса. Долгосрочное принятие достигается не путем принуждения, а за счет больших преимуществ при меньших личных усилиях.
Это не означает, что технические средства контроля не нужны. Предотвращение потери данных, ограничения для клиентов, управление браузером, ведение журналов и четкие правила использования остаются важными. Однако их эффективность значительно возрастает, если также доступна высокопроизводительная альтернатива. Поэтому правильный подход руководства заключается не только в блокировке теневого ИИ, но и в анализе его первопричин: для каких задач сотрудники его используют? Какие авторизованные системы дают сбои? Какие неэффективности заставляют людей использовать частные учетные записи? Ответы на эти вопросы позволят составить реалистичный список приоритетов для корпоративного ИИ.
Корпоративные знания не создаются в окне чата
Общие ИИ-помощники начинают процесс, опираясь в первую очередь на контекст, предоставленный пользователем или выведенный продуктом из ограниченного числа предыдущих взаимодействий. Такая нейтральность часто полезна для решения личных задач. Однако в деловом контексте она становится риском, как только решения начинают зависеть от исторической, договорной или специфической для клиента информации. Например, надежный ответ на страховой случай может быть получен только путем объединения истории претензий, версии полиса, переписки, нормативных требований и статуса обработки. Одного загруженного договора для этой цели недостаточно.
Необходимые знания редко находятся в одном месте. Они разбросаны по системам ERP, CRM, системам управления документами, системам обработки заявок, хранилищам данных, электронной почте, специализированным приложениям и личным файлам. Кроме того, существуют различные идентификаторы, варианты написания, версии данных и обязанности. Клиент может быть указан под разными именами в трех системах; код продукта может приобрести другое значение после слияния; политика может быть формально доступна, но технически устарела. Языковая модель не может самостоятельно разрешить эти противоречия. Без надежного сопоставления она может, в лучшем случае, создать лингвистически убедительный синтез противоречивых данных.
Таким образом, предоставление контекста — это прежде всего задача интеграции и управления данными. Генерация с расширенным поиском, то есть целенаправленное предоставление релевантного контента в момент запроса, является важным методом, но не полным решением. Также необходимы метаданные, версионирование, проверка личности, проверки авторизации, приоритет источников, сроки действия и правила для конфликтующей информации. Чем больше система предназначена для действий, а не просто для реагирования, тем важнее становятся транзакционный контроль и четко определенное руководство системой.
Простой тест может выявить зрелость: одобренному инструменту задают вопрос, для правильного ответа на который требуются лишь внутренние знания компании. Если он дает общий, уверенный и неверный ответ, то по сути это чат-бот с доступом к корпоративным ресурсам. Если же он просто запрашивает файл, то это чат-бот с функцией загрузки. Истинный корпоративный интеллект проявляется только тогда, когда он получает доступ к соответствующим системам законным, прозрачным и в режиме реального времени, распознает неопределенность и помещает ответ в контекст компании.
Контекстный слой становится производственным капиталом
Ключевой архитектурный компонент находится между моделью и операционной деятельностью бизнеса. Этот слой можно описать как контекстную платформу, базу знаний или слой интеграции и оркестрации. Его название менее важно, чем его функция: он сопоставляет сущности друг с другом, связывает источники данных, проверяет разрешения, предоставляет определения, управляет инструментами и документирует, как был получен ответ или действие. В идеале, эту работу не следует начинать заново для каждого варианта использования, а следует создавать как многократно используемый корпоративный строительный блок.
С экономической точки зрения, этот слой напоминает производительный основной капитал. Первоначальное подключение к архиву контрактов, первое корректное присвоение идентификаторов клиентов или первая реализация логики утверждения влекут за собой высокие первоначальные затраты. Однако, как только эти элементы стандартизированы, на их основе можно строить дальнейшие сценарии использования. Предельные издержки второго, третьего и пятого использования должны снижаться. Уже один этот эффект оправдывает платформенную стратегию: часть инвестиций становится пригодной не только для одного проекта, но и для растущего числа будущих процессов.
Однако эффект повторного использования не возникает автоматически. Многие предполагаемые платформы представляют собой набор интерфейсов, подсказок и пользовательских решений, специфичных для конкретного проекта. Каждое новое приложение затем необходимо анализировать, интегрировать и обеспечивать его безопасность заново. Кривая затрат остается линейной, в то время как возникают дополнительные зависимости. Поэтому настоящим тестом на зрелость является определение того, какие конкретные компоненты из первого варианта использования могут быть повторно использованы во втором без перестройки. К повторно используемым компонентам относятся, например, службы идентификации, коннекторы, контроль доступа, каталоги данных, процедуры оценки, ведение журналов, доступ к моделям и стандартизированные процедуры утверждения пользователями.
Контекстный слой стратегически важнее, чем приверженность одной конкретной модели. Модели быстро совершенствуются, цены меняются, и для разных задач требуются разные преимущества. Поэтому компаниям необходима возможность контролируемого переключения между моделями или параллельного использования нескольких. Однако переключение не является полностью бесплатным: поведение запросов, форматы вывода, фильтры безопасности, контекстные окна и профили производительности различаются. Хорошая архитектура снижает эти затраты на переключение за счет абстракции, стандартизированных интерфейсов и повторяемых тестов, а не за счет создания нереалистичного впечатления полной взаимозаменяемости.
Суверенитет данных включает в себя нечто большее, чем просто исключение обучения
В общественном обсуждении давно уделяется внимание вопросу о том, используются ли входные данные для обучения модели. Хотя этот вопрос важен для бизнеса, он слишком узок. Вся цепочка хранения и обработки данных имеет решающее значение: где обрабатываются входные данные? Какие части документа передаются? Где хранятся история чатов, кэши, журналы и векторные представления? Как долго они хранятся? Какие субподрядчики имеют технические контактные лица? Какая правовая база применяется? Могут ли администраторы просматривать, экспортировать и удалять контент? Как осуществляется резервное копирование?
Отдел маркетинга при определенных обстоятельствах может ответственно использовать черновик, обработанный сторонними организациями. К неопубликованным коммерческим показателям, коммерческой тайне, данным о здоровье, судебным делам или критической инфраструктуре применяются другие стандарты. Поэтому класс риска должен основываться не только на используемом инструменте, но и на типе данных, предпринятых действиях, потенциальном ущербе и уровне человеческого контроля. Одна и та же модель может представлять низкий риск при переписывании публичного пресс-релиза и высокий риск при автоматической обработке заявки на кредит или страхового случая.
Надежная архитектура минимизирует перемещение данных. Информация по возможности остается в существующих системах; предоставляется только контекст, необходимый для выполнения задачи, с учетом существующих правил доступа. Запросы авторизуются для каждого пользователя отдельно, конфиденциальные поля маскируются там, где это необходимо, а выходные данные классифицируются в соответствии с их содержанием. Для особо важных процессов может быть целесообразно использовать региональную обработку, выделенные экземпляры, конфиденциальные вычислительные среды или локальное развертывание. Однако полностью внутренняя эксплуатация не является автоматически более безопасной или более экономичной, поскольку эксплуатация, обновление, мониторинг, поддержка моделей и специализированный персонал влекут за собой значительные затраты.
Формула, описывающая перенос модели на данные, описывает разумный принцип, но не должна восприниматься как техническое упрощение. Даже в случае федеративных или локально связанных решений фрагменты, встраивания или метаданные могут попадать во внешние сервисы. Документированный анализ потока данных на уровне компонентов имеет решающее значение. Только когда для каждого этапа можно продемонстрировать, какие данные куда попадают и как они защищаются, можно надежно оценить суверенитет данных.
Регулирование превращает отслеживаемость в экономический фактор
В регулируемых отраслях поток данных не является абстрактным идеалом безопасности. Финансовые учреждения, в соответствии с европейскими правилами цифровой операционной устойчивости, должны систематически оценивать риски, создаваемые информационными и коммуникационными технологиями, а также сторонними поставщиками. Соглашения о конфиденциальности, профессиональная тайна, законы о защите данных и отраслевые правила также требуют от компаний возможности объяснять процессы обработки данных, обязанности и меры контроля. Приложение ИИ, качество отклика которого убедительно, но путь передачи данных которого не подлежит аудиту, не сможет пройти приемочное тестирование в эксплуатации.
В европейском законодательстве об ИИ систематическое управление приобретает все большее значение. Значительная часть европейской нормативно-правовой базы действует с августа 2026 года, в то время как отдельные обязательства для определенных систем высокого риска будут вступать в силу поэтапно. Это не означает полного запрета генеративного ИИ для компаний. Скорее, необходима надежная классификация, основанная на области применения и роли. Общая модель, специализированная система, построенная на ее основе, и компания, использующая эту систему, могут иметь разные обязательства. Прозрачность, документация, человеческий контроль, качество данных, точность, кибербезопасность и отслеживаемость особенно важны для приложений высокого риска.
Соответствие требованиям — это не просто фактор стоимости. Многократно используемая архитектура управления может сократить время выхода на рынок, поскольку не каждому проекту нужно заново изобретать свои правила. Стандартизированные классы рисков, утвержденные пути моделирования, техническое журналирование, шаблоны оценки и определенные уровни утверждения снижают неопределенность. Таким образом, управление трансформируется из функции контроля на последующих этапах в продуктивную инфраструктуру. Экономическая выгода становится особенно очевидной во время второго и третьего развертываний, когда протестированные компоненты могут быть использованы повторно.
Компаниям также следует различать риск, связанный с моделью, и риск, связанный с процессом. Модель может быть технически мощной, в то время как плохо разработанный процесс продолжает использовать некорректные источники данных, имеет нечеткие обязанности или не позволяет отменить ошибочные действия. И наоборот, ограниченная модель может быть очень полезной в четко определенном, хорошо контролируемом процессе. Поэтому качество общей архитектуры чаще является решающим фактором для нормативной и экономической целесообразности, чем максимальная производительность модели в общих тестах.
🤖🚀 Управляемая платформа ИИ: более быстрые, безопасные и интеллектуальные решения на основе ИИ с UNFRAME.AI

Платформа управляемого ИИ — Изображение: Xpert.Digital
Здесь вы узнаете, как ваша компания может быстро, безопасно и без высоких барьеров для входа внедрить индивидуальные решения на основе искусственного интеллекта.
Управляемая платформа искусственного интеллекта — это комплексное и беззаботное решение для вашего бизнеса в сфере искусственного интеллекта. Вместо того чтобы возиться со сложными технологиями, дорогостоящей инфраструктурой и длительными процессами разработки, вы получаете готовое решение, адаптированное под ваши потребности, от специализированного партнера — зачастую всего за несколько дней.
Основные преимущества с первого взгляда:
⚡ Быстрая реализация: от идеи до готового к использованию приложения за считанные дни, а не месяцы. Мы предлагаем практические решения, которые создают немедленную добавленную стоимость.
🔒 Максимальная безопасность данных: Ваши конфиденциальные данные остаются с вами. Мы гарантируем безопасную и соответствующую законодательству обработку данных без их передачи третьим лицам.
💸 Отсутствие финансового риска: вы платите только за результат. Полностью исключаются высокие первоначальные инвестиции в оборудование, программное обеспечение или персонал.
🎯 Сосредоточьтесь на своем основном бизнесе: сконцентрируйтесь на том, что у вас получается лучше всего. Мы берем на себя всю техническую реализацию, эксплуатацию и обслуживание вашего решения на основе ИИ.
📈 Перспективность и масштабируемость: ваш ИИ растет вместе с вами. Мы обеспечиваем непрерывную оптимизацию и масштабируемость, а также гибко адаптируем модели к новым требованиям.
Более подробная информация здесь:
От проекта в области искусственного интеллекта до бизнес-операционной системы
Ответственность не должна исчезать между этапами лицензирования и консультирования
Сервисы искусственного интеллекта, ориентированные на потребителя, продаются как инструменты. Поставщики справедливо отмечают, что расчеты расходов могут быть неточными, и пользователи должны проверять результаты. Эта модель понятна для недорогого массового рынка. Однако в бизнес-приложениях возникает разрыв в ответственности, как только эти же расходы достигают клиентов, влияют на отчетность перед регулирующими органами или запускают финансовые процессы. Поставщик доступа продает возможность использования сервиса, но, как правило, не берет на себя ответственность за результат конкретного бизнес-процесса.
Даже традиционная модель интеграции может оставлять этот пробел открытым. Поставщик услуг анализирует, разрабатывает и интегрирует систему в течение нескольких месяцев, выставляет счета за время и материалы и, наконец, поставляет готовую систему. Контракт может быть формально выполнен, даже если инструмент плохо воспринимается в повседневной работе, выдает слишком много ошибок или не обеспечивает измеримого улучшения процессов. С одной стороны, продается доступ; с другой — рабочая сила. В обоих случаях никто не обязательно финансово связан согласованным результатом.
Таким образом, корпоративный ИИ требует четкого распределения ответственности. Бизнес-подразделения, ИТ-отдел, отдел информационной безопасности, отдел защиты данных, отдел управления рисками и поставщики должны знать, кто отвечает за качество данных, кто выбирает модели, кто устанавливает ограничения, кто утверждает расходы и кто принимает решения в случае сбоев. Для автоматизированных действий крайне важны отслеживаемость, возможности отзыва и четко определенные процедуры эскалации. Человеческий контроль эффективен только в том случае, если у проверяющего достаточно времени, опыта и информации; обычный щелчок мышью сводит человеческий контроль к простой формальности.
Модели вознаграждения, ориентированные на результат, могут улучшить систему стимулирования, но они не являются панацеей. Они работают только в том случае, если результаты измеримы, поддаются оценке и защищены от манипуляций. Для четкого процесса, такого как сокращение времени обработки, снижение количества ошибок или увеличение числа решенных дел, можно согласовать элементы, основанные на результатах. Оценка результатов сложнее для стратегических задач, требующих знаний. Часто целесообразна гибридная модель, состоящая из базовой заработной платы, показателей качества и использования, а также компонента, связанного с согласованными бизнес-результатами.
Второй пример использования демонстрирует преимущества платформенной экономики
Многие процессы отбора ориентированы на первый, намеренно простой сценарий использования. Составление резюме документов, написание электронных писем, объяснение содержимого загруженного файла или генерация текстовых вариантов хорошо подходят для универсальных моделей, поскольку практически весь контекст доступен по запросу. Такие задачи демонстрируют языковые возможности модели, но вряд ли зрелость корпоративной платформы. Зачастую их можно решить с помощью всего нескольких лицензий и приемлемых затрат на внедрение.
Второй вариант использования более информативен. Если одна и та же система должна сверять счета-фактуры поставщиков с договорами, ей необходим доступ к архиву договоров, системе ERP, матрице утверждений, основным данным и правилам обработки исключений. Она должна объединять различные назначения, объяснять расхождения, соблюдать полномочия и передавать вопросы соответствующим специалистам в случае неопределенности. Здесь акцент смещается с модели на интеграционную и процессную логику. Этот вариант использования проверяет, действительно ли ранее созданная архитектура пригодна для повторного использования.
Платформа заслуживает своего названия, когда второе развертывание становится относительно быстрее и дешевле, и этот эффект усиливается при последующих применениях. Если каждый новый вариант использования остается таким же дорогим, как и предыдущий, то значительной синергетической экономии не существует. В этом случае компания владеет лицензией плюс очередью на консультационные услуги. Поэтому важнейшим коммерческим критерием является определение надежной стоимости и сроков второго и третьего развертываний еще до принятия решения о первом.
Такой подход также меняет расчет инвестиций. Первоначальный вариант использования не должен нести все затраты на платформу изолированно, если значимые компоненты будут использоваться повторно в дальнейшем. И наоборот, нечестно рассматривать расплывчатое будущее повторное использование как преимущество, не уточнив конкретные последующие процессы, ответственных лиц и бюджеты. Грамотный расчет разделяет единовременные инвестиции в платформу, разработку, специфичную для конкретного варианта использования, текущие затраты на модель и инфраструктуру, а также затраты на мониторинг, обеспечение качества и управление изменениями. Только тогда можно определить реалистичные общие затраты на несколько лет.
Затраты редко бывают обусловлены исключительно вызовами моделей
В случае генеративного ИИ внимание часто сосредоточено на лицензионных сборах или стоимости токенов. Эти затраты очевидны, но зачастую не являются доминирующими в сложных корпоративных приложениях. Дополнительные расходы включают очистку данных, интерфейсы, управление идентификацией, аудит безопасности, наборы данных для оценки, мониторинг, время специалистов, обучение, поддержку и постоянные корректировки. Неясное право собственности на данные, индивидуальные решения для конкретных проектов и ручная доработка из-за непостоянного качества становятся особенно дорогостоящими.
Исследования рынка выявляют противоречие между завышенными ожиданиями и ограниченной масштабируемостью. В международном опросе 2000 руководителей предприятий выяснилось, что лишь около четверти инициатив в области ИИ достигли ожидаемой окупаемости инвестиций; только 16 процентов были масштабированы в масштабах всей компании. В то же время 72 процента считают конфиденциальные данные компании критически важными для ценности генеративного ИИ, а 68 процентов считают критически важной интегрированную общекорпоративную архитектуру данных. Эти цифры не являются абсолютной истиной, но они показывают, что доступ к моделям сам по себе не обеспечивает ни масштабируемости, ни окупаемости инвестиций.
Даже очень высокие показатели неудач в исследованиях следует интерпретировать с осторожностью. Широко цитируемый анализ 2025 года пришел к выводу, что 95 процентов рассмотренных инициатив не принесли никакой измеримой финансовой выгоды. Методология, размер выборки и определение успеха ограничивают обобщаемость этого вывода; кроме того, многие проекты все еще находились на ранних стадиях. Тем не менее, результат указывает на реальную закономерность: универсальные инструменты могут повысить индивидуальную производительность, но эта экономия времени не автоматически приводит к снижению затрат, увеличению производительности или дополнительному доходу.
Поэтому для оценки инвестиций показатели процесса важнее показателей активности. Количество пользователей, запросов или сгенерированных текстов измеряет принятие решения, а не экономический успех. Более актуальными являются время обработки, стоимость транзакции, частота ошибок, трудозатраты на доработку, пропускная способность, время обработки дебиторской задолженности, коэффициент разрешения проблем и удовлетворенность клиентов. Повышение производительности приводит к финансовому результату только тогда, когда компания перераспределяет ресурсы, устраняет узкие места, продает дополнительные услуги или фактически избегает затрат.
Частная модель пока еще не является корпоративным ИИ
Термины «частный ИИ», «частная языковая модель» и «корпоративный ИИ» часто используются как синонимы. Частная модель в первую очередь описывает технические и договорные условия, в которых модель функционирует, и кто имеет к ней доступ. Она может работать локально, в выделенной облачной среде или через высокозащищенный сервис. Однако эта характеристика мало что говорит о том, понимает ли система соответствующие бизнес-данные, правильно ли применяет разрешения или надежно ли поддерживает тот или иной процесс.
Компания может использовать модель, полностью разработанную собственными силами, и всё равно в итоге получить разрозненные данные, низкое качество поиска, нечёткое распределение обязанностей и отсутствие оценки производительности. Напротив, тщательно настроенное облачное решение может быть более экономичным и достаточно безопасным для определённых классов данных. Правильное решение зависит от конфиденциальности, задержки, объёма, потребностей в интеграции, нормативных требований, внутренних операционных ресурсов и стратегической независимости. Выбор локального решения не должен быть символом статуса, а скорее результатом анализа рисков и затрат.
Настоящий корпоративный ИИ включает в себя модель, контекстный и интеграционный слой, управление, контроль доступа, логику процессов, тестирование, мониторинг и операционную модель с четко определенными обязанностями. Он также включает коммерческую структуру, которая делает прозрачными затраты на разработку и риски производительности. Частная модель может быть частью этой архитектуры, но она не заменяет ее. Ключевым критерием является не то, где работает только модель, а то, контролирует ли вся система, обеспечивает ли она проверяемое улучшение и экономически повышает эффективность бизнес-процесса.
Это различие также защищает от излишней технической сложности. Не каждый вариант использования требует большой модели, и не каждая задача является генеративной. Классические методы поиска, правила, статистические модели или автоматизация процессов могут быть более экономически эффективными, стабильными и простыми в тестировании. Зрелая корпоративная архитектура подразумевает развертывание генеративного ИИ только там, где его способность обрабатывать неструктурированную информацию и переменный язык создает ощутимую добавленную ценность.
Для быстрой реализации необходимы строгие ограничения, а не громкие обещания
Четко определенный первоначальный сценарий использования существующих систем должен привести к результатам, близким к производственным, в течение нескольких недель, а не многих кварталов. Это не означает, что полную трансформацию можно завершить быстро. Речь идет о строго структурированном процессе с четко определенными пользователями, источниками данных, измеримыми пороговыми значениями качества и контролируемым операционным путем. Если даже этот начальный этап занимает более шести месяцев, это может указывать на отсутствие стандартных компонентов, нечеткие данные, чрезмерно большой объем работ или архитектуру интеграции, построенную с нуля.
Однако скорость не следует путать со спешкой в производство. Убедительный прототип лишь демонстрирует, что модель может производить пригодные для использования результаты в благоприятных условиях. При оперативной реализации необходимо учитывать редкие события, устаревшие документы, противоречивые данные, изменения доступа, сбои и вредоносный ввод. В частности, атаки с использованием быстрого внедрения могут пытаться обойти системные инструкции через содержимое документов или веб-сайтов. Поэтому технические ограничения, проверка содержимого, отдельные разрешения и тестирование с использованием реалистичных сценариев инцидентов имеют важное значение.
Разумный процесс внедрения начинается с измеримой проблемы, а не с предпочтительной модели. Затем определяются потоки данных, роли пользователей, риски ошибок и экономические рычаги. После этого следует ограниченный пилотный проект с реальными рабочими процессами, основой для сравнения и четкими критериями завершения. Масштабирование происходит только после того, как будет продемонстрировано качество, приемлемость, безопасность и влияние на процесс. Такой поэтапный подход снижает невозвратные затраты и предотвращает финансирование технически привлекательного эксперимента в течение многих лет без доказанной коммерческой ценности.
Управление изменениями также имеет решающее значение. Сотрудники должны понимать, для чего предназначена система, в чем заключаются ее ограничения и как сообщать об ошибках. Экспертиза не должна незаметно обесцениваться за счет предполагаемой автоматизации. Наилучшие результаты часто достигаются, когда опытные сотрудники участвуют в оценке случаев, обработке исключений и обратной связи. Таким образом, индивидуальная коррекция становится обучающим организационным процессом, даже если сама базовая модель не учится постоянно на основе каждого разговора.
Четыре критерия тестирования отличают платформы от переупакованных чат-ботов
Первый ключевой вопрос заключается в том, знает ли система компанию в необходимой степени, или пользователям приходится восстанавливать контекст для каждой транзакции. Поэтому для наглядной демонстрации следует использовать собственные данные компании, терминологию и реальные права доступа, а не заранее подготовленную базу данных-шаблон. Оценка должна учитывать не только правильность ответов, но и то, как система обрабатывает отсутствующую, противоречивую и некорректную информацию. Надежная система должна распознавать ограничения и делать неопределенности видимыми.
Второй вопрос касается полного пути обработки данных. Компании должны документировать путь обработки, места хранения, правила хранения, субподрядчиков, ведение журналов и варианты удаления. Не менее важно и то, может ли архитектура сохранять данные в существующих системах и предоставлять только необходимые фрагменты. Заявления о безопасности надежны только тогда, когда их можно связать с конкретным вариантом продукта и конфигурацией.
Третий вопрос заключается в том, кто несет экономическую и организационную ответственность за согласованный результат. Необходимо уточнить, что произойдет, если точность, производительность, время обработки или другие целевые значения не будут достигнуты. Простое обращение к планированию будущего продукта выявляет пробел в подотчетности. В то же время компания должна признать свою собственную ответственность, особенно в отношении качества данных, определения процессов, обучения пользователей и принятия экспертных решений. Ответственность за результаты не может быть полностью передана на аутсорсинг.
Четвертый вопрос касается затрат на второй вариант использования. Поставщики должны продемонстрировать, какие соединения, разрешения, определения, тесты и операционные функции используются повторно. Прозрачный расчет затрат для последующего процесса более информативен, чем общий слайд о платформе. Он показывает, реальна ли экономия за счет масштаба или каждое расширение запускает новый проект интеграции. Эти четыре вопроса намеренно смещают акцент с названия модели на контекст, суверенитет данных, ответственность и совокупные экономические выгоды.
Соответствующая операционная архитектура основана на оценке рисков, а не на идеологических соображениях
Для большинства компаний не существует единственно правильного метода развертывания. Портфельный подход более экономически целесообразен. Обработка общедоступного контента и задач, требующих низкого уровня риска, может осуществляться с помощью стандартизированных корпоративных помощников. Для внутренних запросов к базе знаний необходимы контролируемые коннекторы, проверки авторизации и верификация источников. Критические бизнес-процессы требуют более строгих потоков данных, воспроизводимых тестов, согласования с человеком и, при необходимости, выделенной или локальной обработки. Высокоэффективные автоматизированные действия дополнительно требуют строго контролируемых инструментов, транзакционного контроля и процедур отката.
Такой многоуровневый подход позволяет избежать двух дорогостоящих крайностей. Первая — это передача всех данных универсальному помощнику и опора на договорные положения. Вторая — это разработка и эксплуатация всех функций ИИ полностью собственными силами. Между этими двумя крайностями находятся управляемые облачные сервисы, региональная обработка, ключи, принадлежащие клиенту, частные сетевые каналы, выделенные экземпляры, локальные модели и гибридные архитектуры. Выбор их комбинации должен зависеть от конкретного риска.
Выбор модели также может быть многоуровневым. Более мелкие модели часто дешевле, быстрее и достаточны для узкоспециализированных задач. Более крупные модели могут быть предпочтительнее для сложных языковых задач, планирования или работы с противоречивыми документами. Интеллектуальный маршрутизатор может назначать задачи различным моделям на основе чувствительности, сложности и стоимости. Необходимым условием является стандартизированная система оценки, гарантирующая, что ценовые преимущества не будут нивелированы более высокими затратами на ошибки и доработки.
В долгосрочной перспективе самым важным активом окажется не самая высокоэффективная отдельная модель, а скорее способность компании безопасно и быстро внедрять модели в производственные процессы. Эта способность включает в себя качество данных, модульную архитектуру, экспертизу, управление и культуру измеримых улучшений. Её сложнее скопировать, чем лицензию, и она остаётся ценной, даже если ведущий поставщик моделей изменится.
От проекта в области искусственного интеллекта до бизнес-операционной системы
Стратегическая перспектива смещается от вопроса о том, какого помощника приобрести, к вопросу о том, какие оперативные возможности необходимо развивать. Компаниям необходим каталогизированный перечень источников данных, четко определенные обязанности, стандартизированные методы доступа, модельный портфель, многократно используемые процедуры оценки и приоритизация на основе экономической ценности. Без этой основы возникает множество разрозненных инструментов, преимущества которых трудно сравнить, а риски накапливаются.
Выбор сценариев использования должен быть сосредоточен на повторяющихся, насыщенных данными и трудоемких процессах. Особенно привлекательными являются переходы между функциями и системами, когда сотрудникам необходимо искать, сравнивать, передавать или объяснять информацию. В таких ситуациях генеративный ИИ может раскрыть неструктурированный контент и дополнить традиционную автоматизацию. Процессы без четкой информационной основы, без измеримого начального состояния или с чрезвычайно высоким уровнем ошибок и ограниченными возможностями управления менее подходят.
Для каждого приоритетного случая руководство должно сформулировать экономическую гипотезу. Эта гипотеза описывает, какое узкое место будет устранено, какой ключевой показатель эффективности изменится, какие затраты будут понесены в полном объеме и как эффект будет реализован в операциях. Простого предположения об экономии времени недостаточно. Должно быть ясно, позволит ли высвободившееся время обрабатывать больше заказов, сократить время ожидания, повысить качество или фактически избежать затрат на персонал и внешние издержки. Только такая взаимосвязь преобразует техническую производительность в экономическую выгоду.
Параллельно необходимо принять архитектурное решение, которое выходит за рамки первоначального пилотного проекта, не создавая сразу же громоздкую платформу. Компактное, общее ядро, включающее идентификацию, логирование, доступ к моделям, коннекторы данных и оценку, может развиваться постепенно. Каждое новое приложение должно улучшать это ядро и генерировать как можно меньше пользовательской логики. Такой подход создает кумулятивные возможности, а не набор демонстрационных примеров.
Фактическое решение о покупке зависит от выбранной модели
Модели ИИ становятся все более мощными, дешевыми и все глубже интегрированными в стандартное программное обеспечение. Это снижает фактор дифференциации, заключающийся лишь в доступе. Компании фактически приобретают или создают самостоятельно компоненты, окружающие модель: бизнес-контекст, контролируемое хранение данных, надежная интеграция, отслеживаемость решений, организационная подотчетность и кривая затрат, которая становится более выгодной с увеличением количества вариантов использования. Эти элементы определяют, останется ли ИИ инструментом повышения производительности для отдельных сотрудников или превратится в общекорпоративную возможность.
Корпоративная лицензия не является ни бесполезной, ни достаточной для этой цели. Зачастую она представляет собой разумный минимум для общих задач и может уменьшить использование теневого ИИ. Однако для регулируемых или критически важных для бизнеса процессов она должна быть дополнена архитектурой данных, управлением, проектированием процессов и измеримой ответственностью за результаты. Аналогично, частная модель сама по себе не является решением. Техническая изоляция без контекста и операционной концепции просто создает частный остров.
Второй пример использования дает наиболее серьезное предупреждение. Если все соединения данных, правила, тесты и обязанности приходится перестраивать, первоначальный успех был достигнут не за счет платформенного эффекта, а скорее в рамках самостоятельного проекта. И наоборот, если основные компоненты используются повторно, а время получения выгоды сокращается, начинается настоящая экономическая целесообразность. Ценность тогда заключается не в эффектной демонстрации, а в обучающей инфраструктуре, которая постоянно совершенствует процессы при меньших предельных издержках.
Таким образом, сотрудники, уже проголосовавшие с использованием личных аккаунтов, представляют собой не просто проблему безопасности. Они демонстрируют высокий спрос и низкую терпимость к некачественным инструментам. Задача руководства компании — преобразовать этот спрос в контролируемую, превосходящую альтернативу: систему, которая понимает бизнес, адекватно защищает конфиденциальные данные, ответственно обрабатывает ошибки и не начинает работу с нуля при следующем использовании. Все, что меньше этого, остается чат-ботом с авторизацией — полезным, часто впечатляющим, но пока еще не корпоративным ИИ.
Консалтинг - Планирование - Внедрение

Konrad Wolfenstein
Я с удовольствием стану вашим личным консультантом.
Вы можете связаться со мной по адресу wolfenstein∂xpert.digital или
Просто позвоните мне по номеру +49 7348 4088 965 .