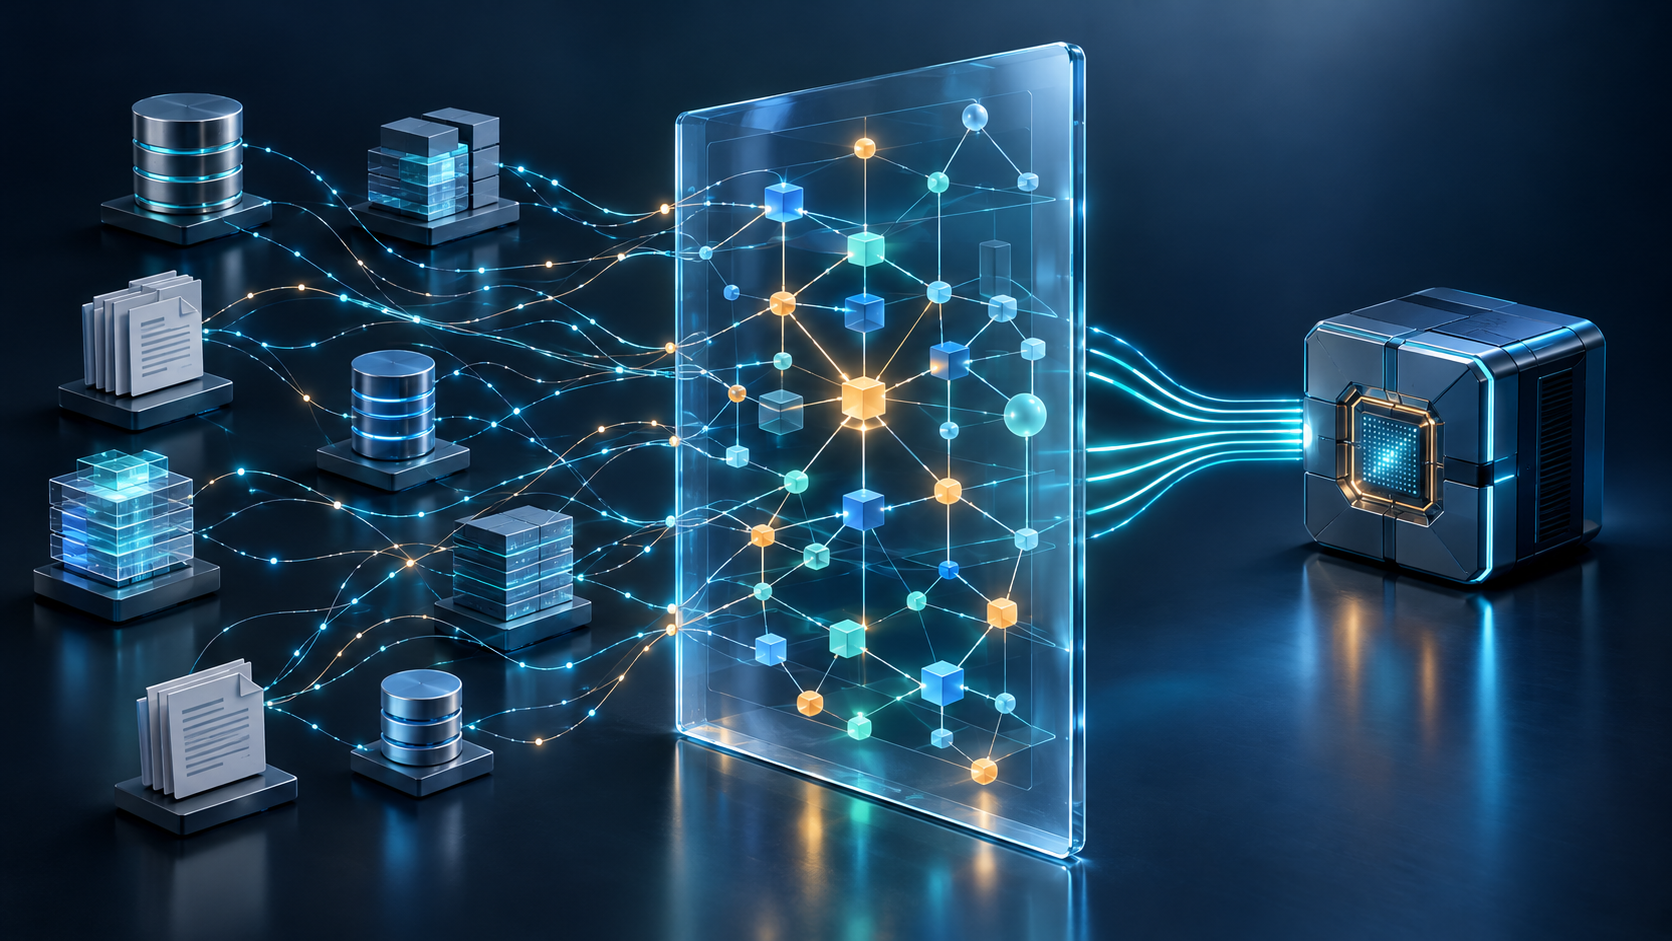
Mais do que um chatbot: como uma camada semântica torna a IA mais fiável nas empresas – O fator de sucesso subestimado para a IA empresarial – Imagem criativa sobre o tema, com IA: Xpert.Digital
Inteligência artificial nos negócios: porque é que uma terminologia clara determina o sucesso económico
Quando a IA acelera o caos: porque é que as empresas precisam de conhecimento empresarial partilhado
Menos contradições, melhores decisões: o que uma camada semântica pode fazer pelas empresas
As empresas estão a investir em inteligência artificial para acelerar processos e tomar decisões mais acertadas. Mas um modelo de linguagem robusto, por si só, não garante o sucesso empresarial. Se as áreas de vendas, finanças e serviço ao cliente interpretarem os termos-chave de formas diferentes, a IA pode fornecer respostas contraditórias — e disseminar os erros mais rapidamente. Uma camada semântica visa solucionar este problema: torna os termos, as relações e as regras utilizáveis e compreensíveis em diversas aplicações. O seu valor reside não só em respostas mais precisas, mas também na redução do esforço de coordenação e na reutilização do conhecimento corporativo. Contudo, uma camada semântica pode revelar ambiguidades organizacionais, mas não as resolverá sozinha. Portanto, o que importa é a forma como as empresas mapeiam a sua realidade empresarial, definem as responsabilidades profissionais e medem os benefícios reais.
Relacionado a isto:
Camada Semântica para a IA Empresarial: Porque é que a Relevância para os Negócios Determina o Retorno do Investimento em IA
Sem conceitos claros, a IA automatiza o caos
Uma camada semântica torna os termos, relações e regras de negócio partilhados e verificáveis para aplicações de IA. O seu valor económico reside, portanto, não só em melhores respostas, mas também na perspectiva de redução dos esforços de coordenação, conhecimento empresarial reutilizável e decisões mais controláveis. No entanto, a principal limitação é que tal camada semântica pode revelar ambiguidades organizacionais, mas não pode resolvê-las sozinha.
Para as empresas, isto muda a questão estratégica. Já não se trata apenas de qual o modelo de linguagem mais eficiente ou da rapidez com que outro assistente pode ser desenvolvido. O que se torna mais importante é a realidade empresarial em que estes sistemas se baseiam. Se as áreas de vendas, finanças e serviço ao cliente utilizarem o mesmo termo de formas diferentes, uma IA tecnicamente poderosa pode disseminar resultados contraditórios de forma ainda mais rápida e ampla. O desafio económico reside em transformar a informação dispersa numa base robusta e permanentemente utilizável para a tomada de decisões.
A diferença entre utilização e resultado
A adoção da IA está a crescer, mas a sua utilização ainda não provou ter um impacto económico. Em 2025, 19,95% das empresas da UE inquiridas com dez ou mais trabalhadores utilizavam pelo menos uma tecnologia de IA; isto representou um aumento de 6,47 pontos percentuais em relação a 2024. Foram observadas diferenças significativas entre as dimensões das empresas: a participação foi de 17% para as pequenas empresas, 30,36% para as médias empresas e 55,03% para as grandes empresas. A investigação abrangeu um amplo espectro de tecnologias de IA, desde a análise de texto a máquinas autónomas, mas não se concentrou especificamente na utilização de IA generativa ou camadas semânticas.
Um panorama diferente emerge de um inquérito internacional empresarial realizado em 2026. Neste inquérito, 80% dos inquiridos relataram um aumento da produtividade pessoal devido à IA, enquanto 37% indicaram uma contribuição positiva para os lucros antes de juros e impostos (EBIT) das suas empresas. Apenas cerca de 6% pertenciam a um grupo particularmente bem-sucedido, atribuindo pelo menos 5% do seu EBIT à IA e reportando simultaneamente benefícios significativos. O inquérito contou com 1.719 participantes de 97 países e baseou-se em dados autodeclarados; não é, portanto, diretamente comparável às estatísticas empresariais europeias.
Os dados não comprovam uma relação causal entre uma camada semântica e outra. Em vez disso, ilustram o problema empresarial: entre a simplificação do trabalho individual e o sucesso empresarial mensurável reside um esforço de tradução organizacional. É precisamente nesta interface que uma camada partilhada de significado se torna relevante.
A importância passa a fazer parte da infraestrutura operacional
Uma camada semântica liga as estruturas de dados técnicos com conceitos de negócio, como cliente, contrato, reclamação ou receita. Descreve, por exemplo, quais os campos de dados que pertencem a um cliente, como é calculado um indicador-chave de desempenho (KPI) e em que condições se aplica um estado específico. Isto permite que diferentes aplicações utilizem definições comuns em vez de derivarem as suas próprias interpretações a partir de etiquetas de tabelas ou documentos.
Um exemplo simples ilustra as implicações. Uma empresa poderia definir um cliente ativo em vendas através de conversas contínuas, em finanças através de transações comerciais registadas e em serviços através de pedidos de serviço existentes. Nenhuma destas perspectivas está necessariamente errada. O problema surge quando uma IA as mistura inadvertidamente ou apresenta uma perspetiva como universalmente válida.
A solução economicamente viável, portanto, nem sempre consiste numa única definição para todos os efeitos. Muitas vezes, são necessárias várias definições claramente nomeadas, profissionalmente responsáveis e com limites de aplicação inequívocos. Uma camada comum de significado deve refletir as diferenças de forma controlada, e não criar artificialmente uma uniformidade que a empresa não possui de facto. O seu objetivo é a interpretação compreensível, não a homogeneização conceptual.
Do relatório à decisão operacional
Os modelos semânticos clássicos para a business intelligence focam-se principalmente em indicadores-chave, dimensões, agregações e nas relações entre objetos de dados. No entanto, seria uma simplificação excessiva negar-lhes completamente a lógica de negócio ou as funções de autorização: os sistemas de BI consolidados, por exemplo, suportam relações, indicadores-chave calculados e acesso a dados baseado em funções. Portanto, a fronteira entre uma camada semântica de BI e uma camada semântica de IA não representa uma clara divisão tecnológica.
A principal diferença reside nos requisitos. Um relatório, por exemplo, deve representar a receita com precisão. Uma aplicação operacional de IA, por outro lado, também deve ser capaz de determinar a que processo pertence um contrato, qual o acordo especial que prevalece e se a próxima etapa requer aprovação. Isto alarga a tarefa de uma análise consistente para um apoio à decisão dependente do contexto.
Do ponto de vista económico, isto aumenta tanto os potenciais benefícios como os potenciais riscos. Um relatório mal elaborado pode levar a uma decisão errada. Um assistente virtual eficiente pode implementá-la imediatamente. Quanto mais a IA se aproxima de encomendas, pagamentos, compromissos de preço ou decisões de clientes, mais crucial se torna a distinção entre interpretação plausível e lógica de execução vinculativa.
Os quatro pilares do conhecimento empresarial
Uma camada de significado abrangente para a IA empresarial deve considerar quatro tipos de conhecimento: definições de entidades, relações, regras de decisão e correções recolhidas. As definições de entidades especificam o que constitui um objeto de negócio, como um cliente ativo, um contrato crítico ou um caso de alto risco. As relações ligam estes objetos, como uma subsidiária a uma conta ou uma alteração contratual ao contrato principal correspondente.
As regras de decisão descrevem limites, exceções, responsabilidades e condições de aprovação. O registo de correções recolhidas indica onde os especialistas no assunto corrigiram resultados erróneos. Só em conjunto, isto se pode desenvolver em algo mais do que uma simples função de pesquisa: uma base transparente para a forma como a informação pode ser interpretada e dentro de que estrutura.
Do ponto de vista económico, estes tipos de conhecimento devem ser valorizados de forma diferente. A definição de um cliente pode ser reutilizada em diversas aplicações. Uma decisão de exceção, por outro lado, só pode ser aplicada a um contrato específico. Uma boa arquitetura, portanto, não deve apenas armazenar conhecimento, mas também limitar o seu âmbito. Caso contrário, transforma uma exceção local numa regra geral e agrava o próprio erro que pretende prevenir.
Porque é que os documentos são cruciais para a gestão empresarial?
Uma camada semântica baseada em IA deve ser capaz de ligar não só dados estruturados, mas também contratos, e-mails, relatórios e atas de reuniões às respetivas transações comerciais. A razão é óbvia: uma entrada na base de dados pode conter o preço padrão acordado, enquanto um acordo suplementar aprovado estipula condições diferentes. Quem analisar apenas o conjunto de dados pode ignorar a exceção economicamente vinculativa.
O desafio não é simplesmente encontrar uma cláusula. Reside em determinar o seu estatuto. Uma minuta não é um contrato assinado. Um memorando de reunião interna não substitui a aprovação. Um documento posterior pode complementar, substituir parcialmente ou aplicar-se a um âmbito diferente de uma regra anterior. Estas distinções devem ser explicitamente modeladas e revistas para cada caso de utilização específico.
Isto leva-nos a uma importante perspectiva económica: o valor da análise documental não se mede pelo número de páginas processadas. Só se torna relevante quando se pode extrair dela informação fidedigna sobre reclamações, obrigações, prazos ou planos de ação. Um resumo superficial, sem verificação do conteúdo, por outro lado, pode gerar custos de auditoria adicionais e criar uma falsa sensação de segurança.
Quatro fontes de custo devido à ambiguidade semântica
O impacto económico pode ser compreendido através de quatro categorias de custos. Em primeiro lugar, os custos de procura surgem quando os colaboradores precisam de recolher informações e compreender o seu significado. Em segundo lugar, os custos de coordenação surgem quando os departamentos explicam e conciliam diferentes análises. Em terceiro lugar, os custos de erro surgem quando classificações ou regras incorretas levam a retrabalho e a decisões erradas. Em quarto lugar, os custos de repetição surgem quando cada novo projeto de IA exige o desenvolvimento das mesmas bases técnicas a partir do zero.
Esta classificação é uma estrutura de avaliação analítica, não uma distribuição de custos medida empiricamente. No entanto, ajuda a evitar um equívoco comum: o retorno do investimento de uma camada semântica não deve depender exclusivamente da velocidade de resposta de um assistente. Uma resposta pode surgir em segundos e ainda assim ser dispendiosa se vários especialistas tiverem de verificar a sua precisão mais tarde.
Por outro lado, uma melhoria aparentemente insignificante pode gerar um valor considerável. Se uma definição vinculativa encurtar a coordenação entre o departamento financeiro e o departamento de vendas, o benefício poderá impactar vários relatórios e decisões em simultâneo. Portanto, a unidade económica relevante nem sempre é o diálogo individual da IA, mas sim todo o processo de negócio, incluindo os seus ciclos de controlo e correção.
A reutilização cria economias de escala
As definições comuns de indicadores-chave de desempenho (KPIs) podem evitar esforços de implementação duplicados e tornar a mesma lógica de negócio acessível em diferentes aplicações. Aplicada a uma arquitetura de IA mais ampla, esta é a principal promessa de escalabilidade: os termos, relações e regras já lançados devem permanecer utilizáveis para outros casos de utilização. Isto transforma a camada semântica num potencial investimento em infraestrutura, em vez de um componente isolado de projeto.
A lógica económica é semelhante à de um recurso partilhado. A sua criação inicial acarreta custos, enquanto os utilizadores adicionais podem utilizar componentes já existentes. No entanto, o benefício só aumenta se os novos casos de utilização apresentarem sobreposição suficiente de conhecimentos especializados. Um assistente na mesma área de serviço pode socorrer-se de mais conhecimento existente do que uma aplicação para uma área de negócio completamente diferente.
Assim, seria irrealista esperar uma redução automática dos custos a cada projeto subsequente de IA. Novos enquadramentos legais, famílias de produtos ou modelos de negócio podem exigir adições significativas. As economias de escala fiáveis não residem na gratuitidade dos projetos posteriores, mas sim no facto de as questões já esclarecidas não necessitarem de ser novamente esclarecidas sem justificação objetiva.
A produtividade necessita de uma avaliação sóbria
Um estudo com 5.172 colaboradores de atendimento ao cliente revelou que o acesso a um assistente de IA generativo resultou num aumento médio de aproximadamente 15% no número de pedidos de clientes resolvidos por hora. No entanto, o efeito foi distribuído de forma desigual: os colaboradores menos experientes e com menor qualificação beneficiaram mais, enquanto os colaboradores altamente experientes e de alto desempenho apresentaram apenas pequenos ganhos em velocidade e, em alguns casos, uma ligeira queda na qualidade. O estudo demonstra, portanto, um efeito concreto na produtividade dentro de um ambiente de trabalho específico, e não o retorno isolado do investimento numa camada semântica.
Esta distinção é crucial para a avaliação económica. Uma implementação bem-sucedida da IA não revela qual a proporção do sucesso que foi atribuída ao modelo de linguagem, à interface do utilizador, ao conhecimento disponível, à formação ou aos fluxos de trabalho alterados. Qualquer pessoa que extraia previsões genéricas de retorno do investimento para um único componente arquitectónico a partir destes dados está a extrapolar o seu poder explicativo.
Além disso, o tempo de trabalho libertado não se traduz automaticamente numa redução de custos correspondente. Os benefícios económicos surgem, por exemplo, quando uma empresa gere a procura adicional, reduz os tempos de espera, evita horas extraordinárias ou atribui trabalhadores qualificados, que são escassos, a tarefas mais complexas. Sem estas alterações, uma poupança de tempo mensurável pode permanecer em grande parte inexplorada do ponto de vista comercial.
Um cálculo de rendibilidade incluindo todos os custos
Um plano de negócios viável deve começar por analisar o processo atual. Isto inclui números de casos, tempos de processamento, consultas, correções, escalonamentos e as consequências de decisões incorretas. Em seguida, é necessário determinar quais destes fatores são suscetíveis de ser influenciados por uma camada comum de significado. Só assim poderão ocorrer discussões significativas sobre o âmbito do investimento e os benefícios esperados.
Em termos de custos, para além do software e da utilização do modelo, devem também ser considerados a integração de sistemas, a modelação de negócio, a verificação de identidade, a gestão de acessos, os testes e as atualizações contínuas. O envolvimento de profissionais experientes, em particular, não é uma despesa extra gratuita. O seu tempo tem valor económico e fica indisponível para outras tarefas durante a implementação.
Uma avaliação sóbria tem também em conta as perdas iniciais e a incerteza. Inicialmente, uma nova aplicação pode exigir verificações adicionais antes que as rotinas estabilizem. Alguns benefícios só se tornam aparentes com casos de utilização adicionais, enquanto outros não se concretizam. Por conseguinte, uma abordagem de investimento faseada com metas intermédias verificáveis costuma ser mais plausível do que um grande investimento inicial cuja justificação se baseia principalmente em promessas de sinergias futuras.
A medida certa do sucesso
A métrica de sucesso mais importante é o gasto económico por transação comercial concluída corretamente e em conformidade com as normas. Esta perspetiva combina velocidade, qualidade e controlo. Impede que uma elevada taxa de utilização ou um tempo de resposta curto sejam considerados um sucesso se a aplicação gerar retrabalho adicional.
Para efeitos de medição, é necessário distinguir diferentes tipos de erros. Uma métrica incorreta é diferente de uma exceção contratual negligenciada. Uma notificação incompleta difere de uma divulgação não autorizada de dados. Da mesma forma, deve ser claro se um sistema responde a uma questão de forma fiável, se a encaminha legitimamente para um ser humano ou se gera um resultado sem fundamento suficiente.
Uma comparação significativa utiliza casos pré-aprovados e considera todo o processo. Para processos adequados, as implementações faseadas ou os grupos de comparação controlados podem ajudar a distinguir entre melhorias técnicas e alterações gerais. A revisão deve também incluir exceções raras, mas economicamente significativas. Um sistema que lide bem com casos de rotina, mas ignore as exceções críticas, pode ser convincente em média, mas ainda assim inaceitável na prática.
A pesquisa vetorial não substitui um compromisso vinculativo
As bases de dados vetoriais permitem a pesquisa de textos similares relacionados com o conteúdo, tornando a informação comparável através de representações numéricas chamadas embeddings. Os sistemas modernos podem, adicionalmente, utilizar filtros de metadados, pesquisas por palavras-chave e métodos de pesquisa combinados. Seria, portanto, incorrecto descrevê-los como repositórios fundamentalmente independentes do contexto e sem capacidades de filtragem.
A sua função principal, no entanto, responde a uma questão diferente da governação operacional. A semelhança substancial não indica automaticamente se um documento é atual, juridicamente vinculativo ou aplicável a um caso específico. Um sistema de pesquisa pode considerar tais propriedades se forem armazenadas de forma fiável e integradas corretamente na consulta. Contudo, ele não determina, por si só, as decisões de negócio necessárias.
Isto leva a uma lógica de investimento clara para as empresas. Buscas melhoradas e camadas de significado mais robustas podem complementar-se. No entanto, resultados de pesquisa adicionais não substituem responsabilidades e regras claramente definidas. Aqueles que tentam corrigir todas as respostas erradas apenas com um índice de pesquisa mais poderoso correm o risco de fornecer mais material sem esclarecer a sua validade temática.
🤖🚀 Plataforma de IA gerenciada: Soluções de IA mais rápidas, seguras e inteligentes com UNFRAME.AI

Plataforma de IA gerenciada - Imagem: Xpert.Digital
Aqui você aprenderá como sua empresa pode implementar soluções de IA personalizadas de forma rápida, segura e sem grandes barreiras de entrada.
Uma plataforma de IA gerenciada é a sua solução completa e descomplicada para inteligência artificial. Em vez de lidar com tecnologia complexa, infraestrutura cara e processos de desenvolvimento demorados, você recebe uma solução pronta, personalizada para suas necessidades, de um parceiro especializado – geralmente em poucos dias.
Principais vantagens em resumo:
⚡ Implementação rápida: Da ideia à aplicação pronta para uso em dias, não em meses. Oferecemos soluções práticas que geram valor agregado imediato.
🔒 Máxima segurança de dados: Seus dados sensíveis permanecem com você. Garantimos o processamento seguro e em conformidade com as normas, sem compartilhar dados com terceiros.
💸 Sem risco financeiro: você só paga pelos resultados. Os altos investimentos iniciais em hardware, software ou pessoal são completamente eliminados.
🎯 Concentre-se no seu negócio principal: Foque no que você faz de melhor. Nós cuidamos de toda a implementação técnica, operação e manutenção da sua solução de IA.
📈 Preparada para o futuro e escalável: Sua IA cresce com você. Garantimos otimização e escalabilidade contínuas, adaptando os modelos de forma flexível a novas necessidades.
Mais informações aqui:
A influência dos documentos nas decisões empresariais
Os grafos de conhecimento podem fazer muito mais do que apenas criar ligações
Um grafo de conhecimento representa entidades e as suas relações numa estrutura em rede e, por isso, pode constituir um componente importante de uma camada semântica. Ao mesmo tempo, as ontologias formais e os métodos construídos sobre elas também podem suportar inferências lógicas; padrões estabelecidos como OWL não se limitam simplesmente a armazenar ligações básicas. A afirmação categórica de que um grafo de conhecimento não pode representar regras em princípio seria, portanto, tecnicamente imprecisa.
A questão crucial, portanto, é quais as capacidades que uma solução específica realmente combina. Um grafo que contenha objetos empresariais não possui automaticamente uma gestão de direitos abrangente, controlo de processos testado ou tratamento profissionalmente aprovado de casos especiais. Por outro lado, uma arquitetura de grafos adequadamente concebida pode satisfazer partes significativas destes requisitos.
Uma camada semântica deve, portanto, ser entendida menos como um produto necessariamente independente e mais como um conjunto de funções essenciais. Algumas empresas conseguem suprir grande parte disto com modelos de BI, catálogos de dados, sistemas de grafos e conjuntos de regras já existentes. Outras necessitam de uma plataforma adicional. O que é economicamente relevante é a lacuna funcional comprovada, e não o número de novas categorias de produtos introduzidas.
Ligue-se em vez de guardar tudo novamente
Uma camada semântica pode ligar sistemas ERP e CRM existentes, plataformas de dados e repositórios de documentos sem a necessidade de migrar todos os dados da empresa para um novo local de armazenamento único. Os modelos semânticos para indicadores-chave de desempenho (KPIs) também podem ser construídos sobre estruturas de dados existentes e derivar a lógica de consulta apropriada a partir das mesmas. O significado partilhado é, portanto, fundamentalmente distinto do armazenamento físico dos dados.
No entanto, isto não significa que tal arquitetura possa funcionar sem qualquer cópia de dados. Índices de pesquisa, informações extraídas de documentos, caches ou resultados pré-calculados podem ser úteis para casos de utilização específicos. A questão comercial relevante é que informação precisa de ser armazenada, onde e durante quanto tempo, e não se a promessa de proteção completa contra cópias pode ser comercializada.
Um sistema bem concebido equilibra a pontualidade, o tempo de resposta, a disponibilidade, os custos e a privacidade dos dados. Diferentes requisitos de pontualidade podem aplicar-se ao estado de um inventário em comparação com uma cláusula contratual. Uma consulta distribuída por vários sistemas de origem pode ser flexível, mas também aumenta a dependência da sua disponibilidade. Assim sendo, a melhor solução não é necessariamente a mais centralizada ou a mais distribuída, mas sim a mais adequada ao processo de negócio.
A qualidade dos dados continua a ser uma tarefa à parte
Uma camada partilhada de significado não torna automaticamente os dados de origem defeituosos corretos. Mesmo os fornecedores de sistemas de consulta semântica recomendam a abordagem de tarefas fundamentais de consistência, como a normalização de objetos comuns e a limpeza de dados inadequados, o mais cedo possível. A semântica empresarial e a qualidade dos dados são complementares; não são tarefas intercambiáveis.
Um exemplo particularmente ilustrativo é a identidade de um parceiro comercial. Grafias diferentes podem referir-se ao mesmo fornecedor. No entanto, nomes semelhantes também podem pertencer a entidades jurídicas diferentes. Uma fusão precipitada destas identidades pode levar à atribuição incorreta de informações de pagamento, dados de crédito ou relações contratuais. Uma boa arquitetura deve, portanto, ser capaz de revelar quais as atribuições confirmadas e onde existe apenas uma suposição plausível.
Isto é economicamente importante porque os erros nem sempre são visíveis onde ocorrem. Uma correspondência de identidade imprecisa pode influenciar posteriormente diversas análises e decisões. Por conseguinte, a implementação deve concentrar-se não só na qualidade das respostas individuais, mas também na atribuição fiável dos objetos subjacentes. Caso contrário, a reutilização não só multiplica o conhecimento, como também os seus erros.
As regras precisam de se tornar tecnicamente eficazes
Uma política num documento não constitui controlo imposto. Para aplicações de IA, os conceitos de segurança distinguem explicitamente entre requisitos linguísticos e medidas técnicas, tais como funções restritas, permissões limitadas e condições de execução verificáveis. A autonomia excessiva e os direitos de acesso muito amplos, em particular, podem levar a resultados de modelos defeituosos ou manipulados, desencadeando ações prejudiciais.
Uma arquitetura robusta deve, portanto, separar a interpretação da execução. O modelo de linguagem pode, por exemplo, classificar um processo ou sugerir uma ação. Nos processos críticos, a verificação da exatidão de um cálculo, a concessão de uma aprovação ou a possibilidade de execução de uma reserva devem ser asseguradas através de uma lógica verificável e pelos sistemas responsáveis.
Isto esclarece um equívoco comum. Uma camada semântica pode fornecer a base de negócio para um comportamento em conformidade com as regras. No entanto, não garante, por si só, que um modelo de linguagem probabilística aplique todas as regras de forma fiável. A solução economicamente viável surge da interação entre significado, permissões, testes, controlos de processo e cursos de ação claramente definidos.
As permissões fazem parte do significado
Ao aceder ao conhecimento da empresa, é necessário verificar não só a relevância, mas também a autorização de acesso. Os controlos relacionados com documentos podem restringir os resultados da pesquisa com base na identidade do utilizador e nos direitos atribuídos; a sua eficácia depende, entre outros fatores, da correta sincronização da informação de autorização. Portanto, uma base de conhecimento partilhada não significa que todos os utilizadores têm permissão para visualizar o mesmo conteúdo.
Na prática, a dimensão temporal é crucial. Um funcionário pode mudar de função, um projeto pode terminar ou um documento pode ser posteriormente restringido. Se a camada de pesquisa e contexto utilizar permissões desatualizadas, pode expor conteúdo que já não está acessível no sistema de origem. Por conseguinte, a manutenção das permissões deve ser explicitamente incluída nos custos operacionais.
Mesmo perguntas com conteúdo semelhante podem, por um bom motivo, receber respostas diferentes. Dois utilizadores podem pertencer a áreas de responsabilidade diferentes ou ter acesso a conjuntos de dados distintos. Consistência, portanto, não significa uma formulação idêntica, mas sim a aplicação das mesmas regras profissionais num contexto comparável. Um desvio só constitui um problema de qualidade se não puder ser explicado pelo tempo, função, disponibilidade de dados ou pela própria questão.
As correções exigem um processo estruturado
A captura das correções do utilizador é um dos componentes de conhecimento pretendidos de uma camada semântica orientada para a IA. Na gestão de riscos em IA, investigar as intervenções humanas e as suas causas é também considerado uma fonte de informação valiosa para avaliar os sistemas implementados. No entanto, isto não significa que toda a alteração efetuada pelo utilizador deva tornar-se automaticamente uma regra geral.
Um resultado corrigido pode ter causas muito diferentes. Talvez um registo de dados tenha sido atribuído incorretamente. Talvez tenha sido aplicada uma exceção contratual. Talvez a regra anterior da empresa estivesse ultrapassada. Ou talvez o utilizador tenha simplesmente introduzido uma preferência pessoal. Estes casos exigem respostas diferentes e não devem ser incorporados indiscriminadamente numa base de conhecimento partilhada.
Um processo de aprendizagem economicamente viável trata inicialmente o feedback como sugestões verificáveis. Os especialistas no assunto definem o seu âmbito, caráter vinculativo e os testes necessários. Só então uma alteração aprovada é disponibilizada para aplicações futuras. Isto não exige necessariamente o retreino do modelo de linguagem. O ponto crucial é que o erro seja evitado no contexto apropriado no futuro, sem introduzir inadvertidamente novos erros noutros locais.
O controlo de versões protege contra visões retrospectivas falsas
As definições e regras de negócio mudam; portanto, uma camada semântica deve versionar as alterações e atribuí-las a especialistas no assunto para aprovação. As plataformas semânticas existentes já suportam definições versionadas ou consultas de referência validadas, incluindo informações sobre quando e por quem foram confirmadas. Um histórico rastreável não é, portanto, um mero complemento, mas parte integrante da utilização controlada.
Para uma revisão posterior, no entanto, a regra atualmente válida é insuficiente. É também relevante qual a versão que estava em vigor no momento da transação e que informação o sistema era efetivamente capaz de processar nesse momento. Uma alteração contratual recebida posteriormente não deve, inadvertidamente, servir de base para a avaliação de uma decisão anterior. Caso contrário, cria-se uma falsa sensação de clareza em retrospetiva, que não existia no momento da decisão.
Por conseguinte, as empresas devem considerar o histórico de regras, as versões dos documentos e os estados dos dados em conjunto. A relação custo-benefício aqui não se resume a poupar segundos, mas sim a reduzir os custos de resolução de litígios. Aqueles que conseguem reconstruir a base de uma decisão passam menos tempo a reunir as informações a partir de e-mails, ficheiros individuais e lembretes subsequentes.
Liberdade de modelo ainda não é liberdade de fornecedor
O conhecimento empresarial deve ser organizado de forma a que uma alteração no modelo linguístico não exija automaticamente uma reescrita completa dos fundamentos empresariais. O argumento estratégico para tal é sustentado pela dinâmica técnica: entre novembro de 2022 e outubro de 2024, o custo das consultas ao modelo diminuiu mais de 280 vezes, com um nível de desempenho comparável ao do GPT-3.5. Esta comparação refere-se a um nível de referência específico e não deve ser interpretada como uma redução correspondente do custo total de uma aplicação empresarial.
No entanto, a conclusão é plausível: quando o desempenho e os preços dos modelos mudam significativamente, a opção de mudança torna-se cada vez mais valiosa. Um modelo técnico permanentemente utilizável pode evitar que cada atualização tecnológica desencadeie um esforço de tradução técnica abrangente. A independência do modelo assume, assim, o carácter de uma opção estratégica.
No entanto, isto não elimina todas as dependências. As definições podem ainda estar ligadas a formatos, interfaces ou modelos operacionais proprietários da plataforma. Por conseguinte, uma empresa deve avaliar separadamente se pode trocar de modelo de linguagem, exportar as suas definições de conhecimento e continuar a executar toda a solução com um fornecedor diferente. Só esta distinção permite uma avaliação realista dos custos de troca e do poder negocial.
O mercado está a crescer junto
Agora, as definições semânticas são oferecidas explicitamente tanto para BI como para IA: o Snowflake liga métricas de negócio e relações entre entidades com consultas e agentes, enquanto o dbt também fornece as suas métricas definidas centralmente através de interfaces para ferramentas de IA. Paralelamente, o Open Semantic Interchange surgiu como uma iniciativa para a troca de metadados semânticos independente de fornecedores. O projeto foi aceite no Apache Incubator em 2026 com o nome Apache Ossie.
Este desenvolvimento é mais significativo economicamente do que o anúncio de outro produto. Se várias ferramentas puderem utilizar as mesmas definições, a necessidade de criar nova lógica de negócio em cada aplicação será fundamentalmente reduzida. Ao mesmo tempo, as plataformas de dados já estabelecidas poderão assumir uma maior fatia da criação de valor que antes estava reservada a soluções complementares especializadas.
Para os clientes, isto significa: antes de efetuar uma nova compra, deve ser realizado um inventário. Os modelos de dados existentes, os catálogos de indicadores-chave de desempenho (KPIs), os sistemas de autorização e as interfaces podem satisfazer alguns dos requisitos. Os formatos de troca aberta são úteis neste sentido, mas não comprovam totalmente a sua eficácia. É necessário avaliar se as definições, regras e informações contextuais podem ser transferidas entre os sistemas em uso sem perda de significado.
A estrutura de conhecimento da Unframe, vista de forma objetiva
Unframe agrupa as suas funções semânticas sob o nome Knowledge Fabric, ligando conceitos empresariais, lógica de negócio, relações e permissões. A abordagem visa tornar os conjuntos de dados estruturados e o conteúdo dos documentos utilizáveis para casos de utilização específicos e expandir gradualmente a base de conhecimento. A solução é também oferecida com diversos modelos de linguagem e integração em sistemas empresariais existentes.
O apelo económico deste conceito reside na combinação de tarefas anteriormente separadas. Se a integração de sistemas, o contexto empresarial e a utilização controlada funcionarem bem em conjunto, o esforço necessário para aplicações adicionais poderá ser reduzido. No entanto, se esta vantagem se vai concretizar numa empresa específica não pode ser deduzido apenas pelo nome da arquitetura. São necessários resultados verificáveis dos próprios processos da empresa.
Ao mesmo tempo, a questão da propriedade e da operação continua a ser relevante: Unframe distingue entre dados, resultados e configurações de soluções propriedade do cliente, por um lado, e a Plataforma de Conhecimento e outros componentes da plataforma operados pelo fornecedor, por outro. Por conseguinte, a liberdade de escolha em relação ao modelo não deve ser equiparada à completa independência da plataforma. Para uma avaliação fiável, as opções de exportação, os direitos sobre as definições técnicas e a continuidade do sistema em caso de mudança de operador devem ser explicitamente clarificados.
Comece pequeno, mantenha-se adaptável
Uma abordagem orientada a aplicações limita o âmbito da modelação e permite que as definições sejam revistas com os especialistas relevantes no assunto, utilizando tarefas do mundo real. Em vez de mapear imediatamente toda a empresa, os sistemas, objetos, relações e regras necessárias de um processo claramente definido são capturados em primeiro lugar. Os componentes aprovados podem então ser alargados para incluir casos de utilização relacionados.
Do ponto de vista económico, um processo com repetições frequentes, resultados verificáveis e problemas de coordenação suficientemente significativos é particularmente adequado. Um caso de utilização demasiado simples pode apenas demonstrar que uma janela de chat pode ser ligada a uma fonte de dados. Por outro lado, uma introdução demasiado complexa pode criar tantos casos especiais não resolvidos que os benefícios só se tornam aparentes após um longo período.
O equilíbrio ideal reside entre um âmbito limitado e uma base reutilizável. Um projeto piloto não deve ser um protótipo descartável. Ao mesmo tempo, o seu potencial de integração não deve tornar-se uma desculpa para construir um modelo de negócio abrangente antes da primeira melhoria mensurável. O parâmetro continua a ser quais os componentes técnicos que são realmente necessários para o próximo passo significativo.
A responsabilidade profissional determina a aceitação
A introdução da IA não transfere a responsabilidade das pessoas para o software. Toda a definição central requer uma autoridade competente que possa avaliar e aprovar as alterações. Mesmo as estruturas abrangentes para uma IA fiável enfatizam papéis e responsabilidades humanas claramente definidos no tratamento dos sistemas de IA. Por conseguinte, a operação técnica e a autoridade especializada não devem ser tacitamente atribuídas à mesma função.
Isto pode ser inconveniente do ponto de vista organizacional. Uma definição partilhada de rendimento, afiliação de clientes ou risco pode afetar os sistemas-alvo, as responsabilidades e as práticas de avaliação existentes. Uma camada semântica expõe estas diferenças. Não as resolve através da elegância técnica, mas antes exige decisões que poderiam ter sido evitadas anteriormente.
É também aí que reside o seu valor a longo prazo. Quando os conceitos e as regras deixam de estar restritos à mente dos colaboradores individuais ou dispersos por diversas aplicações, a empresa pode tornar-se menos dependente de monopólios informais de conhecimento. Contudo, esta vantagem pressupõe que os especialistas estejam envolvidos no processo de design e percebam a camada de significado como um apoio. Se for introduzida meramente como um instrumento de controlo, a disponibilidade para contribuir com conhecimento empírico valioso poderá diminuir.
Nem todas as empresas precisam da mesma profundidade de conhecimento
Os dados de utilização na Europa revelam diferenças significativas na escala de implementação da IA, sem indicar necessariamente a necessidade de uma arquitectura específica. Além disso, entre as empresas que consideraram utilizar IA, mas ainda não o faziam em 2025, 70,89% referiram a falta de conhecimento especializado relevante como motivo para não a utilizarem; 52,52% apontaram consequências legais incertas e 48,83% preocupações com a privacidade dos dados. Estes números referem-se especificamente a este subgrupo e não a todas as empresas.
Isto permite o desenvolvimento de uma perspetiva de investimento diferenciada. Uma pequena empresa com poucos sistemas e processos geríveis pode necessitar inicialmente de indicadores-chave de desempenho (KPIs) consistentes e de bases de conhecimento claramente mantidas. Uma corporação com inúmeras subsidiárias, linhas de produtos e funções de acesso, por outro lado, pode beneficiar de uma infraestrutura semântica mais abrangente. O nível de detalhe adequado depende da complexidade e do risco, e não da atratividade de um termo tecnológico específico.
A omissão de determinadas tarefas pode também ser economicamente vantajosa. Se uma tarefa ocorrer com pouca frequência, não tiver grandes consequências e puder ser realizada de forma fiável com um procedimento simples, os custos de manutenção de uma camada adicional podem superar os seus benefícios. Uma abordagem arquitetural convincente deve, portanto, ser capaz de explicar onde não é necessária.
Significado controlado como vantagem competitiva
A IA generativa pode apresentar conteúdo falho de forma convincente; este risco está entre as características e os perigos explicitamente descritos de tais sistemas. Mesmo a informação adicional da empresa e os métodos de recuperação não eliminam todos os riscos de segurança, como os representados pelas instruções manipuladas no conteúdo processado. Assim sendo, uma camada semântica não garante a veracidade, a segurança ou a relação custo-benefício.
A sua importância estratégica justificada reside noutro lugar. Pode apoiar a transição do conhecimento empírico disperso para definições de negócio explícitas, reutilizáveis e mensuráveis. Isto possibilita não só a implantação esporádica da IA, mas também a sua incorporação gradual num sistema operativo controlado. O ativo duradouro, então, não é o assistente individual, mas a capacidade organizada de aproveitar de forma fiável o conhecimento da empresa para novas tarefas.
A vantagem competitiva decisiva, portanto, não surge de ter o maior número de agentes autónomos. Surge da capacidade das empresas reconhecerem mais rapidamente que informação é válida, que exceções são relevantes e que ações permanecem justificáveis. Aqueles que dominam este fundamento conseguem utilizar modelos e ferramentas em constante mudança de forma mais eficaz. Aqueles que o negligenciam correm o risco, principalmente, de aumentar a velocidade dos seus próprios equívocos a cada nova aplicação de IA.
Consultoria - Planejamento - Implementação

Konrad Wolfenstein
Terei o maior prazer em atuar como seu consultor pessoal.
Você pode entrar em contato comigo pelo endereço wolfenstein∂xpert.digital ou
Basta me ligar no número +49 7348 4088 965 .