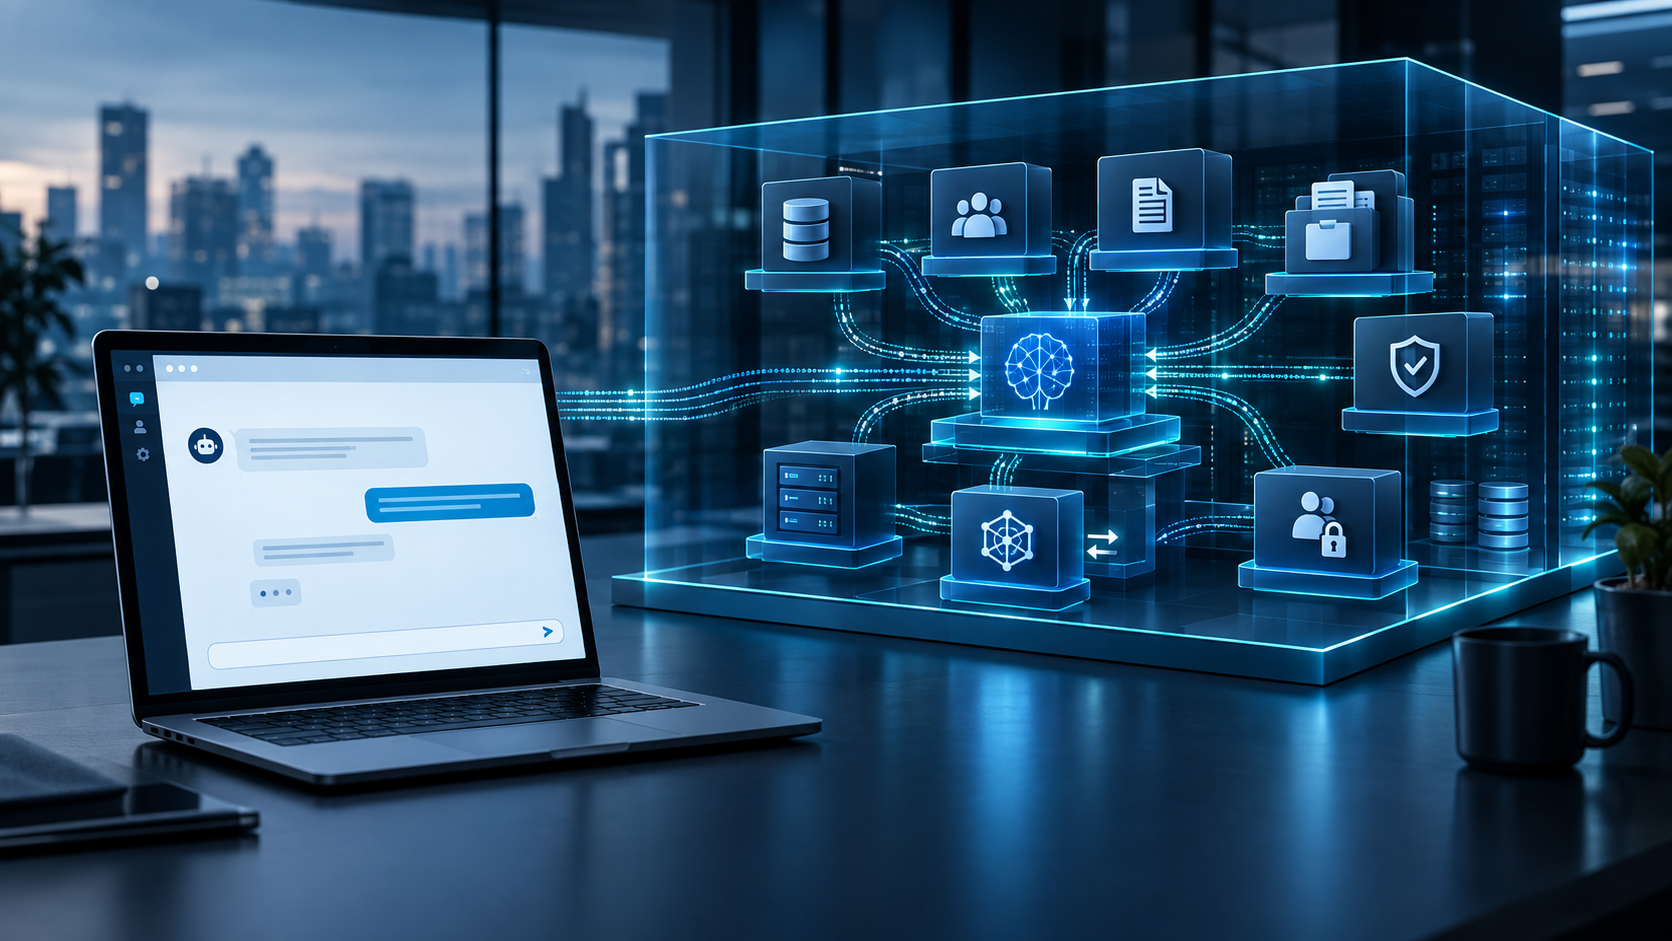
A IA empresarial começa onde o chatbot termina – imagem criativa sobre o tema, com IA da Xpert.Digital
Da licença à responsabilidade: como as empresas devem repensar a sua estratégia de IA
É assim que as empresas estão a reduzir o fosso entre as expectativas e a realidade da IA
A importância de uma camada de contexto para uma IA empresarial eficaz
No panorama digital atual, a integração da inteligência artificial (IA) nos processos de negócio está a tornar-se cada vez mais importante. No entanto, muitas empresas enfrentam o desafio de os seus colaboradores utilizarem frequentemente serviços de IA privados e não autorizados — uma prática conhecida como IA paralela (ou shadow AI). Este cenário revela um fosso crítico entre as soluções oferecidas pelas empresas e as reais necessidades dos utilizadores no local de trabalho. Embora as licenças empresariais para ferramentas de IA consolidadas sejam consideradas uma medida básica, elas, por si só, são insuficientes para satisfazer os requisitos complexos e as circunstâncias específicas de uma empresa. Uma IA empresarial verdadeiramente generativa requer uma arquitetura de sistema bem concebida que abranja modelos, acesso a dados, lógica de processos e responsabilidade. Neste artigo, exploramos os aspetos essenciais que as empresas devem considerar para aproveitar ao máximo o potencial da IA e combater eficazmente a IA paralela.
Relacionado a isto:
A simples distribuição de licenças não digitaliza a empresa – digitaliza o seu problema oculto de IA
Em muitas empresas, o futuro da inteligência artificial generativa não é decidido numa reunião de estratégia, mas num momento banal no trabalho: um colaborador copia um contrato de cliente, um cálculo ou um e-mail interno para um serviço de IA público porque a ferramenta utilizada internamente parece mais rápida, mais compreensível e mais poderosa do que a solução oficialmente aprovada pela empresa. Na perspetiva do colaborador, esta não é geralmente uma violação deliberada das regras, mas uma reação pragmática a processos ineficientes. Na perspetiva da empresa, isto indica uma lacuna perigosa entre a aprovação técnica e a usabilidade real.
A reação comum de tentar preencher esta lacuna comprando uma licença corporativa para um assistente de IA conhecido revela-se insuficiente. Tal licença pode oferecer importantes salvaguardas, funções administrativas e compromissos contratuais. No entanto, não transforma automaticamente um assistente genérico num sistema capaz de compreender os produtos, clientes, contratos, funções, limites de aprovação e fluxos de trabalho da empresa. Também não responde automaticamente a questões como onde os dados sensíveis são processados, quem é responsável por resultados incorretos ou se outros processos podem ser desenvolvidos a um custo marginal razoável após o caso de utilização inicial.
A tese económica central é, portanto, a seguinte: a verdadeira IA empresarial generativa não se resume a um modelo isolado ou a uma janela de chat com o logótipo de uma empresa. Trata-se de um sistema operativo composto por modelos, pontos de acesso a dados, contexto, identidades, permissões, lógica de processo, controlos de qualidade, responsabilidades e uma arquitetura de custos robusta. O valor real não reside no acesso à IA em si, mas sim na sua integração controlada na organização. É precisamente neste ponto que uma componente empresarial produtiva se diferencia de um produto de consumo conveniente com um login empresarial.
A licença comercial é uma base, mas ainda não é um edifício
As versões empresariais dos principais assistentes de IA resolvem problemas do mundo real. Normalmente, os fornecedores comprometem-se a não utilizar, por defeito, entradas e saídas de negócio para treinar os seus modelos de utilização geral. As características adicionais incluem a gestão centralizada de utilizadores, login único (SSO), controlo de acesso baseado em funções, registo de registos, encriptação, relatórios de utilização, contratos de processamento de dados e períodos de retenção parcialmente configuráveis. Além disso, os direitos de acesso, as políticas e os mecanismos de segurança existentes podem ser aproveitados em plataformas empresariais já estabelecidas. Para muitas organizações, isto representa uma melhoria significativa em relação às contas pessoais.
O erro não está na compra destas licenças. O erro está em confundir o âmbito de proteção das mesmas com uma solução empresarial completa. O compromisso de não utilizar os dados do cliente para o treino de modelos gerais responde apenas a uma das várias questões relacionadas com os dados. O local de processamento, o armazenamento de entradas e saídas, o período de retenção, o envolvimento de subcontratados, o tratamento da telemetria e as jurisdições aplicáveis podem permanecer questões em aberto. Além disso, o produto de chat, a interface de programação, o assistente de escritório integrado e a instância de cloud específica do cliente diferem frequentemente de forma significativa. Por conseguinte, uma versão genérica baseada na marca é insuficiente tanto do ponto de vista comercial como regulamentar.
Acima de tudo, a própria licença carece de memória institucional. Um modelo não conhece automaticamente o significado específico que a empresa atribui ao nome de um produto, o histórico de uma reclamação ou qual dos vários sistemas do cliente é o autorizado para um determinado processo. Não reconhece exceções informais nem a matriz de aprovação e não pode determinar de forma independente se é aplicável uma política desatualizada ou a sua sucessora. O acesso ao modelo é adquirido; no entanto, a fiabilidade operacional deve ser construída, testada e mantida continuamente.
Shadow AI é uma avaliação de mercado feita pelos próprios colaboradores da empresa
O uso de contas privadas de IA é frequentemente tratado como uma questão de disciplina ou formação. Isso é uma visão demasiado simplista. Quando os colaboradores recorrem a ferramentas não autorizadas, apesar das proibições, fornecem feedback involuntário ao mercado: a opção autorizada perde em comparação direta em termos de velocidade, usabilidade, qualidade do modelo ou integração prática nos processos de trabalho. As proibições podem reduzir os riscos a curto prazo, mas não eliminam a procura de uma solução melhor.
A escala é significativa. Os relatórios indicam que, até 2026, 47% dos colaboradores que utilizam IA generativa no ambiente de trabalho ainda utilizarão contas pessoais não geridas. Simultaneamente, o número de incidentes registados envolvendo a transferência de dados sensíveis para aplicações de IA duplicou. Foram registadas uma média de 223 violações de políticas deste tipo por organização por mês; para as empresas particularmente afectadas, o número foi muitas vezes superior. Os dados pessoais, financeiros e médicos regulamentados representaram uma fatia particularmente grande destas violações. Estas métricas apenas captam os incidentes visíveis e provavelmente não refletem totalmente a utilização real.
Do ponto de vista económico, a TI centralizada compete, portanto, com uma alternativa gratuita ou financiada por capital privado. Esta alternativa apresenta baixas barreiras à entrada, uma boa experiência de utilização e, frequentemente, representa o modelo mais recente. Uma alternativa interna não se destaca apenas pela conformidade, mas sim se for, no mínimo, tão conveniente e oferecer valor acrescentado ao negócio. Deve encontrar informação relevante, estar disponível nas aplicações existentes, evitar cópias desnecessárias e contextualizar as respostas dentro do fluxo de trabalho. A aceitação duradoura não se conquista através da coação, mas sim através de maiores benefícios com menos esforço individual.
Isto não significa que os controlos técnicos sejam desnecessários. A prevenção contra a perda de dados, restrições de clientes, controlos do browser, registo de logs e regras de utilização claras continuam a ser essenciais. No entanto, a sua eficácia aumenta significativamente quando também está disponível uma alternativa de alto desempenho. A resposta correta da gestão, portanto, não é apenas bloquear a IA paralela, mas analisar as suas causas raízes: Para que tarefas os colaboradores a estão a utilizar? Quais os sistemas autorizados que estão a apresentar falhas? Que ineficiências estão a levar as pessoas a usar contas privadas? Estas respostas levarão a uma lista de prioridades realista para a IA empresarial.
O conhecimento corporativo não é criado na janela de chat
Os assistentes genéricos de IA iniciam um processo principalmente com base no contexto fornecido pelo utilizador ou inferido pelo produto a partir de interações anteriores limitadas. Esta neutralidade costuma ser útil para tarefas pessoais. No entanto, torna-se um risco num contexto empresarial assim que as decisões dependem de informação histórica, contratual ou específica do cliente. Por exemplo, uma resposta fiável a um pedido de seguro só pode ser obtida combinando o histórico de sinistros, a versão da apólice, a correspondência, os requisitos regulamentares e o estado do processamento. Um único contrato carregado é insuficiente para este efeito.
O conhecimento necessário raramente está concentrado num único lugar. Encontra-se disperso por sistemas ERP, CRMs, sistemas de gestão documental, sistemas de emissão de tickets, data warehouses, e-mails, aplicações especializadas e ficheiros pessoais. Além disso, existem diferentes identificadores, grafias, versões de dados e responsabilidades. Um cliente pode estar listado com nomes diferentes em três sistemas; um código de produto pode ter adquirido um significado diferente após uma fusão; uma política pode ainda ser formalmente acessível, mas tecnicamente obsoleta. O modelo da linguagem não consegue resolver estas contradições por si só. Sem um mapeamento fiável, pode, na melhor das hipóteses, produzir uma síntese linguisticamente convincente de dados inconsistentes.
Assim sendo, o fornecimento de contexto é, primordialmente, uma tarefa de integração e gestão de dados. A geração aumentada por recuperação, ou seja, o fornecimento direcionado de conteúdo relevante no momento do pedido, é um método importante, mas não uma solução completa. São também necessários metadados, controlo de versão, verificação de identidade, verificações de autorização, precedência de fontes, períodos de validade e regras para informações conflituantes. Quanto mais o sistema for concebido para agir em vez de apenas responder, mais importantes se tornam os controlos transacionais e uma liderança de sistema claramente definida.
Um teste simples pode revelar a maturidade: a ferramenta aprovada recebe uma pergunta que apenas requer conhecimento interno da empresa para ser respondida corretamente. Se esta fornecer uma resposta genérica, confiante e incorreta, trata-se, na prática, de um chatbot com acesso à empresa. Se apenas solicitar um ficheiro, é um chatbot com função de upload. Só quando acede aos sistemas relevantes de forma legítima, transparente e em tempo real, reconhece a incerteza e contextualiza a resposta dentro do âmbito da empresa, é que surge a verdadeira inteligência empresarial.
A camada de contexto torna-se o stock de capital produtivo
O componente arquitetónico crucial reside entre o modelo e o negócio operacional. Esta camada pode ser descrita como uma plataforma de contexto, uma malha de conhecimento ou uma camada de integração e orquestração. O seu nome é menos importante do que a sua função: mapeia entidades entre si, liga fontes de dados, verifica permissões, fornece definições, controla ferramentas e documenta como uma resposta ou ação foi gerada. Idealmente, este trabalho não é reiniciado para cada caso de utilização, mas sim construído como um bloco de construção empresarial reutilizável.
Do ponto de vista económico, esta camada assemelha-se a um stock de capital produtivo. A ligação inicial a um ficheiro de contratos, a primeira atribuição correta de identidades de clientes ou a primeira implementação de uma lógica de aprovação acarretam custos iniciais elevados. No entanto, uma vez padronizados estes elementos, podem ser construídos outros casos de utilização sobre eles. O custo marginal do segundo, terceiro e quinto usos deverá diminuir. Este efeito, por si só, justifica uma estratégia de plataforma: uma parte do investimento torna-se utilizável não só para um projeto, mas para um número crescente de processos futuros.
Este efeito de reutilização não ocorre automaticamente, no entanto. Muitas plataformas supostamente prontas a usar consistem numa coleção de interfaces, prompts e soluções personalizadas específicas para cada projeto. Cada nova aplicação necessita de ser analisada, integrada e protegida novamente. A curva de custos mantém-se linear, enquanto surgem novas dependências. Assim sendo, um verdadeiro teste de maturidade consiste em determinar quais os componentes específicos do primeiro caso de utilização que podem ser reutilizados no segundo sem necessidade de reconstrução. Os componentes reutilizáveis incluem, por exemplo, serviços de identidade, conectores, controlo de acesso, catálogos de dados, procedimentos de avaliação, registo de registos, acesso a modelos e aprovações humanas normalizadas.
A camada de contexto é estrategicamente mais importante do que o compromisso com um único modelo. Os modelos evoluem rapidamente, os preços mudam e as diferentes tarefas beneficiam de diferentes vantagens. Por isso, as empresas precisam da capacidade de alternar entre modelos de forma controlada ou utilizar vários em paralelo. No entanto, esta alternância não é totalmente gratuita: o comportamento dos avisos, os formatos de saída, os filtros de segurança, as janelas de contexto e os perfis de desempenho variam. Uma boa arquitetura reduz estes custos de alternância através da abstração, interfaces padronizadas e testes repetíveis, em vez de criar uma impressão irrealista de completa permutabilidade.
A soberania dos dados abrange mais do que apenas excluir a formação
O debate público tem-se centrado, desde há muito, em saber se os dados de entrada são utilizados para treinar um modelo. Embora esta questão seja importante para as empresas, o seu foco é muito restrito. Toda a cadeia de armazenamento e processamento é crucial: onde são processados os dados de entrada? Que partes de um documento são transferidas? Onde são armazenados os históricos de chat, caches, registos e representações vetoriais? Durante quanto tempo são retidos? Que subcontratados têm os pontos de contacto técnicos? Qual a estrutura jurídica que se aplica? Os administradores podem visualizar, exportar e eliminar conteúdos? Como são geridos os backups?
Um departamento de marketing pode, em determinadas circunstâncias, utilizar de forma responsável um rascunho processado externamente. Padrões diferentes aplicam-se a dados comerciais não publicados, segredos comerciais, dados de saúde, processos judiciais ou infraestruturas críticas. A classificação do risco, portanto, não deve basear-se apenas na ferramenta utilizada, mas sim no tipo de dados, na ação realizada, no potencial dano e no nível de supervisão humana. O mesmo modelo pode representar um risco baixo ao reescrever um comunicado de imprensa público e um risco elevado ao processar automaticamente um empréstimo ou um pedido de reembolso.
Uma arquitetura robusta minimiza a movimentação de dados. A informação permanece dentro dos sistemas existentes tanto quanto possível; apenas o contexto necessário para a tarefa é fornecido, sujeito às regras de acesso em vigor. As consultas são autorizadas individualmente para cada utilizador, os campos sensíveis são mascarados quando apropriado e a saída é classificada de acordo com o seu conteúdo. Para processos particularmente críticos, podem ser recomendáveis o processamento regional, instâncias dedicadas, ambientes de computação confidenciais ou implementação local. No entanto, a operação totalmente interna não é automaticamente mais segura nem mais económica, dado que a operação, a aplicação de patches, a monitorização, a manutenção do modelo e a contratação de pessoal especializado acarretam custos significativos.
A fórmula para levar o modelo aos dados descreve, portanto, um princípio sensato, mas não deve ser interpretada como uma simplificação técnica. Mesmo com soluções federadas ou ligadas localmente, os snippets, incorporações ou metadados podem chegar a serviços externos. Uma análise documentada do fluxo de dados ao nível do componente é crucial. Só quando for possível demonstrar, para cada etapa, para onde vão os dados e como são protegidos, é que a soberania dos dados poderá ser avaliada de forma fiável.
A regulamentação torna a rastreabilidade um fator económico
Nos setores regulamentados, o fluxo de dados não é um ideal abstrato de segurança. As instituições financeiras, de acordo com as normas europeias para a resiliência operacional digital, devem avaliar sistematicamente os riscos representados pelas tecnologias de informação e comunicação, bem como pelos fornecedores externos. Os acordos de confidencialidade, o sigilo profissional, as leis de proteção de dados e as regulamentações setoriais exigem também que as empresas sejam capazes de explicar as atividades de processamento, as responsabilidades e as medidas de controlo. Uma aplicação de IA cuja qualidade de resposta seja convincente, mas cujo fluxo de dados não seja auditável, não poderá ser aprovada nos testes de aceitação operacional.
Com a legislação europeia sobre a IA, a governação sistemática ganha ainda mais importância. Grande parte do quadro regulamentar europeu está em vigor desde agosto de 2026, enquanto as obrigações individuais para determinados sistemas de alto risco entrarão gradualmente em vigor. Isto não resulta numa proibição total da IA genérica para as empresas. Em vez disso, exige-se uma classificação robusta com base na área de aplicação e na função. Um modelo geral, um sistema especializado construído sobre o mesmo e a empresa que utiliza esse sistema podem ter obrigações diferentes. A transparência, a documentação, a supervisão humana, a qualidade dos dados, a precisão, a cibersegurança e a rastreabilidade são particularmente cruciais para aplicações de alto risco.
A conformidade não é apenas um fator de custo. Uma arquitetura de controlo reutilizável pode reduzir o tempo de lançamento no mercado, uma vez que nem todos os projetos têm de reinventar as suas regras. As classes de risco padronizadas, os percursos de modelo aprovados, o registo técnico, os modelos de avaliação e os níveis de aprovação definidos reduzem a incerteza. A governação transforma-se, portanto, de uma função de controlo subsequente numa infra-estrutura produtiva. A vantagem económica torna-se particularmente evidente durante a segunda e terceira implementações, quando os componentes testados podem ser reutilizados.
As empresas devem também distinguir entre o risco de modelo e o risco de processo. Um modelo pode ser tecnicamente poderoso, enquanto um processo mal concebido continua a utilizar fontes de dados incorretas, tem responsabilidades pouco claras ou não permite a reversão de ações erróneas. Por outro lado, um modelo limitado pode ser altamente benéfico num processo bem definido e controlado. Por conseguinte, a qualidade da arquitetura global é, mais frequentemente, o fator decisivo para a viabilidade regulamentar e económica do que o desempenho máximo do modelo em testes globais.
🤖🚀 Plataforma de IA gerenciada: Soluções de IA mais rápidas, seguras e inteligentes com UNFRAME.AI

Plataforma de IA gerenciada - Imagem: Xpert.Digital
Aqui você aprenderá como sua empresa pode implementar soluções de IA personalizadas de forma rápida, segura e sem grandes barreiras de entrada.
Uma plataforma de IA gerenciada é a sua solução completa e descomplicada para inteligência artificial. Em vez de lidar com tecnologia complexa, infraestrutura cara e processos de desenvolvimento demorados, você recebe uma solução pronta, personalizada para suas necessidades, de um parceiro especializado – geralmente em poucos dias.
Principais vantagens em resumo:
⚡ Implementação rápida: Da ideia à aplicação pronta para uso em dias, não em meses. Oferecemos soluções práticas que geram valor agregado imediato.
🔒 Máxima segurança de dados: Seus dados sensíveis permanecem com você. Garantimos o processamento seguro e em conformidade com as normas, sem compartilhar dados com terceiros.
💸 Sem risco financeiro: você só paga pelos resultados. Os altos investimentos iniciais em hardware, software ou pessoal são completamente eliminados.
🎯 Concentre-se no seu negócio principal: Foque no que você faz de melhor. Nós cuidamos de toda a implementação técnica, operação e manutenção da sua solução de IA.
📈 Preparada para o futuro e escalável: Sua IA cresce com você. Garantimos otimização e escalabilidade contínuas, adaptando os modelos de forma flexível a novas necessidades.
Mais informações aqui:
De projeto de IA a sistema operativo empresarial
A responsabilidade não deve desaparecer entre o licenciamento e a consultoria
Os serviços de IA orientados para o consumidor são vendidos como ferramentas. Os fornecedores salientam, com razão, que os gastos podem ser imprecisos e que os utilizadores devem verificar os resultados. Este modelo é compreensível para um mercado de massas de baixo custo. No entanto, nas aplicações empresariais, surge uma lacuna de responsabilidade assim que esses mesmos gastos chegam aos clientes, influenciam os relatórios regulamentares ou desencadeiam processos financeiros. O fornecedor de acesso vende a possibilidade de utilizar o serviço, mas normalmente não assume a responsabilidade pelo resultado do processo empresarial específico.
Mesmo o modelo de integração tradicional pode deixar esta lacuna em aberto. Um prestador de serviços analisa, desenvolve e integra o sistema ao longo de meses, cobra pelo tempo e pelos materiais e, por fim, entrega o produto. O contrato pode ser formalmente cumprido, mesmo que a ferramenta seja mal aceite na utilização diária, produza muitos erros ou não consiga gerar qualquer melhoria mensurável no processo. Por um lado, o acesso foi vendido; por outro, a mão-de-obra. Em ambos os casos, ninguém está necessariamente vinculado financeiramente ao resultado acordado.
A IA empresarial exige, portanto, uma atribuição explícita de responsabilidades. As unidades de negócio, TI, segurança da informação, proteção de dados, gestão de risco e fornecedores precisam de saber quem é responsável pela qualidade dos dados, quem seleciona os modelos, quem define os limites, quem aprova as despesas e quem toma as decisões em caso de interrupções. Para ações automatizadas, a rastreabilidade, as opções de revogação e os escalonamentos claramente definidos são essenciais. A revisão humana só é um controlo eficaz se o revisor tiver tempo, conhecimento e informação suficientes; um clique rotineiro reduz a supervisão humana a uma mera formalidade.
Os modelos de remuneração orientados para os resultados podem melhorar os incentivos, mas não são a solução para todos os problemas. Só funcionam se os resultados forem mensuráveis, atribuíveis e protegidos contra a manipulação. Para um processo claro, como a redução do tempo de processamento, a diminuição das taxas de erro ou o aumento do número de casos resolvidos, podem ser acordados elementos baseados no desempenho. A atribuição é mais difícil para tarefas estratégicas baseadas no conhecimento. É normalmente aconselhável um modelo híbrido, consistindo num salário base, métricas de qualidade e utilização e uma componente ligada a resultados de negócio previamente acordados.
O segundo caso de utilização expõe a economia de plataforma
Muitos processos de seleção centram-se num primeiro caso de utilização deliberadamente simples. Resumir documentos, redigir e-mails, explicar um ficheiro carregado ou gerar variações de texto são tarefas adequadas para modelos gerais, uma vez que quase todo o contexto está disponível no prompt. Estas tarefas demonstram as capacidades linguísticas do modelo, mas dificilmente a maturidade de uma plataforma empresarial. Frequentemente, podem ser executadas com apenas algumas licenças e um esforço de implementação gerenciável.
O segundo caso de utilização é mais informativo. Se o mesmo sistema for utilizado para conciliar faturas de fornecedores com contratos, necessitará de aceder ao ficheiro de contratos, ao sistema ERP, à matriz de aprovações, aos dados mestre e às regras de exceção. Deverá consolidar diferentes designações, explicar as discrepâncias, respeitar as autorizações e encaminhar os problemas para a função adequada em caso de dúvida. Aqui, o foco muda do modelo para a integração e a lógica de processo. Este caso de uso verifica se a arquitetura previamente estabelecida é de facto reutilizável.
Uma plataforma merece este nome quando a segunda implementação se torna relativamente mais rápida e barata, e este efeito amplifica-se com as aplicações seguintes. Se cada novo caso de utilização se mantiver tão dispendioso como o anterior, não haverá sinergia económica significativa. Neste caso, a empresa possui uma licença e uma lista de espera para serviços de consultoria. Portanto, o teste comercial mais importante é exigir um custo e um prazo fiáveis para a segunda e terceira implementações antes mesmo de decidir pela primeira.
Esta perspetiva também altera o cálculo do investimento. O caso de utilização inicial não deve suportar todos os custos da plataforma isoladamente, caso os componentes significativos sejam reutilizados posteriormente. Por outro lado, é desonesto considerar uma reutilização futura vaga como um benefício sem especificar processos de acompanhamento concretos, responsáveis e orçamentos. Um cálculo sólido separa os investimentos únicos na plataforma, o desenvolvimento específico do caso de utilização, os custos contínuos do modelo e da infraestrutura, e os custos de monitorização, garantia de qualidade e gestão da mudança. Só assim é possível determinar um gasto total realista ao longo de vários anos.
Os custos raramente são atribuíveis exclusivamente às chamadas do modelo
Com a IA generativa, a atenção centra-se frequentemente nas taxas de licenciamento ou nos custos dos tokens. Estes custos são visíveis, mas geralmente não são os principais em aplicações empresariais complexas. As despesas adicionais incluem limpeza de dados, interfaces, gestão de identidade, auditorias de segurança, conjuntos de dados para avaliação, monitorização, tempo de especialistas, formação, suporte e ajustes contínuos. A falta de clareza na propriedade dos dados, as soluções personalizadas específicas para cada projeto e o retrabalho manual devido à qualidade inconsistente tornam-se particularmente dispendiosos.
Os estudos de mercado revelam a tensão entre expectativas elevadas e escalabilidade limitada. Num inquérito internacional a 2.000 líderes empresariais, apenas cerca de um quarto das iniciativas de IA alcançaram o retorno do investimento esperado; apenas 16% foram implementadas em toda a empresa. Ao mesmo tempo, 72% consideraram os dados proprietários da empresa cruciais para o valor da IA genérica, e 68% consideraram uma arquitetura de dados integrada e abrangente como essencial. Estes números não são verdades absolutas, mas ilustram que o acesso a modelos por si só não gera escalabilidade nem retorno do investimento.
Mesmo taxas de insucesso muito elevadas, observadas em estudos, devem ser interpretadas com cautela. Uma análise amplamente citada, de 2025, concluiu que 95% das iniciativas examinadas não alcançaram qualquer benefício financeiro mensurável. A metodologia, o tamanho da amostra e a definição de sucesso limitam a generalização desta conclusão; além disso, muitos projetos ainda estavam numa fase inicial. Ainda assim, o resultado aponta para um padrão real: as ferramentas genéricas podem aumentar a produtividade individual, mas esta poupança de tempo não se traduz automaticamente em custos mais baixos, maior rendimento ou receitas adicionais.
Para a avaliação de investimentos, as métricas de processo são, portanto, mais importantes do que as métricas de atividade. O número de utilizadores, pedidos ou textos gerados mede a aceitação, não o sucesso económico. Mais relevantes são o tempo de processamento, o custo por transação, a taxa de erros, o esforço de retrabalho, a produtividade, o tempo de receção, a taxa de resolução e a satisfação do cliente. Os ganhos de produtividade só se traduzem em resultados financeiros quando a empresa realoca recursos, elimina os estrangulamentos, vende serviços adicionais ou, na verdade, evita custos.
Um modelo privado ainda não é a IA empresarial
Os termos IA privada, modelo de linguagem privado e IA empresarial são frequentemente utilizados como sinónimos. Um modelo privado descreve principalmente as condições técnicas e contratuais em que um modelo é operado e quem tem acesso a ele. Pode ser executado localmente, num ambiente de nuvem dedicado ou através de um serviço altamente seguro. No entanto, esta característica diz pouco sobre se o sistema compreende os dados de negócio relevantes, aplica as permissões corretamente ou suporta fiável um processo.
Uma empresa pode operar um modelo inteiramente internamente e ainda assim acabar com dados isolados, baixa qualidade de pesquisa, responsabilidades pouco claras e falta de métricas de desempenho. Por outro lado, uma solução na nuvem cuidadosamente configurada pode ser mais económica e suficientemente segura para determinadas classes de dados. A decisão correta depende da sensibilidade, latência, volume, necessidades de integração, requisitos regulamentares, recursos operacionais internos e independência estratégica. A operação local não deve ser escolhida como um símbolo de status, mas sim como o resultado de uma análise de risco e de custos.
A verdadeira IA empresarial engloba o modelo, o contexto e a camada de integração, a governação, os controlos de acesso, a lógica de processos, os testes, a monitorização e um modelo operacional com responsabilidades claramente definidas. Inclui também uma estrutura comercial que torna transparentes os custos de desenvolvimento e os riscos de desempenho. Um modelo privado pode fazer parte desta arquitetura, mas não a substitui. O teste crucial não é aquele em que o modelo é executado isoladamente, mas sim se todo o sistema controla, melhora comprovadamente e otimiza economicamente um processo de negócio.
Esta distinção também protege contra complexidade técnica desnecessária. Nem todo o caso de utilização exige um modelo de grande dimensão, e nem toda a tarefa é generativa. Os métodos de pesquisa clássicos, as regras, os modelos estatísticos ou a automatização de processos podem ser mais económicos, estáveis e fáceis de testar. Uma arquitetura empresarial madura significa implementar IA generativa apenas onde a sua capacidade de lidar com informação não estruturada e linguagem variável gera valor acrescentado demonstrável.
A implementação rápida exige limites rigorosos, não grandes promessas
Um caso de utilização inicial bem definido nos sistemas existentes deverá conduzir a resultados próximos dos de produção em poucas semanas, em vez de vários trimestres. Isto não significa que uma transformação completa possa ser concluída rapidamente. Refere-se a um processo rigorosamente estruturado, com utilizadores claramente definidos, fontes de dados, limites de qualidade mensuráveis e um caminho operacional controlado. Se mesmo esta fase inicial demorar mais de seis meses, poderá indicar a ausência de componentes padrão, dados pouco claros, um âmbito demasiado amplo ou uma arquitetura de integração construída de raiz.
A velocidade, contudo, não deve ser confundida com pressa para entrar em produção. Um protótipo convincente apenas demonstra que um modelo pode produzir resultados utilizáveis em condições favoráveis. A implementação operacional deve ter em conta ocorrências raras, documentos desatualizados, dados conflituantes, alterações de acesso, falhas e entradas maliciosas. Os ataques de injeção de código, em particular, podem tentar contornar as instruções do sistema através do conteúdo de documentos ou websites. Por conseguinte, são essenciais limitações técnicas, validação de conteúdo, permissões separadas e testes com cenários de incidentes realistas.
Um processo de implementação sensato começa com um problema mensurável, e não com um modelo preferido. De seguida, definem-se os fluxos de dados, as funções dos utilizadores, os riscos de erros e a alavancagem económica. Segue-se um projeto-piloto limitado com fluxos de trabalho reais, uma base para comparação e critérios de encerramento claros. A escalabilidade só ocorre depois de demonstrada a qualidade, a aceitação, a segurança e o impacto no processo. Esta abordagem faseada reduz os custos irrecuperáveis e evita que um teste tecnicamente atrativo seja financiado durante anos sem valor comercial demonstrável.
A gestão da mudança é também crucial. Os colaboradores precisam de compreender para que é que o sistema é adequado, quais as suas limitações e como reportar erros. A experiência não deve ser desvalorizada silenciosamente através de uma suposta automatização. Os melhores resultados surgem frequentemente quando os colaboradores experientes estão envolvidos em avaliações, exceções e ciclos de feedback. Desta forma, a correção individual torna-se um processo organizacional de aprendizagem, mesmo que o modelo básico em si não aprenda permanentemente com cada interação.
Quatro critérios de teste diferenciam as plataformas dos chatbots requentados
A primeira questão fundamental é se o sistema já conhece a empresa na medida necessária ou se os utilizadores precisam de reconstruir o contexto para cada transação. Uma demonstração significativa utiliza, portanto, os dados, a terminologia e as permissões reais da própria empresa, em vez de uma base de dados de modelo predefinido. A avaliação não se deve limitar a verificar as respostas corretas, mas também analisar a forma como o sistema lida com a informação em falta, contraditória e inválida. Um sistema fiável deve reconhecer as suas limitações e tornar visíveis as incertezas.
A segunda questão diz respeito ao fluxo completo de dados. As empresas devem documentar o caminho de processamento, os locais de armazenamento, as regras de retenção, os subcontratados, o registo de registos e as opções de eliminação. Igualmente importante é saber se a arquitetura consegue reter dados nos sistemas existentes e fornecer apenas os excertos necessários. As declarações sobre segurança só são fiáveis quando podem ser ligadas a uma variante e configuração específicas do produto.
A terceira questão é a de quem é responsável, do ponto de vista económico e organizacional, pelo resultado acordado. É necessário esclarecer o que acontece se a precisão, a produtividade, o tempo de processamento ou outros valores-alvo não forem atingidos. A simples menção do planeamento futuro do produto revela uma lacuna na responsabilidade. Ao mesmo tempo, a empresa deve reconhecer as suas próprias responsabilidades, principalmente em relação à qualidade dos dados, à definição dos processos, à formação dos utilizadores e às decisões dos especialistas. A responsabilidade pelos resultados não pode ser totalmente externalizada.
A quarta questão diz respeito aos custos do segundo caso de utilização. Os fornecedores devem demonstrar quais as ligações, permissões, definições, testes e funções operacionais que são reutilizadas. Um cálculo de custos transparente para um processo subsequente é mais informativo do que um slide genérico sobre a plataforma. Revela se as economias de escala são reais ou se cada extensão desencadeia um novo projecto de integração. Estas quatro questões, deliberadamente, deslocam o foco do nome do modelo para o contexto, a soberania dos dados, a responsabilidade e os benefícios económicos cumulativos.
A arquitetura operacional adequada é baseada no risco, não na ideologia
Para a maioria das empresas, não existe um único método de implementação ideal. Uma abordagem de carteira faz mais sentido do ponto de vista económico. O conteúdo público e as tarefas de escrita de baixo risco podem ser geridos através de assistentes corporativos padronizados. As consultas internas de conhecimento requerem conectores controlados, verificações de autorização e verificação da fonte. Os processos críticos de negócio exigem fluxos de dados mais rigorosos, testes reproduzíveis, aprovações humanas e, quando necessário, processamento dedicado ou local. As ações automatizadas altamente eficazes exigem também ferramentas rigorosamente controladas, controlos transacionais e procedimentos de reversão.
Esta abordagem por camadas evita dois extremos dispendiosos. O primeiro é entregar todos os dados a um assistente genérico e depender de cláusulas contratuais. O segundo é desenvolver e operar todas as funções de IA internamente. Entre estes dois extremos, encontram-se os serviços geridos na cloud, o processamento regional, as chaves de propriedade do cliente, os caminhos de rede privados, as instâncias dedicadas, os modelos locais e as arquiteturas híbridas. A combinação destes recursos deve ser escolhida com base no risco específico.
A escolha do modelo também pode ser hierarquizada. Os modelos mais pequenos são, normalmente, mais baratos, mais rápidos e suficientes para tarefas bem definidas. Modelos maiores podem ser superiores para linguagem complexa, planeamento ou documentos inconsistentes. Um router inteligente pode atribuir tarefas a diferentes modelos com base na sensibilidade, complexidade e custo. Um pré-requisito é um sistema de avaliação normalizado para garantir que as vantagens de preço não são anuladas por custos mais elevados de erros e retrabalho.
A longo prazo, o ativo mais importante não será o modelo individual com melhor desempenho, mas sim a capacidade da empresa em implementar modelos de forma segura e rápida nos processos de produção. Esta capacidade engloba a qualidade dos dados, a arquitetura modular, a expertise, a governança e uma cultura de melhoria contínua. É mais difícil de copiar do que uma licença e continua a ser valiosa mesmo que o principal fornecedor de modelos mude.
De projeto de IA a sistema operativo empresarial
A perspetiva estratégica passa da questão de qual o assistente a adquirir para a questão de quais as capacidades operacionais que precisam de ser desenvolvidas. As empresas necessitam de um inventário catalogado de fontes de dados, responsabilidades claramente definidas, métodos de acesso normalizados, um portfólio modelo, procedimentos de avaliação reutilizáveis e priorização com base no valor económico. Sem esta base, surgem muitas ferramentas isoladas, cujos benefícios são difíceis de comparar e cujos riscos se acumulam.
A seleção de casos de uso deve focar-se em processos recorrentes, ricos em dados e com um elevado grau de atrito. As transições entre funções e sistemas, em que os colaboradores têm de procurar, comparar, transferir ou explicar informação, são particularmente atraentes. Nestas situações, a IA generativa pode desbloquear conteúdo não estruturado e complementar a automatização tradicional. Os processos sem uma base de dados clara, sem um estado inicial mensurável ou com taxas de erro extremamente elevadas e opções de controlo limitadas são menos adequados.
Para cada caso priorizado, a gestão deve formular uma hipótese económica. Esta hipótese descreve qual o estrangulamento que será eliminado, qual o indicador-chave de desempenho que será alterado, quais os custos que serão integralmente incorridos e como será percebido o efeito nas operações. Uma mera suposição de poupança de tempo é insuficiente. Deve ficar claro se o tempo libertado permitirá atender mais casos, reduzir os tempos de espera, aumentar a qualidade ou, de facto, evitar custos com pessoal e externos. Só esta ligação transforma a produtividade técnica em retorno económico.
Em paralelo, é necessária uma decisão arquitetónica que olhe para além do projeto piloto inicial, sem construir imediatamente uma plataforma sobredimensionada. Um núcleo enxuto e partilhado, composto por identidade, registo de registos, acesso a modelos, conectores de dados e avaliação, pode crescer incrementalmente. Cada nova aplicação deve melhorar este núcleo e gerar o mínimo possível de lógica personalizada. Esta abordagem cria capacidade cumulativa em vez de uma coleção de demonstrações.
A decisão de compra propriamente dita gira em torno do modelo
Os modelos de IA estão a tornar-se mais poderosos, mais baratos e mais profundamente integrados no software padrão. Isto reduz o fator de diferenciação do mero acesso. O que as empresas realmente adquirem ou desenvolvem são os componentes que rodeiam o modelo: contexto de negócio, armazenamento de dados controlado, integração fiável, decisões rastreáveis, responsabilidade organizacional e uma curva de custos que se torna mais favorável com casos de utilização adicionais. Estes elementos determinam se a IA permanecerá uma ferramenta de produtividade para os colaboradores individuais ou se evoluirá para uma capacidade de toda a empresa.
Uma licença empresarial não é inútil nem suficiente para este efeito. Muitas vezes representa um mínimo razoável para tarefas gerais e pode reduzir a IA paralela. No entanto, para processos regulamentados ou críticos para o negócio, deve ser complementada pela arquitetura de dados, governação, design de processos e responsabilização mensurável pelos resultados. Da mesma forma, um modelo privado por si só não é a solução. O isolamento técnico sem contexto e um conceito operacional cria apenas uma ilha operada a título privado.
O segundo caso de utilização oferece o alerta mais forte. Se todas as ligações de dados, regras, testes e responsabilidades tiverem de ser reconstruídas, o sucesso inicial não foi um efeito da plataforma, mas sim de um projeto isolado. Por outro lado, se os componentes essenciais forem reutilizados e o tempo para obter benefícios diminuir, a verdadeira economia empresarial entra em ação. O valor, então, reside não numa demonstração espetacular, mas numa infraestrutura de aprendizagem que melhora continuamente mais processos a custos marginais mais baixos.
Os funcionários que já votaram utilizando contas privadas não representam, portanto, apenas um problema de segurança. Demonstram a elevada procura e a baixa tolerância a ferramentas inadequadas. A tarefa da liderança da empresa é traduzir esta procura numa alternativa controlada e superior: um sistema que compreenda o negócio, proteja adequadamente os dados sensíveis, lide com os erros de forma responsável e não necessite de ser reiniciado do zero na próxima vez que for utilizado. Qualquer coisa inferior a isto continua a ser um chatbot com login – útil, muitas vezes impressionante, mas ainda não uma IA empresarial.
Consultoria - Planejamento - Implementação

Konrad Wolfenstein
Terei o maior prazer em atuar como seu consultor pessoal.
Você pode entrar em contato comigo pelo endereço wolfenstein∂xpert.digital ou
Basta me ligar no número +49 7348 4088 965 .