Aleph Alpha en Kolibri-1: Duitslands AI-comeback tussen efficiëntie, afhankelijkheid en een nieuw machtsblok – een creatieve afbeelding over dit onderwerp, met AI: Xpert.Digital
78 miljard parameters en toch efficiënt: Kolibri-1 in de schijnwerpers
Duits en Engels: Kolibri-1 als economisch onderscheidend vermogen
Van chatbot naar procesautomatisering: de ontwikkeling van Kolibri-1
Met de lancering van Kolibri-1 presenteert Aleph Alpha een innovatief AI-model dat niet alleen is afgestemd op de behoeften van Duitse bedrijven, maar ook internationale standaarden zou kunnen zetten. In tegenstelling tot andere grote taalmodellen, die vaak worden gedomineerd door Amerikaanse of Chinese bedrijven, streeft Kolibri-1 ernaar een beheersbare en efficiënte AI-oplossing te bieden, met name geschikt voor gevoelige gegevens en complexe documenten. De focus op Duits en Engels, evenals de integratie in bestaande bedrijfsprocessen, kan cruciaal zijn voor veel organisaties, vooral in een markt die steeds meer op zoek is naar oplossingen die zowel hoge prestaties als gegevensbeveiliging bieden. In deze context rijst de vraag of Kolibri-1 slechts een technologisch experiment is of de hoeksteen van een nieuw hoofdstuk in de Europese AI-ontwikkeling. De uitdagingen en kansen die dit model biedt, worden in de volgende paragrafen uitgebreid besproken.
78 miljard parameters – en toch is het uiteindelijk niet het model dat de doorslag geeft, maar de infrastructuur
Een model als signaal voor economisch beleid
Met Kolibri-1 keert Aleph Alpha terug naar een discipline waaruit het in Heidelberg gevestigde bedrijf zich grotendeels leek te hebben teruggetrokken: de ontwikkeling van grote, algemeen toepasbare taalmodellen. Het nieuwe systeem is echter niet zomaar een poging om Amerikaanse of Chinese modellen te kopiëren. Het is ontworpen als een gespecialiseerde Duits-Engelse basis voor bedrijven, overheidsinstanties en gereguleerde sectoren. Kolibri-1 richt zich dan ook minder op de massamarkt voor gratis chatbots en meer op een commercieel aantrekkelijke, maar minder toegankelijke markt: beheersbare AI voor gevoelige gegevens, lange documenten, interne kennisbanken, industriële processen en agentgebaseerde workflows.
De publicatie moet daarom niet alleen als een technische gebeurtenis worden beschouwd. Ze raakt drie belangrijke economische vraagstukken van de Europese AI-strategie. Ten eerste gaat het om de vraag of Europese aanbieders technologisch onafhankelijke basismodellen kunnen ontwikkelen zonder permanent afhankelijk te worden van de grote platforms uit de VS en China. Ten tweede werpt ze de vraag op of een hoogwaardig, openbaar beschikbaar model ook een levensvatbaar bedrijfsmodel oplevert. Ten derde wordt het economische voordeel niet bepaald door het aantal parameters, maar door de vraag of bedrijven het model veilig en tegen redelijke kosten kunnen gebruiken, integreren in bestaande processen en continu kunnen bijwerken.
Kolibri-1 wordt gelanceerd in een gunstig marktklimaat. De Duitse uitgaven aan kunstmatige intelligentie zullen naar verwachting stijgen tot € 28,7 miljard in 2026, een groei van ongeveer 48 procent ten opzichte van het voorgaande jaar. Generatieve AI vertegenwoordigt al zo'n € 11,5 miljard, oftewel ongeveer 40 procent van de totale markt. Tegelijkertijd is de praktische toepassing ervan in Duitse bedrijven nog steeds aanzienlijk minder wijdverspreid dan de hoge investeringsbedragen doen vermoeden. Slechts een fractie van de bedrijven biedt hun werknemers directe toegang tot generatieve AI-toepassingen. Met name kleinere bedrijven aarzelen vanwege de kosten, zorgen over gegevensbescherming, een tekort aan geschoolde werknemers en onduidelijke integratiemogelijkheden.
Dit creëert een gat in de markt. Bedrijven willen krachtige AI gebruiken, maar ze willen geen gevoelige informatie zonder verificatie naar externe platforms overdragen. Ze hebben behoefte aan transparante werkmodellen, beheersbare datastromen, Duitstalige kwaliteit en juridisch solide implementatieconcepten. Precies hier komt Kolibri-1 in beeld. Het model is daarom minder een aanval op de meest populaire chatbots en meer een aanbod voor organisaties die hun eigen AI-infrastructuur willen bouwen om wettelijke, strategische of economische redenen.
Economische activering in plaats van kleinschalige architectuur
Kolibri-1 omvat in totaal ongeveer 78,1 miljard parameters. Dit aantal klinkt in eerste instantie als een zeer groot en navenant duur model. In werkelijkheid werkt het systeem echter met een architectuur gebaseerd op een mix van experts. Dit betekent dat niet alle parameters bij elke verwerkingsstap worden geactiveerd. In plaats daarvan bepaalt een router welke gespecialiseerde subnetwerken verantwoordelijk zijn voor het betreffende token. Van de 78,1 miljard parameters zijn er slechts ongeveer 3,46 miljard actief per token. Dit komt overeen met ongeveer 4,4 procent van de totale capaciteit.
De architectuur bestaat uit 50 transformatorlagen. Elke laag heeft 384 gespecialiseerde experts. Eén gemeenschappelijke expert is altijd actief, terwijl zes andere experts worden geactiveerd afhankelijk van de inhoud van het betreffende token. Het onderliggende concept is economisch aantrekkelijk: het model beschikt over de kennis en specialisatiecapaciteit van een zeer groot systeem, maar vereist slechts een fractie van de gebruikelijke rekenkracht voor één enkele berekeningsstap. Dit leidt tot fundamentele verbeteringen in doorvoer en operationele kosten in vergelijking met een compact model van vergelijkbare omvang.
Deze efficiëntie moet echter niet worden verward met lage geheugenvereisten. Alle modelgewichten moeten in het geheugen beschikbaar blijven, omdat de router afhankelijk van de invoer verschillende experts kan activeren. De FP8-variant vereist ongeveer 78 gigabyte grafisch geheugen alleen al voor de gewichten. Extra geheugen is nodig voor de context (de KV-cache), tijdelijke berekeningen, parallelisatie en de runtime-omgeving. Daarom is de minimaal aanbevolen configuratie twee A100 GPU's met elk 80 gigabyte, twee H100 SXM5 GPU's of een enkele H200, B200 of B300 GPU. Voor een stabiele productieomgeving zijn krachtigere of redundante configuraties aan te raden.
Dit benadrukt de fundamentele spanning die inherent is aan Kolibri-1. De rekeninspanning per token is relatief laag, maar de toegang tot de benodigde hardware blijft kapitaalintensief. Voor een bedrijf met een bestaande GPU-infrastructuur kan het model economisch aantrekkelijk zijn. Voor een middelgrote onderneming zonder eigen AI-cluster is directe hosting echter zelden de meest kosteneffectieve oplossing. In dat geval spelen managed hostingdiensten, soevereine clouddiensten of branchespecifieke platforms waarschijnlijk een doorslaggevende rol.
Het economische voordeel van een expertarchitectuur is daarom niet vanzelfsprekend. Het hangt af van een hoge benutting. Een dure GPU die slechts af en toe verzoeken verwerkt, blijft zelfs met een efficiënt model onrendabel. Hoe meer gebruikers, documentprocessen en agentgebaseerde applicaties op een gedeelde infrastructuur worden gebundeld, hoe beter de vaste kosten kunnen worden verdeeld. Voor datacenterbeheerders, cloudproviders en grote bedrijven is Kolibri-1 daarom aanzienlijk aantrekkelijker dan voor individuele kleine bedrijven met een lage benutting.
Een miljoen tokens is geen vrijbrief
Een belangrijk kenmerk van Kolibri-1 is het vermogen om zeer lange invoer te verwerken. De initiële training werd uitgevoerd met sequenties van 16.384 tokens. In een volgende trainingsfase werd de lengte verhoogd tot 65.536 tokens. De laatste fase met lange contexten werkte met 262.144 tokens. Deze lengte wordt beschouwd als de native context van het model. Technisch gezien kan het systeem verder worden uitgebreid zonder verdere positionele schaling. De kwaliteit en beschikbaarheid werden geverifieerd tot 1.048.576 tokens.
Afhankelijk van de taal, het formaat en de tokenisatie kunnen een miljoen tokens duizenden pagina's tekst vertegenwoordigen. Dit opent mogelijkheden voor bedrijven die met traditionele chatbots slechts in beperkte mate haalbaar zijn. Denk hierbij aan de analyse van omvangrijke contracten, technische handleidingen, onderhoudsdocumentatie, juridische dossiers, onderzoeksarchieven, leveranciersdocumenten en interne kennisbanken. Ook complexe due diligence-onderzoeken, aanbestedingsanalyses, compliance-vergelijkingen en de evaluatie van omvangrijke dossiers worden in principe vereenvoudigd.
Economisch gezien is echter niet alleen de maximale contextlengte van belang, maar ook de kosten per stukje zinvol verwerkte informatie. Een zeer lange context verhoogt het geheugenverbruik van de computationele logica (CLU) cache, verlengt de responstijden en kan de doorvoer aanzienlijk verminderen. Bovendien garandeert een groot contextvenster niet dat het model alle relevante informatie betrouwbaar vindt, correct weegt en consistent verwerkt. Hoe langer de invoer, hoe groter het risico dat cruciale details verloren gaan tussen irrelevante passages.
Daarom ligt het economisch haalbare gebruiksbereik vaak onder het technische maximum. Voor complexe taken en toepassingen waarbij latency cruciaal is, wordt een limiet van maximaal 262.144 tokens aanbevolen. In veel bedrijfsapplicaties blijft een aanzienlijk kleinere context, gecombineerd met retrieval-augmented generation, efficiënter. Bij deze aanpak worden niet alle beschikbare documenten tegelijkertijd in het model geladen. Een zoeksysteem selecteert eerst de vermoedelijk relevante secties en geeft alleen deze door aan het taalmodel.
Kolibri-1 vervangt RAG niet. Integendeel, het grote contextvenster vergroot de mogelijkheden voor hybride architecturen. Een bedrijf kan bijvoorbeeld eerst duizenden documenten semantisch doorzoeken, vervolgens enkele honderden relevante pagina's in de context laden en het model hieruit een onderbouwde analyse laten genereren. De toegevoegde waarde ontstaat door de combinatie van zoeken, documentbegrip, bronvermelding, gestructureerde output en menselijke beoordeling. Het lukraak invoeren van complete datasets in het model brengt daarentegen het risico met zich mee van hoge kosten en beperkte inzichten.
Het Duits wordt een economische onderscheidende factor
De ware strategische waarde van Kolibri-1 schuilt in de consistente focus op Duits en Engels. Ongeveer 62,5 procent van het basistrainingsmateriaal bestaat uit Engelstalige inhoud, circa 23,9 procent uit Duitse teksten en ongeveer 13,6 procent uit programmacode. In latere trainingsfasen werden instructiegegevens, redeneertaken, agentgebaseerde processen, inhoudelijke informatie en lange documenten toegevoegd. De pre-trainingsfase omvatte in totaal 20 biljoen tokens. Nog eens 3,44 biljoen tokens werden gebruikt in de middenfase van de training en 201 miljard tokens werden geïnvesteerd in het uitbreiden van het contextvenster.
Het Duitse component is significant in vergelijking met andere landen. Hoewel veel wereldwijde modellen vloeiend Duits kunnen genereren, zijn ze voornamelijk getraind op Engelse data. Dit heeft met name invloed op juridische nuances, bestuurstaal, samengestelde technische termen, regionale uitdrukkingen en branchespecifieke tekstsoorten. Kolibri-1 gebruikt een eigen tokenizer met 128.000 entries, die de morfologie en woordvorming van de Duitse taal vollediger in rekening brengt. Hierdoor kan Duitse tekst compacter en efficiënter worden verwerkt.
Deze technische eigenschap heeft directe economische gevolgen. Minder tokens per Duits document kunnen de opslagbehoefte, de verwerkingstijd en daarmee de kosten verlagen. De kwaliteit is echter nog belangrijker in gespecialiseerde toepassingen. Kleine taalkundige onvolkomenheden zijn vaak acceptabel in een chatgesprek met de klantenservice. Daarentegen kan onnauwkeurige terminologie in een contractanalyse, een technische beveiligingsrichtlijn of een administratief proces leiden tot aanzienlijke extra kosten.
Duitsland beschikt over enorme archieven met waardevolle, maar moeilijk toegankelijke technische documenten. Industriële bedrijven hebben archieven met ontwerpspecificaties, onderhoudsrapporten, kwaliteitsmeldingen, normen, opmerkingen bij onderdelenlijsten en correspondentie met leveranciers die in de loop der decennia zijn gegroeid. Overheidsinstanties beheren omvangrijke dossiers, regelgeving, officiële mededelingen en procedurele documentatie. Verzekeringsmaatschappijen, banken, energiebedrijven en zorginstellingen werken met streng gereguleerde tekstarchieven. Een model dat deze inhoud taalkundig en structureel beter vastlegt, kan productiviteitswinst opleveren waar algemene chatbots hun grenzen bereiken.
De focus op twee talen is tevens een beperking. Internationale bedrijven hebben vaak uniforme systemen nodig voor tientallen talen. In dergelijke gevallen kan een breed meertalig model economisch voordeliger zijn, ondanks een minder sterke specialisatie in het Duits. Kolibri-1 is daarom met name aantrekkelijk wanneer Duits en Engels de meerderheid van de waardetoevoegende communicatie vormen. De bewuste beperking tot twee talen is geen universele oplossing, maar eerder een strategische focus op een duidelijk afgebakende markt.
Van chatbot tot digitale procesmedewerker
Kolibri-1 ondersteunt een expliciete redeneermodus. Gebruikers of applicaties kunnen de redeneerinspanning instellen op laag, gemiddeld of hoog, of de extra redeneerfunctie volledig uitschakelen. Deze gradatie is belangrijker voor zakelijk gebruik dan het in eerste instantie lijkt. Niet elke taak vereist langdurige interne verwerking. Eenvoudige classificatie, snelle extractie of het herschrijven van tekst moeten snel en kosteneffectief kunnen worden uitgevoerd. Daarentegen kunnen complexe technische analyses of meerfasenplanning baat hebben bij een hoger redeneerniveau.
Dit maakt het mogelijk om de rekenkracht te sturen op basis van de economische waarde van een taak. Een bedrijf kan routinematige processen uitvoeren met weinig cognitieve inspanning en alleen extra rekentijd toewijzen aan complexere gevallen. Dit is vergelijkbaar met risicogebaseerd resourcebeheer: hoe groter de potentiële gevolgen van een onjuist antwoord, hoe meer inspanning er is toegestaan voor verificatie, het ophalen van de informatie en de redenering. Dit vereist echter wel dat de applicatie dit complexiteitsniveau op de juiste manier selecteert en de resultaten monitort.
Nog belangrijker is het vermogen om tools aan te roepen. Het model kan gestructureerde functieaanroepen genereren, informatie ophalen via programmeerinterfaces, toegang krijgen tot zoeksystemen, code uitvoeren en gegevens in vooraf gedefinieerde formaten uitvoeren. Dit transformeert een eenvoudige tekstgenerator in een bouwsteen voor agentgebaseerde workflows. Een assistent kan bijvoorbeeld een zoekopdracht begrijpen, relevante documenten zoeken, gegevens ophalen uit een ERP-systeem, berekeningen uitvoeren en een conceptbesluitsjabloon maken.
De economische voordelen zitten niet in geautomatiseerde tekstgeneratie, maar in het samenvoegen van voorheen gescheiden processtappen. Wanneer een servicemonteur niet langer in meerdere systemen hoeft te zoeken naar artikelnummers, onderhoudshistorie en contractvoorwaarden, neemt de verwerkingstijd af. Wanneer een inkoopafdeling automatisch leveranciersdocumenten structureert, risico's identificeert en vergelijkingstabellen opstelt, neemt de capaciteit toe zonder een evenredige toename van het personeel. Wanneer een overheidsinstantie de inhoud van bestanden extraheert en gestandaardiseerde concepten creëert, kunnen specialisten meer tijd besteden aan juridische beoordeling en burgerparticipatie.
Volledig autonome besluitvorming kan hier echter niet uit worden afgeleid. Kolibri-1 is ontworpen voor systemen waarin mensen uitgaven beoordelen alvorens actie te ondernemen. In besluitvormingsprocessen moet het model bewijsmateriaal verzamelen, opties formuleren en tegenstrijdigheden aan het licht brengen, maar geen bindende beslissingen nemen zonder toezicht. Dit geldt met name voor personeelszaken, leningen, geneeskunde, openbare diensten, veiligheidskwesties en andere gebieden met aanzienlijke individuele of maatschappelijke gevolgen.
Openbaar beschikbare gewichten beïnvloeden de onderhandelingspositie
Kolibri-1 is uitgebracht onder de Apache 2.0-licentie. Bedrijven kunnen de gewichten downloaden, op hun eigen infrastructuur uitvoeren, aanpassen en in principe commercieel gebruiken. In vergelijking met propriëtaire programmeerinterfaces vermindert dit de afhankelijkheid van één enkele leverancier. De prijsstelling, servicevoorwaarden of productstrategieën van een externe platformaanbieder kunnen het eigen systeem van een bedrijf minder abrupt beïnvloeden wanneer het model binnen de eigen verantwoordelijkheidssfeer van het bedrijf opereert.
Deze openheid versterkt de onderhandelingspositie van klanten ten opzichte van cloud- en softwareproviders. Een bedrijf kan verschillende hostingpartners vergelijken, van infrastructuur wisselen of bijzonder gevoelige applicaties volledig in eigen beheer uitvoeren. Branchespecifieke aanpassingen zijn ook mogelijk. Consultancybureaus, integrators en softwarebedrijven kunnen op basis van dit model hun eigen oplossingen ontwikkelen zonder voor elk verzoek een eigen modelvergoeding te hoeven betalen.
Open Weight betekent echter niet dat het hele systeem in de strikte zin van het woord open source is. Modelgewichten en configuratiebestanden zijn beschikbaar. Trainingsdata, de volledige trainingscode, de architectuurontwikkeling en alle productietools worden niet automatisch openbaar gemaakt. De gepubliceerde licentie verleent ruime gebruiksrechten voor de aangeboden componenten, maar staat geen volledige reproductie van het ontwikkelingsproces toe.
Zelfs gratis downloadbare gewichten elimineren de operationele kosten niet. Bedrijven moeten hardware, energie, datacenterruimte, monitoring, beveiliging, updates en gekwalificeerd personeel financieren. Daar komen nog de kosten bij voor datavoorbereiding, vectordatabases, toegangscontrole, evaluatie, logging en applicatiebeveiliging. In veel gevallen vormt de licentie voor het model slechts een klein deel van de totale kosten.
De economische beslissing is daarom geen keuze tussen een gratis model en een betaalde API. Het is een keuze tussen vaste kosten en variabele kosten. Proprietäre API's rekenen doorgaans een prijs per verwerkt token of per verzoek. Interne hosting brengt hoge opstart- en installatiekosten met zich mee, maar kan kosteneffectiever worden bij groot en consistent gebruik. Bedrijven met fluctuerende of lage volumes profiteren vaak van cloudfacturering op basis van gebruik. Organisaties met een constant hoog gebruik, strikte datavereisten of strategische aanpassingsbehoeften kunnen voordelen behalen met interne hosting.
Een nieuwe dimensie van digitale transformatie met 'Managed AI' (kunstmatige intelligentie) - Platform- en B2B-oplossing | Xpert Consulting

Een nieuwe dimensie van digitale transformatie met 'Managed AI' (kunstmatige intelligentie) – Platform- en B2B-oplossing | Xpert Consulting - Afbeelding: Xpert.Digital
Hier leert u hoe uw bedrijf snel, veilig en zonder hoge drempels AI-oplossingen op maat kan implementeren.
Een beheerd AI-platform is uw allesomvattende, zorgeloze oplossing voor kunstmatige intelligentie. In plaats van te worstelen met complexe technologie, dure infrastructuur en langdurige ontwikkelprocessen, ontvangt u een kant-en-klare oplossing op maat van een gespecialiseerde partner – vaak al binnen enkele dagen.
De belangrijkste voordelen in één oogopslag:
⚡ Snelle implementatie: Van idee tot gebruiksklare applicatie in dagen, niet maanden. Wij leveren praktische oplossingen die direct toegevoegde waarde creëren.
🔒 Maximale gegevensbeveiliging: Uw gevoelige gegevens blijven bij u. Wij garanderen een veilige en conforme verwerking zonder gegevens met derden te delen.
💸 Geen financieel risico: u betaalt alleen voor de resultaten. Hoge investeringen vooraf in hardware, software of personeel zijn volledig uitgesloten.
🎯 Focus op uw kernactiviteiten: concentreer u op waar u het beste in bent. Wij zorgen voor de volledige technische implementatie, werking en het onderhoud van uw AI-oplossing.
📈 Toekomstbestendig en schaalbaar: Uw AI groeit met u mee. Wij garanderen continue optimalisatie en schaalbaarheid en passen de modellen flexibel aan nieuwe eisen aan.
Meer informatie vindt u hier:
De werkelijke kosten van Kolibri-1 voor de bedrijfsvoering
De eigenlijke berekening begint na het downloaden
Een gedegen economische analyse voor Kolibri-1 moet veel verder gaan dan alleen de aanschaf van de GPU. Aan de kapitaalzijde omvat dit de aanschaf, financiering, netwerktechnologie, opslagsystemen, koeling en mogelijk noodzakelijke structurele aanpassingen. Aan de operationele kant ontstaan kosten voor elektriciteit, onderhoud, personeel, softwaregebruik en betrouwbaarheid. Redundante systemen zijn vaak vereist voor productietoepassingen. Een enkele server is wellicht voldoende voor testdoeleinden, maar vormt geen betrouwbare bedrijfsdienst.
Het gebruik is de belangrijkste kostenfactor. Een intern beheerd model kan theoretisch lage marginale kosten per extra aanvraag realiseren. In de praktijk moet de infrastructuur echter ook beschikbaar zijn tijdens perioden met weinig vraag. Als deze slechts voor tien of twintig procent van de capaciteit wordt benut, worden de vaste kosten verdeeld over een klein aantal tokens. Een gespecialiseerde hostingprovider kan de belasting van verschillende klanten bundelen en zo veel efficiënter werken. Dit pleit voor soevereine, beheerde AI-oplossingen, waarbij dataopslag, modelbeheer en governance worden gecombineerd in een gecontroleerde Europese infrastructuur.
Langetermijncontexten veranderen ook de kostenstructuur. Het verwerken van een groot document legt gedurende een langere periode beslag op opslag- en verwerkingstijd. Wanneer meerdere gebruikers tegelijkertijd honderdduizenden tokens indienen, neemt het aantal verzoeken dat parallel kan worden verwerkt af. Daarom moeten bedrijven niet alleen het gemiddelde aantal verzoeken modelleren, maar ook piekbelastingen, responstijdvereisten en prioriteiten. Een systeem voor nachtelijke batchverwerking kan met dezelfde hardware aanzienlijk kosteneffectiever werken dan een interactieve assistent met gegarandeerde responstijden.
Het aanpassen aan bedrijfsgegevens brengt extra kosten met zich mee. Vaak is volledige finetuning niet nodig. Een goed RAG-systeem, schone metadata en een robuust autorisatieconcept leveren vaak grotere voordelen op. Finetuning kan nuttig zijn wanneer terugkerende formaten, zakelijke talen of workflows betrouwbaar moeten worden aangeleerd. Het verhoogt echter de benodigde inspanning voor datakwaliteit, testen, versiebeheer en herverificatie na modelupdates.
De grootste verborgen kostenfactor is kwaliteitsborging. Een taalmodel kan overtuigende resultaten opleveren en toch onjuist zijn. Productieve systemen vereisen daarom bedrijfsgerelateerde testgevallen, gedefinieerde fouttoleranties en continue evaluatie. Voor elke kritieke applicatie moeten bedrijven meten hoe vaak het model correcte informatie vindt, wanneer het ongefundeerde conclusies trekt, of het zich aan de toegangsrechten houdt en hoe het reageert op gemanipuleerde documenten. Zonder deze controles is een lage tokenkost economisch waardeloos, omdat zelfs een enkele fout aanzienlijke schade kan veroorzaken.
950 megawattuur en de kwestie van efficiëntie
Het energieverbruik voor de pre-training-, mid-training- en long-contextfasen wordt geschat op ongeveer 950 megawattuur. Dit cijfer omvat het stroomverbruik van de rekenknooppunten en de overhead van het datacenter. Het omvat onder andere geen supervised fine-tuning, reinforcement learning, hulpmodellen, testreeksen, en de rust- en piekbelastingen. Het werkelijke totale energieverbruik van het ontwikkelingsprogramma is daarom hoger dan het gepubliceerde cijfer.
De pre-trainingsfase duurde 21 dagen en werd uitgevoerd op 768 Nvidia B200 GPU's, verdeeld over 96 HGX-systemen. Dit resulteerde in ongeveer 392.000 GPU-uren. De daaropvolgende trainingsfase duurde ongeveer vijf dagen en vereiste circa 90.000 GPU-uren. De fase voor het genereren van een langetermijncontext voegde daar nog eens 10.000 GPU-uren aan toe. De gerapporteerde rekeninspanning bedraagt 6,4 x 10^23 drijvende-komma-bewerkingen.
Het cijfer van 950 megawattuur lijkt hoog, maar het moet in economische termen worden geplaatst. Training is een eenmalige investering in een herbruikbaar digitaal product. De cruciale factor is hoe intensief het model vervolgens wordt gebruikt en welke productieve effecten het genereert. Als een model in duizenden toepassingen gedurende meerdere jaren wordt gebruikt, wordt de trainingsinspanning verdeeld over een grote hoeveelheid economische output. Omgekeerd, als het een technologisch demonstratieproject blijft met weinig gebruik, is de productiviteit van de middelen gering.
Voor de milieueffectbeoordeling is de doorlopende werking op de lange termijn vaak belangrijker dan een eenmalige trainingssessie. Elke query verbruikt energie en grote contextvensters verhogen deze vraag. Tegelijkertijd kan een efficiënt expertmodel minder berekeningen per token vereisen dan een complex model met een vergelijkbare totale capaciteit. De cruciale vergelijking is daarom niet een hoog absoluut verbruik versus geen verbruik, maar eerder energie per bruikbaar resultaat.
Europa heeft een strategische drijfveer voor efficiëntie. Hoge elektriciteitsprijzen en beperkte datacentercapaciteit maken inefficiënte architecturen bijzonder duur. Modellen zoals Kolibri-1, die slechts een klein deel van hun parameters activeren, passen in een Europese strategie om technologische prestaties te combineren met een efficiënt gebruik van hulpbronnen. Dit voordeel wordt echter gedeeltelijk tenietgedaan door de hoge opslagvereisten en de benodigde krachtige hardware.
De benchmarks tonen een sterke positie, maar geen duidelijke winnaar
De gepubliceerde vergelijkende gegevens positioneren Kolibri-1 als een hoogwaardig model in zijn grootte- en efficiëntieklasse. Het behaalt een gemiddelde score van 75,5 punten in het Engels en 70,8 punten in het Duits. De prestaties zijn met name sterk in wiskunde en meerstapsredenering. Het behaalt 96,0 procent in de Engelse AIME-2026-test en 90,0 procent in de Duitse versie. In de wetenschappelijk veeleisende GPQA Diamond-test behaalt het model 84,3 procent in het Engels en 81,3 procent in het Duits.
Kolibri-1 behaalt ook concurrerende resultaten in programmeertaken, agentgebaseerde processen en industriële RAG-scenario's. Bijzonder opmerkelijk zijn de hoge scores op gebieden zoals toeleveringsketens in de automobielindustrie, halfgeleidertechnologie, de Duitse publieke sector en industriële aandrijftechnologie. Dit ondersteunt de positionering als model voor kennisintensieve bedrijfsprocessen. Even belangrijk is de verbetering ten opzichte van een eerdere basislijn: na de training zijn het redeneervermogen, het gebruik van tools en de naleving van instructies aanzienlijk verbeterd.
Desondanks is Kolibri-1 niet in alle disciplines de beste. Dichter en groter concurrerende modellen behalen betere resultaten in diverse kennis-, code- en lange-contexttests. Andere expertmodellen presteren ook beter in individuele taken zoals het aanroepen van tools of het ophalen van informatie. De Duitse resultaten zijn sterk, maar niet consistent superieur. Daarom kan een duidelijk economisch voordeel niet uitsluitend worden afgeleid uit een benchmarktabel.
Benchmarks weerspiegelen alleen gedefinieerde testomstandigheden. In de praktijk zijn de documentkwaliteit, toegangsrechten, diversiteit aan formaten, technisch jargon en de gevolgen van fouten aanzienlijk complexer. Een model kan goed presteren in een gestandaardiseerde test, maar toch falen door slecht gescande PDF's, tegenstrijdige legacy-gegevens of interne afkortingen. Omgekeerd kan een model met een iets lagere gemiddelde score superieur zijn in een goed geconfigureerde bedrijfsapplicatie.
Voor inkoop- en architectuurbeslissingen is intern testen daarom essentieel. Bedrijven moeten gebruikmaken van representatieve documenten, uitdagende randgevallen en data uit de praktijk. Metingen moeten niet alleen de nauwkeurigheid van de respons omvatten, maar ook kosten, latentie, stabiliteit, bronreferentie, faalgedrag en onderhoudbaarheid. Kolibri-1, met zijn open gewichten, is zeer geschikt voor dergelijke gecontroleerde evaluaties. Dit is een significant voordeel ten opzichte van systemen waarvan de interne versies en bedrijfsomstandigheden kunnen veranderen zonder tussenkomst van de klant.
Beveiliging is een systeemgerichte taak
De training van Kolibri-1 omvat maatregelen tegen schadelijke inhoud, persoonsgegevens en hallucinaties. Persoonsgegevens werden gedeeltelijk verwijderd of vervangen tijdens de voorbereidende training. Voor de gecontroleerde finetuning werden gegevens toegevoegd ter bescherming tegen aanvallen op persoonsgegevens. Bovendien werd het model getraind om niet te reageren wanneer het geconfronteerd wordt met ontbrekende of tegenstrijdige informatie.
Deze maatregelen verminderen de risico's, maar elimineren ze niet volledig. Taalmodellen kunnen onjuiste informatie genereren, politieke of sociale vooroordelen aannemen en reageren op gemanipuleerde invoer. Indirecte promptinjectie-aanvallen zijn bijzonder problematisch. Bij deze aanvallen bevat een opgehaald document verborgen instructies die bedoeld zijn om het model te misleiden en ongewenste acties te laten uitvoeren. Hoe vaker tools en geautomatiseerde processen worden gebruikt, hoe groter de potentiële schade van een dergelijke aanval.
Beveiligde bedrijfssystemen vereisen daarom meerdere beschermingslagen. Toegang moet worden verleend volgens het principe van minimale bevoegdheden. Aanroepen van tools moeten worden gevalideerd, gevoelige acties vereisen goedkeuring en de uitvoer moet worden gelogd. Het model mag niet zelfstandig bepalen welke gegevens het mag inzien of welke transacties het mag uitvoeren. De toegangsrechten moeten technisch beperkt zijn, los van het model zelf.
De uitgebreide context brengt ook nieuwe risico's met zich mee. Grote hoeveelheden documenten kunnen vertrouwelijke informatie, persoonsgegevens of tegenstrijdige instructies bevatten. Iedereen die complete dataruimtes beheert, moet ervoor zorgen dat gebruikers alleen toegang krijgen tot de informatie waarvoor ze geautoriseerd zijn. Een centraal taalmodel voor verschillende afdelingen zonder consistente toegangsscheiding kan onbedoeld bestaande informatiesilo's doorbreken.
Implementatie in gereguleerde sectoren vereist daarom meer dan een in Europa ontwikkeld model. Het vereist gedocumenteerde risicobeoordelingen, gegevensclassificatie, menselijk toezicht, technische protocollen en duidelijke verantwoordelijkheidslijnen. Soevereiniteit betekent niet simpelweg dat gegevens zich in een specifiek datacenter bevinden. Het betekent dat een organisatie de volledige controle heeft over het technische en juridische besluitvormingsproces.
Het trans-Atlantische machtsblok achter het model
De lancering van Kolibri-1 valt samen met een periode van ingrijpende bedrijfsherstructurering. Aleph Alpha en het Canadese AI-bedrijf Cohere hebben een bindende overeenkomst gesloten om te fuseren. De transactie is nog onderhevig aan definitieve goedkeuring door de regelgevende instanties begin oktober 2026. Het gecombineerde bedrijf zal wereldwijd opereren onder de merknaam Cohere, met hoofdkantoren in Toronto en Berlijn. De vestiging in Heidelberg blijft behouden als onderzoekscentrum.
Deze samenvoeging verandert de classificatie van Kolibri-1. Hoewel het model in Duitsland is ontwikkeld, wordt de economische toekomst ervan steeds meer bepaald door een trans-Atlantische organisatie. De fusie combineert Aleph Alpha's onderzoek, Duitstalige expertise en toegang tot de publieke sector met Cohere's internationale bereik, bedrijfsproducten en verkoopcapaciteit. Dit kan de commercialisering versnellen, maar ondermijnt het idee van een volledig onafhankelijke Duitse AI-kampioen.
Politiek gezien wordt het partnerschap afgeschilderd als een alternatief van Duitsland en Canada voor de dominante Amerikaanse platformbedrijven. Deze beschrijving is begrijpelijk, maar slechts gedeeltelijk toereikend. Hoewel Canada een nauwe partner van Europa is, is het onderworpen aan andere juridische, kapitaalmarkt- en veiligheidsstructuren. Digitale soevereiniteit vloeit niet automatisch voort uit de nationaliteit van de betrokken bedrijven. Cruciale factoren zijn onder meer de eigendomsstructuur, governance, toegang tot data, controle over de infrastructuur en de mogelijkheid voor Europese klanten om van aanbieder en locatie te wisselen.
De Schwarz Group speelt hierin een sleutelrol. Het was al een belangrijke investeerder in Aleph Alpha en investeert nu verder in het gecombineerde bedrijf. Via Schwarz Digits en het STACKIT-cloudplatform zal het rekenkracht leveren voor soevereine AI-oplossingen. Dit creëert een meer verticaal geïntegreerde structuur die modelontwikkeling, bedrijfssoftware, cloudinfrastructuur en datacentercapaciteit omvat.
Vanuit economisch oogpunt is deze consolidatie logisch. Eén enkel model genereert op zichzelf geen marktmacht. Waardecreatie ontstaat door verkoop, integratie, hosting, dataplatformen en langetermijncontracten met klanten. De trans-Atlantische alliantie kan deze niveaus beter afdekken dan Aleph Alpha alleen. Tegelijkertijd vergroot dit de afhankelijkheid van een paar grote partners. Mocht STACKIT de voorkeursbasis voor technische oplossingen worden, dan zou de openheid van de modelwegingen in de praktijk aangevuld kunnen worden met een sterke focus op een specifiek operationeel ecosysteem.
De soevereiniteit van Europa moet concreet worden gemaakt, niet symbolisch
Europa investeert fors in AI-infrastructuur. Het netwerk van Europese AI-fabrieken groeit en er zijn miljarden euro's gereserveerd voor AI-fabrieken en aanverwante structuren. Daarnaast staan er diverse AI-gigafabrieken gepland. Het doel is om Europese bedrijven, onderzoeksinstellingen en overheidsinstanties toegang te bieden tot krachtige computercapaciteit. Dit infrastructuurbeleid is noodzakelijk omdat moderne modellen niet economisch ontwikkeld of beheerd kunnen worden zonder grote GPU-clusters.
Kolibri-1 laat echter zien dat hardware alleen niet voldoende is. Europa heeft een compleet industrieel ecosysteem nodig, bestaande uit modellen, datacenters, dataruimtes, integratoren, gespecialiseerde software, beveiligingsdiensten en gekwalificeerde gebruikers. Publieke investeringen in rekenkracht zijn alleen effectief als ze leiden tot commercieel aantrekkelijke toepassingen. Anders subsidieert Europa dure infrastructuur, terwijl de winstgevende software- en platformbedrijven buiten het continent blijven.
De vraag is er wel degelijk. Een grote meerderheid van de Duitse bedrijven geeft de voorkeur aan AI-oplossingen uit Duitsland. In de praktijk domineren Amerikaanse diensten echter duidelijk. Deze discrepantie is niet te wijten aan een gebrek aan interesse in soevereiniteit, maar eerder aan gemak, productvolwassenheid, ecosystemen en bestaande contracten. Bedrijven kiezen zelden een model op basis van de herkomst. Ze kiezen een oplossing als deze snel te integreren, betrouwbaar, transparant geprijsd en organisatorisch beheersbaar is.
Kolibri-1 moet daarom meer bieden dan alleen de belofte van Europese oorsprong. Het heeft concurrerende tools, stabiele hostingopties, goede documentatie, partnernetwerken en meetbare voordelen in Duitse bedrijfsprocessen nodig. De Apache 2.0-aanpak faciliteert de ontwikkeling van een dergelijk ecosysteem. Softwarebedrijven en onderzoeksgroepen kunnen het model testen, aanpassen en integreren in hun eigen producten. Dit verhoogt de kans dat innovatie niet beperkt blijft tot één enkele leverancier.
Tegelijkertijd bestaat het risico dat open weegsystemen worden misbruikt door wereldwijde platforms zonder dat Duitsland een evenredig deel van de toegevoegde waarde ontvangt. Openheid is daarom geen vervanging voor een gedegen bedrijfsstrategie. Aleph Alpha en haar partners moeten diensten, veilige operationele modellen, branchespecifieke oplossingen en institutioneel vertrouwen verkopen. Het model dient als technologische basis en toegangspoort, niet als enige bron van inkomsten.
Een realistische beoordeling van Hummingbird-1
Kolibri-1 is noch het bewijs van volledige Europese AI-onafhankelijkheid, noch een onbeduidend nichemodel. Het belang ervan ligt ergens tussen deze uitersten in. Technisch gezien combineert het een grote totale capaciteit met een relatief lage actieve rekenbelasting, een ongewoon sterke Duitse trainingscomponent, zeer lange contexten, redeneervermogen en toolaanroepmogelijkheden. De open licentie biedt bedrijven, integratoren en overheidsinstellingen concrete mogelijkheden.
Economisch gezien is dit model bijzonder aantrekkelijk in omgevingen waar gevoelige data, Duitse technische terminologie en hoge gebruiksvolumes samenkomen. Grote industriële bedrijven, overheidsinstanties, banken, verzekeringsmaatschappijen, energieleveranciers, onderzoeksinstellingen en gespecialiseerde softwareleveranciers behoren tot de voor de hand liggende doelgroepen. Voor kleine bedrijven zonder eigen infrastructuur is directe hosting doorgaans minder praktisch. Zij zullen Kolibri-1 eerder gebruiken via managed services, branchespecifieke oplossingen of soevereine cloudoplossingen.
Het grootste voordeel schuilt niet in de 78 miljard parameters, maar in de mogelijkheid om controle en aanpassingsvermogen te combineren met concurrentievermogen. Het grootste nadeel is dat deze controle betaald en organisatorisch beheerd moet worden. Degene die het model zelf beheert, is verantwoordelijk voor de infrastructuur, de beveiliging, de evaluatie en de updates. Dit is strategische vrijheid, maar niet vrijheid zonder kosten.
De samenwerking met Cohere en Schwarz Digits zou Kolibri-1 kunnen transformeren tot een internationaal verkoopbaar bedrijfsproduct. Het zou onderzoek, kapitaal, verkoop en rekenkracht kunnen samenbrengen. Tegelijkertijd vereist het een nuchtere heroverweging van het concept digitale soevereiniteit. Een trans-Atlantische onderneming met Duits onderzoek en een Europese cloudinfrastructuur zou een levensvatbaar alternatief kunnen zijn voor de grote Amerikaanse platforms. Het is echter niet automatisch een puur Duits of volledig Europees systeem.
De duidelijke conclusie is dan ook: Kolibri-1 is een serieuze bouwsteen voor een Europese AI-economie, maar het is geen garantie voor succes. Het succes ervan zal niet worden bepaald door benchmarktabellen, maar door datacenters, inkoopbudgetten en concrete bedrijfsprocessen. Als het voordeel van de Duitse taal, de open licentie en de efficiënte expertarchitectuur kunnen worden vertaald naar robuuste applicaties, kan het model een commercieel belangrijke markt veroveren. Als hosting, integratie en distributie te duur of te complex blijven, zal technologische kwaliteit alleen niet volstaan.
Kolibri-1 illustreert daarmee zowel de kansen als de problemen van Europa. Het continent kan krachtige AI ontwikkelen, heeft veeleisende industriële klanten en breidt zijn infrastructuur uit. Wat vaak ontbreekt, is de snelle opschaling van een onderzoeksmodel naar een breed geaccepteerd standaardproduct. De kolibrie lijkt licht en gebruikt slechts een klein deel van zijn vleugelkracht per keer. Maar om economisch te kunnen vliegen, heeft hij een solide basis nodig van kapitaal, energie, rekenkracht, vertrouwen en distributie.
🎯🎯🎯 Datagestuurd B2B-brancheplatform als quasi-interne oplossing

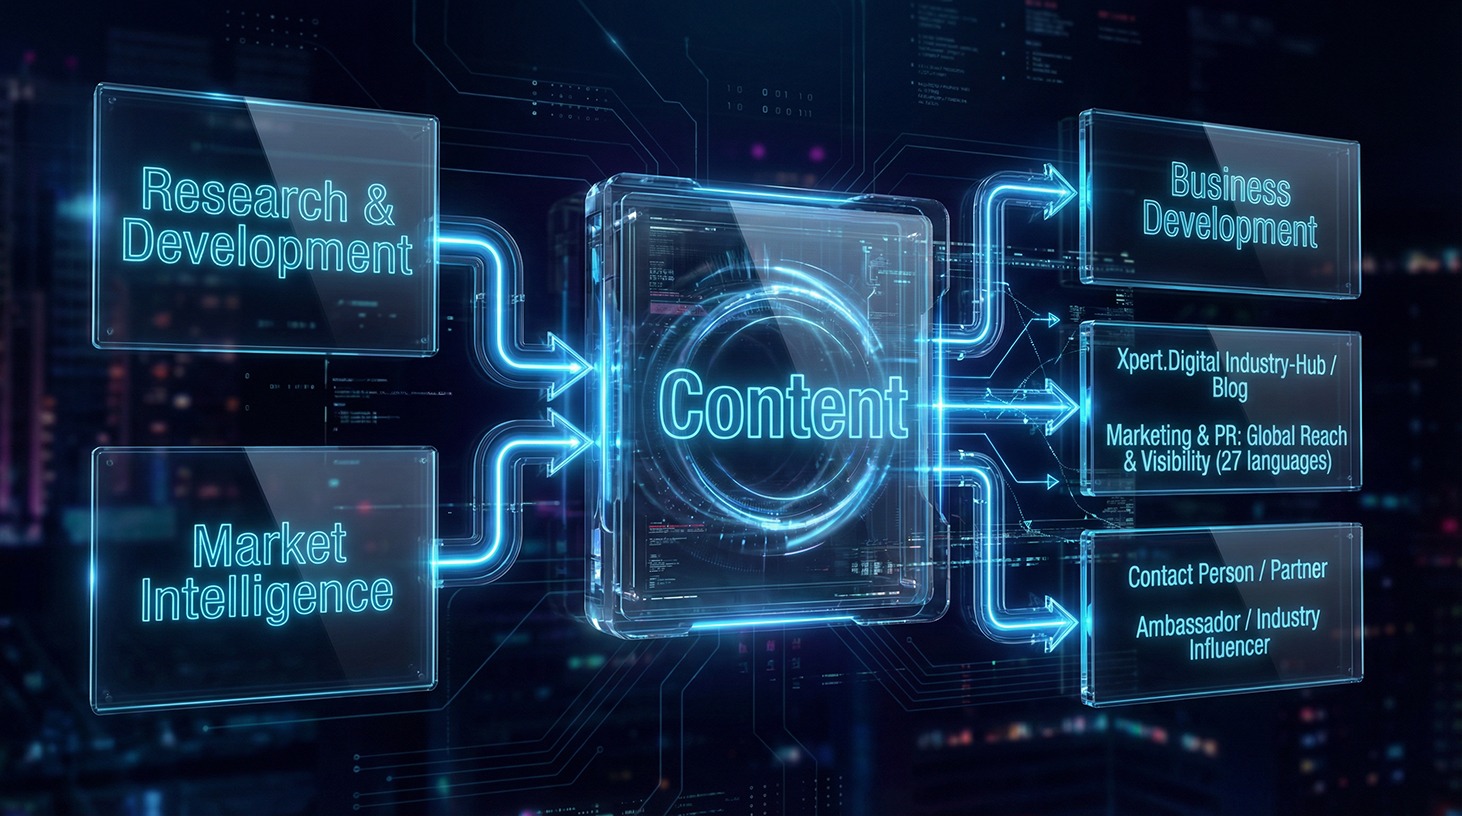
De quasi-interne oplossing: Hoe Xpert.Digital operationele hiaten in B2B-marketing en -verkoop dicht – Slimme, contentgedreven bedrijfsvoering - Afbeelding: Xpert.Digital
Xpert.Digital is een datagedreven B2B-branchehub onder leiding van Konrad Wolfenstein . Het bedrijf fungeert als een externe, quasi-interne oplossing voor industriële partners en dicht operationele lacunes in marketing, content en sales – zonder dat de klant extra middelen nodig heeft.
Meer informatie vindt u hier:
Uw wereldwijde partner voor marketing en bedrijfsontwikkeling
☑️ Onze zakelijke voertaal is Engels of Duits
☑️ NIEUW: Correspondentie in uw moedertaal!

Konrad Wolfenstein
Mijn team en ik staan graag tot uw beschikking als uw persoonlijke adviseur.
U kunt contact met mij opnemen door hier het contactformulier in te vullen wolfenstein@xpert.digital:of door mij te bellen op +49 7348 4088 965. Mijn e-mailadres is
Ik kijk uit naar ons gezamenlijke project.