
Enterprise AI begint waar de chatbot ophoudt
Xpert Pre-release

Available in 27 languages 📢
Kies Xpert.Digital op GoogleⓘGepubliceerd op: 2 oktober 2026 / Bijgewerkt op: 2 oktober 2026 – Auteur: Konrad Wolfenstein
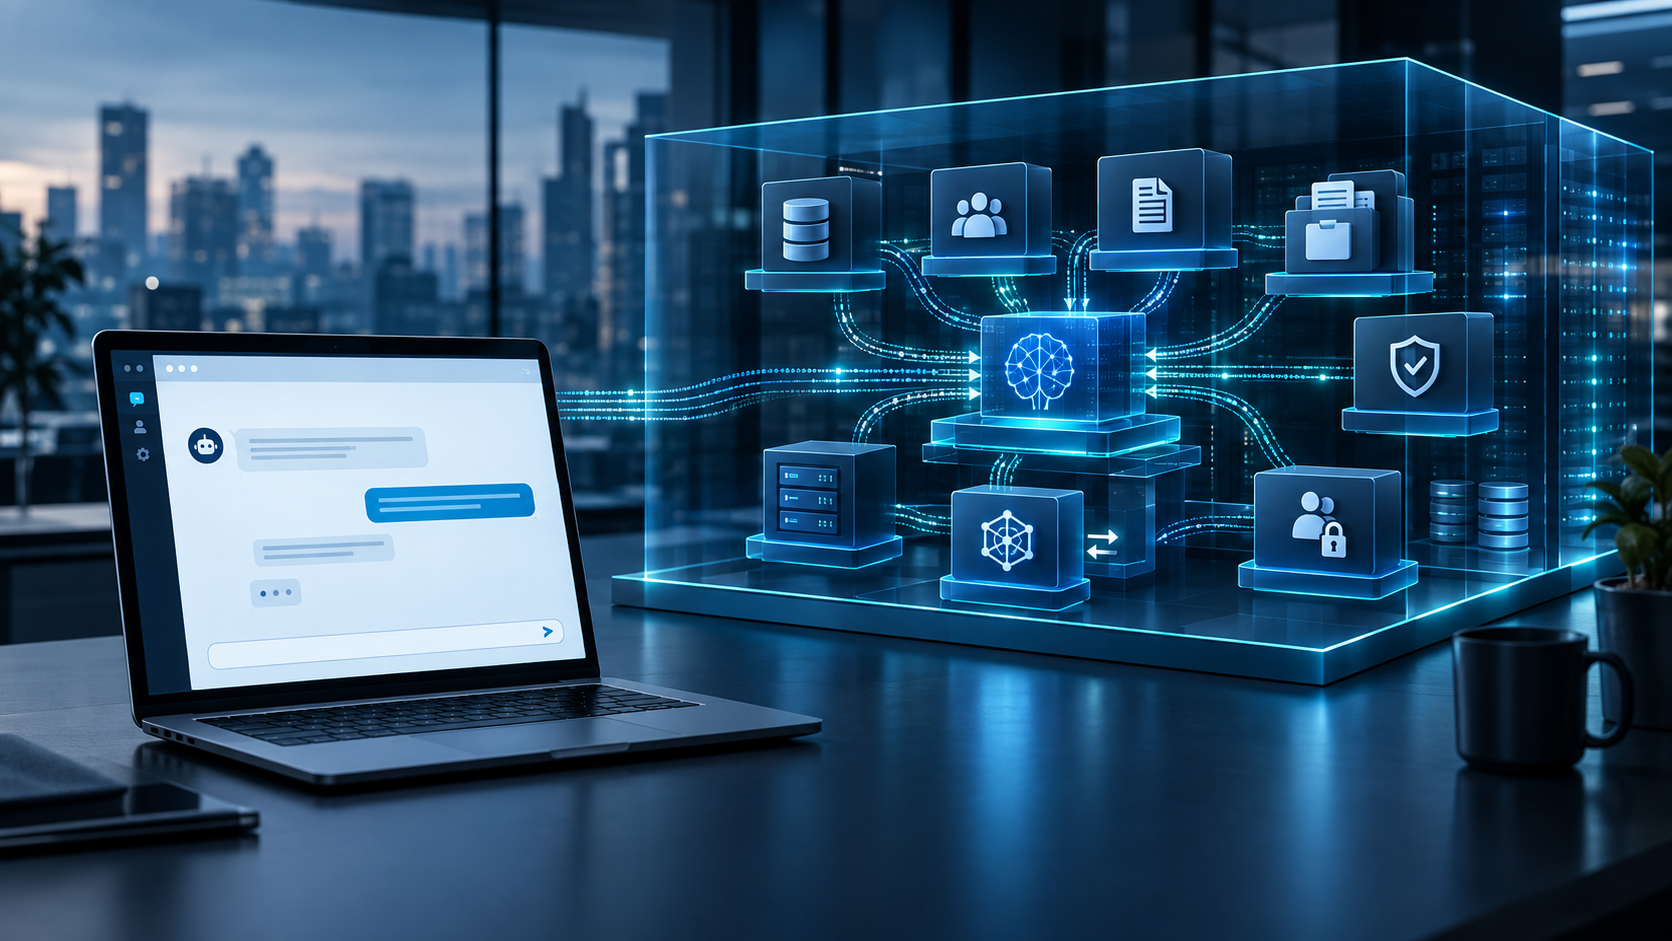
Enterprise AI begint waar de chatbot eindigt – een creatieve afbeelding over dit onderwerp, met AI: Xpert.Digital
Van licentie naar verantwoordelijkheid: hoe bedrijven hun AI-strategie moeten herzien
Zo dichten bedrijven de kloof tussen de verwachtingen en de realiteit van AI
Het belang van een contextlaag voor effectieve AI in bedrijven
In het huidige digitale landschap wordt de integratie van kunstmatige intelligentie (AI) in bedrijfsprocessen steeds belangrijker. Veel bedrijven worden echter geconfronteerd met de uitdaging dat hun medewerkers vaak gebruikmaken van ongeautoriseerde, private AI-diensten – een praktijk die bekend staat als schaduw-AI. Deze ontwikkeling legt een kritieke kloof bloot tussen de oplossingen die bedrijven bieden en de werkelijke behoeften van gebruikers op de werkvloer. Hoewel bedrijfslicenties voor gevestigde AI-tools als een basismaatregel worden beschouwd, zijn ze op zichzelf onvoldoende om te voldoen aan de complexe eisen en specifieke omstandigheden van een bedrijf. Echte generatieve AI voor bedrijven vereist een goed ontworpen systeemarchitectuur die modellen, gegevenstoegang, proceslogica en verantwoording omvat. In dit artikel onderzoeken we de essentiële aspecten waarmee bedrijven rekening moeten houden om het potentieel van AI volledig te benutten en schaduw-AI effectief te bestrijden.
Dit is hiermee gerelateerd:
Het simpelweg verstrekken van licenties digitaliseert het bedrijf niet, maar wel het probleem van de verborgen AI
In veel bedrijven wordt de toekomst van generatieve kunstmatige intelligentie niet bepaald tijdens een strategievergadering, maar in een onopvallend moment op de werkvloer: een medewerker kopieert een klantcontract, een berekening of een interne e-mail naar een openbaar toegankelijke AI-service, omdat de privé gebruikte tool sneller, begrijpelijker en krachtiger lijkt dan de officieel goedgekeurde bedrijfsoplossing. Vanuit het perspectief van de medewerker is dit vaak geen opzettelijke overtreding van de regels, maar een pragmatische reactie op inefficiënte processen. Vanuit het perspectief van het bedrijf duidt het echter op een gevaarlijke kloof tussen technische goedkeuring en daadwerkelijke bruikbaarheid.
De gebruikelijke reflex om deze kloof te dichten door een bedrijfsbrede licentie aan te schaffen voor een bekende AI-assistent schiet tekort. Zo'n licentie kan belangrijke waarborgen, administratieve functies en contractuele verplichtingen bieden. Het transformeert een algemene assistent echter niet automatisch in een systeem dat de producten, klanten, contracten, rollen, goedkeuringsgrenzen en workflows van het bedrijf begrijpt. Evenmin beantwoordt het automatisch vragen zoals waar gevoelige gegevens worden verwerkt, wie verantwoordelijk is voor onjuiste resultaten, of of verdere processen tegen redelijke meerkosten kunnen worden ontwikkeld na de eerste implementatie.
De centrale economische these is daarom als volgt: Echte generatieve AI voor bedrijven is geen enkel model of een chatvenster met een bedrijfslogo. Het is een operationeel systeem dat bestaat uit modellen, data-toegangspunten, context, identiteiten, machtigingen, proceslogica, kwaliteitscontroles, verantwoordelijkheden en een robuuste kostenarchitectuur. De werkelijke waarde ontstaat niet door toegang tot de AI, maar door de gecontroleerde integratie ervan in de organisatie. Dit is precies waar een productieve bedrijfscomponent zich onderscheidt van een handig consumentenproduct met een zakelijke login.
Een bedrijfsvergunning is een fundament, maar nog geen gebouw
De bedrijfsversies van de belangrijkste AI-assistenten lossen problemen uit de praktijk op. Leveranciers beloven doorgaans standaard geen gebruik te maken van bedrijfsgegevens voor het trainen van hun algemene modellen. Extra functies omvatten gecentraliseerd gebruikersbeheer, single sign-on, op rollen gebaseerde toegangscontrole, logging, encryptie, gebruiksrapporten, gegevensverwerkingsovereenkomsten en gedeeltelijk configureerbare bewaartermijnen. Bovendien kunnen bestaande toegangsrechten, beleidsregels en beveiligingsmechanismen binnen de bestaande kantooromgevingen worden hergebruikt. Voor veel organisaties betekent dit een aanzienlijke verbetering ten opzichte van persoonlijke accounts.
De fout zit hem niet in de aanschaf van dergelijke licenties. De fout zit hem in de verwarring tussen de beschermingsomvang en een complete bedrijfsoplossing. Een toezegging om klantgegevens niet te gebruiken voor algemene modeltraining beantwoordt slechts één van de vele vragen met betrekking tot data. De locatie van de verwerking, de opslag van input en output, de bewaartermijn, de betrokkenheid van onderaannemers, de verwerking van telemetrie en de toepasselijke jurisdicties kunnen allemaal onbeantwoord blijven. Bovendien verschillen het chatproduct, de programmeerinterface, de geïntegreerde kantoorassistent en de klantspecifieke cloudomgeving vaak aanzienlijk. Een algemene vrijgave op basis van merknaam is daarom onvoldoende, zowel vanuit zakelijk als vanuit regelgevend oogpunt.
Bovenal mist de licentie zelf institutioneel geheugen. Een model weet niet automatisch wat de specifieke betekenis van een productnaam voor het bedrijf is, de geschiedenis van een klacht, of welk van de verschillende klantensystemen gezaghebbend is voor een bepaald proces. Het herkent geen informele uitzonderingen of de goedkeuringsmatrix en kan niet zelfstandig bepalen of een verouderd beleid of de opvolger ervan van toepassing is. Toegang tot het model wordt gekocht; de operationele betrouwbaarheid moet echter continu worden opgebouwd, getest en onderhouden.
Shadow AI is een marktbeoordeling door het personeel van het bedrijf zelf
Het gebruik van privé-AI-accounts wordt vaak beschouwd als een kwestie van discipline of training. Dit is echter een te simplistische benadering. Wanneer werknemers ondanks verboden gebruikmaken van ongeautoriseerde tools, geven ze onbedoeld feedback vanuit de markt: de toegestane optie schiet in een directe vergelijking tekort op het gebied van snelheid, gebruiksgemak, modelkwaliteit en praktische integratie in werkprocessen. Verboden kunnen risico's op korte termijn verminderen, maar ze nemen de vraag naar een betere oplossing niet weg.
De omvang is aanzienlijk. Rapporten geven aan dat in 2026 47 procent van de werknemers die generatieve AI op de werkplek gebruiken, nog steeds persoonlijke, onbeheerde accounts zullen gebruiken. Tegelijkertijd is het aantal geregistreerde incidenten met betrekking tot de overdracht van gevoelige gegevens aan AI-toepassingen verdubbeld. Gemiddeld werden er 223 van dergelijke beleidsschendingen per organisatie per maand geregistreerd; voor bijzonder getroffen bedrijven lag de last vele malen hoger. Gereguleerde persoonlijke, financiële en medische gegevens waren verantwoordelijk voor een bijzonder groot deel van deze schendingen. Dergelijke statistieken registreren alleen zichtbare incidenten en geven waarschijnlijk geen volledig beeld van het werkelijke gebruik.
Vanuit economisch oogpunt concurreert centrale IT dus met een gratis of particulier gefinancierd alternatief. Dit alternatief heeft lage instapdrempels, een goede gebruikerservaring en is vaak het meest recente model. Een intern alternatief wint het niet alleen op basis van naleving van regelgeving, maar alleen als het minstens even gebruiksvriendelijk is en extra waarde voor de organisatie biedt. Het moet relevante informatie vinden, beschikbaar zijn in bestaande applicaties, onnodig kopiëren voorkomen en antwoorden in de context van het werkproces plaatsen. Duurzame acceptatie wordt niet bereikt door dwang, maar door grotere voordelen met minder persoonlijke inspanning.
Dit betekent niet dat technische controles overbodig zijn. Preventie van dataverlies, clientbeperkingen, browsercontrole, logging en duidelijke gebruiksregels blijven essentieel. De effectiviteit ervan neemt echter aanzienlijk toe wanneer er ook een krachtig alternatief beschikbaar is. De juiste reactie van het management is daarom niet alleen het blokkeren van verborgen AI, maar ook het analyseren van de onderliggende oorzaken: Voor welke taken gebruiken medewerkers het? Welke geautoriseerde systemen falen? Welke inefficiënties zorgen ervoor dat mensen privéaccounts gebruiken? Deze antwoorden leiden tot een realistische prioriteitenlijst voor AI binnen de organisatie.
Bedrijfskennis wordt niet in een chatvenster gecreëerd
Algemene AI-assistenten beginnen een proces voornamelijk met de context die door de gebruiker wordt aangeleverd of die het product afleidt uit beperkte eerdere interacties. Deze neutraliteit is vaak nuttig voor persoonlijke taken. In een zakelijke context wordt het echter een risico zodra beslissingen afhankelijk zijn van historische, contractuele of klantspecifieke informatie. Een betrouwbaar antwoord op een verzekeringsclaim kan bijvoorbeeld alleen worden verkregen door de claimgeschiedenis, de polisversie, correspondentie, wettelijke vereisten en de verwerkingsstatus te combineren. Een enkel geüpload contract is hiervoor onvoldoende.
De benodigde kennis bevindt zich zelden op één plek. Ze is verspreid over ERP-systemen, CRM's, documentbeheersystemen, ticketsystemen, datawarehouses, e-mail, gespecialiseerde applicaties en persoonlijke bestanden. Bovendien zijn er verschillende identificaties, spellingen, dataversies en verantwoordelijkheden. Een klant kan onder verschillende namen in drie systemen voorkomen; een productcode kan na een fusie een andere betekenis hebben gekregen; een beleid kan formeel nog steeds toegankelijk zijn, maar technisch achterhaald. Het taalmodel kan deze tegenstrijdigheden niet zelfstandig oplossen. Zonder betrouwbare mapping kan het hoogstens een taalkundig overtuigende synthese van inconsistente gegevens produceren.
Contextvoorziening is daarom in de eerste plaats een taak op het gebied van integratie en gegevensbeheer. Het gericht genereren van relevante content op het moment van een verzoek, aangevuld met zoekopdrachten, is een belangrijke methode, maar geen complete oplossing. Ook metadata, versiebeheer, identiteitsverificatie, autorisatiecontroles, prioriteit van bronnen, geldigheidsperioden en regels voor tegenstrijdige informatie zijn vereist. Hoe meer het systeem bedoeld is om te handelen in plaats van alleen te reageren, hoe belangrijker transactionele controles en een duidelijk gedefinieerd systeemleiderschap worden.
Een eenvoudige test kan de volwassenheid van een tool aantonen: de goedgekeurde tool krijgt een vraag voorgelegd die alleen interne bedrijfskennis vereist om correct te beantwoorden. Als de tool een algemeen, zelfverzekerd en onjuist antwoord geeft, functioneert deze in feite als een chatbot met toegang tot de bedrijfssystemen. Als de tool slechts om een bestand vraagt, is het een chatbot met een uploadfunctie. Pas wanneer de tool op legitieme, transparante en realtime wijze toegang krijgt tot de relevante systemen, onzekerheid herkent en het antwoord in de juiste bedrijfscontext plaatst, ontstaat er echte bedrijfsintelligentie.
De contextlaag wordt de productieve kapitaalvoorraad
De cruciale architectonische component bevindt zich tussen het model en de operationele bedrijfsvoering. Deze laag kan worden omschreven als een contextplatform, kennisstructuur of integratie- en orchestratielaag. De naam is minder belangrijk dan de functie: het koppelt entiteiten aan elkaar, verbindt gegevensbronnen, controleert toegangsrechten, biedt definities, beheert tools en documenteert hoe een reactie of actie tot stand is gekomen. Idealiter wordt dit werk niet voor elk gebruiksscenario opnieuw gedaan, maar gebouwd als een herbruikbare bouwsteen voor de gehele organisatie.
Vanuit economisch perspectief is deze laag te vergelijken met een productieve kapitaalvoorraad. De eerste koppeling met een contractarchief, de eerste correcte toewijzing van klantidentiteiten of de eerste implementatie van een goedkeuringslogica brengt hoge opstartkosten met zich mee. Zodra deze elementen echter gestandaardiseerd zijn, kunnen verdere gebruiksscenario's daarop voortbouwen. De marginale kosten van het tweede, derde en vijfde gebruik zouden moeten dalen. Dit effect alleen al rechtvaardigt een platformstrategie: een deel van de investering wordt niet alleen bruikbaar voor één project, maar voor een groeiend aantal toekomstige processen.
Dit hergebruikseffect treedt echter niet automatisch op. Veel zogenaamde platforms bestaan uit een verzameling projectspecifieke interfaces, prompts en maatwerkoplossingen. Elke nieuwe applicatie moet vervolgens opnieuw worden geanalyseerd, geïntegreerd en beveiligd. De kosten blijven lineair, terwijl er steeds meer afhankelijkheden ontstaan. Een echte test voor de volwassenheid van een platform is daarom om te bepalen welke specifieke componenten uit het eerste gebruiksscenario in het tweede scenario kunnen worden hergebruikt zonder dat ze opnieuw hoeven te worden opgebouwd. Herbruikbare componenten zijn bijvoorbeeld identiteitsdiensten, connectoren, toegangscontrole, datacatalogi, evaluatieprocedures, logging, modeltoegang en gestandaardiseerde menselijke goedkeuringen.
De contextlaag is strategisch belangrijker dan de keuze voor één enkel model. Modellen verbeteren snel, prijzen veranderen en verschillende taken profiteren van verschillende sterke punten. Daarom moeten bedrijven in staat zijn om op een gecontroleerde manier tussen modellen te wisselen of om er meerdere parallel te gebruiken. Het wisselen is echter niet geheel kosteloos: promptgedrag, uitvoerformaten, beveiligingsfilters, contextvensters en prestatieprofielen verschillen. Een goede architectuur verlaagt deze wisselkosten door middel van abstractie, gestandaardiseerde interfaces en herhaalbare tests, in plaats van een onrealistische indruk van volledige uitwisselbaarheid te wekken.
Datasoevereiniteit omvat meer dan alleen het uitsluiten van trainingen
Het publieke debat draait al lange tijd om de vraag of input wordt gebruikt om een model te trainen. Hoewel deze vraag belangrijk is voor bedrijven, is de focus te beperkt. De gehele opslag- en verwerkingsketen is cruciaal: Waar wordt input verwerkt? Welke delen van een document worden overgedragen? Waar worden chatgeschiedenissen, caches, logboeken en vectorrepresentaties opgeslagen? Hoe lang worden ze bewaard? Welke onderaannemers hebben technische contactpunten? Welk wettelijk kader is van toepassing? Kunnen beheerders content bekijken, exporteren en verwijderen? Hoe worden back-ups beheerd?
Een marketingafdeling mag onder bepaalde omstandigheden op verantwoorde wijze gebruikmaken van een extern bewerkt concept. Voor niet-gepubliceerde bedrijfsgegevens, bedrijfsgeheimen, gezondheidsgegevens, rechtszaken of kritieke infrastructuur gelden andere normen. De risicoclassificatie mag daarom niet alleen gebaseerd zijn op het gebruikte instrument, maar eerder op het type gegevens, de genomen actie, de potentiële schade en de mate van menselijk toezicht. Hetzelfde model zou een laag risico kunnen aangeven bij het herschrijven van een persbericht en een hoog risico bij de automatische verwerking van een lening of claim.
Een robuuste architectuur minimaliseert de verplaatsing van gegevens. Informatie blijft zoveel mogelijk binnen bestaande systemen; alleen de context die nodig is voor de taak wordt verstrekt, met inachtneming van de bestaande toegangsregels. Query's worden geautoriseerd op basis van de gebruiker, gevoelige velden worden waar nodig gemaskeerd en de uitvoer wordt geclassificeerd op basis van de inhoud. Voor bijzonder kritieke processen kan regionale verwerking, dedicated instances, vertrouwelijke computeromgevingen of lokale implementatie raadzaam zijn. Volledig in-house beheer is echter niet automatisch veiliger of economischer, aangezien beheer, patching, monitoring, modelonderhoud en specialistisch personeel aanzienlijke kosten met zich meebrengen.
De formule om het model naar de data te brengen beschrijft daarom een zinnig principe, maar mag niet worden opgevat als een technische vereenvoudiging. Zelfs bij gefedereerde of lokaal verbonden oplossingen kunnen fragmenten, embeddings of metadata externe services bereiken. Een gedocumenteerde dataflowanalyse op componentniveau is cruciaal. Alleen wanneer voor elke fase kan worden aangetoond welke data waar naartoe gaat en hoe deze wordt beschermd, kan de datasoevereiniteit betrouwbaar worden beoordeeld.
Regelgeving maakt traceerbaarheid tot een economische factor
In gereguleerde sectoren is dataflow geen abstract beveiligingsideaal. Financiële instellingen moeten, conform de Europese regelgeving voor digitale operationele weerbaarheid, systematisch de risico's beoordelen die uitgaan van informatie- en communicatietechnologieën en externe dienstverleners. Vertrouwelijkheidsovereenkomsten, beroepsgeheim, wetgeving inzake gegevensbescherming en sectorale regelgeving vereisen bovendien dat bedrijven hun verwerkingsactiviteiten, verantwoordelijkheden en controlemaatregelen kunnen toelichten. Een AI-toepassing waarvan de responskwaliteit overtuigend is, maar waarvan het datapad niet traceerbaar is, zal de operationele acceptatietest niet doorstaan.
Met de Europese wetgeving voor AI wint systematische governance aan belang. Grote delen van het Europese regelgevingskader zijn al sinds augustus 2026 van kracht, terwijl individuele verplichtingen voor bepaalde systemen met een hoog risico gefaseerd worden ingevoerd. Dit leidt niet tot een algeheel verbod op generatieve AI voor bedrijven. In plaats daarvan is een robuuste classificatie op basis van toepassingsgebied en rol vereist. Een algemeen model, een daarop gebaseerd gespecialiseerd systeem en het bedrijf dat dit systeem gebruikt, kunnen elk verschillende verplichtingen hebben. Transparantie, documentatie, menselijk toezicht, datakwaliteit, nauwkeurigheid, cybersecurity en traceerbaarheid zijn met name cruciaal voor toepassingen met een hoog risico.
Compliance is niet alleen een kostenfactor. Een herbruikbare controlearchitectuur kan de time-to-market verkorten, omdat niet elk project zijn regels opnieuw hoeft te definiëren. Gestandaardiseerde risicoklassen, goedgekeurde modelpaden, technische logging, evaluatiesjablonen en gedefinieerde goedkeuringsniveaus verminderen de onzekerheid. Governance transformeert zo van een downstream controlefunctie naar een productieve infrastructuur. Het economische voordeel wordt met name duidelijk tijdens de tweede en derde implementatie, wanneer geteste componenten hergebruikt kunnen worden.
Bedrijven moeten ook onderscheid maken tussen modelrisico en procesrisico. Een model kan technisch zeer krachtig zijn, terwijl een slecht ontworpen proces onjuiste gegevensbronnen blijft gebruiken, onduidelijke verantwoordelijkheden kent of het terugdraaien van foutieve acties niet mogelijk maakt. Omgekeerd kan een beperkt model zeer nuttig zijn in een strak gedefinieerd en goed gecontroleerd proces. Daarom is de kwaliteit van de algehele architectuur vaker de doorslaggevende factor voor de wettelijke en economische haalbaarheid dan de maximale prestaties van het model in algemene tests.
🤖🚀 Beheerd AI-platform: Sneller, veiliger en slimmer naar AI-oplossingen met UNFRAME

Beheerd AI-platform - Afbeelding: Xpert.Digital
Hier leert u hoe uw bedrijf snel, veilig en zonder hoge drempels AI-oplossingen op maat kan implementeren.
Een beheerd AI-platform is uw allesomvattende, zorgeloze oplossing voor kunstmatige intelligentie. In plaats van te worstelen met complexe technologie, dure infrastructuur en langdurige ontwikkelprocessen, ontvangt u een kant-en-klare oplossing op maat van een gespecialiseerde partner – vaak al binnen enkele dagen.
De belangrijkste voordelen in één oogopslag:
⚡ Snelle implementatie: Van idee tot gebruiksklare applicatie in dagen, niet maanden. Wij leveren praktische oplossingen die direct toegevoegde waarde creëren.
🔒 Maximale gegevensbeveiliging: Uw gevoelige gegevens blijven bij u. Wij garanderen een veilige en conforme verwerking zonder gegevens met derden te delen.
💸 Geen financieel risico: u betaalt alleen voor de resultaten. Hoge investeringen vooraf in hardware, software of personeel zijn volledig uitgesloten.
🎯 Focus op uw kernactiviteiten: concentreer u op waar u het beste in bent. Wij zorgen voor de volledige technische implementatie, werking en het onderhoud van uw AI-oplossing.
📈 Toekomstbestendig en schaalbaar: Uw AI groeit met u mee. Wij garanderen continue optimalisatie en schaalbaarheid en passen de modellen flexibel aan nieuwe eisen aan.
Meer informatie vindt u hier:
Van AI-project naar bedrijfsbesturingssysteem
De verantwoordelijkheid mag niet verdwijnen tussen het verlenen van vergunningen en het verlenen van advies
Consumentgerichte AI-diensten worden verkocht als tools. Aanbieders wijzen er terecht op dat uitgaven onnauwkeurig kunnen zijn en dat gebruikers de resultaten moeten controleren. Dit model is begrijpelijk voor een goedkope massamarkt. In zakelijke toepassingen ontstaat er echter een verantwoordelijkheidskloof zodra deze uitgaven de klanten bereiken, van invloed zijn op wettelijke rapportages of financiële processen in gang zetten. De aanbieder verkoopt de mogelijkheid om de dienst te gebruiken, maar neemt doorgaans geen verantwoordelijkheid voor de uitkomst van het specifieke bedrijfsproces.
Zelfs het traditionele integratiemodel kan deze kloof openlaten. Een dienstverlener analyseert, ontwikkelt en integreert gedurende maanden, factureert voor tijd en materiaal, en levert uiteindelijk een systeem op. Het contract kan formeel worden nagekomen, ook al wordt de tool in de praktijk slecht geaccepteerd, produceert deze te veel fouten of levert deze geen meetbare procesverbetering op. Enerzijds is toegang verkocht; anderzijds arbeid. In beide gevallen is niemand financieel gebonden aan het overeengekomen resultaat.
Enterprise AI vereist daarom een expliciete toewijzing van verantwoordelijkheden. Bedrijfsonderdelen, IT, informatiebeveiliging, gegevensbescherming, risicomanagement en leveranciers moeten weten wie verantwoordelijk is voor de datakwaliteit, wie modellen selecteert, wie limieten stelt, wie uitgaven goedkeurt en wie beslissingen neemt in geval van verstoringen. Voor geautomatiseerde acties zijn traceerbaarheid, intrekkingsmogelijkheden en duidelijk gedefinieerde escalatieprocedures essentieel. Menselijke controle is alleen effectief als de controleur voldoende tijd, expertise en informatie heeft; een routinematige klik reduceert menselijk toezicht tot een loutere formaliteit.
Resultaatgerichte beloningsmodellen kunnen de motivatie verhogen, maar ze zijn geen wondermiddel. Ze werken alleen als de resultaten meetbaar, toewijsbaar en beschermd tegen manipulatie zijn. Voor een duidelijk proces, zoals het verkorten van de verwerkingstijd, het verlagen van het foutenpercentage of het verhogen van het aantal opgeloste zaken, kunnen prestatiegerelateerde elementen worden afgesproken. Toewijzing is lastiger voor strategische, kennisintensieve taken. Een hybride model is vaak aan te raden, bestaande uit een basissalaris, kwaliteits- en gebruiksstatistieken en een component gekoppeld aan overeengekomen bedrijfsresultaten.
Het tweede gebruiksscenario legt de platformeconomie bloot
Veel selectieprocessen richten zich op een eerste, bewust eenvoudige use case. Het samenvatten van documenten, het opstellen van e-mails, het toelichten van een geüpload bestand of het genereren van tekstvarianten zijn zeer geschikt voor algemene modellen, omdat vrijwel de volledige context direct beschikbaar is. Dergelijke taken tonen de taalvaardigheden van het model aan, maar nauwelijks de volwassenheid van een bedrijfsplatform. Ze kunnen vaak worden afgedekt met slechts een paar licenties en een beheersbare implementatie-inspanning.
Het tweede gebruiksscenario is informatiever. Als hetzelfde systeem leveranciersfacturen moet afstemmen met contracten, heeft het toegang nodig tot het contractarchief, het ERP-systeem, de goedkeuringsmatrix, stamgegevens en uitzonderingsregels. Het moet verschillende aanduidingen consolideren, discrepanties verklaren, autorisaties respecteren en problemen doorverwijzen naar de juiste rol wanneer er onduidelijkheid bestaat. Hier verschuift de focus van het model naar de integratie- en proceslogica. Dit gebruiksscenario verifieert of de eerder vastgestelde architectuur daadwerkelijk herbruikbaar is.
Een platform verdient zijn naam pas echt wanneer de tweede implementatie relatief sneller en goedkoper verloopt, en dit effect versterkt wordt bij volgende toepassingen. Als elke nieuwe use case even duur blijft als de vorige, is er geen sprake van significante synergievoordelen. In dat geval heeft het bedrijf een licentie én een wachtlijst voor adviesdiensten. De belangrijkste commerciële test is daarom om een betrouwbare kostenraming en tijdsplanning te eisen voor de tweede en derde implementatie, nog voordat er überhaupt een beslissing over de eerste wordt genomen.
Dit perspectief verandert ook de investeringsberekening. De initiële use case mag niet worden belast met alle platformkosten afzonderlijk als belangrijke componenten later worden hergebruikt. Omgekeerd is het oneerlijk om vaag toekomstig hergebruik als voordeel te beschouwen zonder concrete vervolgprocessen, verantwoordelijken en budgetten te specificeren. Een gedegen berekening maakt onderscheid tussen eenmalige platforminvesteringen, use-case-specifieke ontwikkeling, doorlopende model- en infrastructuurkosten en kosten voor monitoring, kwaliteitsborging en wijzigingsbeheer. Alleen dan kan een realistische totale uitgave over meerdere jaren worden bepaald.
De kosten zijn zelden uitsluitend toe te schrijven aan de modelaanroepen
Bij generatieve AI ligt de focus vaak op licentiekosten of tokenkosten. Deze kosten zijn zichtbaar, maar vaak niet doorslaggevend bij complexe bedrijfsapplicaties. Bijkomende kosten omvatten dataopschoning, interfaces, identiteitsbeheer, beveiligingsaudits, evaluatiegegevenssets, monitoring, specialistische tijd, training, ondersteuning en continue aanpassingen. Onduidelijke data-eigendom, projectspecifieke maatwerkoplossingen en handmatig herwerk als gevolg van inconsistente kwaliteit worden bijzonder kostbaar.
Marktonderzoek onthult de spanning tussen hoge verwachtingen en beperkte schaalbaarheid. In een internationale enquête onder 2000 bedrijfsleiders heeft slechts ongeveer een kwart van de AI-initiatieven tot nu toe het verwachte rendement op investering behaald; slechts 16 procent is bedrijfsbreed geïmplementeerd. Tegelijkertijd beschouwde 72 procent bedrijfseigen data als cruciaal voor de waarde van generatieve AI, en 68 procent achtte een geïntegreerde, bedrijfsbrede data-architectuur essentieel. Deze cijfers zijn geen absolute waarheden, maar ze illustreren wel dat toegang tot modellen alleen niet leidt tot schaalbaarheid of rendement op investering.
Zelfs zeer hoge faalpercentages uit studies moeten met de nodige nuance worden geïnterpreteerd. Een veel geciteerde analyse uit 2025 concludeerde dat 95 procent van de onderzochte initiatieven geen meetbaar financieel voordeel had opgeleverd. De methodologie, de steekproefgrootte en de definitie van succes beperken de generaliseerbaarheid van deze bevinding; bovendien bevonden veel projecten zich nog in een vroeg stadium. Niettemin wijst het resultaat op een reëel patroon: generieke tools kunnen de individuele productiviteit verhogen, maar deze tijdsbesparing vertaalt zich niet automatisch in lagere kosten, een hogere doorvoer of extra inkomsten.
Voor de beoordeling van investeringen zijn processtatistieken daarom belangrijker dan activiteitsstatistieken. Het aantal gebruikers, prompts of gegenereerde teksten meet acceptatie, niet economisch succes. Relevanter zijn verwerkingstijd, kosten per transactie, foutenpercentage, herwerkinspanning, doorvoer, debiteurenafhandelingstijd, oplossingspercentage en klanttevredenheid. Productiviteitswinst vertaalt zich pas in een financieel resultaat wanneer het bedrijf middelen herverdeelt, knelpunten wegneemt, extra diensten verkoopt of daadwerkelijk kosten bespaart.
Een particulier model is nog geen AI voor bedrijven
De termen private AI, private taalmodel en enterprise AI worden vaak door elkaar gebruikt. Een private model beschrijft voornamelijk de technische en contractuele voorwaarden waaronder een model wordt gebruikt en wie er toegang toe heeft. Het kan lokaal draaien, in een speciale cloudomgeving of via een zeer beveiligde service. Deze eigenschap zegt echter weinig over de vraag of het systeem relevante bedrijfsgegevens begrijpt, de juiste machtigingen toepast of een proces betrouwbaar ondersteunt.
Een bedrijf kan een model volledig intern beheren en toch te maken krijgen met gefragmenteerde data, slechte zoekkwaliteit, onduidelijke verantwoordelijkheden en een gebrek aan prestatiemeting. Omgekeerd kan een zorgvuldig geconfigureerde cloudoplossing economischer en voldoende veilig zijn voor bepaalde datacategorieën. De juiste beslissing hangt af van gevoeligheid, latentie, volume, integratiebehoeften, wettelijke vereisten, interne operationele middelen en strategische onafhankelijkheid. On-premises beheer moet niet worden gekozen als statussymbool, maar als resultaat van een risico- en kostenanalyse.
Echte AI voor bedrijven omvat het model, de context- en integratielaag, governance, toegangscontrole, proceslogica, testen, monitoring en een operationeel model met duidelijk gedefinieerde verantwoordelijkheden. Het omvat ook een commerciële structuur die de kosten, ontwikkelingsrisico's en prestatierisico's transparant maakt. Een privémodel kan deel uitmaken van deze architectuur, maar vervangt deze niet. De cruciale vraag is niet waar het model op zichzelf draait, maar of het hele systeem een bedrijfsproces beheert, aantoonbaar verbetert en economisch aantrekkelijker maakt.
Dit onderscheid beschermt ook tegen onnodige technische complexiteit. Niet elke use case vereist een groot model, en niet elke taak is generatief. Klassieke zoekmethoden, regels, statistische modellen of procesautomatisering kunnen kosteneffectiever, stabieler en gemakkelijker te testen zijn. Een volwaardige bedrijfsarchitectuur betekent dat generatieve AI alleen wordt ingezet waar het vermogen om ongestructureerde informatie en variabele taal te verwerken aantoonbare toegevoegde waarde oplevert.
Snelle implementatie vereist strikte grenzen, geen grootse beloftes
Een goed gedefinieerde initiële use case op bestaande systemen zou binnen enkele weken, in plaats van vele kwartalen, tot resultaten moeten leiden die bijna klaar zijn voor productie. Dit betekent niet dat een volledige transformatie snel kan worden afgerond. Het verwijst naar een strak gestructureerd proces met duidelijk gedefinieerde gebruikers, databronnen, meetbare kwaliteitsdrempels en een gecontroleerd operationeel traject. Als zelfs deze initiële fase langer dan zes maanden duurt, kan dit duiden op ontbrekende standaardcomponenten, onduidelijke data, een te grote scope of een integratiearchitectuur die volledig vanaf nul is opgebouwd.
Snelheid moet echter niet worden verward met overhaast in productie gaan. Een overtuigend prototype toont alleen aan dat een model onder gunstige omstandigheden bruikbare resultaten kan opleveren. Bij de operationele implementatie moet rekening worden gehouden met zeldzame gebeurtenissen, verouderde documenten, tegenstrijdige gegevens, wijzigingen in toegangsrechten, storingen en kwaadwillige invoer. Met name prompt-injectieaanvallen kunnen proberen systeeminstructies te omzeilen via de inhoud van documenten of websites. Daarom zijn technische beperkingen, validatie van de inhoud, aparte machtigingen en testen met realistische incidentscenario's essentieel.
Een verstandig implementatieproces begint met een meetbaar probleem, niet met een voorkeursmodel. Vervolgens worden datastromen, gebruikersrollen, foutrisico's en economische voordelen gedefinieerd. Dit wordt gevolgd door een kleinschalig pilotproject met realistische workflows, een basis voor vergelijking en duidelijke beëindigingscriteria. Opschaling vindt pas plaats nadat de kwaliteit, acceptatie, beveiliging en impact op de processen zijn aangetoond. Deze gefaseerde aanpak vermindert de verzonken kosten en voorkomt dat een technisch aantrekkelijke proef jarenlang wordt gefinancierd zonder aantoonbare zakelijke waarde.
Verandermanagement is ook cruciaal. Medewerkers moeten begrijpen waarvoor het systeem geschikt is, waar de beperkingen liggen en hoe ze fouten kunnen melden. Expertise mag niet stilletjes worden gedevalueerd door zogenaamde automatisering. De beste resultaten worden vaak behaald wanneer ervaren medewerkers betrokken zijn bij evaluaties, uitzonderingen en feedbackloops. Op deze manier wordt individuele correctie een lerend organisatieproces, zelfs als het basismodel zelf niet permanent leert van elk gesprek.
Vier testcriteria onderscheiden platforms van herverpakte chatbots
De eerste cruciale vraag is of het systeem het bedrijf al voldoende kent, of dat gebruikers de context voor elke transactie opnieuw moeten reconstrueren. Een zinvolle demonstratie maakt daarom gebruik van de eigen gegevens, terminologie en daadwerkelijke toegangsrechten van het bedrijf, in plaats van een vooraf opgestelde sjabloondatabase. De evaluatie moet niet alleen de juiste antwoorden beoordelen, maar ook hoe het systeem omgaat met ontbrekende, tegenstrijdige en ongeldige informatie. Een betrouwbaar systeem moet beperkingen erkennen en onzekerheden zichtbaar maken.
De tweede vraag betreft het volledige datapad. Bedrijven moeten het verwerkingspad, de opslaglocaties, bewaarregels, onderaannemers, logboekregistratie en verwijderingsopties documenteren. Even belangrijk is de vraag of de architectuur gegevens in bestaande systemen kan bewaren en alleen de noodzakelijke fragmenten kan weergeven. Uitspraken over beveiliging zijn alleen betrouwbaar als ze gekoppeld kunnen worden aan een specifieke productvariant en configuratie.
De derde vraag is wie economisch en organisatorisch verantwoordelijk is voor het overeengekomen resultaat. Het moet duidelijk zijn wat er gebeurt als de nauwkeurigheid, doorvoer, verwerkingstijd of andere streefwaarden niet worden gehaald. Een simpele verwijzing naar toekomstige productplanning onthult een gebrek aan verantwoordelijkheid. Tegelijkertijd moet het bedrijf zijn eigen verantwoordelijkheden erkennen, met name met betrekking tot datakwaliteit, procesdefinitie, gebruikerstraining en beslissingen van experts. Verantwoordelijkheid voor resultaten kan niet volledig worden uitbesteed.
De vierde vraag betreft de kosten van het tweede gebruiksscenario. Leveranciers moeten aantonen welke verbindingen, machtigingen, definities, tests en operationele functies hergebruikt worden. Een transparante kostenberekening voor een volgend proces is informatiever dan een algemene presentatie van het platform. Het laat zien of er daadwerkelijk sprake is van schaalvoordelen of dat elke uitbreiding een nieuw integratieproject vereist. Deze vier vragen verleggen de focus bewust van de modelnaam naar context, datasoevereiniteit, verantwoordelijkheid en cumulatieve economische voordelen.
De juiste operationele architectuur is gebaseerd op risico's, niet op ideologieën
Voor de meeste bedrijven bestaat er niet één juiste implementatiemethode. Een portfoliobenadering is economisch gezien verstandiger. Openbare content en schrijftaken met een laag risico kunnen worden afgehandeld via gestandaardiseerde bedrijfssoftware. Interne kennisvragen vereisen gecontroleerde connectoren, autorisatiecontroles en bronverificatie. Kritieke bedrijfsprocessen vereisen striktere gegevensstromen, reproduceerbare tests, menselijke goedkeuringen en, waar nodig, dedicated of lokale verwerking. Zeer effectieve geautomatiseerde acties vereisen bovendien streng gecontroleerde tools, transactiecontroles en terugdraaiprocedures.
Deze gelaagde aanpak voorkomt twee kostbare uitersten. Het eerste is het overdragen van alle data aan een generieke assistent en het vertrouwen op contractuele bepalingen. Het tweede is het volledig intern ontwikkelen en beheren van elke AI-functie. Tussen deze twee uitersten liggen beheerde cloudservices, regionale verwerking, klant-eigen sleutels, privénetwerken, dedicated instances, on-premises modellen en hybride architecturen. De combinatie hiervan moet worden gekozen op basis van het specifieke risico.
De keuze voor een model kan ook gelaagd zijn. Kleinere modellen zijn vaak goedkoper, sneller en voldoende voor nauwkeurig gedefinieerde taken. Grotere modellen kunnen beter geschikt zijn voor complexe taal, planning of inconsistente documenten. Een intelligente router kan taken toewijzen aan verschillende modellen op basis van gevoeligheid, complexiteit en kosten. Een voorwaarde hiervoor is een gestandaardiseerd evaluatiesysteem om te garanderen dat prijsvoordelen niet teniet worden gedaan door hogere fout- en herwerkkosten.
Op de lange termijn zal de belangrijkste troef niet het best presterende individuele model zijn, maar eerder het vermogen van een bedrijf om modellen veilig en snel in productieprocessen te implementeren. Dit vermogen omvat datakwaliteit, een modulaire architectuur, expertise, governance en een cultuur van meetbare verbetering. Het is moeilijker te kopiëren dan een licentie en blijft waardevol, zelfs als de toonaangevende modelaanbieder verandert.
Van AI-project naar bedrijfsbesturingssysteem
Het strategische perspectief verschuift van de vraag welke assistent moet worden aangeschaft naar de vraag welke operationele capaciteiten moeten worden ontwikkeld. Bedrijven hebben een gecatalogiseerde inventaris van gegevensbronnen nodig, duidelijk omschreven verantwoordelijkheden, gestandaardiseerde toegangsmethoden, een modelportfolio, herbruikbare evaluatieprocedures en prioritering op basis van economische waarde. Zonder deze basis ontstaan er veel losse tools waarvan de voordelen moeilijk te vergelijken zijn en waarvan de risico's zich opstapelen.
Bij de selectie van use cases moet de focus liggen op terugkerende, data-intensieve en wrijvingsintensieve processen. Overdrachten tussen functies en systemen, waarbij medewerkers informatie moeten zoeken, vergelijken, overdragen of toelichten, zijn bijzonder aantrekkelijk. In deze situaties kan generatieve AI ongestructureerde content ontsluiten en traditionele automatisering aanvullen. Processen zonder een duidelijke databasis, zonder een meetbare beginsituatie of met extreem hoge foutpercentages en beperkte controlemogelijkheden zijn minder geschikt.
Voor elke prioritaire casus moet het management een economische hypothese formuleren. Deze hypothese beschrijft welke knelpunten worden weggenomen, welke prestatie-indicatoren veranderen, welke kosten volledig worden gedragen en hoe het effect in de bedrijfsvoering tot uiting komt. Een simpele aanname van tijdsbesparing is onvoldoende. Het moet duidelijk zijn of de vrijgekomen tijd leidt tot meer casussen, kortere wachttijden, hogere kwaliteit of daadwerkelijk tot besparing op personeels- en externe kosten. Alleen dit verband zorgt ervoor dat technische productiviteit zich vertaalt in een economisch rendement.
Tegelijkertijd is een architectuurbeslissing nodig die verder kijkt dan de initiële pilot, zonder direct een te groot platform te bouwen. Een slanke, gedeelde kern bestaande uit identiteitsbeheer, logging, modeltoegang, dataverbindingen en evaluatie kan stapsgewijs worden uitgebreid. Elke nieuwe applicatie moet voortbouwen op deze kern en zo min mogelijk aangepaste logica genereren. Deze aanpak creëert cumulatieve functionaliteit in plaats van een verzameling demonstraties.
De uiteindelijke aankoopbeslissing hangt af van het model
AI-modellen worden steeds krachtiger, goedkoper en dieper geïntegreerd in standaardsoftware. Hierdoor neemt het onderscheidende kenmerk van loutere toegang af. Wat bedrijven daadwerkelijk aanschaffen of zelf ontwikkelen, zijn de componenten rondom het model: de zakelijke context, gecontroleerde gegevensopslag, betrouwbare integratie, traceerbare beslissingen, organisatorische verantwoording en een kostencurve die gunstiger wordt naarmate er meer toepassingen bijkomen. Deze elementen bepalen of AI een productiviteitstool voor individuele medewerkers blijft of zich ontwikkelt tot een bedrijfsbrede capaciteit.
Een bedrijfslicentie is niet waardeloos en ook niet voldoende voor dit doel. Het vertegenwoordigt vaak een redelijk minimum voor algemene taken en kan schaduw-AI verminderen. Voor gereguleerde of bedrijfskritische processen moet het echter worden aangevuld met data-architectuur, governance, procesontwerp en meetbare verantwoording voor de resultaten. Evenzo is een privémodel op zich niet de oplossing. Technische isolatie zonder context en een operationeel concept creëert slechts een privé-eiland.
Het tweede gebruiksscenario biedt de sterkste waarschuwing. Als alle dataverbindingen, regels, tests en verantwoordelijkheden opnieuw moeten worden opgebouwd, was het aanvankelijke succes geen platformeffect, maar eerder een op zichzelf staand project. Omgekeerd, als essentiële componenten worden hergebruikt en de tijd tot het behalen van resultaten korter wordt, ontstaat er echte bedrijfseconomie. De waarde ligt dan niet in een spectaculaire demonstratie, maar in een lerende infrastructuur die continu meer processen verbetert tegen lagere marginale kosten.
Werknemers die al via privéaccounts hebben gestemd, vormen dus niet alleen een beveiligingsprobleem. Ze tonen de hoge eisen en de lage tolerantie voor gebrekkige tools aan. De taak van het management is om deze eisen te vertalen naar een gecontroleerd, superieur alternatief: een systeem dat de bedrijfsactiviteiten begrijpt, gevoelige gegevens adequaat beschermt, fouten verantwoord afhandelt en niet de volgende keer helemaal opnieuw begint. Alles minder dan dat blijft een chatbot met een inlog – nuttig, vaak indrukwekkend, maar nog geen AI voor de hele onderneming.
Advisering - Planning - Implementatie

Konrad Wolfenstein
Ik sta graag tot uw beschikking als uw persoonlijke adviseur.
U kunt contact met mij opnemen via wolfenstein∂xpert.digital of
U kunt me bellen op +49 7348 4088 965 .


