BERTによるAIとSEO – Transformerからの双方向エンコーダー表現 – 自然言語処理(NLP)分野のモデル – 画像:Xpert.Digital
🚀💬 Googleが開発したBERTと自然言語処理におけるその重要性 - 双方向テキスト理解が重要な理由
🔍🗣️ BERT(Bidirectional Encoder Representations from Transformersの略)は、Googleが開発した自然言語処理(NLP)分野における重要なモデルです。機械が言語を理解する方法に革命をもたらしました。テキストを左から右、またはその逆の順序で分析していた従来のモデルとは異なり、BERTは双方向処理を可能にします。つまり、単語の文脈を前後のテキストシーケンスの両方から把握できるということです。この機能により、複雑な言語関係の理解が大幅に向上します。.
🔍 BERTのアーキテクチャ
近年、自然言語処理(NLP)における最も重要な発展の一つは、 2017年のPDF論文「Attention is all you need」 (Wikipedia)で説明されているTransformerモデルの導入です。このモデルは、機械翻訳などの従来用いられてきた構造を捨て去ることで、この分野を根本的に変革しました。代わりに、アテンションメカニズムのみに依存しています。Transformerの設計は、音声生成、翻訳など、さまざまな分野における最先端技術を代表する多くのモデルの基礎となっています。
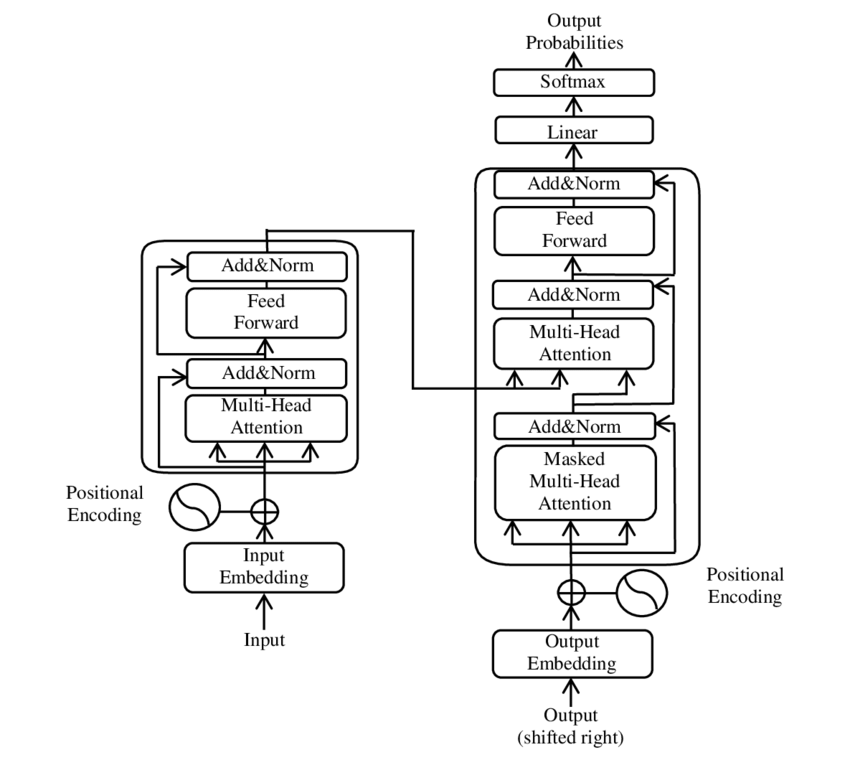
トランスフォーマーモデルの主要構成要素の図解 – 画像:Google
BERTはこのトランスフォーマーアーキテクチャに基づいています。このアーキテクチャは、いわゆる自己注意機構を用いて文中の単語間の関係を分析します。各単語は文全体の文脈の中で注目されるため、構文的および意味的な関係をより正確に理解することができます。.
論文「注意こそすべて」の著者は以下の通りです。
- アシシュ・ヴァスワニ(Google Brain)
- ノーム・シャジール(Google Brain)
- ニキ・パルマー(Googleリサーチ)
- ヤコブ・ウシュコライト(Googleリサーチ)
- ライオン・ジョーンズ(Googleリサーチ)
- エイダン・N・ゴメス(トロント大学、研究の一部はGoogle Brainで実施)
- ウカシュ・カイザー(Google Brain)
- イリア・ポロスヒン(独立系、以前はGoogle Researchに勤務)
これらの著者は、本論文で提示されたTransformerモデルの開発に多大な貢献をしてきた。.
🔄双方向処理
BERTの重要な特徴の一つは、テキストを双方向に処理できる点です。リカレントニューラルネットワーク(RNN)や長短期記憶(LSTM)ネットワークといった従来のモデルはテキストを一方向にしか処理しませんが、BERTは単語の文脈を双方向に分析します。これにより、モデルは意味の微妙なニュアンスをより的確に捉え、より精度の高い予測が可能になります。.
🕵️♂️ マスク音声モデリング
BERTのもう一つの革新的な点は、マスク言語モデル(MLM)技術です。この技術では、文中のランダムに選択された単語がマスクされ、周囲の文脈に基づいてこれらの単語を予測するようにモデルが訓練されます。この方法により、BERTは文中の各単語の文脈と意味を深く理解するようになります。.
🚀 BERTのトレーニングと適応
BERTは、事前学習と微調整という2段階の学習プロセスを経る。.
📚 事前トレーニング
事前学習段階では、BERTは大量のテキストデータを用いて、一般的な言語パターンを学習します。これには、Wikipediaの記事やその他の大規模なテキストコーパスが含まれます。この段階で、モデルは基本的な言語構造と文脈を学習します。.
🔧 微調整
事前学習後、BERTはテキスト分類や感情分析といった特定の自然言語処理タスクに合わせて調整されます。モデルは、特定のアプリケーションにおけるパフォーマンスを最適化するために、タスクに関連した小規模なデータセットを用いて学習されます。.
🌍 BERTの応用分野
BERTは、自然言語処理の多くの分野で非常に有用であることが証明されています。
検索エンジン最適化
GoogleはBERTを用いて検索クエリをより正確に理解し、より関連性の高い検索結果を表示します。これにより、ユーザーエクスペリエンスが大幅に向上します。.
テキスト分類
BERTは文書をトピック別に分類したり、テキストの雰囲気分析を行ったりすることができる。.
固有表現抽出(NER)
このモデルは、テキスト中の人名、地名、組織名などの固有表現を識別し、分類します。.
質問応答システム
BERTは、提示された質問に対して正確な回答を提供するために使用されます。.
🧠 人工知能の未来におけるBERTの重要性
BERTは自然言語処理モデルの新たな基準を確立し、さらなるイノベーションへの道を開きました。双方向処理能力と言語コンテキストの深い理解力により、AIアプリケーションの効率性と精度を大幅に向上させています。.
🔜 今後の展開
BERTや類似モデルのさらなる開発は、より強力なシステムの構築を目指すものと期待されている。これらのシステムは、より複雑な言語処理タスクに対応でき、幅広い新たな応用分野で活用される可能性がある。こうしたモデルを日常的なテクノロジーに統合することで、私たちがコンピュータとやり取りする方法は根本的に変わるかもしれない。.
🌟 人工知能開発における画期的な出来事
BERTは人工知能開発における画期的な成果であり、機械による自然言語処理の方法に革命をもたらしました。その双方向アーキテクチャにより、言語間の関係性をより深く理解することが可能になり、幅広いアプリケーションにとって不可欠な存在となっています。研究が進むにつれ、BERTのようなモデルはAIシステムの改善と新たな活用可能性の開拓において、今後も中心的な役割を果たし続けるでしょう。.
📣 類似トピック
- 📚 BERT入門:画期的な自然言語処理モデル
- 🔍 BERTと自然言語処理における双方向性の役割
- 🧠 トランスフォーマーモデル:BERTの基礎
- 🚀 マスク言語モデリング:BERTの成功の鍵
- 📈 BERTのカスタマイズ:事前学習から微調整まで
- 🌐 現代技術におけるBERTの応用分野
- 🤖 BERTが人工知能の未来に与える影響
- 💡 今後の展望:BERTのさらなる発展
- 🏆 BERTはAI開発における画期的な出来事
- 📰 Transformer論文「Attention Is All You Need」の著者たち:BERTの生みの親たち
#️⃣ ハッシュタグ: #NLP #人工知能 #言語モデリング #Transformer #機械学習
🎯🎯🎯 Xpert.Digitalの5つの専門知識を1つの包括的なサービスパッケージで活用しましょう | BD、R&D、XR、PR、デジタル可視性の最適化

Xpert.Digitalの5つの専門知識を包括的サービスパッケージで活用 | R&D、XR、PR、デジタル可視性の最適化 - 画像: Xpert.Digital
Xpert.Digitalは、様々な業界にわたる深い知識を有しています。これにより、お客様の特定の市場セグメントのニーズと課題に的確に合致した、カスタマイズされた戦略を策定することができます。市場トレンドを継続的に分析し、業界の動向をモニタリングすることで、先を見越した行動を取り、革新的なソリューションを提供することができます。経験と専門知識を組み合わせることで付加価値が生まれ、お客様に決定的な競争優位性を提供します。.
詳細はこちら:
BERT:革新的な🌟自然言語処理技術
🚀 BERT(Bidirectional Encoder Representations from Transformersの略)は、Googleが開発した高度な言語モデルで、2018年の発表以来、自然言語処理(NLP)における大きなブレークスルーとなっています。BERTは、機械がテキストを理解し処理する方法に革命をもたらしたTransformerアーキテクチャに基づいています。しかし、BERTの何がそんなに特別なのでしょうか?また、何に使われているのでしょうか?この疑問に答えるには、BERTの技術的な基盤、動作原理、そして応用例を詳しく見ていく必要があります。.
📚 1. 自然言語処理の基礎
BERTの重要性を十分に理解するためには、自然言語処理(NLP)の基礎を簡単に復習しておくと役立ちます。NLPは、コンピュータと人間の言語との相互作用を扱う分野です。その目的は、機械がテキストデータを分析、理解し、応答できるようにすることです。BERTのようなモデルが登場する以前は、機械言語処理は、特に人間の言語の曖昧さ、文脈依存性、複雑な構造のために、しばしば大きな課題を抱えていました。.
📈 2. 自然言語処理モデルの開発
BERTが登場する以前は、ほとんどの自然言語処理モデルは、いわゆる単方向アーキテクチャに基づいていました。つまり、これらのモデルはテキストを左から右、または右から左のいずれかの方向にしか読み取れず、文中の単語を処理する際に考慮できる文脈が限られていました。この制約により、モデルは文の意味的な文脈を十分に捉えることができず、曖昧な単語や文脈依存的な単語を正確に解釈することが困難でした。.
BERT以前の自然言語処理研究におけるもう一つの重要な進展は、単語を意味的な類似性を反映するベクトルに変換することを可能にするword2vecモデルでした。しかし、ここでも文脈は単語のすぐ周辺に限られていました。その後、リカレントニューラルネットワーク(RNN)、特に長短期記憶(LSTM)モデルが開発され、複数の単語にわたって情報を保存することでテキストシーケンスをよりよく理解することが可能になりました。しかし、これらのモデルにも限界があり、特に長いテキストを扱い、同時に双方向の文脈を理解する場合には問題がありました。.
🔄 3. トランスフォーマーアーキテクチャによる革命
画期的な進歩は、BERTの基盤となるTransformerアーキテクチャが2017年に導入されたことで実現しました。Transformerモデルは、単語の前後のテキストからの文脈を考慮しながら、並列テキスト処理を可能にするように設計されています。これは、いわゆる自己注意機構によって実現され、文中の各単語に、文中の他の単語との相対的な重要度に基づいて重み値を割り当てます。.
従来の手法とは異なり、トランスフォーマーモデルは一方向ではなく双方向です。つまり、単語の左右両方の文脈から情報を取得し、単語とその意味をより完全かつ正確に表現することができます。.
🧠 4. BERT:双方向モデル
BERTは、Transformerアーキテクチャの性能を新たなレベルへと引き上げます。このモデルは、単語の文脈を左から右、右から左だけでなく、両方向で同時に捉えるように設計されています。これにより、BERTは文中の単語の完全な文脈を考慮することができ、自然言語処理タスクにおける精度が大幅に向上します。.
BERTの重要な特徴の一つは、いわゆるマスク言語モデル(MLM)を使用している点です。BERTの学習過程では、文中のランダムに選択された単語がマスクに置き換えられ、モデルは文脈に基づいてこれらのマスクされた単語を推測するように学習されます。この手法により、BERTは文中の単語間のより深く、より正確な関係性を学習することができます。.
さらに、BERTは次文予測(NSP)と呼ばれる手法を用いており、モデルが文の後に別の文が続くかどうかを予測するように学習します。これにより、BERTはより長いテキストを理解し、文間のより複雑な関係を認識する能力が向上します。.
🌐 5. BERTの実践的な応用
BERTは、さまざまな自然言語処理タスクにおいて非常に有用であることが証明されています。以下に、最も重要な応用分野をいくつか挙げます。
📊 a) テキスト分類
BERTの最も一般的な用途の一つはテキスト分類であり、テキストをあらかじめ定義されたカテゴリに分類します。例としては、感情分析(テキストが肯定的か否定的かを認識するなど)や顧客フィードバックの分類などが挙げられます。BERTは単語の文脈を深く理解できるため、従来のモデルよりも精度の高い結果を提供できます。.
❓ b) 質問応答システム
BERTは質問応答システムにも利用されており、テキストから質問に対する回答を抽出します。この機能は、検索エンジン、チャットボット、仮想アシスタントなどのアプリケーションにおいて特に重要です。双方向アーキテクチャのおかげで、BERTは質問が間接的に表現されていても、テキストから関連情報を抽出できます。.
🌍 c) テキスト翻訳
BERT自体は直接翻訳モデルとして設計されたものではありませんが、他の技術と組み合わせて機械翻訳の精度向上に役立てることができます。BERTは文中の意味的な関係性をより深く理解することで、特に曖昧な表現や複雑な言い回しを含む文章において、より正確な翻訳を生成するのに役立ちます。.
🏷️ d) 固有表現認識 (NER)
もう一つの応用分野は、固有表現認識(NER)です。これは、テキストの中から名前、場所、組織などの特定のエンティティを識別するものです。BERTは、文の文脈を十分に考慮するため、文脈によって意味が異なるエンティティであっても、より正確に認識できることから、このタスクにおいて特に効果的であることが証明されています。.
✂️ e) テキストの要約
BERTはテキスト全体の文脈を理解できるため、自動テキスト要約のための強力なツールとなります。長いテキストから最も重要な情報を抽出し、簡潔な要約を作成するために使用できます。.
🌟 6. BERTが研究と産業にとって重要である理由
BERTの登場は、自然言語処理(NLP)研究に新たな時代をもたらしました。BERTは双方向トランスフォーマーアーキテクチャの力を最大限に活用した最初のモデルの一つであり、その後の多くのモデルの標準となりました。数多くの企業や研究機関が、アプリケーションのパフォーマンス向上を目的として、BERTをNLPパイプラインに統合しています。.
さらに、BERTは言語モデル分野におけるさらなる革新への道を開きました。例えば、GPT(Generative Pretrained Transformer)やT5(Text-to-Text Transfer Transformer)といったモデルがその後開発されました。これらは同様の原理に基づきながらも、異なるユースケースに合わせて具体的な改良が加えられています。.
🚧 7. BERTの課題と限界
BERTには多くの利点がある一方で、いくつかの課題や限界も存在します。最大の障害の一つは、モデルの学習と適用に必要な計算負荷の高さです。BERTは数百万ものパラメータを持つ非常に大規模なモデルであるため、特に大規模なデータセットを処理する際には、高性能なハードウェアと相当な計算リソースが必要となります。.
もう一つの問題は、学習データに存在する可能性のあるバイアスです。BERTは大量のテキストデータで学習されるため、そのデータに含まれる偏見や固定観念を反映してしまうことがあります。しかし、研究者たちはこれらの問題の特定と解決に向けて継続的に取り組んでいます。.
🔍 現代の音声処理アプリケーションに欠かせないツール
BERTは、機械が人間の言語を理解する方法を大きく向上させました。双方向アーキテクチャと革新的な学習方法により、文中の単語の文脈を深く正確に把握することができ、多くの自然言語処理タスクにおいて精度向上を実現しています。テキスト分類、質問応答システム、固有表現認識など、BERTは現代の自然言語処理アプリケーションに欠かせないツールとしての地位を確立しています。.
自然言語処理分野の研究は今後も間違いなく進歩を続け、BERTは将来の多くのイノベーションの基盤を築きました。既存の課題や限界はあるものの、BERTは短期間でこの技術がどれほど進歩したか、そして将来どのような刺激的な機会が開かれるかを鮮やかに示しています。.
🌀 トランスフォーマー:自然言語処理における革命
🌟 近年、自然言語処理(NLP)における最も重要な発展の一つは、2017年の論文「Attention Is All You Need」で紹介されたTransformerモデルの導入です。このモデルは、機械翻訳などのシーケンス変換タスクで従来用いられていたリカレント構造や畳み込み構造を廃止することで、この分野を根本的に変革しました。代わりに、アテンション機構のみに依存しています。Transformerの設計は、音声生成、翻訳など、さまざまな分野で最先端のモデルの基礎となっています。.
🔄 トランスフォーマー:パラダイムシフト
Transformerが導入される以前は、シーケンス処理のためのモデルのほとんどは、本質的に逐次的に動作するリカレントニューラルネットワーク(RNN)または長短期記憶(LSTM)ネットワークに基づいていました。これらのモデルは入力データを段階的に処理し、シーケンスに沿って伝播される隠れ状態を生成します。この方法は効果的ですが、計算コストが高く、特に長いシーケンスでは並列化が困難です。さらに、RNNは勾配消失問題のために長期的な依存関係を学習するのに苦労します。.
Transformerの重要な革新点は、自己注意機構を採用していることにあります。この機構により、モデルは文中の単語の位置に関係なく、それぞれの単語の重要度を相対的に評価できます。これにより、モデルはRNNやLSTMよりも効果的に、離れた単語間の関係性を捉えることができ、しかもそれを逐次処理ではなく並列処理で行うことができます。これは、学習効率の向上だけでなく、機械翻訳などのタスクにおけるパフォーマンス向上にもつながります。.
🧩 モデルアーキテクチャ
トランスフォーマーは、エンコーダとデコーダという2つの主要コンポーネントで構成されており、どちらも複数の層から成り、マルチヘッドアテンション機構に大きく依存している。.
⚙️ エンコーダー
エンコーダは、それぞれ2つのサブレイヤーを持つ6つの同一のレイヤーで構成されています。
1. マルチヘッド自己注意機構
このメカニズムにより、モデルは各単語を処理する際に、入力文の異なる部分に焦点を当てることができます。単一の空間で注意を計算するのではなく、マルチヘッドアテンションは入力を複数の異なる空間に投影することで、単語間の様々な種類の関係性を捉えます。.
2. 位置的に完全に接続されたフィードフォワードネットワーク
アテンション層に続いて、各位置に独立して全結合フィードフォワードネットワークが適用されます。これにより、モデルは各単語を文脈の中で処理し、アテンション機構からの情報を活用できるようになります。.
入力シーケンスの構造を維持するため、モデルには位置エンコーディングも含まれています。トランスフォーマーは単語を順番に処理しないため、これらのエンコーディングは、文中の単語の順序に関する情報をモデルに提供するために不可欠です。位置エンコーディングは単語埋め込みに追加され、モデルがシーケンス内の異なる位置を区別できるようにします。.
🔍デコーダー
エンコーダーと同様に、デコーダーも6つの層で構成されており、各層には追加のアテンション機構が備わっています。これにより、モデルは出力生成時に入力シーケンスの関連部分に焦点を当てることができます。また、デコーダーはマスキング技術を用いて将来の位置を考慮しないようにすることで、シーケンス生成の自己回帰性を維持しています。.
🧠 マルチヘッドアテンションとスカラー積アテンション
Transformerの中核となるのは、より単純なスカラー積アテンションを拡張したマルチヘッドアテンション機構です。アテンション関数は、クエリとキーと値のペアのセットとの間のマッピングとして捉えることができ、各キーはシーケンス内の単語を表し、値はそれに対応する文脈情報を表します。.
マルチヘッドアテンション機構により、モデルはシーケンスの異なる部分に同時に焦点を当てることができます。入力を複数の部分空間に投影することで、モデルは単語間のより豊かな関係性を捉えることができます。これは、単語の文脈を理解するために構文構造や意味など、多くの異なる要素が必要となる機械翻訳のようなタスクにおいて特に有効です。.
スカラー積アテンションの公式は次のとおりです。
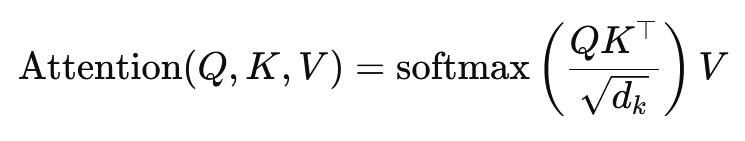
ここで、(Q)はクエリ行列、(K)はキー行列、(V)は値行列です。(sqrt{d_k})は、スカラー積が大きくなりすぎて勾配が小さくなり学習速度が低下するのを防ぐためのスケーリング係数です。ソフトマックス関数は、アテンション重みの合計が1になるように適用されます。.
🚀 変圧器の利点
Transformerは、RNNやLSTMといった従来のモデルに比べて、いくつかの重要な利点を提供します。
1. 並列化
トランスフォーマーはシーケンス内のすべてのトークンを同時に処理するため、高度に並列化することができ、特に大規模なデータセットの場合、RNNやLSTMよりもはるかに高速に学習できます。.
2. 長期的な依存関係
自己注意機構により、このモデルは、計算が逐次的に行われるという制約を持つRNNよりも、離れた単語間の関係性をより効果的に捉えることができる。.
3. スケーラビリティ
このトランスフォーマーは、RNNに伴うパフォーマンスのボトルネックに悩まされることなく、非常に大規模なデータセットやより長いシーケンスにも容易に拡張できます。.
🌍 用途と効果
Transformerは登場以来、幅広い自然言語処理(NLP)モデルの基盤となってきました。最も注目すべき例の一つがBERT(Bidirectional Encoder Representations from Transformers)です。BERTは改良されたTransformerアーキテクチャを用いて、質問応答やテキスト分類など、多くのNLPタスクにおいて最先端の性能を実現しています。.
もう一つの重要な発展は、テキスト生成にデコーダー機能のみを限定したトランスフォーマーを用いるGPT(Generative Pretrained Transformer)です。GPT-3を含むGPTモデルは、コンテンツ作成からコード補完まで、現在では数多くのアプリケーションで利用されています。.
🔍パワフルで柔軟なモデル
Transformerは、自然言語処理(NLP)タスクへのアプローチ方法を根本的に変えました。強力かつ柔軟なモデルを提供し、幅広い問題に適用可能です。長期依存関係を処理できる能力と効率的な学習能力により、多くの最新モデルで好ましいアーキテクチャとして採用されています。研究が進むにつれて、特に画像処理や音声処理など、アテンションメカニズムが有望な結果を示している分野において、Transformerのさらなる改良や応用が見られるでしょう。.
コンサルティング、計画、実装、プロジェクト管理など、あらゆる面でサポートいたします。
☑️ 業界の専門家。2,500 以上の専門記事を掲載した独自の Xpert.Digital 業界ハブを運営しています。

Konrad Wolfenstein
喜んであなたの個人アドバイザーを務めさせていただきます。.
下記の連絡フォームにご記入いただくか、 +49 7348 4088 965 。
私たちの共同プロジェクトを楽しみにしています。.
私に手紙を書いてください


Xpert.Digital - Konrad Wolfenstein
Xpert.Digital は、デジタル化、機械工学、物流/イントラロジスティクス、太陽光発電に重点を置いた業界のハブです。.
当社の 360° ビジネス開発ソリューションでは、新規事業からアフターセールスまで有名企業をサポートします。.
市場情報、マーケティング、マーケティング自動化、コンテンツ開発、PR、メールキャンペーン、パーソナライズされたソーシャルメディア、リード育成は、当社のデジタルツールの一部です。.
詳細については、 www.xpert.digital 、 www.xpert.solar 、 www.xpert.plus
連絡を取り合う