Più di un semplice chatbot: come un livello semantico rende l'IA più affidabile nelle aziende – Il fattore di successo sottovalutato per l'IA aziendale
Pre-release di Xpert

Available in 27 languages 📢
Preferisco Xpert.Digital su GoogleⓘPubblicato il: 1 novembre 2026 / Aggiornato il: 1 novembre 2026 – Autore: Konrad Wolfenstein
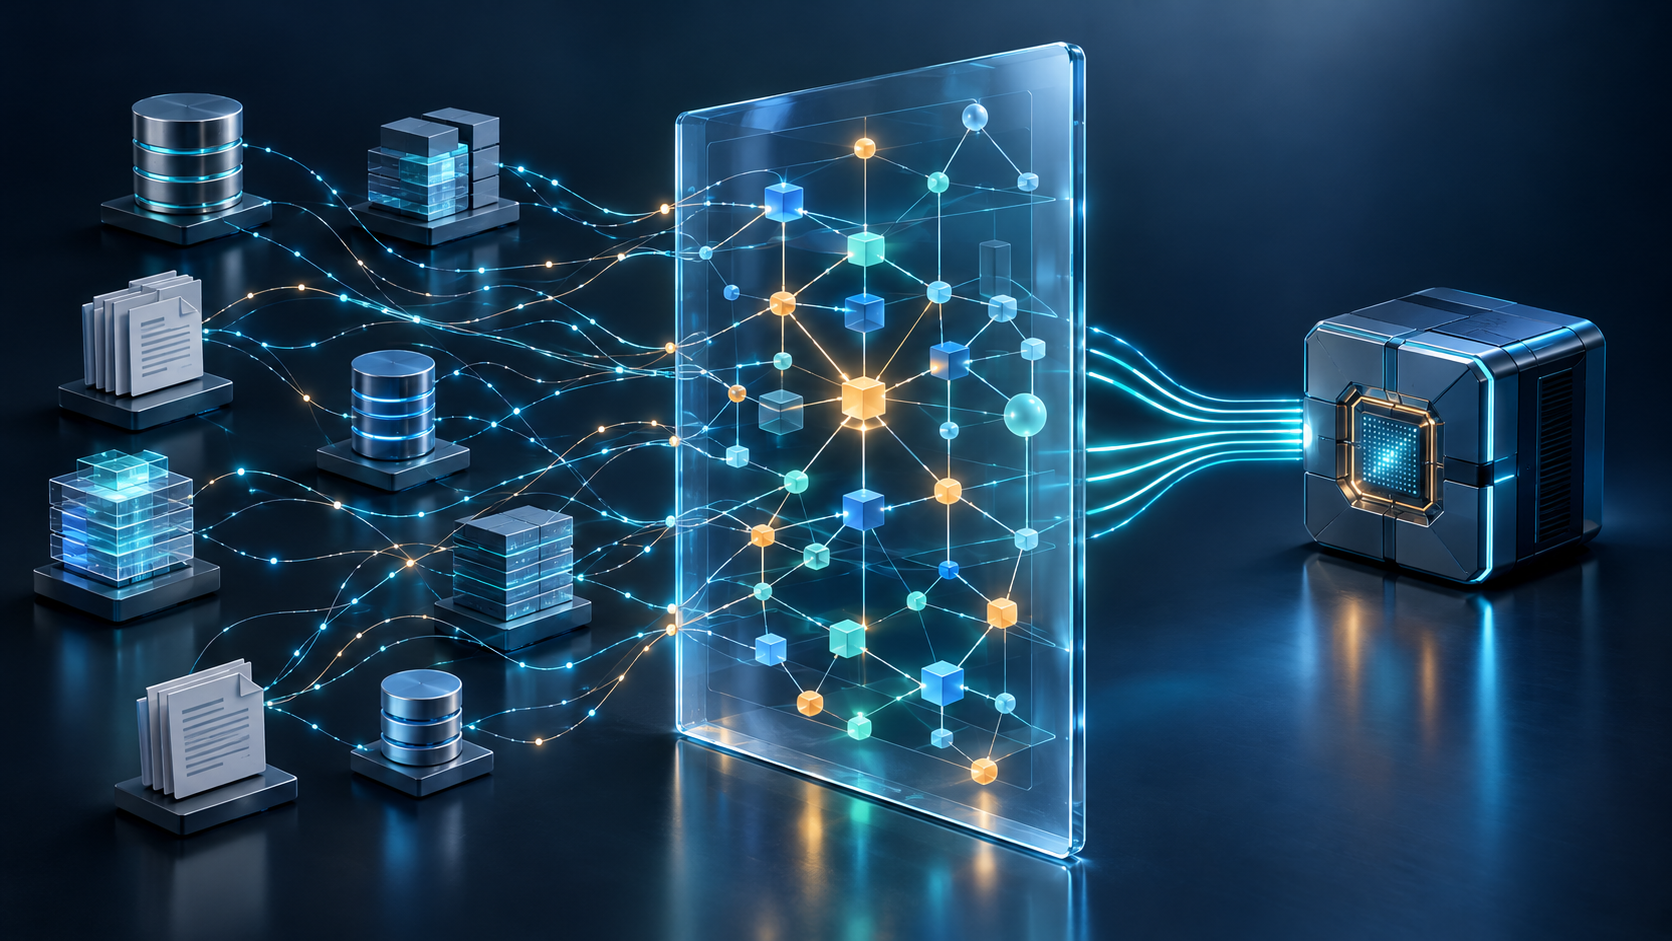
Più di un chatbot: come un livello semantico rende l'IA più affidabile nelle aziende – Il fattore di successo sottovalutato per l'IA aziendale – Immagine creativa sul tema, con l'IA: Xpert.Digital
L'intelligenza artificiale nel mondo degli affari: perché una terminologia chiara determina il successo economico
Quando l'IA accelera il caos: perché le aziende hanno bisogno di conoscenze aziendali condivise
Meno contraddizioni, decisioni migliori: cosa può fare un livello semantico per le aziende
Le aziende stanno investendo nell'intelligenza artificiale per accelerare i processi e prendere decisioni migliori. Tuttavia, un modello linguistico potente da solo non garantisce il successo aziendale. Se vendite, finanza e assistenza clienti interpretano i termini chiave in modo diverso, l'IA può fornire risposte contraddittorie e diffondere gli errori più rapidamente. Un livello semantico mira a risolvere questo problema: rende termini, relazioni e regole utilizzabili e comprensibili in diverse applicazioni. Il suo valore risiede non solo in risposte migliori, ma anche nella riduzione degli sforzi di coordinamento e nella riutilizzabilità delle conoscenze aziendali. Tuttavia, un livello semantico può rivelare ambiguità organizzative, ma non le risolverà da solo. Pertanto, ciò che conta è come le aziende mappano la propria realtà aziendale, definiscono le responsabilità professionali e misurano i benefici effettivi.
Correlato a questo:
Livello semantico per l'IA aziendale: perché la rilevanza per il business determina il ritorno sull'investimento nell'IA
Senza concetti chiari, l'IA automatizza il caos
Un livello semantico rende condivisibili e verificabili, per le applicazioni di intelligenza artificiale, termini, relazioni e regole aziendali. Il suo valore economico risiede quindi non solo in risposte più accurate, ma anche nella prospettiva di una riduzione degli sforzi di coordinamento, di una conoscenza aziendale riutilizzabile e di decisioni più controllabili. Tuttavia, il limite cruciale è che un tale livello semantico può rivelare ambiguità organizzative, ma non è in grado di risolverle autonomamente.
Per le aziende, questo sposta l'attenzione sulla questione strategica. Non si tratta più solo di quale modello linguistico sia più efficiente o di quanto velocemente si possa sviluppare un altro assistente. Ciò che diventa più importante è la realtà aziendale su cui questi sistemi si basano. Se vendite, finanza e assistenza clienti utilizzano lo stesso termine in modo diverso, un'IA tecnicamente potente può diffondere risultati contraddittori ancora più rapidamente e ampiamente. La sfida economica consiste nel trasformare le informazioni frammentate in una base solida e permanentemente utilizzabile per il processo decisionale.
Il divario tra utilizzo e risultato
L'adozione dell'IA è in crescita, ma il suo utilizzo non ha ancora dimostrato di avere un impatto economico. Nel 2025, il 19,95% delle aziende europee intervistate con dieci o più dipendenti utilizzava almeno una tecnologia di IA; ciò rappresentava un aumento di 6,47 punti percentuali rispetto al 2024. Esistevano differenze significative in base alle dimensioni delle aziende: la quota era del 17% per le piccole imprese, del 30,36% per le medie imprese e del 55,03% per le grandi imprese. L'indagine ha preso in considerazione un ampio spettro di tecnologie di IA, dall'analisi del testo alle macchine autonome, ma non si è concentrata specificamente sull'uso dell'IA generativa o dei livelli semantici.
Un quadro diverso emerge da un'indagine internazionale sulle imprese condotta nel 2026. In tale indagine, l'80% degli intervistati ha dichiarato un miglioramento della produttività personale grazie all'intelligenza artificiale, mentre il 37% ha indicato un contributo positivo agli utili prima degli interessi e delle imposte (EBIT) della propria azienda. Solo circa il 6% apparteneva a un gruppo particolarmente di successo, attribuendo almeno il 5% del proprio EBIT all'intelligenza artificiale e riportando al contempo benefici significativi. L'indagine ha coinvolto 1.719 partecipanti provenienti da 97 paesi ed è stata basata su dati auto-dichiarati; pertanto, non è direttamente confrontabile con le statistiche aziendali europee.
I dati non dimostrano un effetto causale di uno strato semantico. Piuttosto, illustrano il problema aziendale: tra la semplificazione del lavoro individuale e il successo aziendale misurabile si cela uno sforzo di traduzione a livello organizzativo. È proprio in questa interfaccia che uno strato di significato condiviso diventa rilevante.
L'importanza diventa parte dell'infrastruttura operativa
Un livello semantico collega le strutture dati tecniche con concetti aziendali come cliente, contratto, reclamo o ricavo. Descrive, ad esempio, quali campi dati appartengono a un cliente, come viene calcolato un indicatore chiave di prestazione (KPI) e in quali condizioni si applica uno stato specifico. Ciò consente a diverse applicazioni di basarsi su definizioni comuni anziché derivare le proprie interpretazioni da etichette di tabelle o documenti.
Un semplice esempio illustra le implicazioni. Un'azienda potrebbe definire un cliente attivo nelle vendite in base alle conversazioni in corso, in ambito finanziario in base alle transazioni commerciali registrate e nell'assistenza clienti in base alle richieste di assistenza esistenti. Nessuna di queste prospettive è necessariamente errata. Il problema sorge quando un'IA le mescola inavvertitamente o presenta una prospettiva come universalmente valida.
La soluzione economicamente valida, pertanto, non consiste sempre in un'unica definizione valida per tutti gli scopi. Spesso, sono necessarie diverse definizioni chiare, professionalmente affidabili e con limiti di applicazione inequivocabili. Un livello comune di significato dovrebbe riflettere le differenze in modo controllato, senza creare artificialmente un'uniformità che l'azienda in realtà non possiede. Il suo obiettivo è un'interpretazione comprensibile, non un'omogeneizzazione concettuale.
Dal rapporto alla decisione operativa
I modelli semantici classici per la business intelligence si concentrano principalmente su indicatori chiave, dimensioni, aggregazioni e relazioni tra oggetti dati. Tuttavia, sarebbe una semplificazione eccessiva negare loro del tutto la logica di business o le funzioni di autorizzazione: i sistemi di BI consolidati, ad esempio, supportano relazioni, indicatori chiave calcolati e accesso ai dati basato sui ruoli. Pertanto, il confine tra un livello semantico di BI e un livello semantico di IA non è una netta divisione tecnologica.
La differenza principale risiede nei requisiti. Un report, ad esempio, deve rappresentare accuratamente i ricavi. Un'applicazione operativa di intelligenza artificiale, d'altro canto, deve anche essere in grado di determinare quale contratto appartiene a un processo, quale accordo specifico ha la precedenza e se il passo successivo richiede un'approvazione. Questo amplia il compito, passando da una semplice analisi a un supporto decisionale contestualizzato.
Dal punto di vista economico, ciò aumenta sia i potenziali benefici che i potenziali rischi. Un report mal definito può spianare la strada a una decisione errata. Un assistente operativo può implementarla immediatamente. Quanto più l'IA si avvicina agli ordini, ai pagamenti, agli impegni sui prezzi o alle decisioni dei clienti, tanto più cruciale diventa la distinzione tra interpretazione plausibile e logica di esecuzione vincolante.
I quattro elementi costitutivi della conoscenza aziendale
Un livello di significato completo per l'IA aziendale dovrebbe considerare quattro tipi di conoscenza: definizioni di entità, relazioni, regole decisionali e correzioni raccolte. Le definizioni di entità specificano cosa costituisce un oggetto aziendale, come un cliente attivo, un contratto critico o un caso ad alto rischio. Le relazioni collegano tali oggetti, come ad esempio una filiale a un account o una modifica contrattuale al contratto principale corrispondente.
Le regole decisionali descrivono soglie, eccezioni, responsabilità e condizioni di approvazione. Le correzioni raccolte registrano i casi in cui gli esperti in materia hanno corretto risultati errati. Solo combinando questi elementi è possibile sviluppare qualcosa di più di una semplice funzione di ricerca: una base trasparente per interpretare le informazioni e definire il quadro di riferimento in cui inserirle.
Da un punto di vista economico, questi tipi di conoscenza devono essere valutati in modo diverso. La definizione di un cliente può essere riutilizzata in molte applicazioni. Una decisione di eccezione, d'altro canto, può essere applicata solo a uno specifico contratto. Una buona architettura deve quindi non solo memorizzare la conoscenza, ma anche limitarne l'ambito di applicazione. Altrimenti, trasforma un'eccezione locale in una regola generale e aggrava proprio l'errore che intende prevenire.
Perché i documenti sono fondamentali per la gestione aziendale
Un livello semantico basato sull'intelligenza artificiale deve essere in grado di collegare non solo dati strutturati, ma anche contratti, e-mail, report e verbali di riunione con le corrispondenti transazioni commerciali. Il motivo è immediatamente evidente: una voce del database potrebbe contenere il prezzo standard concordato, mentre un accordo supplementare approvato potrebbe prevedere condizioni diverse. Chiunque analizzi solo l'insieme dei dati potrebbe trascurare l'eccezione economicamente vincolante.
La difficoltà non sta semplicemente nel trovare una clausola, ma nel determinarne lo status. Una bozza non è un accordo firmato. Un verbale di una riunione interna non sostituisce l'approvazione. Un documento successivo può integrare, sostituire parzialmente o avere un ambito di applicazione diverso rispetto a una norma precedente. Queste distinzioni devono essere esplicitamente modellate e analizzate per ogni singolo caso d'uso.
Ciò ci porta a un'importante prospettiva economica: il valore dell'analisi documentale non si misura con il numero di pagine elaborate. Esso si manifesta solo quando da essa si possono ricavare informazioni attendibili su pretese, obblighi, scadenze o linee d'azione. Un riassunto frettoloso senza verifica del contenuto, al contrario, può comportare costi di audit aggiuntivi e creare un falso senso di sicurezza.
Quattro fonti di costo dovute all'ambiguità semantica
L'impatto economico può essere compreso attraverso quattro categorie di costi. In primo luogo, i costi di ricerca si verificano quando i dipendenti devono raccogliere informazioni e comprenderne il significato. In secondo luogo, i costi di coordinamento si verificano quando i dipartimenti spiegano e conciliano analisi diverse. In terzo luogo, i costi di errore si verificano quando classificazioni o regole errate portano a rilavorazioni e decisioni errate. In quarto luogo, i costi di ripetizione si verificano quando ogni nuovo progetto di intelligenza artificiale richiede lo sviluppo ex novo delle stesse basi tecniche.
Questa classificazione rappresenta un quadro di valutazione analitica, non una distribuzione dei costi misurata empiricamente. Tuttavia, contribuisce a evitare un equivoco comune: il ritorno sull'investimento di un livello semantico non dovrebbe dipendere esclusivamente dalla velocità di risposta di un assistente. Una risposta può apparire in pochi secondi e risultare comunque costosa se successivamente diversi specialisti devono verificarne l'accuratezza.
Al contrario, un miglioramento apparentemente insignificante può creare un valore considerevole. Se una definizione vincolante riduce i tempi di coordinamento tra il reparto finanziario e quello commerciale, il beneficio può ripercuotersi simultaneamente su numerosi report e decisioni. Pertanto, l'unità economica rilevante non è sempre il singolo dialogo con l'IA, ma l'intero processo aziendale, compresi i relativi cicli di controllo e correzione.
Il riutilizzo crea economie di scala
Definizioni comuni degli indicatori chiave di prestazione (KPI) possono evitare sforzi di implementazione duplicati e rendere la stessa logica di business accessibile a diverse applicazioni. Applicato a un'architettura di intelligenza artificiale più ampia, questo rappresenta il principale vantaggio in termini di scalabilità: termini, relazioni e regole già rilasciati dovrebbero rimanere utilizzabili per altri casi d'uso. Ciò trasforma il livello semantico in un potenziale investimento infrastrutturale, anziché in un componente di progetto isolato.
La logica economica è simile a quella di una risorsa condivisa. La sua creazione iniziale comporta dei costi, mentre altri utenti possono utilizzare i componenti esistenti. Tuttavia, il vantaggio aumenta solo se i nuovi casi d'uso presentano effettivamente una sovrapposizione sufficiente di competenze. Un altro assistente nello stesso settore di servizio può attingere a una maggiore quantità di conoscenze preesistenti rispetto a un'applicazione per un settore aziendale completamente diverso.
Pertanto, sarebbe irrealistico aspettarsi una diminuzione automatica dei costi con ogni successivo progetto di intelligenza artificiale. Nuovi quadri normativi, famiglie di prodotti o modelli di business potrebbero richiedere integrazioni sostanziali. Le economie di scala affidabili non risiedono nel fatto che i progetti successivi diventino gratuiti, bensì nel fatto che le questioni già chiarite non necessitano di essere chiarite nuovamente senza una giustificazione oggettiva.
La produttività necessita di una valutazione obiettiva
Uno studio condotto su 5.172 addetti al servizio clienti ha rilevato che l'accesso a un assistente basato sull'intelligenza artificiale generativa ha comportato un aumento medio di circa il 15% delle richieste dei clienti risolte all'ora. Tuttavia, l'effetto è stato distribuito in modo disomogeneo: i dipendenti meno esperti e con minori competenze ne hanno tratto maggior beneficio, mentre i dipendenti più esperti e performanti hanno registrato solo lievi miglioramenti in termini di velocità e, in alcuni casi, un lieve calo della qualità. Lo studio dimostra quindi un effetto concreto sulla produttività all'interno di uno specifico contesto lavorativo, piuttosto che il ritorno sull'investimento isolato di un livello semantico.
Questa distinzione è cruciale per la valutazione economica. Un'implementazione di IA di successo non rivela quale proporzione del successo sia attribuibile al modello linguistico, all'interfaccia utente, alle conoscenze disponibili, all'addestramento o ai flussi di lavoro modificati. Chiunque ricavi da questi dati promesse generiche di ritorno sull'investimento per un singolo componente architetturale ne sta superando il potere esplicativo.
Inoltre, il tempo di lavoro liberato non si traduce automaticamente in una corrispondente riduzione dei costi. I benefici economici si manifestano, ad esempio, quando un'azienda gestisce la domanda aggiuntiva, riduce i tempi di attesa, evita gli straordinari o impiega lavoratori qualificati, la cui disponibilità è limitata, in mansioni più impegnative. Senza tali modifiche, un risparmio di tempo misurabile può rimanere in gran parte inutilizzato dal punto di vista aziendale.
Calcolo del rendimento comprensivo di tutti i costi
Un business case valido dovrebbe innanzitutto analizzare il processo attuale. Ciò include i numeri di pratica, i tempi di elaborazione, le richieste di chiarimenti, le correzioni, le procedure di escalation e le conseguenze di decisioni errate. Successivamente, è necessario determinare quali di questi fattori potrebbero essere influenzati da un livello di significato comune. Solo allora si potranno avviare discussioni significative sulla portata dell'investimento e sui benefici attesi.
Sul fronte dei costi, oltre all'utilizzo di software e modelli, occorre considerare anche l'integrazione del sistema, la modellazione aziendale, la verifica dell'identità, la gestione degli accessi, i test e gli aggiornamenti continui. Il coinvolgimento di professionisti esperti, in particolare, non è una spesa aggiuntiva gratuita. Il loro tempo ha un valore economico e non è disponibile per altre attività durante la fase di implementazione.
Una valutazione obiettiva tiene conto anche delle perdite iniziali e dell'incertezza. Inizialmente, una nuova applicazione potrebbe richiedere ulteriori verifiche prima che le procedure si stabilizzino. Alcuni vantaggi si manifestano solo con un utilizzo più frequente, mentre altri non si concretizzano. Pertanto, un approccio di investimento graduale con obiettivi intermedi verificabili è spesso più plausibile di un ingente investimento iniziale la cui giustificazione si basa principalmente sulla promessa di sinergie future.
La giusta misura del successo
Il parametro di successo più importante è la spesa economica per transazione commerciale completata correttamente e in conformità. Questa prospettiva combina velocità, qualità e controllo. Impedisce che un elevato tasso di utilizzo o un breve tempo di risposta vengano considerati un successo se l'applicazione genera rilavorazioni aggiuntive.
Ai fini della misurazione, è necessario distinguere tra diverse tipologie di errore. Una metrica errata è diversa da un'eccezione contrattuale trascurata. Una notifica incompleta è diversa da una divulgazione non autorizzata di dati. Allo stesso modo, deve essere chiaro se un sistema risponde in modo affidabile a una domanda, la trasmette legittimamente a un essere umano o produce un risultato privo di fondamento.
Un confronto significativo si basa su casi pre-approvati e prende in considerazione l'intero processo. Per i processi idonei, implementazioni graduali o gruppi di confronto controllati possono aiutare a distinguere tra miglioramenti tecnici e modifiche generali. La revisione dovrebbe includere anche eccezioni rare ma economicamente rilevanti. Un sistema che gestisce bene i casi di routine ma trascura le eccezioni critiche può risultare convincente in media, ma comunque inaccettabile nella pratica.
La ricerca vettoriale non sostituisce un impegno vincolante
I database vettoriali supportano la ricerca di testi simili per contenuto, rendendo le informazioni comparabili tramite rappresentazioni numeriche chiamate embedding. I sistemi moderni possono inoltre utilizzare filtri di metadati, ricerche per parole chiave e metodi di ricerca combinati. Sarebbe quindi errato descriverli come repository fondamentalmente privi di contesto e di funzionalità di filtraggio.
La sua funzione principale, tuttavia, risponde a una domanda diversa da quella della governance operativa. La somiglianza sostanziale non indica automaticamente se un documento è attuale, legalmente vincolante o applicabile a un caso specifico. Un sistema di ricerca può considerare tali proprietà se sono memorizzate in modo affidabile e integrate correttamente nella query. Tuttavia, non determina autonomamente le decisioni aziendali necessarie.
Ciò si traduce in una chiara logica di investimento per le aziende. Una ricerca migliorata e livelli di significato più approfonditi possono completarsi a vicenda. Tuttavia, un maggior numero di risultati di ricerca non sostituisce responsabilità e regole chiaramente definite. Chi cerca di correggere ogni risposta errata unicamente con un indice di ricerca più potente rischia di fornire più materiale senza chiarirne la validità tematica.
🤖🚀 Piattaforma di intelligenza artificiale gestita: soluzioni di intelligenza artificiale più veloci, sicure e intelligenti con UNFRAME.AI

Piattaforma di intelligenza artificiale gestita - Immagine: Xpert.Digital
Qui scoprirai come la tua azienda può implementare soluzioni di intelligenza artificiale personalizzate in modo rapido, sicuro e senza elevate barriere all'ingresso.
Una piattaforma di intelligenza artificiale gestita è la soluzione completa e senza pensieri per l'intelligenza artificiale. Invece di dover gestire tecnologie complesse, infrastrutture costose e lunghi processi di sviluppo, riceverai una soluzione pronta all'uso, su misura per le tue esigenze, da un partner specializzato, spesso entro pochi giorni.
I principali vantaggi in sintesi:
⚡ Implementazione rapida: dall'idea all'applicazione pronta all'uso in pochi giorni, non mesi. Forniamo soluzioni pratiche che creano un valore aggiunto immediato.
🔒 Massima sicurezza dei dati: i tuoi dati sensibili restano con te. Garantiamo un'elaborazione sicura e conforme alle normative, senza condividere i dati con terze parti.
💸 Nessun rischio finanziario: paghi solo per i risultati. Gli elevati investimenti iniziali in hardware, software o personale vengono completamente eliminati.
🎯 Concentrati sul tuo core business: concentrati su ciò che sai fare meglio. Ci occupiamo dell'intera implementazione tecnica, del funzionamento e della manutenzione della tua soluzione di intelligenza artificiale.
📈 A prova di futuro e scalabile: la tua IA cresce con te. Garantiamo ottimizzazione e scalabilità continue e adattiamo i modelli in modo flessibile alle nuove esigenze.
Maggiori informazioni qui:
L'influenza dei documenti sulle decisioni aziendali
I grafi della conoscenza possono fare molto di più che semplici collegamenti
Un grafo della conoscenza rappresenta entità e le loro relazioni in una struttura a rete e può quindi costituire una componente importante di un livello semantico. Allo stesso tempo, le ontologie formali e i metodi basati su di esse possono anche supportare inferenze logiche; standard consolidati come OWL non si limitano alla semplice memorizzazione di connessioni di base. L'affermazione generica secondo cui un grafo della conoscenza non può rappresentare regole in linea di principio sarebbe quindi tecnicamente inesatta.
La questione cruciale, invece, è quali funzionalità una specifica soluzione combini effettivamente. Un grafo contenente oggetti aziendali non possiede automaticamente una gestione completa dei diritti, un controllo dei processi collaudato o una gestione professionale dei casi speciali. Al contrario, un'architettura a grafo opportunamente progettata può soddisfare gran parte di questi requisiti.
Un livello semantico dovrebbe quindi essere inteso meno come un prodotto necessariamente a sé stante e più come un insieme di funzioni necessarie. Alcune aziende possono coprire gran parte di queste esigenze con i modelli di business intelligence, i cataloghi di dati, i sistemi a grafo e i set di regole già esistenti. Altre necessitano di una piattaforma aggiuntiva. Ciò che è economicamente rilevante è la comprovata lacuna funzionale, non il numero di nuove categorie di prodotti introdotte.
Connettiti invece di salvare di nuovo tutto
Un livello semantico può connettere sistemi ERP e CRM esistenti, piattaforme dati e repository di documenti senza dover prima migrare tutti i dati aziendali in un'unica nuova posizione di archiviazione. I modelli semantici per gli indicatori chiave di prestazione (KPI) possono inoltre basarsi su strutture dati esistenti e derivarne la logica di interrogazione appropriata. Il significato condiviso è quindi fondamentalmente distinto dall'archiviazione fisica dei dati.
Tuttavia, ciò non significa che un'architettura di questo tipo possa funzionare senza alcuna copia dei dati. Indici di ricerca, informazioni estratte dai documenti, cache o risultati precalcolati possono essere utili per casi d'uso specifici. La questione aziendale rilevante è quali informazioni devono essere memorizzate, dove e per quanto tempo, non se la promessa di una protezione completa dalla copia possa essere commercializzata.
Un sistema ben progettato bilancia tempestività, tempi di risposta, disponibilità, costi e privacy dei dati. Requisiti di tempestività diversi possono essere applicati allo stato di un inventario rispetto a una clausola contrattuale. Una query distribuita su più sistemi sorgente può essere flessibile, ma aumenta anche la dipendenza dalla loro disponibilità. Pertanto, la soluzione migliore non è necessariamente la più centralizzata o la più distribuita, ma piuttosto quella più appropriata al processo aziendale.
La qualità dei dati rimane un compito a sé stante
Un livello di significato condiviso non rende automaticamente corretti i dati di origine errati. Persino i fornitori di sistemi di interrogazione semantica raccomandano di affrontare tempestivamente le attività fondamentali di coerenza, come la normalizzazione degli oggetti comuni e la pulizia dei dati non idonei. La semantica aziendale e la qualità dei dati sono complementari, non interscambiabili.
Un esempio particolarmente significativo è rappresentato dall'identità di un partner commerciale. Diverse grafie possono riferirsi allo stesso fornitore. Tuttavia, nomi simili possono anche appartenere a diverse entità giuridiche. Un'associazione affrettata di queste può quindi portare a un'errata attribuzione di informazioni di pagamento, dati di solvibilità o rapporti contrattuali. Una buona architettura deve pertanto essere in grado di indicare quali attribuzioni sono confermate e dove si tratta solo di un'ipotesi plausibile.
Questo aspetto è economicamente importante perché gli errori non sono sempre visibili nel momento in cui si verificano. Un'errata corrispondenza di identità può in seguito influenzare molteplici analisi e decisioni. Pertanto, l'implementazione dovrebbe concentrarsi non solo sulla qualità delle singole risposte, ma anche sull'assegnazione affidabile degli oggetti sottostanti. Altrimenti, il riutilizzo non solo moltiplica la conoscenza, ma anche i suoi errori.
Le regole devono diventare tecnicamente efficaci
Una policy contenuta in un documento non costituisce un controllo coercitivo. Per le applicazioni di intelligenza artificiale, i concetti di sicurezza distinguono esplicitamente tra requisiti linguistici e misure tecniche come funzioni limitate, permessi ristretti e condizioni di esecuzione verificabili. Un'eccessiva autonomia e diritti di accesso troppo ampi, in particolare, possono portare a risultati del modello errati o manipolati, innescando azioni dannose.
Un'architettura robusta dovrebbe quindi separare l'interpretazione dall'esecuzione. Il modello linguistico può, ad esempio, classificare un processo o suggerire un'azione. La correttezza del calcolo di un importo, l'approvazione concessa o la possibilità di eseguire una prenotazione dovrebbero, nei processi critici, essere ulteriormente garantite da una logica verificabile e dai sistemi responsabili.
Questo chiarisce un equivoco comune. Un livello semantico può fornire le basi aziendali per un comportamento conforme alle regole. Tuttavia, da solo non garantisce che un modello linguistico probabilistico applichi in modo affidabile ogni regola. La soluzione economicamente valida deriva dall'interazione tra significato, autorizzazioni, test, controlli di processo e linee d'azione chiaramente definite.
Le autorizzazioni fanno parte del significato
Quando si accede alla conoscenza aziendale, è necessario verificare non solo la pertinenza, ma anche le autorizzazioni di accesso. I controlli relativi ai documenti possono limitare i risultati della ricerca in base all'identità dell'utente e ai diritti assegnati; la loro efficacia dipende, tra l'altro, dalla corretta sincronizzazione delle informazioni di autorizzazione. Una knowledge base condivisa non significa quindi che ogni utente sia autorizzato a visualizzare gli stessi contenuti.
In pratica, la dimensione temporale è cruciale. Un dipendente può cambiare ruolo, un progetto può terminare o un documento può essere successivamente soggetto a restrizioni. Se il livello di ricerca e contesto utilizza autorizzazioni obsolete, può esporre contenuti non più accessibili nel sistema di origine. Pertanto, la manutenzione delle autorizzazioni deve essere esplicitamente inclusa nei costi operativi.
Anche domande con contenuti simili possono, per validi motivi, ricevere risposte diverse. Due utenti possono appartenere a diverse aree di responsabilità o avere accesso a diversi set di dati. La coerenza, quindi, non significa formulazione identica, bensì applicazione delle stesse regole professionali in un contesto comparabile. Una discrepanza costituisce un problema di qualità solo se non può essere spiegata da fattori quali tempo, ruolo, disponibilità dei dati o dalla domanda stessa.
Il sistema penitenziario necessita di un processo strutturato
Acquisire le correzioni degli utenti è una delle componenti di conoscenza previste per un livello semantico orientato all'IA. Nella gestione del rischio dell'IA, l'analisi delle modifiche apportate dagli utenti e delle loro cause è considerata una preziosa fonte di informazioni per la valutazione dei sistemi implementati. Tuttavia, ciò non significa che ogni modifica apportata dall'utente debba automaticamente diventare una regola generale.
Un risultato corretto può avere cause molto diverse. Forse un record di dati è stato assegnato in modo errato. Forse si è applicata un'eccezione contrattuale. Forse la precedente regola aziendale era obsoleta. Oppure forse l'utente ha semplicemente inserito una preferenza personale. Questi casi richiedono risposte diverse e non dovrebbero essere incorporati indiscriminatamente in una base di conoscenza condivisa.
Un processo di apprendimento economicamente valido considera inizialmente il feedback come un insieme di suggerimenti verificabili. Gli esperti in materia ne definiscono la portata, la natura vincolante e i test necessari. Solo a quel punto una modifica approvata viene resa disponibile per ulteriori applicazioni. Ciò non richiede necessariamente un riaddestramento del modello linguistico. Il punto cruciale è che l'errore venga evitato in futuro nel contesto appropriato, senza introdurre inavvertitamente nuovi errori altrove.
Il versioning protegge da false interpretazioni retrospettive
Le definizioni e le regole aziendali sono soggette a modifiche; pertanto, un livello semantico dovrebbe gestire le versioni di tali modifiche e assegnarle a esperti in materia per l'approvazione. Le piattaforme semantiche esistenti supportano già definizioni versionate o query di riferimento validate, incluse informazioni su quando e da chi sono state confermate. Una cronologia tracciabile non è quindi un elemento aggiuntivo puramente estetico, ma parte integrante di un utilizzo controllato.
Per una successiva revisione, tuttavia, la norma attualmente in vigore non è sufficiente. È altresì rilevante quale versione fosse in vigore al momento della transazione e quali informazioni il sistema fosse effettivamente in grado di elaborare in quel momento. Un emendamento contrattuale ricevuto successivamente non deve inavvertitamente diventare la base per la valutazione di una decisione precedente. Altrimenti, emerge a posteriori una parvenza di chiarezza che non esisteva al momento della decisione.
Le aziende dovrebbero quindi considerare congiuntamente la cronologia delle regole, le versioni dei documenti e lo stato dei dati. Il vantaggio in termini di costi non risiede tanto nel risparmio di secondi, quanto nella riduzione dei costi di risoluzione delle controversie. Chi è in grado di ricostruire le basi di una decisione impiega meno tempo a ricomporle a partire da e-mail, singoli file e solleciti successivi.
La libertà di modello non equivale ancora alla libertà di fornitore
La conoscenza aziendale dovrebbe essere organizzata in modo tale che una modifica del modello linguistico non richieda automaticamente una riscrittura completa delle fondamenta del business. La validità strategica di questa affermazione è supportata dalle dinamiche tecniche: tra novembre 2022 e ottobre 2024, il costo delle query del modello si è ridotto di oltre 280 volte a un livello di prestazioni paragonabile a GPT-3.5. Questo confronto si riferisce a uno specifico livello di benchmark e non deve essere interpretato come una corrispondente riduzione del costo complessivo di un'applicazione aziendale.
Tuttavia, la conclusione è plausibile: quando le prestazioni e i prezzi di un modello cambiano in modo significativo, la possibilità di passare a un altro diventa sempre più preziosa. Un modello tecnico utilizzabile in modo permanente può evitare che ogni aggiornamento tecnologico comporti un'ampia opera di traduzione tecnica. L'indipendenza dal modello assume quindi il carattere di un'opzione strategica.
Tuttavia, ciò non elimina tutte le dipendenze. Le definizioni potrebbero essere ancora legate a formati, interfacce o modelli operativi proprietari della piattaforma. Pertanto, un'azienda dovrebbe valutare separatamente se è possibile cambiare modello linguistico, esportare le proprie definizioni di conoscenza e continuare a utilizzare l'intera soluzione con un fornitore diverso. Solo questa distinzione consente una valutazione realistica dei costi di migrazione e del potere contrattuale.
Il mercato cresce insieme
Le definizioni semantiche sono ora offerte esplicitamente sia per la Business Intelligence (BI) che per l'Intelligenza Artificiale (IA): Snowflake collega le metriche aziendali e le relazioni tra entità con query e agenti, mentre dbt fornisce le sue metriche definite centralmente tramite interfacce per strumenti di IA. Parallelamente, è emerso Open Semantic Interchange (OSI) come iniziativa per lo scambio di metadati semantici indipendente dal fornitore. Il progetto è stato accettato nell'Apache Incubator nel 2026 con il nome di Apache Ossie.
Questo sviluppo ha un impatto economico maggiore rispetto al semplice annuncio di un nuovo prodotto. Se più strumenti possono utilizzare le stesse definizioni, la necessità di creare una nuova logica di business in ogni applicazione si riduce drasticamente. Allo stesso tempo, le piattaforme dati consolidate possono assumersi una quota maggiore della creazione di valore, precedentemente riservata a soluzioni aggiuntive specializzate.
Per i clienti, questo significa: prima di effettuare un nuovo acquisto, è necessario fare un inventario. I modelli di dati esistenti, i cataloghi degli indicatori chiave di prestazione (KPI), i sistemi di autorizzazione e le interfacce possono soddisfare alcuni dei requisiti. I formati di scambio aperti sono utili a questo proposito, ma non sono una prova completa di efficacia. Devono essere valutati in base a quali definizioni, regole e informazioni contestuali possono essere trasferite tra i sistemi effettivamente in uso senza perdita di significato.
La struttura della conoscenza di Unframe, vista in modo obiettivo
Unframe raggruppa le sue funzioni semantiche sotto il nome di Knowledge Fabric, collegando concetti aziendali, logica di business, relazioni e autorizzazioni. L'approccio mira a rendere i dataset strutturati e il contenuto dei documenti utilizzabili per casi d'uso specifici e ad espandere gradualmente la base di conoscenza. La soluzione è offerta anche con diversi modelli linguistici e integrazione nei sistemi aziendali esistenti.
Il vantaggio economico di questo concetto risiede nella combinazione di compiti precedentemente separati. Se l'integrazione del sistema, il contesto aziendale e l'utilizzo controllato funzionano bene insieme, lo sforzo richiesto per applicazioni aggiuntive può essere ridotto. Tuttavia, la concreta applicazione di questo vantaggio in una specifica azienda non può essere dedotta unicamente dal nome dell'architettura. Sono necessari risultati verificabili dai processi aziendali stessi.
Allo stesso tempo, la questione della proprietà e della gestione rimane rilevante: Unframe distingue tra dati, risultati e configurazioni di soluzione di proprietà del cliente, da un lato, e Knowledge Fabric e altri componenti della piattaforma gestiti dal fornitore, dall'altro. Pertanto, la libertà di scelta in merito al modello non deve essere equiparata alla completa indipendenza dalla piattaforma. Per una valutazione affidabile, è necessario chiarire esplicitamente le opzioni di esportazione, i diritti sulle definizioni tecniche e la continuità del sistema in caso di cambio di operatore.
Inizia in piccolo, ma mantieni la capacità di adattamento
Un approccio orientato alle applicazioni limita la portata della modellazione e consente di rivedere le definizioni con gli esperti in materia, utilizzando attività reali. Invece di mappare immediatamente l'intera azienda, vengono prima individuati i sistemi, gli oggetti, le relazioni e le regole necessari di un processo chiaramente definito. I componenti approvati possono quindi essere estesi per includere casi d'uso correlati.
Da un punto di vista economico, un processo con frequenti ripetizioni, risultati verificabili e problemi di coordinamento sufficientemente significativi è particolarmente adatto. Un caso d'uso eccessivamente semplice potrebbe dimostrare soltanto che una finestra di chat può essere collegata a una fonte di dati. Al contrario, un'introduzione troppo complessa può creare così tanti casi particolari irrisolti che i benefici diventeranno evidenti solo dopo molto tempo.
Il giusto equilibrio si trova tra un ambito limitato e una base riutilizzabile. Un progetto pilota non dovrebbe essere un prototipo usa e getta. Allo stesso tempo, il suo potenziale di integrazione non dovrebbe diventare una scusa per costruire un modello di business completo prima del primo miglioramento misurabile. Il punto di riferimento rimane l'individuazione dei componenti tecnici effettivamente necessari per il passo successivo significativo.
La responsabilità professionale determina l'accettazione
L'introduzione dell'IA non trasferisce la responsabilità dalle persone al software. Ogni definizione centrale richiede un'autorità competente in grado di valutare e approvare le modifiche. Anche i framework generali per un'IA affidabile sottolineano ruoli e responsabilità umani chiaramente definiti nella gestione dei sistemi di IA. Pertanto, la gestione tecnica e l'autorità degli esperti non dovrebbero essere tacitamente attribuite alla stessa figura.
Questo può risultare scomodo a livello organizzativo. Una definizione condivisa di fatturato, affiliazione al cliente o rischio può avere ripercussioni sui sistemi target, sulle responsabilità e sulle pratiche di valutazione esistenti. Un livello semantico mette in luce tali differenze. Non le risolve attraverso l'eleganza tecnica, ma piuttosto impone decisioni che in precedenza potevano essere evitate.
È proprio qui che risiede il suo valore a lungo termine. Quando concetti e regole non sono più confinati esclusivamente nella mente dei singoli dipendenti o sparsi in diverse applicazioni, l'azienda può diventare meno dipendente dai monopoli informali della conoscenza. Tuttavia, questo vantaggio presuppone che gli specialisti siano coinvolti nel processo di progettazione e percepiscano il livello di significato come un supporto. Se viene introdotto semplicemente come strumento di controllo, la disponibilità a contribuire con preziose conoscenze esperienziali potrebbe diminuire.
Non tutte le aziende necessitano della stessa profondità
I dati europei sull'utilizzo dell'IA rivelano differenze significative nella portata della sua implementazione, senza tuttavia indicare necessariamente la necessità di un'architettura specifica. Inoltre, tra le aziende che avevano preso in considerazione l'utilizzo dell'IA ma che non la stavano ancora impiegando nel 2025, il 70,89% ha citato la mancanza di competenze specifiche come motivo del mancato utilizzo; il 52,52% ha indicato le incertezze sulle conseguenze legali e il 48,83% le preoccupazioni relative alla privacy dei dati. Queste cifre si riferiscono specificamente a questo sottogruppo e non a tutte le aziende.
Ciò consente lo sviluppo di una prospettiva di investimento differenziata. Una piccola azienda con pochi sistemi e processi gestibili potrebbe inizialmente necessitare di indicatori chiave di prestazione (KPI) coerenti e di basi di conoscenza chiaramente mantenute. Una grande azienda con numerose filiali, linee di prodotto e ruoli di accesso, d'altro canto, può trarre vantaggio da un'infrastruttura semantica più completa. Il livello di dettaglio appropriato dipende dalla complessità e dal rischio, non dall'attrattiva di un particolare termine tecnologico.
Rinunciare a determinati compiti può anche essere economicamente vantaggioso. Se un'attività si verifica raramente, non ha conseguenze rilevanti e può essere svolta in modo affidabile con una procedura semplice, i costi di manutenzione di un ulteriore livello potrebbero superare i suoi benefici. Un approccio architettonico convincente deve quindi essere in grado di spiegare anche quando non è necessario.
Significato controllato come vantaggio competitivo
L'intelligenza artificiale generativa può presentare in modo convincente contenuti errati; questo rischio è tra le caratteristiche e i pericoli esplicitamente descritti di tali sistemi. Persino l'aggiunta di informazioni aziendali e metodi di recupero più sofisticati non elimina tutti i rischi per la sicurezza, come quelli derivanti da istruzioni manipolate nei contenuti elaborati. Pertanto, un livello semantico non garantisce la veridicità, la sicurezza o l'efficacia in termini di costi.
La sua giustificata importanza strategica risiede altrove. Può supportare la transizione da una conoscenza esperienziale frammentata a definizioni aziendali esplicite, riutilizzabili e verificabili. Ciò consente non solo di implementare l'IA in modo sporadico, ma anche di integrarla gradualmente in un sistema operativo controllato. Il vero valore aggiunto, quindi, non è il singolo assistente, bensì la capacità organizzata di sfruttare in modo affidabile la conoscenza aziendale per nuovi compiti.
Il vantaggio competitivo decisivo, quindi, non deriva dall'avere il maggior numero di agenti autonomi. Si manifesta piuttosto nella capacità delle aziende di riconoscere più rapidamente quali informazioni sono valide, quali eccezioni sono rilevanti e quali azioni rimangono giustificabili. Chi padroneggia queste basi può utilizzare modelli e strumenti in continua evoluzione in modo più efficace. Chi le trascura, rischia soprattutto di accelerare i propri fraintendimenti ad ogni nuova applicazione dell'intelligenza artificiale.
Consulenza - Pianificazione - Implementazione

Konrad Wolfenstein
Sarei felice di fungere da tuo consulente personale.
Puoi contattarmi all'indirizzo wolfenstein∂xpert.digital o
Chiamami al numero +49 7348 4088 965 .