
בינה מלאכותית ארגונית מתחילה היכן שהצ'אטבוט מסתיים
אקספרט טרום-השקה

זמין ב-27 שפות 📢
העדיפו את Xpert.Digital בגוגלⓘפורסם בתאריך: 2 באוקטובר, 2026 / עודכן בתאריך: 2 באוקטובר, 2026 – מחבר: Konrad Wolfenstein
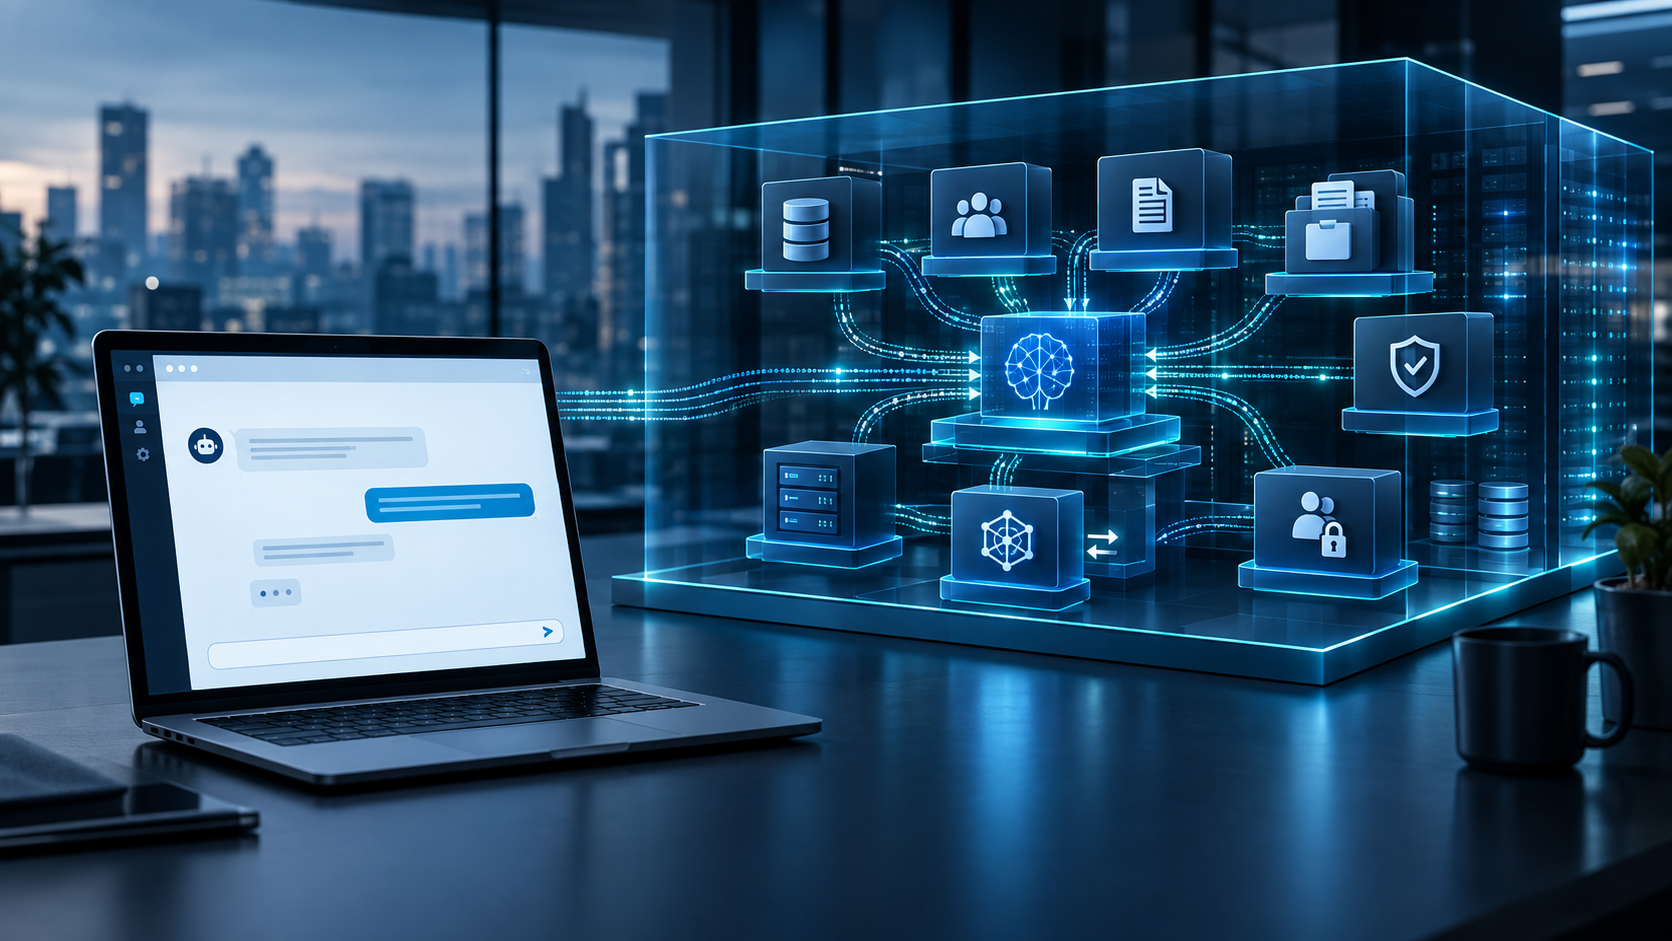
בינה מלאכותית ארגונית מתחילה היכן שהצ'אטבוט מסתיים - תמונה יצירתית בנושא, בהשתתפות בינה מלאכותית: Xpert.Digital
מרישיון לאחריות: כיצד חברות צריכות לחשוב מחדש על אסטרטגיית הבינה המלאכותית שלהן
כך חברות מצמצמות את הפער בין תקוות הבינה המלאכותית למציאות
חשיבות שכבת ההקשר לבינה מלאכותית ארגונית יעילה
בנוף הדיגיטלי של ימינו, שילוב הבינה המלאכותית (AI) בתהליכים עסקיים הופך לחשוב יותר ויותר. עם זאת, חברות רבות מתמודדות עם האתגר שעובדיהן מסתמכים לעתים קרובות על שירותי בינה מלאכותית פרטיים ולא מורשים - נוהג המכונה בינה מלאכותית צללית (Shadow AI). התפתחות זו חושפת פער קריטי בין הפתרונות המסופקים על ידי חברות לבין הצרכים בפועל של המשתמשים במקום העבודה. בעוד שרישיונות ארגוניים לכלי בינה מלאכותית מבוססים נחשבים אמצעי בסיסי, הם לבדם אינם מספיקים כדי לענות על הדרישות המורכבות והנסיבות הספציפיות של עסק. בינה מלאכותית ארגונית גנרטיבית אמיתית דורשת ארכיטקטורת מערכת מעוצבת היטב הכוללת מודלים, גישה לנתונים, לוגיקת תהליכים ואחריותיות. במאמר זה, נחקור את ההיבטים החיוניים שחברות חייבות לשקול כדי למנף את מלוא הפוטנציאל של הבינה המלאכותית ולהילחם ביעילות בבינה מלאכותית צללית.
קשור לזה:
חלוקת רישיונות בלבד לא הופכת את החברה לדיגיטלית – היא הופכת את בעיית הבינה המלאכותית בצל שלה לדיגיטלית
בחברות רבות, עתידה של הבינה המלאכותית הגנרטיבית אינו מוכרע בפגישת אסטרטגיה, אלא ברגע נסתר בעבודה: עובד מעתיק חוזה עם לקוח, חישוב או אימייל פנימי לשירות בינה מלאכותית הזמין לציבור, משום שהכלי שנמצא בשימוש פרטי נראה מהיר יותר, מובן יותר וחזק יותר מהפתרון שאושר רשמית על ידי החברה. מנקודת מבטו של העובד, לעתים קרובות אין מדובר בהפרה מכוונת של הכללים, אלא בתגובה פרגמטית לתהליכים לא יעילים. מנקודת מבטה של החברה, הדבר מצביע על פער מסוכן בין אישור טכני לשימושיות בפועל.
הרפלקס הנפוץ לסגור את הפער הזה על ידי רכישת רישיון כלל-חברתי לעוזר בינה מלאכותית ידוע לוקה בחסר. רישיון כזה יכול לספק אמצעי הגנה חשובים, פונקציות אדמיניסטרטיביות והתחייבויות חוזיות. עם זאת, הוא אינו הופך אוטומטית עוזר כללי למערכת שמבינה את מוצרי החברה, לקוחותיה, חוזיה, תפקידיה, גבולות האישורים וזרימות העבודה. הוא גם אינו עונה אוטומטית על שאלות כגון היכן מעובדים נתונים רגישים, מי אחראי לתוצאות שגויות, או האם ניתן לפתח תהליכים נוספים בעלות שולית סבירה לאחר מקרה השימוש הראשוני.
התזה הכלכלית המרכזית היא אפוא זו: בינה מלאכותית ארגונית גנרטיבית אמיתית אינה מודל יחיד או חלון צ'אט עם לוגו של חברה. זוהי מערכת תפעולית המורכבת ממודלים, נקודות גישה לנתונים, הקשר, זהויות, הרשאות, לוגיקת תהליכים, בקרות איכות, אחריות וארכיטקטורת עלויות חזקה. הערך האמיתי נובע לא מגישה לבינה מלאכותית, אלא משילובה המבוקר בארגון. זה בדיוק המקום שבו רכיב עסקי פרודוקטיבי שונה ממוצר צריכה נוח עם פרטי התחברות עסקיים.
רישיון חברה הוא יסוד, אך עדיין לא בניין
גרסאות ארגוניות של עוזרי בינה מלאכותית מרכזיים פותרות בעיות מהעולם האמיתי. בדרך כלל, ספקים מתחייבים לא להשתמש בקלטים ובפלטים עסקיים כברירת מחדל כדי לאמן את המודלים הכלליים שלהם. תכונות נוספות כוללות ניהול משתמשים מרכזי, כניסה יחידה, בקרת גישה מבוססת תפקידים, רישום, הצפנה, דוחות שימוש, הסכמי עיבוד נתונים ותקופות שמירה הניתנות להגדרה חלקית. יתר על כן, ניתן למנף זכויות גישה, מדיניות ומנגנוני אבטחה קיימים בתוך פלטפורמות משרדיות מבוססות. עבור ארגונים רבים, זה מייצג שיפור משמעותי לעומת חשבונות אישיים.
הטעות אינה ברכישת רישיונות כאלה. הטעות היא בטעות בבחינת היקף ההגנה שלהם כפתרון ארגוני מלא. התחייבות לא להשתמש בנתוני לקוחות לצורך אימון מודלים כללי עונה רק על אחת מכמה שאלות הקשורות לנתונים. מיקום העיבוד, אחסון הקלטים והפלטים, תקופת השמירה, מעורבותם של קבלני משנה, הטיפול בטלמטריה ותחומי השיפוט הרלוונטיים - כל אלה יכולים להישאר שאלות פתוחות. יתר על כן, מוצר הצ'אט, ממשק התכנות, עוזר המשרד המשולב ומופע הענן הספציפי ללקוח לרוב שונים זה מזה באופן משמעותי. לכן, שחרור גורף המבוסס על שם מותג אינו מספיק הן מבחינה עסקית והן מבחינה רגולטורית.
מעל הכל, הרישיון עצמו חסר זיכרון מוסדי. מודל אינו יודע באופן אוטומטי את המשמעות הספציפית של שם מוצר, את היסטוריית התלונה, או איזו מבין מספר מערכות של לקוחות היא סמכותית לתהליך מסוים. הוא אינו מזהה חריגים לא פורמליים או את מטריצת האישור ואינו יכול לקבוע באופן עצמאי האם מדיניות מיושנת או יורשתה חלה. הגישה למודל נרכשת; עם זאת, יש לבנות, לבדוק ולתחזק את האמינות התפעולית באופן רציף.
בינה מלאכותית של צללים היא שיקול דעת שוק של כוח העבודה של החברה עצמה
השימוש בחשבונות פרטיים של בינה מלאכותית מטופל לעתים קרובות כסוגיה של משמעת או הכשרה. זה פשטני מדי. כאשר עובדים פונים לכלים לא מורשים למרות איסורים, הם מספקים משוב שוק לא מכוון: האפשרות המאושרת מפסידה בהשוואה ישירה מבחינת מהירות, שימושיות, איכות המודל או שילוב מעשי בתהליכי עבודה. איסורים יכולים להפחית סיכונים בטווח הקצר, אך הם אינם מבטלים את הדרישה לפתרון טוב יותר.
היקף העניינים משמעותי. דיווחים מצביעים על כך שעד שנת 2026, 47 אחוז מהעובדים המשתמשים בבינה מלאכותית גנרטורה במקום העבודה עדיין ישתמשו בחשבונות אישיים ולא מנוהלים. במקביל, מספר האירועים שתועדו הקשורים להעברת נתונים רגישים ליישומי בינה מלאכותית הוכפל. בממוצע נרשמו 223 הפרות מדיניות כאלה לארגון לחודש; עבור חברות שנפגעו במיוחד, הנטל היה גבוה פי כמה. נתונים אישיים, פיננסיים ורפואיים מוסדרים היוו חלק גדול במיוחד מהפרות אלו. מדדים כאלה לוכדים רק אירועים גלויים וסביר להניח שלא ישקפו באופן מלא את השימוש בפועל.
מנקודת מבט כלכלית, מערכות מידע מרכזיות מתחרה אפוא בחלופה חינמית או במימון פרטי. לחלופה זו חסמי כניסה נמוכים, חוויית משתמש טובה, ולעתים קרובות היא המודל העדכני ביותר. חלופה פנימית אינה מנצחת אך ורק על בסיס תאימות, אלא רק אם היא נוחה לפחות באותה מידה ומציעה ערך עסקי נוסף. עליה למצוא מידע רלוונטי, להיות זמינה ביישומים קיימים, להימנע מהעתקה מיותרת ולתאם תשובות להקשר בתוך תהליך העבודה. קבלה מתמשכת אינה מושגת באמצעות כפייה, אלא באמצעות תועלת גדולה יותר בפחות מאמץ אישי.
אין זה אומר שבקרות טכניות מיותרות. מניעת אובדן נתונים, הגבלות לקוחות, בקרות דפדפן, רישום וכללי שימוש ברורים נותרים חיוניים. עם זאת, יעילותם עולה משמעותית כאשר קיימת גם אלטרנטיבה בעלת ביצועים גבוהים. לכן, תגובת ההנהלה הנכונה אינה רק חסימת בינה מלאכותית בצל, אלא ניתוח גורמים בסיסיים: לאילו משימות משתמשים בה העובדים? אילו מערכות מורשות נכשלות? איזה חוסר יעילות גורם לאנשים להשתמש בחשבונות פרטיים? תשובות אלו יובילו לרשימת עדיפויות ריאליסטית עבור בינה מלאכותית ארגונית.
ידע תאגידי לא נוצר בחלון הצ'אט
עוזרי בינה מלאכותית כלליים מתחילים תהליך בעיקר עם ההקשר שמספק המשתמש או שמוסבר על ידי המוצר מאינטראקציות קודמות מוגבלות. ניטרליות זו שימושית לעתים קרובות למשימות אישיות. עם זאת, היא הופכת לסיכון בהקשר עסקי ברגע שהחלטות תלויות במידע היסטורי, חוזי או ספציפי ללקוח. לדוגמה, תגובה אמינה לתביעת ביטוח יכולה להיות מושגת רק על ידי שילוב היסטוריית התביעות, גרסת הפוליסה, התכתבויות, דרישות רגולטוריות ומצב הטיפול. חוזה יחיד שהועלה אינו מספיק למטרה זו.
הידע הדרוש ממוקם לעיתים רחוקות במקום אחד. הוא מפוזר על פני מערכות ERP, CRM, מערכות ניהול מסמכים, מערכות כרטוס, מחסני נתונים, דוא"ל, יישומים ייעודיים וקבצים אישיים. יתר על כן, ישנם מזהים, איותים, גרסאות נתונים ואחריות שונים. לקוח עשוי להיות רשום תחת שמות שונים בשלוש מערכות; קוד מוצר עשוי לקבל משמעות שונה לאחר מיזוג; מדיניות עשויה עדיין להיות נגישה רשמית אך טכנית הוחלף. מודל השפה אינו יכול לפתור את הסתירות הללו בעצמו. ללא מיפוי אמין, הוא יכול, במקרה הטוב, לייצר סינתזה משכנעת מבחינה לשונית של נתונים לא עקביים.
לכן, אספקת הקשר היא בעיקר משימת אינטגרציה וניהול נתונים. יצירה מורחבת של אחזור, כלומר, אספקה ממוקדת של תוכן רלוונטי בזמן הבקשה, היא שיטה חשובה, אך לא פתרון מלא. נדרשים גם מטא-נתונים, ניהול גרסאות, אימות זהות, בדיקות הרשאה, עדיפות מקור, תקופות תוקף וכללים למידע סותר. ככל שהמערכת נועדה לפעול ולא רק להגיב, כך חשובות יותר בקרות טרנזקציות ומנהיגות מערכת מוגדרת בבירור.
בדיקה פשוטה יכולה לחשוף בגרות: הכלי שאושר מקבל שאלה הדורשת רק ידע פנימי של החברה כדי לענות בצורה נכונה. אם הוא מספק תשובה כללית, בטוחה ושגויה, הוא פונקציונלי נחשב לצ'אטבוט עם גישה לחברה. אם הוא רק מבקש קובץ, הוא נחשב לצ'אטבוט עם פונקציית העלאה. רק כאשר הוא ניגש למערכות הרלוונטיות באופן לגיטימי, שקוף ובזמן אמת, מזהה אי ודאות וממקם את התשובה בהקשר החברה, מתגלה בינה ארגונית אמיתית.
שכבת ההקשר הופכת למלאי ההון היצרני
המרכיב הארכיטקטוני המכריע נמצא בין המודל לעסק התפעולי. ניתן לתאר שכבה זו כפלטפורמת הקשר, מארג ידע, או שכבת אינטגרציה ותזמור. שמה פחות חשוב מתפקידה: היא ממפה ישויות זו לזו, מחברת מקורות נתונים, בודקת הרשאות, מספקת הגדרות, שולטת בכלים ומתעדת כיצד תגובה או פעולה התרחשה. באופן אידיאלי, עבודה זו אינה מתחילה מחדש עבור כל מקרה שימוש, אלא נבנית כאבן בניין ארגונית רב פעמית.
מנקודת מבט כלכלית, שכבה זו דומה למלאי הון יצרני. החיבור הראשוני לארכיון חוזים, ההקצאה הנקייה הראשונה של זהויות לקוח, או היישום הראשון של לוגיקת אישור כרוכים בעלויות ראשוניות גבוהות. עם זאת, לאחר שאלמנטים אלה עוברים סטנדרטיזציה, מקרי שימוש נוספים יכולים להיבנות עליהם. העלות השולית של השימוש השני, השלישי והחמישי אמורה לרדת. השפעה זו לבדה מצדיקה אסטרטגיית פלטפורמה: חלק מההשקעה הופך לשימושי לא רק עבור פרויקט אחד, אלא עבור מספר הולך וגדל של תהליכים עתידיים.
עם זאת, אפקט שימוש חוזר זה אינו מתרחש באופן אוטומטי. פלטפורמות רבות המוצעות כביכול מורכבות מאוסף של ממשקים, הנחיות ופתרונות מותאמים אישית ספציפיים לפרויקט. לאחר מכן יש לנתח, לשלב ולאבטח כל יישום חדש מחדש. עקומת העלות נשארת ליניארית, בעוד שתלות נוספות מתעוררות. לכן, מבחן בגרות אמיתי הוא לקבוע אילו רכיבים ספציפיים ממקרה השימוש הראשון ניתן לעשות בהם שימוש חוזר במקרה השימוש השני ללא בנייה מחדש. רכיבים הניתנים לשימוש חוזר כוללים, לדוגמה, שירותי זהות, מחברים, בקרת גישה, קטלוגי נתונים, הליכי הערכה, רישום, גישה למודל ואישורים אנושיים סטנדרטיים.
שכבת ההקשר חשובה אסטרטגית יותר מהמחויבות למודל יחיד. מודלים משתפרים במהירות, מחירים משתנים ומשימות שונות נהנות מיתרונות שונים. לכן, חברות זקוקות ליכולת להחליף מודלים באופן מבוקר או להשתמש בכמה מודלים במקביל. עם זאת, מעבר אינו חופשי לחלוטין: התנהגות מהירה, פורמטי פלט, מסנני אבטחה, חלונות הקשר ופרופילי ביצועים שונים. ארכיטקטורה טובה מפחיתה את עלויות המעבר הללו באמצעות הפשטה, ממשקים סטנדרטיים ובדיקות חוזרות, במקום ליצור רושם לא מציאותי של החלפה מוחלטת.
ריבונות נתונים כוללת יותר מאשר רק אי הכללת הדרכה
הדיון הציבורי התמקד זה מכבר בשאלה האם קלט משמש לאימון מודל. בעוד ששאלה זו חשובה לעסקים, היא מוקד צר מדי. שרשרת האחסון והעיבוד כולה היא קריטית: לאן מעובד הקלט? אילו חלקים של מסמך מועברים? לאן מאוחסנים היסטוריית צ'אט, מטמונים, יומני רישום וייצוגים וקטוריים? כמה זמן הם נשמרים? לאילו קבלני משנה יש נקודות קשר טכניות? איזו מסגרת משפטית חלה? האם מנהלים יכולים לצפות, לייצא ולמחוק תוכן? כיצד מטפלים בגיבויים?
מחלקת שיווק רשאית, בנסיבות מסוימות, להשתמש באחריות בטיוטה שעובדה חיצונית. סטנדרטים שונים חלים על נתונים עסקיים שלא פורסמו, סודות מסחריים, נתוני בריאות, תיקים משפטיים או תשתיות קריטיות. לכן, סיווג הסיכון לא צריך להתבסס אך ורק על הכלי בו נעשה שימוש, אלא על סוג הנתונים, הפעולה שננקטה, הנזק הפוטנציאלי ורמת הפיקוח האנושי. אותו מודל עשוי לייצג סיכון נמוך בעת כתיבה מחדש של הודעה לעיתונות וסיכון גבוה בעת עיבוד אוטומטי של הלוואה או תביעה.
ארכיטקטורה חזקה ממזערת את תנועת הנתונים. המידע נשאר בתוך המערכות הקיימות ככל האפשר; רק ההקשר הדרוש למשימה מסופק, בכפוף לכללי הגישה הקיימים. שאילתות מאושרות על בסיס ספציפי למשתמש, שדות רגישים מוסווים במידת הצורך, והפלט מסווג לפי תוכנו. עבור תהליכים קריטיים במיוחד, עיבוד אזורי, מופעים ייעודיים, סביבות מחשוב סודיות או פריסה מקומית עשויים להיות מומלצים. עם זאת, תפעול פנימי מלא אינו אוטומטית בטוח יותר ואינו חסכוני יותר, שכן תפעול, תיקון תיקונים, ניטור, תחזוקת מודלים וצוות מומחה כרוכים בעלויות משמעותיות.
הנוסחה להבאת המודל לנתונים מתארת אפוא עיקרון הגיוני, אך אין לפרש אותה כפישוט טכני. אפילו עם פתרונות מאוחדים או מחוברים מקומית, קטעים, הטמעות או מטא-דאטה יכולים להגיע לשירותים חיצוניים. ניתוח זרימת נתונים מתועד ברמת הרכיב הוא קריטי. רק כאשר ניתן להדגים עבור כל שלב אילו נתונים הולכים לאן וכיצד הם מוגנים, ניתן להעריך באופן מהימן את ריבונות הנתונים.
רגולציה הופכת את המעקב לגורם כלכלי
בתעשיות מוסדרות, זרימת נתונים אינה אידיאל אבטחה מופשט. מוסדות פיננסיים, במסגרת הכללים האירופיים לחוסן תפעולי דיגיטלי, חייבים להעריך באופן שיטתי את הסיכונים הנשקפים מטכנולוגיות מידע ותקשורת וכן מספקי צד שלישי. הסכמי סודיות, סודיות מקצועית, חוקי הגנת מידע ותקנות מגזריות דורשים גם מחברות להיות מסוגלות להסביר פעילויות עיבוד, אחריות ואמצעי בקרה. יישום בינה מלאכותית שאיכות התגובה שלו משכנעת, אך נתיב הנתונים שלו אינו ניתן לביקורת, אינו יכול לעבור בדיקות קבלה תפעוליות.
עם חוק הבינה המלאכותית האירופית, משילות שיטתית צוברת חשיבות רבה יותר. חלקים גדולים מהמסגרת הרגולטורית האירופית נמצאים בתוקף מאז אוגוסט 2026, בעוד שחובות בודדות עבור מערכות מסוימות בסיכון גבוה ייכנסו לתוקף בשלבים. הדבר אינו מביא לאיסור גורף על בינה מלאכותית גנרטורה עבור חברות. במקום זאת, נדרש סיווג חזק המבוסס על תחום יישום ותפקיד. מודל כללי, מערכת ייעודית הבנויה עליו, והחברה המשתמשת במערכת זו יכולות להיות בעלות התחייבויות שונות. שקיפות, תיעוד, פיקוח אנושי, איכות נתונים, דיוק, אבטחת סייבר ומעקב הם קריטיים במיוחד עבור יישומים בסיכון גבוה.
תאימות אינה רק גורם עלות. ארכיטקטורת בקרה רב פעמית יכולה לקצר את זמן ההגעה לשוק מכיוון שלא כל פרויקט צריך להמציא מחדש את הכללים שלו. מחלקות סיכון סטנדרטיות, נתיבי מודל מאושרים, רישום טכני, תבניות הערכה ורמות אישור מוגדרות מפחיתות את אי הוודאות. לפיכך, הממשל הופך מפונקציית בקרה במורד הזרם לתשתית יצרנית. היתרון הכלכלי מתבטא במיוחד במהלך פריסות שניות ושלישיות, כאשר ניתן לעשות שימוש חוזר ברכיבים שנבדקו.
חברות צריכות גם להבחין בין סיכון מודל לסיכון תהליך. מודל יכול להיות בעל עוצמה טכנית, בעוד שתהליך שתוכנן בצורה גרועה ממשיך להשתמש במקורות נתונים שגויים, בעל אחריות לא ברורה, או שאינו מאפשר היפוך של פעולות שגויות. לעומת זאת, מודל מוגבל יכול להיות מועיל מאוד בתהליך מוגדר היטב ומבוקר היטב. לכן, איכות הארכיטקטורה הכוללת היא לעתים קרובות יותר הגורם המכריע לכדאיות רגולטורית וכלכלית מאשר ביצועי השיא של המודל בבדיקות כלליות.
🤖🚀 פלטפורמת בינה מלאכותית מנוהלת: פתרונות בינה מלאכותית מהירים, בטוחים וחכמים יותר עם UNFRAME.AI

פלטפורמת בינה מלאכותית מנוהלת - תמונה: Xpert.Digital
כאן תלמדו כיצד החברה שלכם יכולה ליישם פתרונות בינה מלאכותית מותאמים אישית במהירות, בצורה מאובטחת וללא חסמי כניסה גבוהים.
פלטפורמת בינה מלאכותית מנוהלת היא הפתרון השלם והחסר דאגות שלכם לבינה מלאכותית. במקום להתמודד עם טכנולוגיה מורכבת, תשתית יקרה ותהליכי פיתוח ארוכים, אתם מקבלים פתרון מוכן מראש המותאם לצרכים שלכם משותף מתמחה - לעתים קרובות תוך מספר ימים בלבד.
היתרונות המרכזיים במבט חטוף:
⚡ יישום מהיר: מרעיון ליישום מוכן לשימוש תוך ימים, לא חודשים. אנו מספקים פתרונות מעשיים היוצרים ערך מוסף מיידי.
🔒 אבטחת מידע מקסימלית: המידע הרגיש שלך נשאר אצלך. אנו מבטיחים עיבוד מאובטח ותואם ללא שיתוף מידע עם צדדים שלישיים.
💸 אין סיכון פיננסי: אתם משלמים רק על תוצאות. השקעות גבוהות מראש בחומרה, תוכנה או כוח אדם מבוטלות לחלוטין.
🎯 התמקדו בעסק הליבה שלכם: התרכזו במה שאתם עושים הכי טוב. אנחנו דואגים לכל תהליך היישום הטכני, התפעול והתחזוקה של פתרון הבינה המלאכותית שלכם.
📈 עמיד לעתיד וניתן להרחבה: הבינה המלאכותית שלכם גדלה איתכם. אנו מבטיחים אופטימיזציה וגמישות מתמשכת, ומתאימים את המודלים לדרישות חדשות בצורה גמישה.
מידע נוסף כאן:
מפרויקט בינה מלאכותית למערכת הפעלה עסקית
אסור שאחריות תעלם בין רישוי לייעוץ
שירותי בינה מלאכותית מוכווני צרכן נמכרים ככלי עבודה. ספקים מציינים בצדק כי הוצאות יכולות להיות לא מדויקות וכי על המשתמשים לאמת את התוצאות. מודל זה מובן עבור שוק המוני בעלות נמוכה. עם זאת, ביישומים עסקיים, נוצר פער באחריות ברגע שאותן הוצאות מגיעות ללקוחות, משפיעות על דיווח רגולטורי או מפעילות תהליכים פיננסיים. ספק הגישה מוכר את היכולת להשתמש בשירות אך בדרך כלל אינו נושא באחריות על תוצאות התהליך העסקי הספציפי.
אפילו מודל האינטגרציה המסורתי יכול להשאיר את הפער הזה פתוח. ספק שירות מנתח, מפתח ומשלב במשך חודשים, גובה תשלום עבור זמן וחומרים, ולבסוף מספק מערכת. החוזה עשוי להתבצע באופן רשמי, למרות שהכלי אינו מתקבל היטב בשימוש יומיומי, מייצר יותר מדי שגיאות, או אינו מצליח להשיג שיפור תהליך מדיד כלשהו. מצד אחד, הגישה נמכרה; מצד שני, עבודה. בשני המקרים, אף אחד לא בהכרח מחויב כלכלית לתוצאה המוסכמת.
לכן, בינה מלאכותית ארגונית דורשת הקצאת אחריות מפורשת. יחידות עסקיות, מערכות מידע, אבטחת מידע, הגנת נתונים, ניהול סיכונים וספקים חייבים לדעת מי אחראי לאיכות הנתונים, מי בוחר מודלים, מי קובע מגבלות, מי מאשר הוצאות ומי מקבל החלטות במקרה של שיבושים. עבור פעולות אוטומטיות, מעקב, אפשרויות ביטול והסלמה מוגדרת בבירור הם חיוניים. סקירה אנושית היא בקרה יעילה רק אם לבודק יש מספיק זמן, מומחיות ומידע; קליק שגרתי מצמצם את הפיקוח האנושי לעניין פורמלי בלבד.
מודלים של תגמול מוכווני תוצאות יכולים לשפר תמריצים, אך הם אינם תרופת פלא. הם עובדים רק אם התוצאות ניתנות למדידה, לייחוס ומוגנות מפני מניפולציה. עבור תהליך ברור, כגון צמצום זמן עיבוד, הפחתת שיעורי שגיאות או הגדלת מספר המקרים הנפתר, ניתן להסכים על אלמנטים מבוססי ביצועים. ייחוס קשה יותר עבור משימות אסטרטגיות מבוססות ידע. לעתים קרובות מומלץ להשתמש במודל היברידי, המורכב משכר בסיס, מדדי איכות ושימוש, ורכיב המקושר לתוצאות עסקיות מוסכמות.
מקרה השימוש השני חושף את כלכלת הפלטפורמה
תהליכי בחירה רבים מתמקדים במקרה שימוש ראשוני, פשוט במכוון. סיכום מסמכים, כתיבת מיילים, הסבר על קובץ שהועלה או יצירת וריאציות טקסט מתאימים היטב למודלים כלליים מכיוון שכמעט כל ההקשר זמין בשורת הפקודה. משימות כאלה מדגימות את יכולות השפה של המודל אך בקושי את הבשלות של פלטפורמה ארגונית. לעתים קרובות ניתן לכסות אותן עם מספר מצומצם של רישיונות ומאמץ יישום שניתן לנהל.
מקרה השימוש השני הוא אינפורמטיבי יותר. אם אותה מערכת אמורה ליישב חשבוניות ספקים עם חוזים, היא דורשת גישה לארכיון החוזים, למערכת ה-ERP, למטריצת אישורים, לנתוני אב ולכללי חריגים. עליה לאחד ייעודים שונים, להסביר פערים, לכבד הרשאות ולהעביר בעיות לתפקיד המתאים כאשר אין ודאות. כאן, המוקד עובר מהמודל לאינטגרציה ולוגיקת התהליך. מקרה שימוש זה מאמת האם הארכיטקטורה שהוקמה בעבר אכן ניתנת לשימוש חוזר.
פלטפורמה ראויה לשמה כאשר הפריסה השנייה הופכת למהירה וזולה יחסית, והאפקט הזה מתעצם עם יישומים נוספים. אם כל מקרה שימוש חדש נשאר יקר כמו הקודם, לא קיימת כלכלת סינרגיה משמעותית. במקרה כזה, החברה מחזיקה ברישיון בתוספת רשימת המתנה לשירותי ייעוץ. לכן, המבחן המסחרי החשוב ביותר הוא לדרוש עלות ומסגרת זמן אמינים עבור הפריסה השנייה והשלישית עוד לפני שמחליטים על הראשונה.
נקודת מבט זו משנה גם את חישוב ההשקעה. אין להכביד על מקרה השימוש הראשוני בכל עלויות הפלטפורמה בנפרד אם רכיבים משמעותיים ינוצלו שוב בהמשך. לעומת זאת, אין זה ישר להתייחס לשימוש חוזר עתידי מעורפל כיתרון מבלי לציין תהליכי מעקב קונקרטיים, בעלים ותקציבים. חישוב תקין מפריד בין השקעות חד-פעמיות בפלטפורמה, פיתוח ספציפי למקרה שימוש, עלויות מודל ותשתית שוטפות, ועלויות עבור ניטור, אבטחת איכות וניהול שינויים. רק אז ניתן לקבוע הוצאה כוללת ריאלית על פני מספר שנים.
העלויות לעיתים רחוקות מיוחסות אך ורק לקריאות המודל
עם בינה מלאכותית גנרטיבית, תשומת הלב מתמקדת לעתים קרובות בדמי רישיון או בעלויות טוקנים. עלויות אלו נראות לעין, אך לרוב אינן דומיננטיות ביישומים ארגוניים מורכבים. הוצאות נוספות כוללות ניקוי נתונים, ממשקים, ניהול זהויות, ביקורות אבטחה, מערכי נתוני הערכה, ניטור, זמן מומחים, הדרכה, תמיכה והתאמות שוטפות. בעלות לא ברורה על נתונים, פתרונות מותאמים אישית ספציפיים לפרויקט ועבודה ידנית חוזרת עקב איכות לא עקבית הופכים יקרים במיוחד.
מחקרי שוק חושפים את המתח בין ציפיות גבוהות לבין יכולת הרחבה מוגבלת. בסקר בינלאומי שנערך בקרב 2,000 מנהיגים עסקיים, רק כרבע מיוזמות הבינה המלאכותית השיגו עד כה את התשואה הצפויה על ההשקעה; רק 16 אחוזים הורחבו לכלל החברה. במקביל, 72 אחוזים ראו בנתוני חברה קנייניים חיוניים לערך של בינה מלאכותית גנרטיבית, ו-68 אחוזים ראו בארכיטקטורת נתונים משולבת כלל-חברתית כחיונית. נתונים אלה אינם אמיתות מוחלטות, אך הם ממחישים שגישה למודלים לבדה אינה מייצרת לא יכולת הרחבה ולא תשואה על ההשקעה.
אפילו שיעורי כישלון גבוהים מאוד ממחקרים יש לפרש בניואנסים. ניתוח שצוטט רבות משנת 2025 הגיע למסקנה כי 95 אחוז מהיוזמות שנבדקו לא השיגו כל תועלת כלכלית מדידה. המתודולוגיה, גודל המדגם והגדרת ההצלחה מגבילים את הכללת הממצא הזה; יתר על כן, פרויקטים רבים היו עדיין בשלבים מוקדמים. אף על פי כן, התוצאה מצביעה על דפוס אמיתי: כלים גנריים יכולים להגביר את הפרודוקטיביות האישית, אך חיסכון בזמן זה אינו מתורגם אוטומטית לעלויות נמוכות יותר, תפוקה גבוהה יותר או הכנסות נוספות.
לצורך הערכת השקעות, מדדי תהליך חשובים יותר ממדדי פעילות. מספר המשתמשים, ההנחיות או הטקסטים שנוצרו מודדים קבלה, לא הצלחה כלכלית. רלוונטיים יותר הם זמן עיבוד, עלות לעסקה, שיעור שגיאות, מאמץ עיבוד חוזר, תפוקה, זמן טיפול בתביעות חייבים, שיעור פתרון ושביעות רצון לקוחות. שיפורי פרודוקטיביות מתורגמים לתוצאה פיננסית רק כאשר החברה פורסת מחדש משאבים, מבטלת צווארי בקבוק, מוכרת שירותים נוספים או למעשה נמנעת מעלויות.
מודל פרטי עדיין אינו בינה מלאכותית ארגונית
המונחים בינה מלאכותית פרטית, מודל שפה פרטי ובינה מלאכותית ארגונית משמשים לעתים קרובות לסירוגין. מודל פרטי מתאר בעיקר את התנאים הטכניים והחוזיים שבהם מודל מופעל ולמי יש גישה אליו. הוא יכול לפעול באופן מקומי, בסביבת ענן ייעודית או באמצעות שירות מאובטח ביותר. עם זאת, מאפיין זה אומר מעט על האם המערכת מבינה נתונים עסקיים רלוונטיים, מיישמת נכון הרשאות או תומכת בתהליך באופן אמין.
חברה יכולה להפעיל מודל כולו באופן פנימי ועדיין להסתיים עם נתונים מבודדים, איכות חיפוש ירודה, אחריות לא ברורה וחוסר במדידת ביצועים. לעומת זאת, פתרון ענן שתצורתו מוגדרת בקפידה יכול להיות חסכוני יותר ומאובטח מספיק עבור סוגי נתונים מסוימים. ההחלטה הנכונה תלויה ברגישות, זמן השהייה, נפח, צורכי אינטגרציה, דרישות רגולטוריות, נכסי תפעול פנימיים ועצמאות אסטרטגית. אין לבחור בהפעלה מקומית כסמל סטטוס, אלא כתוצאה של ניתוח סיכונים ועלויות.
בינה מלאכותית ארגונית אמיתית כוללת את המודל, שכבת ההקשר והאינטגרציה, ממשל, בקרות גישה, לוגיקת תהליכים, בדיקות, ניטור ומודל תפעולי עם אחריות מוגדרת בבירור. היא כוללת גם מבנה מסחרי שהופך את סיכוני פיתוח העלויות והביצועים לשקופים. מודל פרטי יכול להיות חלק מארכיטקטורה זו, אך הוא אינו מחליף אותה. המבחן המכריע אינו היכן המודל לבדו פועל, אלא האם המערכת כולה שולטת, משפרת באופן מאמת ומשפרת כלכלית תהליך עסקי.
הבחנה זו מגנה גם מפני מורכבות טכנית מיותרת. לא כל מקרה שימוש דורש מודל גדול, ולא כל משימה היא גנרטיבית. שיטות חיפוש קלאסיות, כללים, מודלים סטטיסטיים או אוטומציה של תהליכים יכולים להיות חסכוניים יותר, יציבים יותר וקלים יותר לבדיקה. ארכיטקטורת ארגון בוגרת פירושה פריסת בינה מלאכותית גנרטיבית רק כאשר יכולתה להתמודד עם מידע לא מובנה ושפה משתנה מייצרת ערך מוסף מוכח.
יישום מהיר דורש מגבלות נוקשות, לא הבטחות גדולות
מקרה שימוש ראשוני מוגדר היטב במערכות קיימות אמור להוביל לתוצאות כמעט-ייצוריות תוך שבועות ולא תוך רבעונים רבים. אין זה אומר שניתן להשלים טרנספורמציה מלאה במהירות. מדובר בתהליך מובנה היטב עם משתמשים מוגדרים בבירור, מקורות נתונים, ספי איכות מדידים ונתיב תפעולי מבוקר. אם אפילו שלב ראשוני זה אורך יותר משישה חודשים, הדבר יכול להצביע על רכיבים סטנדרטיים חסרים, נתונים לא ברורים, היקף גדול מדי או ארכיטקטורת אינטגרציה שנבנתה מאפס.
עם זאת, אין לבלבל בין מהירות לבין כניסה מהירה לייצור. אב טיפוס משכנע רק מדגים שמודל יכול לייצר פלט שמיש בתנאים נוחים. יישום תפעולי חייב להתחשב באירועים נדירים, מסמכים מיושנים, נתונים סותרים, שינויי גישה, כשלים וקלט זדוני. התקפות הזרקה מהירות, בפרט, יכולות לנסות לעקוף הוראות מערכת באמצעות תוכן מסמכים או אתרי אינטרנט. לכן, מגבלות טכניות, אימות תוכן, הרשאות נפרדות ובדיקות עם תרחישי אירועים מציאותיים הם חיוניים.
תהליך יישום הגיוני מתחיל בבעיה מדידה, לא במודל מועדף. לאחר מכן, מוגדרים זרימות נתונים, תפקידי משתמשים, סיכוני שגיאות ומינוף כלכלי. לאחר מכן מתקיים פרויקט פיילוט מוגבל עם זרימות עבודה אמיתיות, בסיס להשוואה וקריטריונים ברורים לסיום. קנה מידה מתרחש רק לאחר שהוכחו איכות, קבלה, אבטחה והשפעת התהליך. גישה מדורגת זו מפחיתה עלויות שקועות ומונעת מימון של ניסוי אטרקטיבי מבחינה טכנית במשך שנים ללא ערך עסקי מוכח.
ניהול שינויים הוא גם קריטי. על העובדים להבין למה המערכת מתאימה, היכן טמונות מגבלותיה וכיצד לדווח על שגיאות. אסור לפגוע בערכה של מומחיות בשקט באמצעות אוטומציה כביכול. התוצאות הטובות ביותר מתקבלות לעתים קרובות כאשר עובדים מנוסים מעורבים במקרי הערכה, חריגים ולולאות משוב. בדרך זו, תיקון אישי הופך לתהליך ארגוני לומד, גם אם המודל הבסיסי עצמו אינו לומד באופן קבוע מכל שיחה.
ארבעה קריטריוני בדיקה מפרידים בין פלטפורמות לבין צ'אטבוטים שעברו ארוז מחדש
השאלה המרכזית הראשונה היא האם המערכת כבר מכירה את החברה במידה הנדרשת, או שמא על המשתמשים לשחזר את ההקשר עבור כל עסקה. לכן, הדגמה משמעותית משתמשת בנתונים, בטרמינולוגיה ובהרשאות מהעולם האמיתי של החברה עצמה במקום במסד נתונים תבניתי שהוכן מראש. ההערכה צריכה לא רק להעריך תשובות נכונות, אלא גם כיצד המערכת מטפלת במידע חסר, סותר ולא תקף. מערכת אמינה חייבת לזהות מגבלות ולהפוך את אי הוודאויות לגלויות.
השאלה השנייה נוגעת לנתיב הנתונים המלא. חברות צריכות לתעד את נתיב העיבוד, מיקומי האחסון, כללי השמירה, קבלני המשנה, אפשרויות הרישום והמחיקה. חשוב לא פחות האם הארכיטקטורה יכולה לשמור נתונים במערכות קיימות ולספק רק קטעים נחוצים. הצהרות לגבי אבטחה אמינות רק כאשר ניתן לקשר אותן לגרסה ותצורה ספציפיים של מוצר.
השאלה השלישית היא מי אחראי מבחינה כלכלית וארגונית לתוצאה המוסכמת. יש להבהיר מה קורה אם לא עומדים בדרישות הדיוק, התפוקה, זמן העיבוד או ערכי יעד אחרים. עצם ההתייחסות לתכנון המוצר העתידי חושפת פער באחריותיות. יחד עם זאת, על החברה להכיר באחריותה שלה, במיוחד בכל הנוגע לאיכות הנתונים, הגדרת התהליך, הכשרת המשתמשים והחלטות מומחים. לא ניתן להעביר את האחריות לתוצאות למיקור חוץ לחלוטין.
השאלה הרביעית נוגעת לעלויות של מקרה השימוש השני. על הספקים להדגים אילו חיבורים, הרשאות, הגדרות, בדיקות ופונקציות תפעוליות נמצאים בשימוש חוזר. חישוב עלויות שקוף עבור תהליך עוקב הוא אינפורמטיבי יותר משקופית פלטפורמה כללית. הוא מגלה האם יתרונות הגודל אמיתיים או שמא כל הרחבה מפעילה פרויקט אינטגרציה חדש. ארבע שאלות אלו מסיטות במכוון את המיקוד משם המודל אל עבר ההקשר, ריבונות נתונים, אחריות ותועלות כלכליות מצטברות.
הארכיטקטורה התפעולית המתאימה היא מבוססת סיכון, לא אידיאולוגית
עבור רוב החברות, אין שיטת פריסה אחת נכונה. גישת תיק עבודות הגיונית יותר מבחינה כלכלית. ניתן לטפל בתוכן ציבורי ובמשימות כתיבה בסיכון נמוך באמצעות עוזרי ארגון סטנדרטיים. שאילתות ידע פנימיות דורשות מחברים מבוקרים, בדיקות הרשאה ואימות מקור. תהליכים עסקיים קריטיים דורשים זרימות נתונים מחמירות יותר, בדיקות ניתנות לשחזור, אישורים אנושיים, ובמידת הצורך, עיבוד ייעודי או מקומי. פעולות אוטומטיות יעילות ביותר דורשות בנוסף כלים מבוקרים היטב, בקרות טרנזקציות ונהלי החזרה למצב אחר.
גישה מדורגת זו מונעת שני מצבים קיצוניים יקרים. הראשון הוא מסירת כל הנתונים לעוזר כללי והסתמכות על סעיפים חוזיים. השני הוא פיתוח ותפעול של כל פונקציית בינה מלאכותית באופן פנימי לחלוטין. בין שני הקצוות הללו נמצאים שירותי ענן מנוהלים, עיבוד אזורי, מפתחות בבעלות הלקוח, נתיבי רשת פרטיים, מופעים ייעודיים, מודלים מקומיים וארכיטקטורות היברידיות. יש לבחור את השילוב שלהם על סמך הסיכון הספציפי.
בחירת המודל יכולה להיות גם מדורגת. מודלים קטנים יותר לרוב זולים יותר, מהירים יותר ומספיקים למשימות מוגדרות באופן צר. מודלים גדולים יותר יכולים להיות טובים יותר עבור שפה מורכבת, תכנון או מסמכים לא עקביים. נתב חכם יכול להקצות משימות למודלים שונים על סמך רגישות, מורכבות ועלות. תנאי הכרחי הוא מערכת הערכה סטנדרטית כדי להבטיח שיתרונות המחיר לא יבוטלו על ידי עלויות גבוהות יותר של שגיאות ועיבוד חוזר.
בטווח הארוך, הנכס החשוב ביותר לא יהיה המודל הבודד בעל הביצועים הגבוהים ביותר, אלא יכולתה של החברה לפרוס מודלים בצורה מאובטחת ומהירה בתהליכי ייצור. יכולת זו כוללת איכות נתונים, ארכיטקטורה מודולרית, מומחיות, ממשל ותרבות של שיפור מדיד. קשה יותר להעתיק אותו מאשר רישיון והוא נשאר בעל ערך גם אם ספק המודל המוביל משתנה.
מפרויקט בינה מלאכותית למערכת הפעלה עסקית
הפרספקטיבה האסטרטגית עוברת מהשאלה איזה עוזר לרכוש לשאלה אילו יכולות תפעוליות יש לפתח. חברות זקוקות למלאי מקוטלג של מקורות נתונים, אחריות מוגדרת בבירור, שיטות גישה סטנדרטיות, תיק מודלים, הליכי הערכה רב פעמיים ותעדוף המבוסס על ערך כלכלי. ללא בסיס זה, צצים כלים מבודדים רבים, שקשה להשוות את יתרונותיהם והסיכונים שלהם מצטברים.
בחירת מקרי השימוש צריכה להתמקד בתהליכים חוזרים, עשירים בנתונים ועתירי חיכוך. מעברים בין פונקציות ומערכות, שבהם עובדים צריכים לחפש, להשוות, להעביר או להסביר מידע, הם אטרקטיביים במיוחד. במצבים אלה, בינה מלאכותית גנרטורה יכולה לפתוח תוכן לא מובנה ולהשלים אוטומציה מסורתית. תהליכים ללא בסיס נתונים ברור, ללא מצב התחלתי מדיד, או עם שיעורי שגיאות גבוהים במיוחד ואפשרויות בקרה מוגבלות פחות מתאימים.
עבור כל מקרה בעל עדיפות, על ההנהלה לגבש השערה כלכלית. השערה זו מתארת איזה צוואר בקבוק יבוטל, איזה מדד ביצועים מרכזי ישתנה, אילו עלויות ייגרמו במלואה, וכיצד ההשפעה תתממש בתפעול. הנחה גרידא של חיסכון בזמן אינה מספיקה. יש להבהיר האם הזמן שיתפנה יאפשר טיפול ביותר מקרים, יקצר את זמני ההמתנה, יעלה את האיכות או ימנע בפועל עלויות כוח אדם ועלויות חיצוניות. רק קשר זה הופך את הפרודוקטיביות הטכנית לתשואה כלכלית.
במקביל, נדרשת החלטה ארכיטקטונית שתסתכל מעבר לפיילוט הראשוני מבלי לבנות באופן מיידי פלטפורמה גדולה מדי. ליבה רזה ומשותפת הכוללת זהות, רישום, גישה למודל, מחברי נתונים והערכה יכולה לגדול בהדרגה. כל יישום חדש צריך לשפר את הליבה הזו וליצור כמה שפחות לוגיקה מותאמת אישית. גישה זו יוצרת יכולת מצטברת במקום אוסף של הדגמות.
החלטת הרכישה בפועל סובבת סביב הדגם
מודלים של בינה מלאכותית הופכים חזקים יותר, זולים יותר ומשולבים עמוק יותר בתוכנות סטנדרטיות. זה מפחית את גורם המבדיל של גישה גרידא. מה שחברות רוכשות או בונות בעצמן בפועל הם הרכיבים המקיפים את המודל: הקשר עסקי, אחסון נתונים מבוקר, אינטגרציה אמינה, החלטות ניתנות למעקב, אחריות ארגונית ועקומת עלויות שהופכת לטובה יותר עם מקרי שימוש נוספים. אלמנטים אלה קובעים האם בינה מלאכותית נותרת כלי פרודוקטיביות עבור עובדים בודדים או מתפתחת ליכולת כלל-ארגונית.
רישיון ארגוני אינו חסר ערך ואינו מספיק למטרה זו. לעתים קרובות הוא מייצג מינימום סביר למשימות כלליות ויכול להפחית את הבינה המלאכותית בצל. עם זאת, עבור תהליכים מוסדרים או קריטיים לעסקים, יש להשלים אותו בארכיטקטורת נתונים, ממשל, תכנון תהליכים ואחריות מדידה לתוצאות. באופן דומה, מודל פרטי לבדו אינו הפתרון. בידוד טכני ללא הקשר ותפיסה תפעולית יוצר רק אי המופעל באופן פרטי.
מקרה השימוש השני מספק את האזהרה החזקה ביותר. אם כל חיבורי הנתונים, הכללים, הבדיקות והאחריות צריכים להיבנות מחדש, ההצלחה הראשונית לא הייתה אפקט פלטפורמה, אלא פרויקט עצמאי. לעומת זאת, אם נעשה שימוש חוזר ברכיבים חיוניים והזמן להפקת תועלת מתקצר, מתחילה כלכלת עסקים אמיתית. הערך טמון אז לא בהדגמה מרהיבה, אלא בתשתית למידה שמשפרת באופן מתמיד תהליכים נוספים בעלויות שוליות נמוכות יותר.
עובדים שכבר הצביעו באמצעות חשבונות פרטיים אינם רק בעיית אבטחה. הם מדגימים את הביקוש הגבוה והסובלנות הנמוכה לכלים גרועים. משימת הנהלת החברה היא לתרגם את הביקוש הזה לחלופה מבוקרת ועדיפה: מערכת שמבינה את העסק, מגנה כראוי על נתונים רגישים, מטפלת בשגיאות באחריות, ואינה מתחילה מאפס בפעם הבאה שהיא תהיה בשימוש. כל דבר פחות מזה נשאר צ'אטבוט עם פרטי התחברות - שימושי, לעתים קרובות מרשים, אך עדיין לא בינה מלאכותית ארגונית.
ייעוץ - תכנון - יישום

Konrad Wolfenstein
אשמח לשמש כיועץ האישי שלך.
ניתן ליצור איתי קשר בכתובת wolfenstein∂xpert.digital או
פשוט התקשרו אליי למספר +49 7348 4088 965 .


