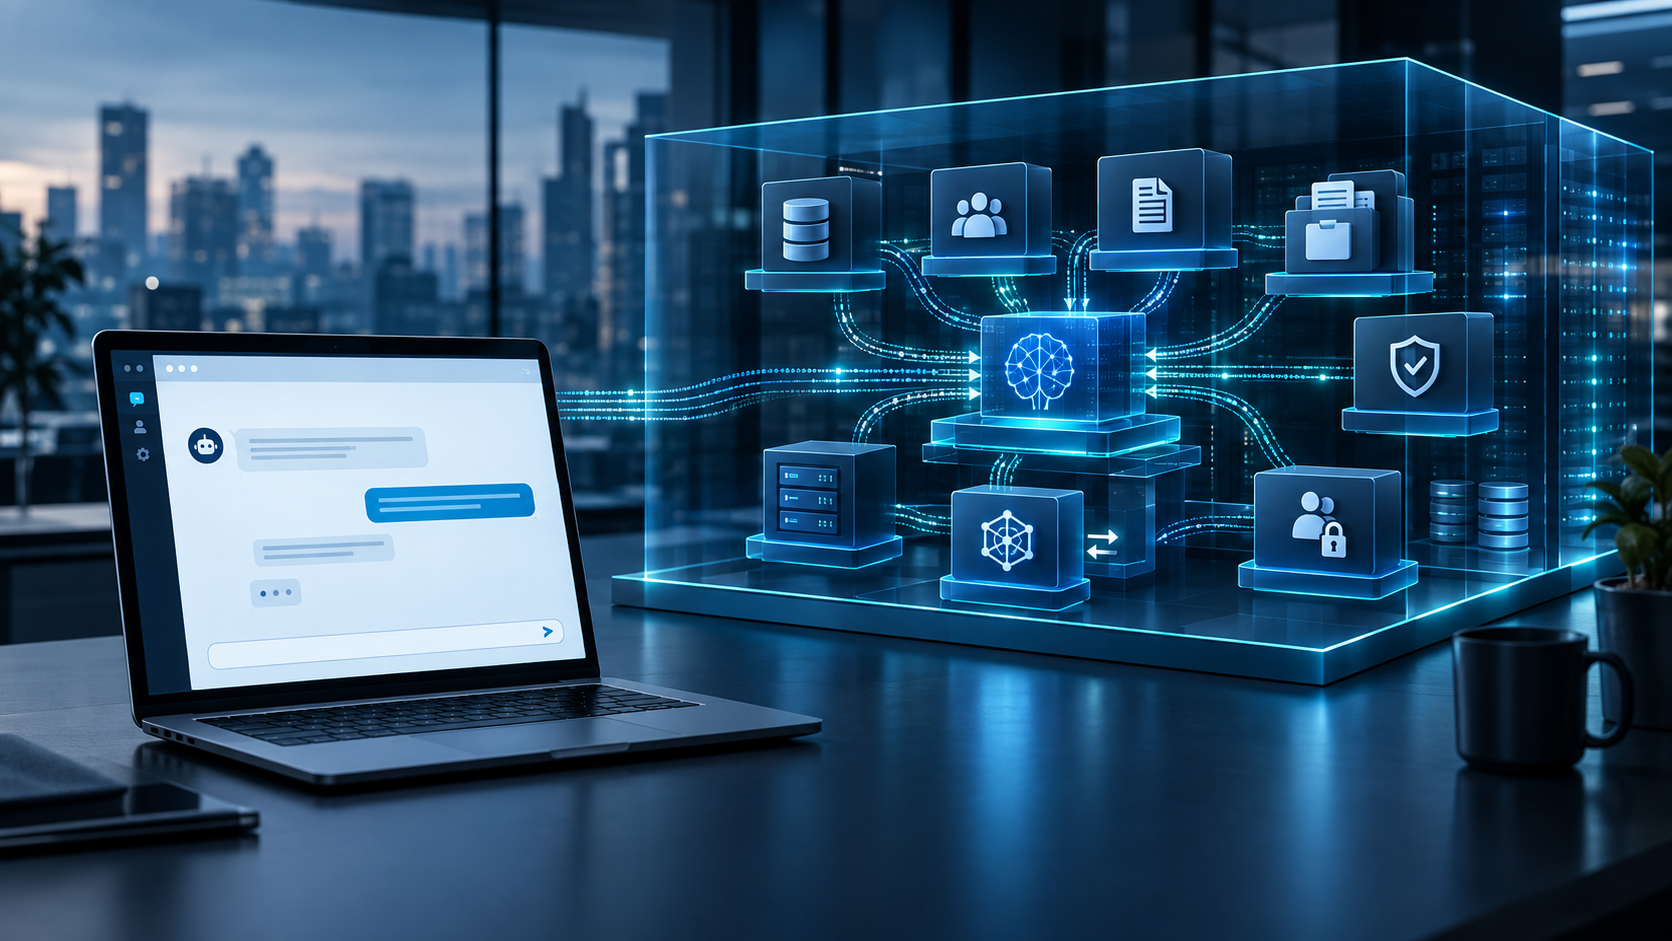
L'IA d'entreprise commence là où le chatbot s'arrête – image créative sur le sujet, mettant en avant l'IA : Xpert.Digital
De la licence à la responsabilité : comment les entreprises devraient repenser leur stratégie en matière d'IA
Voici comment les entreprises réduisent l'écart entre les espoirs placés en l'IA et la réalité
L'importance d'une couche de contexte pour une IA d'entreprise efficace
Dans le paysage numérique actuel, l'intégration de l'intelligence artificielle (IA) aux processus métier revêt une importance croissante. Cependant, de nombreuses entreprises sont confrontées au problème de la dépendance de leurs employés à des services d'IA privés et non autorisés, une pratique connue sous le nom d'IA fantôme. Cette situation révèle un décalage important entre les solutions proposées par les entreprises et les besoins réels des utilisateurs en milieu professionnel. Si les licences d'entreprise pour les outils d'IA établis constituent une première étape, elles ne suffisent pas à elles seules pour répondre aux exigences complexes et aux spécificités de chaque entreprise. Une véritable IA générative d'entreprise requiert une architecture système bien conçue, englobant les modèles, l'accès aux données, la logique des processus et la responsabilisation. Cet article explore les aspects essentiels que les entreprises doivent prendre en compte pour exploiter pleinement le potentiel de l'IA et lutter efficacement contre l'IA fantôme.
En lien avec ceci :
La simple distribution de licences ne numérise pas l'entreprise – elle numérise son problème d'IA occulte
Dans de nombreuses entreprises, l'avenir de l'intelligence artificielle générative ne se décide pas lors d'une réunion stratégique, mais plutôt dans un moment anodin au travail : un employé copie un contrat client, un calcul ou un courriel interne dans un service d'IA public, car cet outil privé lui semble plus rapide, plus intuitif et plus performant que la solution officielle de l'entreprise. Du point de vue de l'employé, il ne s'agit souvent pas d'une violation délibérée des règles, mais d'une réaction pragmatique face à des processus inefficaces. Du point de vue de l'entreprise, cela révèle un décalage dangereux entre l'approbation technique et l'utilisation réelle.
Le réflexe courant de combler cette lacune en achetant une licence d'entreprise pour un assistant IA reconnu s'avère insuffisant. Une telle licence peut certes offrir des garanties importantes, des fonctions d'administration et des engagements contractuels. Cependant, elle ne transforme pas automatiquement un assistant généraliste en un système capable de comprendre les produits, les clients, les contrats, les rôles, les procédures d'approbation et les flux de travail de l'entreprise. Elle ne répond pas non plus automatiquement à des questions telles que : où sont traitées les données sensibles ? Qui est responsable des résultats erronés ? Ou encore, est-il possible de développer des processus supplémentaires à un coût marginal raisonnable après la phase initiale ?.
La thèse économique centrale est donc la suivante : une véritable IA générative d’entreprise ne se résume pas à un simple modèle ou à une fenêtre de discussion ornée du logo de l’entreprise. Il s’agit d’un système opérationnel composé de modèles, de points d’accès aux données, de contexte, d’identités, de permissions, de logique de processus, de contrôles qualité, de responsabilités et d’une architecture de coûts robuste. La véritable valeur réside non pas dans l’accès à l’IA, mais dans son intégration maîtrisée au sein de l’organisation. C’est précisément en cela qu’un outil métier productif se distingue d’un produit grand public pratique nécessitant une authentification professionnelle.
Une licence d'exploitation est une base, mais pas encore un bâtiment
Les versions professionnelles des principaux assistants IA résolvent des problèmes concrets. Généralement, les fournisseurs s'engagent à ne pas utiliser par défaut les données métier pour entraîner leurs modèles. Parmi les fonctionnalités supplémentaires figurent la gestion centralisée des utilisateurs, l'authentification unique, le contrôle d'accès basé sur les rôles, la journalisation, le chiffrement, les rapports d'utilisation, les accords de traitement des données et des durées de conservation partiellement configurables. De plus, les droits d'accès, les politiques et les mécanismes de sécurité existants peuvent être exploités au sein des plateformes bureautiques établies. Pour de nombreuses organisations, cela représente une amélioration significative par rapport aux comptes personnels.
L'erreur ne réside pas dans l'achat de telles licences, mais dans la confusion entre leur portée de protection et une solution d'entreprise complète. Un engagement à ne pas utiliser les données client pour l'entraînement général des modèles ne répond qu'à une seule des nombreuses questions relatives aux données. Le lieu de traitement, le stockage des entrées et sorties, la durée de conservation, le recours à des sous-traitants, la gestion de la télémétrie et les juridictions applicables restent autant de points à éclaircir. De plus, le produit de messagerie instantanée, l'interface de programmation, l'assistant bureautique intégré et l'instance cloud spécifique au client présentent souvent des différences importantes. Une licence générique basée sur la marque est donc insuffisante, tant du point de vue commercial que réglementaire.
Avant tout, la licence elle-même est dépourvue de mémoire institutionnelle. Un modèle ne connaît pas automatiquement la signification précise qu'a l'entreprise d'un nom de produit, l'historique d'une réclamation, ni quel système client fait foi pour un processus donné. Il ne tient pas compte des exceptions informelles ni de la matrice d'approbation et ne peut déterminer de manière autonome si une politique obsolète ou sa version ultérieure est applicable. L'accès au modèle est payant ; toutefois, sa fiabilité opérationnelle doit être développée, testée et maintenue en permanence.
Shadow AI est une évaluation du marché réalisée par les employés de l'entreprise
L'utilisation de comptes d'IA privés est souvent perçue comme une simple question de discipline ou de formation. C'est une vision trop simpliste. Lorsque les employés ont recours à des outils non autorisés malgré les interdictions, ils influencent involontairement le marché : la solution autorisée se révèle moins performante en termes de rapidité, d'ergonomie, de qualité du modèle et d'intégration pratique aux processus de travail. Les interdictions peuvent certes réduire les risques à court terme, mais elles n'éliminent pas la demande pour une meilleure solution.
L'ampleur du problème est considérable. Selon les rapports, d'ici 2026, 47 % des employés utilisant l'IA générative au travail utiliseront encore des comptes personnels non gérés. Parallèlement, le nombre d'incidents recensés concernant le transfert de données sensibles vers des applications d'IA a doublé. En moyenne, 223 violations de ce type ont été enregistrées par organisation et par mois ; pour les entreprises les plus touchées, ce chiffre était bien plus élevé. Les données personnelles, financières et médicales réglementées représentaient une part particulièrement importante de ces violations. Ces indicateurs ne prennent en compte que les incidents visibles et ne reflètent probablement pas pleinement l'usage réel.
D'un point de vue économique, l'informatique centralisée se trouve donc en concurrence avec une alternative gratuite ou financée par le secteur privé. Cette alternative présente de faibles barrières à l'entrée, une expérience utilisateur optimale et constitue souvent le modèle le plus récent. Une solution interne ne s'impose pas uniquement par sa conformité, mais seulement si elle est au moins aussi pratique et apporte une valeur ajoutée à l'entreprise. Elle doit permettre de trouver les informations pertinentes, être intégrée aux applications existantes, éviter les duplications inutiles et contextualiser les réponses dans le cadre du processus de travail. Une adoption durable ne s'obtient pas par la contrainte, mais par des avantages accrus pour un effort personnel moindre.
Cela ne signifie pas que les contrôles techniques sont inutiles. La prévention des pertes de données, les restrictions client, les contrôles du navigateur, la journalisation et des règles d'utilisation claires demeurent essentiels. Cependant, leur efficacité s'accroît considérablement lorsqu'une alternative performante est également disponible. La réponse appropriée de la direction ne consiste donc pas seulement à bloquer l'IA parallèle, mais à analyser ses causes profondes : à quelles tâches les employés l'utilisent-ils ? Quels systèmes autorisés présentent des défaillances ? Quelles inefficacités poussent les utilisateurs à recourir à des comptes privés ? Ces réponses permettront d'établir une liste de priorités réaliste pour l'IA en entreprise.
Le savoir-faire de l'entreprise ne se crée pas dans une fenêtre de chat
Les assistants IA généralistes débutent leur processus principalement à partir du contexte fourni par l'utilisateur ou déduit par le produit de quelques interactions précédentes. Cette neutralité est souvent utile pour les tâches personnelles. Cependant, elle devient un risque dans un contexte professionnel dès lors que les décisions dépendent d'informations historiques, contractuelles ou spécifiques au client. Par exemple, une réponse fiable à une demande d'indemnisation ne peut être obtenue qu'en combinant l'historique des sinistres, la version de la police, la correspondance, les exigences réglementaires et l'état de traitement. Un seul contrat téléchargé est insuffisant à cet effet.
Les connaissances nécessaires sont rarement centralisées. Elles sont dispersées entre les systèmes ERP, CRM, systèmes de gestion documentaire, systèmes de billetterie, entrepôts de données, messageries électroniques, applications spécialisées et fichiers personnels. De plus, les identifiants, les orthographes, les versions de données et les responsabilités varient. Un client peut être référencé sous différents noms dans trois systèmes ; un code produit peut avoir acquis une signification différente suite à une fusion ; une politique peut rester accessible formellement tout en étant techniquement obsolète. Le modèle de langage ne peut résoudre ces contradictions à lui seul. Sans correspondance fiable, il ne peut, au mieux, produire qu’une synthèse linguistiquement convaincante de données incohérentes.
Par conséquent, la fourniture de contexte est avant tout une tâche d'intégration et de gestion des données. La génération augmentée par la recherche, c'est-à-dire la fourniture ciblée de contenu pertinent au moment d'une requête, est une méthode importante, mais non une solution complète. Les métadonnées, le versionnage, la vérification d'identité, les contrôles d'autorisation, la priorité des sources, les périodes de validité et les règles de gestion des informations contradictoires sont également nécessaires. Plus le système est conçu pour agir plutôt que pour simplement répondre, plus les contrôles transactionnels et une gouvernance système clairement définie deviennent essentiels.
Un test simple permet d'évaluer la maturité de l'outil : on lui pose une question dont la réponse correcte ne requiert que des connaissances internes à l'entreprise. S'il fournit une réponse générale, assurée et erronée, il s'agit en réalité d'un chatbot ayant accès aux ressources de l'entreprise. S'il se contente de demander un fichier, c'est un chatbot doté d'une fonction de téléchargement. Ce n'est que lorsqu'il accède aux systèmes pertinents de manière légitime, transparente et en temps réel, qu'il prend en compte l'incertitude et qu'il replace la réponse dans le contexte de l'entreprise, qu'il révèle une véritable intelligence d'entreprise.
La couche contextuelle devient le stock de capital productif
L'élément architectural crucial se situe entre le modèle et les opérations métier. Cette couche peut être décrite comme une plateforme de contexte, un réseau de connaissances ou une couche d'intégration et d'orchestration. Son nom importe moins que sa fonction : elle met en correspondance les entités, connecte les sources de données, vérifie les autorisations, fournit des définitions, contrôle les outils et documente le déroulement d'une réponse ou d'une action. Idéalement, ce travail ne devrait pas être entrepris pour chaque cas d'usage, mais plutôt conçu comme un module d'architecture d'entreprise réutilisable.
D'un point de vue économique, cette couche s'apparente à un stock de capital productif. La connexion initiale à une base de données contractuelles, l'attribution initiale des identités clients ou la première mise en œuvre d'une logique d'approbation engendrent des coûts initiaux élevés. Toutefois, une fois ces éléments standardisés, d'autres cas d'usage peuvent s'y appuyer. Le coût marginal des deuxième, troisième et cinquième utilisations devrait diminuer. Cet effet à lui seul justifie une stratégie de plateforme : une partie de l'investissement devient utilisable non seulement pour un projet, mais aussi pour un nombre croissant de processus futurs.
Cet effet de réutilisation ne se produit toutefois pas automatiquement. De nombreuses plateformes, en apparence, se composent d'interfaces, d'invites et de solutions personnalisées propres à chaque projet. Chaque nouvelle application doit donc être analysée, intégrée et sécurisée de manière inédite. La courbe des coûts reste linéaire, tandis que des dépendances supplémentaires apparaissent. Par conséquent, un véritable test de maturité consiste à déterminer quels composants spécifiques du premier cas d'utilisation peuvent être réutilisés dans le second sans avoir à les reconstruire. Parmi les composants réutilisables, on peut citer les services d'identité, les connecteurs, le contrôle d'accès, les catalogues de données, les procédures d'évaluation, la journalisation, l'accès aux modèles et les approbations humaines standardisées.
La couche de contexte est stratégiquement plus importante que l'adoption d'un modèle unique. Les modèles évoluent rapidement, les prix fluctuent et différentes tâches tirent parti de différentes forces. Par conséquent, les entreprises doivent pouvoir changer de modèle de manière contrôlée ou en utiliser plusieurs en parallèle. Cependant, ce changement n'est pas sans conséquences : le comportement des invites, les formats de sortie, les filtres de sécurité, les fenêtres de contexte et les profils de performance diffèrent. Une bonne architecture réduit ces coûts de changement grâce à l'abstraction, à des interfaces standardisées et à des tests reproductibles, plutôt que de donner l'illusion d'une interchangeabilité totale.
La souveraineté des données englobe bien plus que la simple exclusion des formations
Le débat public s'est longtemps concentré sur l'utilisation des données d'entrée pour l'entraînement d'un modèle. Bien que cette question soit importante pour les entreprises, elle reste trop restrictive. L'ensemble de la chaîne de stockage et de traitement est crucial : où les données d'entrée sont-elles traitées ? Quelles parties d'un document sont transférées ? Où sont stockés l'historique des conversations, les caches, les journaux et les représentations vectorielles ? Pendant combien de temps sont-ils conservés ? Quels sous-traitants sont des interlocuteurs techniques ? Quel cadre juridique s'applique ? Les administrateurs peuvent-ils consulter, exporter et supprimer du contenu ? Comment les sauvegardes sont-elles gérées ?
Un service marketing peut, dans certaines circonstances, utiliser de manière responsable un document traité en externe. Des normes différentes s'appliquent aux données non publiées, aux secrets commerciaux, aux données de santé, aux affaires juridiques ou aux infrastructures critiques. Le niveau de risque ne doit donc pas reposer uniquement sur l'outil utilisé, mais plutôt sur la nature des données, les mesures prises, les dommages potentiels et le niveau de contrôle humain. Un même modèle pourrait présenter un faible risque lors de la réécriture d'un communiqué de presse et un risque élevé lors du traitement automatisé d'un prêt ou d'une réclamation.
Une architecture robuste minimise les déplacements de données. L'information reste autant que possible au sein des systèmes existants ; seul le contexte nécessaire à la tâche est fourni, dans le respect des règles d'accès en vigueur. Les requêtes sont autorisées au cas par cas, les champs sensibles sont masqués lorsque cela est approprié et les résultats sont classés selon leur contenu. Pour les processus particulièrement critiques, un traitement régional, des instances dédiées, des environnements informatiques confidentiels ou un déploiement local peuvent être recommandés. Cependant, une exploitation entièrement en interne n'est ni automatiquement plus sécurisée ni plus économique, car l'exploitation, les correctifs, la surveillance, la maintenance des modèles et le personnel spécialisé engendrent des coûts importants.
La formule permettant d'appliquer le modèle aux données décrit donc un principe judicieux, mais ne doit pas être perçue comme une simplification technique. Même avec des solutions fédérées ou connectées localement, des extraits, des intégrations ou des métadonnées peuvent accéder à des services externes. Une analyse documentée des flux de données au niveau des composants est essentielle. Ce n'est que lorsqu'il est possible de démontrer, pour chaque étape, quelles données sont acheminées, où et comment elles sont protégées que la souveraineté des données peut être évaluée de manière fiable.
La réglementation fait de la traçabilité un facteur économique
Dans les secteurs réglementés, la sécurité des flux de données n'est pas un idéal abstrait. Les institutions financières, soumises à la réglementation européenne en matière de résilience opérationnelle numérique, doivent évaluer systématiquement les risques liés aux technologies de l'information et de la communication, ainsi qu'aux prestataires tiers. Les accords de confidentialité, le secret professionnel, les lois sur la protection des données et les réglementations sectorielles imposent également aux entreprises de pouvoir expliquer leurs activités de traitement, leurs responsabilités et les mesures de contrôle mises en place. Une application d'IA dont la qualité de réponse est convaincante, mais dont le parcours des données n'est pas auditable, ne peut satisfaire aux exigences des tests d'acceptation opérationnelle.
Avec la législation européenne sur l'IA, la gouvernance systématique prend une importance accrue. Une grande partie du cadre réglementaire européen est en vigueur depuis août 2026, tandis que les obligations spécifiques à certains systèmes à haut risque entreront en vigueur progressivement. Il ne s'agit pas d'une interdiction générale de l'IA générative pour les entreprises, mais plutôt d'une classification rigoureuse fondée sur le domaine d'application et le rôle. Un modèle général, un système spécialisé qui en découle et l'entreprise qui l'utilise peuvent chacun avoir des obligations différentes. La transparence, la documentation, la supervision humaine, la qualité et l'exactitude des données, la cybersécurité et la traçabilité sont particulièrement cruciales pour les applications à haut risque.
La conformité n'est pas qu'une question de coût. Une architecture de contrôle réutilisable peut accélérer la mise sur le marché, car chaque projet n'a pas besoin de redéfinir ses règles. Des classes de risques standardisées, des modèles approuvés, une documentation technique, des modèles d'évaluation et des niveaux d'approbation définis réduisent l'incertitude. La gouvernance passe ainsi d'une fonction de contrôle en aval à une infrastructure productive. L'avantage économique est particulièrement évident lors des deuxième et troisième déploiements, lorsque les composants testés peuvent être réutilisés.
Les entreprises doivent également faire la distinction entre le risque lié au modèle et le risque lié au processus. Un modèle peut être techniquement performant, tandis qu'un processus mal conçu continue d'utiliser des sources de données erronées, présente des responsabilités floues ou ne permet pas de corriger les erreurs. Inversement, un modèle limité peut s'avérer très utile dans un processus rigoureux et bien contrôlé. Par conséquent, la qualité de l'architecture globale est plus souvent le facteur déterminant de la viabilité réglementaire et économique que les performances maximales du modèle lors de tests généraux.
🤖🚀 Plateforme d'IA gérée : Accédez à des solutions d'IA plus rapides, plus sûres et plus intelligentes avec UNFRAME

Plateforme d'IA gérée - Image : Xpert.Digital
Vous découvrirez ici comment votre entreprise peut mettre en œuvre des solutions d'IA personnalisées rapidement, en toute sécurité et sans barrières à l'entrée élevées.
Une plateforme d'IA managée est votre solution clé en main pour l'intelligence artificielle. Fini les technologies complexes, les infrastructures coûteuses et les longs processus de développement : vous bénéficiez d'une solution clé en main, adaptée à vos besoins, fournie par un partenaire spécialisé – souvent en quelques jours seulement.
Les principaux avantages en un coup d'œil :
⚡ Mise en œuvre rapide : De l’idée à l’application prête à l’emploi en quelques jours, et non en plusieurs mois. Nous fournissons des solutions pratiques qui créent une valeur ajoutée immédiate.
🔒 Sécurité maximale des données : Vos données sensibles restent chez vous. Nous garantissons un traitement sécurisé et conforme à la réglementation, sans partage de données avec des tiers.
💸 Aucun risque financier : vous ne payez que pour les résultats. Les investissements initiaux importants en matériel, logiciels ou personnel sont totalement éliminés.
🎯 Concentrez-vous sur votre cœur de métier : nous prenons en charge l’intégralité de la mise en œuvre technique, de l’exploitation et de la maintenance de votre solution d’IA.
📈 Évolutif et à l'épreuve du temps : votre IA évolue avec vous. Nous assurons une optimisation et une évolutivité continues, et adaptons les modèles avec souplesse aux nouveaux besoins.
Plus d'informations ici :
Du projet d'IA au système d'exploitation d'entreprise
La responsabilité ne doit pas disparaître entre l'octroi de licences et le conseil
Les services d'IA destinés aux consommateurs sont vendus comme des outils. Les fournisseurs soulignent, à juste titre, que les dépenses peuvent être inexactes et que les utilisateurs doivent vérifier les résultats. Ce modèle se comprend pour un marché de masse à bas coût. Cependant, dans les applications professionnelles, un déficit de responsabilité apparaît dès lors que ces mêmes dépenses atteignent les clients, influencent les rapports réglementaires ou déclenchent des processus financiers. Le fournisseur d'accès vend la possibilité d'utiliser le service, mais n'assume généralement pas la responsabilité du résultat du processus métier spécifique.
Même le modèle d'intégration traditionnel peut laisser subsister cette lacune. Un prestataire de services analyse, développe et intègre le système pendant des mois, facture le temps passé et les matériaux utilisés, puis livre un système. Le contrat peut être formellement exécuté, même si l'outil est mal accepté au quotidien, génère trop d'erreurs ou n'apporte aucune amélioration mesurable des processus. D'un côté, l'accès a été vendu ; de l'autre, la main-d'œuvre. Dans les deux cas, personne n'est nécessairement tenu financièrement au résultat convenu.
L'IA d'entreprise exige donc une répartition claire des responsabilités. Les unités opérationnelles, l'informatique, la sécurité de l'information, la protection des données, la gestion des risques et les fournisseurs doivent savoir qui est responsable de la qualité des données, qui sélectionne les modèles, qui fixe les limites, qui approuve les dépenses et qui prend les décisions en cas de dysfonctionnement. Pour les actions automatisées, la traçabilité, les options de révocation et des procédures d'escalade clairement définies sont essentielles. Le contrôle humain n'est efficace que si l'examinateur dispose du temps, de l'expertise et des informations nécessaires ; un simple clic réduit le contrôle humain à une simple formalité.
Les modèles de rémunération axés sur les résultats peuvent améliorer la motivation, mais ne constituent pas une solution miracle. Ils ne fonctionnent que si les résultats sont mesurables, attribuables et protégés contre toute manipulation. Pour un processus clair, comme la réduction des délais de traitement, la diminution des taux d'erreur ou l'augmentation du nombre de dossiers résolus, des éléments liés à la performance peuvent être définis. L'attribution est plus complexe pour les tâches stratégiques nécessitant une expertise pointue. Un modèle hybride est souvent conseillé ; il comprend un salaire de base, des indicateurs de qualité et d'utilisation, ainsi qu'une composante liée aux résultats commerciaux convenus.
Le deuxième cas d'utilisation met en lumière l'économie des plateformes
De nombreux processus de sélection se concentrent sur un premier cas d'utilisation volontairement simple. La synthèse de documents, la rédaction d'e-mails, la description d'un fichier téléchargé ou la génération de variantes de texte conviennent parfaitement aux modèles généralistes, car le contexte est quasiment disponible dès l'invite de commande. Ces tâches démontrent les capacités linguistiques du modèle, mais ne reflètent guère la maturité d'une plateforme d'entreprise. Elles peuvent souvent être prises en charge avec seulement quelques licences et un effort de mise en œuvre raisonnable.
Le second cas d'utilisation est plus instructif. Si le même système doit rapprocher les factures fournisseurs des contrats, il nécessite l'accès à l'archive des contrats, au système ERP, à la matrice d'approbation, aux données de référence et aux règles d'exception. Il doit consolider les différentes désignations, expliquer les divergences, respecter les autorisations et remonter les problèmes au rôle approprié en cas d'incertitude. Ici, l'accent est mis sur l'intégration et la logique des processus plutôt que sur le modèle. Ce cas d'utilisation permet de vérifier si l'architecture précédemment établie est effectivement réutilisable.
Une plateforme mérite son nom lorsque le deuxième déploiement s'avère relativement plus rapide et moins coûteux, et que cet effet se renforce avec les applications suivantes. Si chaque nouveau cas d'usage reste aussi onéreux que le précédent, aucune synergie significative n'est réalisée. Dans ce cas, l'entreprise se retrouve avec une licence et une liste d'attente pour des services de conseil. Par conséquent, le critère commercial le plus important est d'obtenir des estimations fiables des coûts et des délais pour les deuxième et troisième déploiements avant même de décider du premier.
Cette perspective modifie également le calcul des investissements. Il ne faut pas imputer l'intégralité des coûts de la plateforme au cas d'usage initial si des composants importants sont réutilisés ultérieurement. À l'inverse, il est malhonnête de considérer une réutilisation future vague comme un avantage sans préciser les processus de suivi, les responsables et les budgets. Un calcul rigoureux distingue les investissements initiaux dans la plateforme, les développements spécifiques au cas d'usage, les coûts récurrents liés au modèle et à l'infrastructure, ainsi que les coûts de surveillance, d'assurance qualité et de gestion du changement. Ce n'est qu'à cette condition qu'il est possible de déterminer une dépense totale réaliste sur plusieurs années.
Les coûts sont rarement imputables uniquement aux appels de modèles
En matière d'IA générative, l'attention se porte souvent sur les frais de licence ou le coût des jetons. Ces coûts sont visibles, mais rarement prépondérants dans les applications d'entreprise complexes. Les dépenses supplémentaires comprennent le nettoyage des données, les interfaces, la gestion des identités, les audits de sécurité, les jeux de données d'évaluation, la surveillance, le temps des spécialistes, la formation, le support et les ajustements continus. L'absence de clarté concernant la propriété des données, les solutions personnalisées spécifiques à chaque projet et les reprises manuelles dues à une qualité inégale s'avèrent particulièrement onéreuses.
Les études de marché révèlent la tension entre des attentes élevées et une capacité de déploiement limitée. Dans une enquête internationale menée auprès de 2 000 dirigeants d'entreprise, seul un quart environ des initiatives d'IA ont atteint le retour sur investissement escompté ; seulement 16 % ont été déployées à l'échelle de l'entreprise. Parallèlement, 72 % considèrent les données propriétaires de l'entreprise comme essentielles à la valeur de l'IA générative, et 68 % estiment qu'une architecture de données intégrée à l'échelle de l'entreprise est indispensable. Ces chiffres ne constituent pas des vérités absolues, mais ils illustrent que l'accès aux modèles à lui seul ne garantit ni le déploiement à grande échelle ni le retour sur investissement.
Même les taux d'échec très élevés observés dans les études doivent être interprétés avec nuance. Une analyse de 2025, largement citée, concluait que 95 % des initiatives examinées n'avaient généré aucun avantage financier mesurable. La méthodologie, la taille de l'échantillon et la définition du succès limitent la généralisation de cette conclusion ; de plus, de nombreux projets étaient encore à leurs débuts. Néanmoins, ce résultat met en évidence une tendance réelle : les outils génériques peuvent accroître la productivité individuelle, mais ce gain de temps ne se traduit pas automatiquement par une baisse des coûts, une augmentation du débit ou des revenus supplémentaires.
Pour l'évaluation des investissements, les indicateurs de processus sont donc plus importants que les indicateurs d'activité. Le nombre d'utilisateurs, d'invites ou de textes générés mesure l'acceptation, et non la réussite économique. Plus pertinents sont le temps de traitement, le coût par transaction, le taux d'erreur, l'effort de retouche, le débit, le délai de gestion des créances, le taux de résolution et la satisfaction client. Les gains de productivité ne se traduisent par un résultat financier que si l'entreprise redéploie des ressources, élimine les goulots d'étranglement, vend des services supplémentaires ou réalise des économies.
Un modèle privé n'est pas encore une IA d'entreprise
Les termes « IA privée », « modèle de langage privé » et « IA d'entreprise » sont souvent utilisés indifféremment. Un modèle privé décrit principalement les conditions techniques et contractuelles de son fonctionnement et les personnes qui y ont accès. Il peut s'exécuter localement, dans un environnement cloud dédié ou via un service hautement sécurisé. Cependant, cette caractéristique ne renseigne guère sur la capacité du système à comprendre les données métier pertinentes, à appliquer correctement les autorisations ou à prendre en charge un processus de manière fiable.
Une entreprise peut gérer un modèle entièrement en interne et se retrouver malgré tout avec des données cloisonnées, une qualité de recherche médiocre, des responsabilités floues et un manque de suivi des performances. À l'inverse, une solution cloud soigneusement configurée peut s'avérer plus économique et suffisamment sécurisée pour certaines catégories de données. Le choix optimal dépend de la sensibilité des données, de la latence, du volume, des besoins d'intégration, des exigences réglementaires, des ressources opérationnelles internes et de l'indépendance stratégique. L'exploitation sur site ne doit pas être un choix symbolique, mais bien le fruit d'une analyse des risques et des coûts.
Une véritable IA d'entreprise englobe le modèle, le contexte et la couche d'intégration, la gouvernance, les contrôles d'accès, la logique des processus, les tests, la surveillance et un modèle opérationnel aux responsabilités clairement définies. Elle comprend également une structure commerciale qui rend transparents les risques liés aux coûts, au développement et aux performances. Un modèle privé peut faire partie de cette architecture, mais ne la remplace pas. Le critère essentiel n'est pas l'exécution du modèle seul, mais la capacité du système dans son ensemble à contrôler, améliorer de manière vérifiable et optimiser économiquement un processus métier.
Cette distinction permet également d'éviter une complexité technique inutile. Tous les cas d'usage ne nécessitent pas un modèle complexe, et toutes les tâches ne sont pas génératives. Les méthodes de recherche classiques, les règles, les modèles statistiques ou l'automatisation des processus peuvent s'avérer plus rentables, plus stables et plus faciles à tester. Une architecture d'entreprise mature implique de déployer l'IA générative uniquement lorsque sa capacité à traiter des informations non structurées et un langage variable génère une valeur ajoutée tangible.
Une mise en œuvre rapide exige des limites strictes, et non de grandes promesses
Un cas d'usage initial bien défini sur les systèmes existants devrait permettre d'obtenir des résultats quasi opérationnels en quelques semaines plutôt qu'en plusieurs trimestres. Cela ne signifie pas pour autant qu'une transformation complète puisse être réalisée rapidement. Il s'agit d'un processus rigoureux, structuré et comprenant des utilisateurs, des sources de données, des seuils de qualité mesurables et un plan d'action opérationnel maîtrisé. Si même cette phase initiale prend plus de six mois, cela peut indiquer l'absence de composants standard, des données imprécises, un périmètre d'application trop vaste ou une architecture d'intégration entièrement nouvelle.
Il ne faut toutefois pas confondre rapidité et précipitation dans la mise en production. Un prototype convaincant démontre seulement qu'un modèle peut produire un résultat exploitable dans des conditions optimales. La mise en œuvre opérationnelle doit prendre en compte les événements rares, les documents obsolètes, les données contradictoires, les modifications d'accès, les pannes et les entrées malveillantes. Les attaques par injection de prompt, en particulier, peuvent tenter de contourner les instructions du système via le contenu des documents ou des sites web. Par conséquent, les limitations techniques, la validation du contenu, la gestion distincte des permissions et les tests avec des scénarios d'incidents réalistes sont essentiels.
Un processus de mise en œuvre judicieux commence par l'identification d'un problème mesurable, et non par la définition d'un modèle privilégié. Ensuite, les flux de données, les rôles des utilisateurs, les risques d'erreur et l'effet de levier économique sont définis. S'ensuit un projet pilote limité, basé sur des flux de travail réels, servant de base de comparaison et assorti de critères d'arrêt clairs. Le passage à l'échelle n'intervient qu'une fois la qualité, l'acceptation, la sécurité et l'impact sur les processus démontrés. Cette approche progressive permet de réduire les coûts irrécupérables et d'éviter le financement pendant des années d'un projet, aussi prometteur soit-il sur le plan technique, sans valeur ajoutée commerciale tangible.
La gestion du changement est également cruciale. Les employés doivent comprendre les objectifs du système, ses limites et la procédure de signalement des erreurs. L'expertise ne doit pas être dévalorisée insidieusement par une prétendue automatisation. Les meilleurs résultats sont souvent obtenus lorsque les employés expérimentés participent à l'évaluation des cas, à la gestion des exceptions et aux boucles de rétroaction. Ainsi, la correction individuelle devient un processus d'apprentissage organisationnel, même si le modèle de base lui-même n'intègre pas systématiquement les enseignements de chaque interaction.
Quatre critères de test permettent de distinguer les plateformes des chatbots reconditionnés
La première question essentielle est de savoir si le système connaît déjà l'entreprise avec suffisamment de précision, ou si les utilisateurs doivent reconstituer le contexte pour chaque transaction. Une démonstration pertinente utilise donc les données, la terminologie et les autorisations réelles de l'entreprise, plutôt qu'une base de données préétablie. L'évaluation doit non seulement porter sur l'exactitude des réponses, mais aussi sur la manière dont le système gère les informations manquantes, contradictoires ou invalides. Un système fiable doit reconnaître ses limites et rendre les incertitudes visibles.
La deuxième question concerne le parcours complet des données. Les entreprises doivent documenter le processus de traitement, les emplacements de stockage, les règles de conservation, les sous-traitants, la journalisation et les options de suppression. Il est tout aussi important de vérifier si l'architecture permet de conserver les données dans les systèmes existants et de n'en fournir que les extraits nécessaires. Les déclarations relatives à la sécurité ne sont fiables que si elles peuvent être rattachées à une variante et une configuration de produit spécifiques.
La troisième question est de savoir qui est responsable, sur les plans économique et organisationnel, du résultat convenu. Il est impératif de clarifier les conséquences d'un non-respect des objectifs de précision, de débit, de temps de traitement ou autres valeurs cibles. Se contenter d'évoquer la planification future des produits révèle un manque de transparence et de responsabilité. Parallèlement, l'entreprise doit assumer ses propres responsabilités, notamment en matière de qualité des données, de définition des processus, de formation des utilisateurs et de décisions d'experts. La responsabilité des résultats ne peut être entièrement externalisée.
La quatrième question porte sur les coûts du second cas d'utilisation. Les fournisseurs doivent démontrer quelles connexions, autorisations, définitions, tests et fonctions opérationnelles sont réutilisés. Un calcul transparent des coûts pour un processus ultérieur est plus instructif qu'une simple présentation de la plateforme. Il permet de déterminer si les économies d'échelle sont réelles ou si chaque extension engendre un nouveau projet d'intégration. Ces quatre questions visent délibérément à recentrer l'attention sur le contexte, la souveraineté des données, la responsabilité et les avantages économiques cumulatifs, plutôt que sur le nom du modèle.
L'architecture opérationnelle appropriée est fondée sur les risques, et non sur l'idéologie
Pour la plupart des entreprises, il n'existe pas de méthode de déploiement unique et optimale. Une approche par portefeuille s'avère plus judicieuse sur le plan économique. La gestion des contenus publics et des tâches de rédaction à faible risque peut s'effectuer via des assistants d'entreprise standardisés. Les requêtes internes relatives aux connaissances nécessitent des connecteurs contrôlés, des vérifications d'autorisation et une validation des sources. Les processus métier critiques requièrent des flux de données plus rigoureux, des tests reproductibles, des validations humaines et, le cas échéant, un traitement dédié ou local. Enfin, les actions automatisées hautement performantes requièrent des outils rigoureusement contrôlés, des contrôles transactionnels et des procédures de restauration.
Cette approche par paliers permet d'éviter deux extrêmes coûteux. Le premier consiste à confier l'intégralité des données à un assistant générique et à s'en remettre aux clauses contractuelles. Le second consiste à développer et exploiter l'ensemble des fonctions d'IA en interne. Entre ces deux extrêmes se trouvent les services cloud managés, le traitement régional, les clés appartenant au client, les chemins réseau privés, les instances dédiées, les modèles sur site et les architectures hybrides. Leur combinaison doit être choisie en fonction du risque spécifique.
Le choix du modèle peut également être hiérarchisé. Les modèles plus petits sont souvent moins chers, plus rapides et suffisants pour des tâches bien définies. Les modèles plus grands peuvent être plus performants pour les langages complexes, la planification ou les documents hétérogènes. Un routeur intelligent peut attribuer les tâches aux différents modèles en fonction de leur sensibilité, de leur complexité et de leur coût. Un système d'évaluation standardisé est indispensable pour garantir que les avantages en termes de prix ne soient pas annulés par des coûts plus élevés liés aux erreurs et aux reprises.
À long terme, l'atout le plus précieux ne sera pas le modèle individuel le plus performant, mais plutôt la capacité de l'entreprise à déployer des modèles de manière sécurisée et rapide dans les processus de production. Cette capacité repose sur la qualité des données, une architecture modulaire, l'expertise, la gouvernance et une culture d'amélioration continue. Plus difficile à copier qu'une licence, elle conserve toute sa valeur, même en cas de changement de fournisseur de modèles dominant.
Du projet d'IA au système d'exploitation d'entreprise
La perspective stratégique évolue : il ne s’agit plus de choisir l’assistant à acquérir, mais de développer les capacités opérationnelles nécessaires. Les entreprises ont besoin d’un inventaire catalogué des sources de données, de responsabilités clairement définies, de méthodes d’accès standardisées, d’un portefeuille modèle, de procédures d’évaluation réutilisables et d’une priorisation fondée sur la valeur économique. Sans ces fondements, de nombreux outils isolés voient le jour, dont les avantages sont difficiles à comparer et les risques s’accumulent.
Le choix des cas d'usage doit privilégier les processus récurrents, riches en données et complexes. Les transferts de responsabilité entre fonctions et systèmes, où les employés doivent rechercher, comparer, transférer ou expliquer des informations, sont particulièrement pertinents. Dans ces situations, l'IA générative peut exploiter des contenus non structurés et compléter l'automatisation traditionnelle. Les processus sans base de données claire, sans état initial mesurable, ou présentant des taux d'erreur extrêmement élevés et des options de contrôle limitées sont moins adaptés.
Pour chaque dossier prioritaire, la direction doit formuler une hypothèse économique. Cette hypothèse décrit quel goulot d'étranglement sera éliminé, quel indicateur clé de performance évoluera, quels coûts seront intégralement engagés et comment l'effet se concrétisera dans les opérations. Une simple supposition de gain de temps est insuffisante. Il est impératif de déterminer clairement si le temps ainsi libéré permettra de traiter davantage de dossiers, de réduire les temps d'attente, d'améliorer la qualité ou, concrètement, d'éviter des coûts de personnel et des coûts externes. Seul ce lien permet de transformer la productivité technique en un retour sur investissement.
Parallèlement, une décision architecturale s'impose, qui envisage l'avenir au-delà du projet pilote initial sans pour autant construire immédiatement une plateforme surdimensionnée. Un noyau allégé et partagé, comprenant la gestion des identités, la journalisation, l'accès aux modèles, les connecteurs de données et l'évaluation, peut évoluer progressivement. Chaque nouvelle application doit s'appuyer sur ce noyau et générer le moins de logique personnalisée possible. Cette approche permet de développer des capacités cumulatives plutôt que de se contenter d'une série de démonstrations.
La décision d'achat proprement dite dépend du modèle
Les modèles d'IA gagnent en puissance, en accessibilité et s'intègrent de plus en plus aux logiciels standards. L'accès seul devient ainsi un facteur de différenciation moins important. Ce que les entreprises acquièrent ou développent réellement, ce sont les composantes qui entourent le modèle : contexte métier, stockage de données contrôlé, intégration fiable, traçabilité des décisions, responsabilisation organisationnelle et une courbe de coûts qui devient plus avantageuse avec l'augmentation des cas d'usage. Ces éléments déterminent si l'IA restera un outil de productivité pour les employés ou deviendra une capacité à l'échelle de l'entreprise.
Une licence d'entreprise n'est ni inutile ni suffisante à cet effet. Elle représente souvent un minimum raisonnable pour les tâches courantes et peut limiter l'utilisation de l'IA parallèle. Cependant, pour les processus réglementés ou critiques, elle doit être complétée par une architecture de données, une gouvernance, une conception des processus et une responsabilisation mesurable quant aux résultats. De même, un modèle privé seul ne constitue pas la solution. L'isolement technique, sans contexte ni concept opérationnel, ne fait que créer un système cloisonné et privé.
Le deuxième cas d'usage est le plus révélateur. Si toutes les connexions de données, règles, tests et responsabilités doivent être reconstruits, le succès initial n'était pas dû à la plateforme, mais à un projet isolé. À l'inverse, si les composants essentiels sont réutilisés et que le délai d'obtention des bénéfices diminue, les véritables avantages économiques se font sentir. La valeur réside alors non pas dans une démonstration spectaculaire, mais dans une infrastructure d'apprentissage qui améliore continuellement les processus à moindre coût.
Les employés ayant déjà voté via des comptes privés ne constituent donc pas seulement un problème de sécurité. Ils témoignent d'une forte exigence et d'une faible tolérance aux outils défaillants. Il incombe à la direction de traduire cette exigence en une alternative performante et maîtrisée : un système qui comprenne les enjeux de l'entreprise, protège efficacement les données sensibles, gère les erreurs de manière responsable et ne nécessite pas de redémarrage à chaque utilisation. Tout système en deçà reste un simple chatbot nécessitant une connexion : utile, souvent impressionnant, mais pas encore une véritable intelligence artificielle d'entreprise.
Conseil - Planification - Mise en œuvre

Konrad Wolfenstein
Je serais heureux de vous servir de conseiller personnel.
wolfenstein∂xpert.digitalmeVous pouvez contacter à ou
Appelez-moi simplement au +49 7348 4088 965 .