Aleph Alpha y Kolibri-1: El regreso de la IA a Alemania entre la eficiencia, la dependencia y un nuevo bloque de poder: una imagen creativa sobre el tema, con IA: Xpert.Digital
78 mil millones de parámetros y aún eficiente: Kolibri-1 en el punto de mira
Alemán e inglés: Kolibri-1 como factor diferenciador económico
Del chatbot a la automatización de procesos: El desarrollo de Kolibri-1
Con el lanzamiento de Kolibri-1, Aleph Alpha presenta un innovador modelo de IA que no solo se adapta a las necesidades de las empresas alemanas, sino que también podría establecer estándares internacionales. A diferencia de otros grandes modelos lingüísticos, a menudo dominados por empresas estadounidenses o chinas, Kolibri-1 busca ofrecer una solución de IA controlable y eficiente, especialmente adecuada para datos sensibles y documentos complejos. Su enfoque en el alemán y el inglés, así como su integración en los procesos de negocio existentes, podría ser crucial para muchas organizaciones, especialmente en un mercado que busca cada vez más soluciones de alto rendimiento y seguras para los datos. En este contexto, surge la pregunta de si Kolibri-1 es simplemente un experimento tecnológico o la piedra angular de un nuevo capítulo en el desarrollo de la IA europea. Los retos y las oportunidades que presenta este modelo se exploran en detalle en las siguientes secciones.
78 mil millones de parámetros, y sin embargo, al final no es el modelo el que decide, sino la infraestructura
Un modelo como señal de política económica
Con Kolibri-1, Aleph Alpha retoma una disciplina de la que la empresa con sede en Heidelberg parecía haberse retirado en gran medida: el desarrollo de modelos lingüísticos amplios y de aplicación general. Sin embargo, el nuevo sistema no es simplemente un intento de replicar modelos estadounidenses o chinos. Está diseñado como una base especializada alemán-inglés para empresas, administraciones públicas e industrias reguladas. Por lo tanto, Kolibri-1 apunta menos al mercado masivo de chatbots gratuitos y más a un mercado comercialmente atractivo, aunque menos accesible: la IA controlable para datos sensibles, documentos extensos, bases de conocimiento internas, procesos industriales y flujos de trabajo basados en agentes.
Por lo tanto, esta publicación no debe considerarse únicamente un evento técnico. Aborda tres cuestiones económicas clave de la estrategia europea de IA. En primer lugar, se refiere a si los proveedores europeos pueden desarrollar modelos básicos tecnológicamente independientes sin depender permanentemente de las principales plataformas de EE. UU. y China. En segundo lugar, plantea la cuestión de si un modelo de alto rendimiento y de acceso abierto genera también un modelo de negocio viable. En tercer lugar, el beneficio económico no se determina por el número de parámetros, sino por la capacidad de las empresas para operar el modelo de forma segura a costes razonables, integrarlo en los procesos existentes y mantenerlo actualizado continuamente.
Kolibri-1 se lanza en un entorno de mercado favorable. Se prevé que el gasto alemán en inteligencia artificial alcance los 28.700 millones de euros en 2026, lo que representa un crecimiento de aproximadamente el 48 % con respecto al año anterior. La IA generativa ya representa unos 11.500 millones de euros, es decir, cerca del 40 % del mercado total. Sin embargo, su aplicación práctica en las empresas alemanas aún está mucho menos extendida de lo que sugieren las elevadas inversiones. Solo una pequeña parte de las empresas ofrece a sus empleados acceso directo a aplicaciones de IA generativa. Las empresas más pequeñas, en particular, se muestran reticentes debido a los costes, las preocupaciones sobre la privacidad de los datos, la falta de personal cualificado y la incertidumbre en los procesos de integración.
Esto crea una brecha en el mercado. Las empresas desean utilizar una IA potente, pero no quieren transferir información confidencial a plataformas externas sin verificación. Necesitan modelos operativos transparentes, flujos de datos controlables, calidad en alemán y conceptos de implementación legalmente sólidos. Aquí es precisamente donde entra en juego Kolibri-1. Por lo tanto, este modelo no pretende ser un ataque a los chatbots más populares, sino más bien una propuesta para las organizaciones que desean construir su propia infraestructura de IA por razones regulatorias, estratégicas o económicas.
Activación económica en lugar de arquitectura a pequeña escala
Kolibri-1 comprende un total de aproximadamente 78.100 millones de parámetros. Esta cifra puede parecer un modelo muy grande y, por consiguiente, costoso. Sin embargo, el sistema opera con una arquitectura de expertos mixtos. Esto significa que no todos los parámetros se activan en cada paso del procesamiento. En cambio, un enrutador decide qué subredes especializadas son responsables de cada token. De los 78.100 millones de parámetros, solo unos 3.460 millones están activos por token. Esto corresponde a aproximadamente el 4,4 % de la capacidad total.
La arquitectura consta de 50 capas de transformadores. Cada capa cuenta con 384 expertos especializados. Un experto común permanece siempre activo, mientras que otros seis se activan según el contenido del token correspondiente. El concepto subyacente resulta económicamente atractivo: el modelo posee la capacidad de conocimiento y especialización de un sistema muy grande, pero requiere solo una fracción de las operaciones computacionales habituales para un único paso de cálculo. Esto permite mejoras fundamentales en el rendimiento y los costos operativos en comparación con un modelo denso de tamaño similar.
Esta eficiencia, sin embargo, no debe confundirse con bajos requisitos de memoria. Todos los pesos del modelo deben permanecer disponibles en memoria, ya que el enrutador puede activar diferentes expertos según la entrada. La variante FP8 requiere aproximadamente 78 gigabytes de memoria gráfica solo para los pesos. Se necesita memoria adicional para el contexto (la caché KV), los cálculos temporales, la paralelización y el entorno de ejecución. Por lo tanto, la configuración mínima recomendada es de dos GPU A100 con 80 gigabytes cada una, dos GPU H100 SXM5 o una GPU H200, B200 o B300. Para un funcionamiento estable en producción, se recomiendan configuraciones más potentes o redundantes.
Esto pone de relieve la tensión central inherente a Kolibri-1. El esfuerzo computacional por token es relativamente bajo, pero el acceso al hardware necesario sigue siendo costoso. Para una empresa con infraestructura de GPU existente, el modelo puede resultar económicamente atractivo. Sin embargo, para una empresa mediana sin su propio clúster de IA, el alojamiento directo rara vez es la solución más rentable. En este caso, los servicios de alojamiento gestionado, los servicios de nube soberana o las plataformas específicas del sector probablemente desempeñen un papel decisivo.
Por lo tanto, la ventaja económica de una arquitectura experta no es automática. Depende de una alta utilización. Una GPU costosa que solo procesa solicitudes ocasionales sigue siendo antieconómica incluso con un modelo eficiente. Cuantos más usuarios, procesos de documentos y aplicaciones basadas en agentes se agrupen en una infraestructura compartida, mejor se podrán distribuir los costos fijos. Para los operadores de centros de datos, los proveedores de servicios en la nube y las grandes corporaciones, Kolibri-1 resulta significativamente más atractivo que para las pequeñas empresas individuales con baja utilización.
Un millón de tokens no es un pase libre
Una característica clave de Kolibri-1 es su capacidad para procesar entradas muy largas. El entrenamiento inicial se realizó con secuencias de 16 384 tokens. En una fase de entrenamiento posterior, la longitud se incrementó a 65 536 tokens. La fase final de contexto extenso operó con 262 144 tokens. Esta longitud se considera el contexto nativo del modelo. Técnicamente, el sistema puede extenderse más allá de este límite sin necesidad de escalado posicional posterior. La calidad y disponibilidad se verificaron hasta 1 048 576 tokens.
Dependiendo del idioma, el formato y la tokenización, un millón de tokens pueden representar varios miles de páginas de texto. Esto abre un abanico de posibilidades para las empresas que con los chatbots tradicionales solo son viables de forma limitada. Entre ellas se incluyen el análisis de contratos extensos, manuales técnicos, documentación de mantenimiento, colecciones legales, archivos de investigación, documentos de proveedores y bases de conocimiento internas. En principio, también se simplifican las complejas revisiones de diligencia debida, los análisis de licitaciones, las comparaciones de cumplimiento y la evaluación de expedientes extensos.
Sin embargo, lo que resulta económicamente relevante no es solo la longitud máxima del contexto, sino el coste por unidad de información procesada de forma significativa. Un contexto muy extenso aumenta el consumo de memoria de la caché de lógica computacional (CLU), alarga los tiempos de respuesta y puede reducir considerablemente el rendimiento. Además, una ventana de contexto amplia no garantiza que el modelo encuentre de forma fiable toda la información relevante, la pondere correctamente y la procese de manera consistente. Cuanto más larga sea la entrada, mayor será el riesgo de que se pierdan detalles cruciales entre pasajes irrelevantes.
Por lo tanto, el rango de uso económicamente viable suele estar por debajo del máximo técnico. Para tareas complejas y aplicaciones críticas en cuanto a latencia, se recomienda un límite de no más de 262 144 tokens. En muchas aplicaciones empresariales, un contexto significativamente menor, combinado con la generación aumentada por recuperación, sigue siendo más eficiente. En este enfoque, no todos los documentos disponibles se cargan en el modelo simultáneamente. Un sistema de búsqueda selecciona primero las secciones que se consideran relevantes y solo las pasa al modelo de lenguaje.
Kolibri-1 no reemplaza a RAG. Su amplio contexto amplía el alcance de las arquitecturas híbridas. Por ejemplo, una empresa puede realizar una búsqueda semántica en miles de documentos, cargar cientos de páginas relevantes en el contexto y que el modelo genere un análisis razonado a partir de esta información. El valor añadido reside en la combinación de búsqueda, comprensión de documentos, atribución de fuentes, resultados estructurados y revisión humana. Por el contrario, introducir indiscriminadamente conjuntos de datos completos en el modelo conlleva el riesgo de altos costes con escasos beneficios.
El alemán se está convirtiendo en un factor diferenciador económico
El verdadero valor estratégico de Kolibri-1 reside en su enfoque constante en el alemán y el inglés. Aproximadamente el 62,5 % del material de entrenamiento básico consiste en contenido en inglés, alrededor del 23,9 % en textos en alemán y aproximadamente el 13,6 % en código del programa. En fases de entrenamiento posteriores, se integraron datos de instrucción, tareas de razonamiento, procesos basados en agentes, contenido temático y documentos extensos. La fase previa al entrenamiento comprendió un total de 20 billones de tokens. Se utilizaron otros 3,44 billones de tokens en la fase intermedia de entrenamiento, y se invirtieron 201 mil millones de tokens en la ampliación de la ventana de contexto.
El componente alemán es significativo en comparación con otros países. Si bien muchos modelos globales pueden generar alemán fluido, se entrenaron principalmente con datos en inglés. Esto tiene un impacto particular en los matices legales, el lenguaje administrativo, los términos técnicos compuestos, las expresiones regionales y los tipos de texto específicos de la industria. Kolibri-1 utiliza su propio tokenizador con 128 000 entradas, que considera de forma más completa la morfología y la formación de compuestos del idioma alemán. Esto permite procesar el texto en alemán de manera más compacta y eficiente.
Esta característica técnica tiene implicaciones económicas directas. Un menor número de tokens por documento en alemán puede reducir los requisitos de almacenamiento, el tiempo de procesamiento y, por lo tanto, los costes. Sin embargo, la calidad en aplicaciones especializadas es aún más importante. En un chat de atención al cliente, a menudo se toleran pequeñas deficiencias lingüísticas. En cambio, una terminología imprecisa en el análisis de un contrato, una directiva de seguridad técnica o un proceso administrativo puede generar costes adicionales significativos.
Alemania posee vastos repositorios de documentos técnicos valiosos pero de difícil acceso. Las empresas industriales cuentan con archivos de especificaciones de diseño, informes de mantenimiento, notificaciones de calidad, normas, comentarios en listas de piezas y correspondencia con proveedores, que se han ido acumulando a lo largo de décadas. Las autoridades públicas gestionan extensos archivos, reglamentos, avisos oficiales y documentación de procedimientos. Las compañías de seguros, los bancos, las empresas energéticas y las organizaciones sanitarias trabajan con repositorios de texto altamente regulados. Un modelo que capture mejor este contenido, tanto lingüística como estructuralmente, puede generar mejoras en la productividad allí donde los chatbots convencionales alcanzan sus límites.
El enfoque bilingüe también supone una limitación. Las corporaciones internacionales suelen requerir sistemas unificados para decenas de idiomas. En estos casos, un modelo multilingüe más amplio puede resultar más ventajoso económicamente, a pesar de una menor especialización en alemán. Por lo tanto, Kolibri-1 es especialmente atractivo cuando el alemán y el inglés constituyen la mayor parte de la comunicación que aporta valor. La limitación deliberada a dos idiomas no es una solución universal, sino más bien un enfoque estratégico en un mercado claramente definido.
De chatbot a trabajador de procesos digitales
Kolibri-1 admite un modo de razonamiento explícito. Los usuarios o las aplicaciones pueden configurar el nivel de razonamiento en bajo, medio o alto, o desactivarlo por completo. Esta gradación es más importante para el uso empresarial de lo que parece a primera vista. No todas las tareas requieren un procesamiento interno prolongado. La clasificación simple, la extracción rápida o la reformulación de texto deben realizarse de forma rápida y rentable. En cambio, el análisis técnico complejo o la planificación en varias etapas pueden beneficiarse de un mayor nivel de razonamiento.
Esto permite controlar la capacidad de procesamiento en función del valor económico de cada tarea. Una empresa puede ejecutar procesos rutinarios con poco esfuerzo cognitivo y asignar tiempo de procesamiento adicional únicamente a los casos más complejos. Esto es similar a la gestión de recursos basada en riesgos: cuanto mayores sean las posibles consecuencias de una respuesta incorrecta, mayor será el esfuerzo dedicado a la verificación, la recuperación y el razonamiento. Sin embargo, esto requiere que la aplicación seleccione adecuadamente este nivel de complejidad y supervise los resultados.
Aún más importante es su capacidad para realizar llamadas a herramientas. El modelo puede generar llamadas a funciones estructuradas, recuperar información mediante interfaces de programación, acceder a sistemas de búsqueda, ejecutar código y generar datos en formatos predefinidos. Esto transforma un simple generador de texto en un componente fundamental para flujos de trabajo basados en agentes. Por ejemplo, un asistente puede comprender una consulta, buscar documentos relevantes, recuperar datos de un sistema ERP, realizar cálculos y crear una plantilla de decisión preliminar.
La ventaja económica no reside en la generación automatizada de texto, sino en la combinación de pasos de procesos que antes estaban separados. Cuando un técnico de servicio ya no tiene que buscar en múltiples sistemas números de pieza, historiales de mantenimiento y términos contractuales, el tiempo de procesamiento disminuye. Cuando un departamento de compras estructura automáticamente los documentos de los proveedores, identifica riesgos y prepara tablas comparativas, la capacidad aumenta sin un incremento proporcional de personal. Cuando una agencia gubernamental extrae el contenido de los archivos y crea borradores estandarizados, los especialistas pueden dedicar más tiempo a la evaluación legal y la participación ciudadana.
Sin embargo, esto no implica una toma de decisiones totalmente autónoma. Kolibri-1 está diseñado para sistemas en los que los humanos revisan los gastos antes de actuar. En los procesos de toma de decisiones, el modelo debe recopilar evidencia, formular opciones y resaltar las contradicciones, pero no tomar decisiones vinculantes sin supervisión. Esto se aplica particularmente a personal, préstamos, medicina, servicios públicos, cuestiones de seguridad y otras áreas con importantes consecuencias individuales o sociales.
La disponibilidad pública de pesos altera el poder de negociación
Kolibri-1 se lanzó bajo la licencia Apache 2.0. Las empresas pueden descargar los pesos, ejecutarlos en su propia infraestructura, personalizarlos y, en principio, utilizarlos comercialmente. En comparación con las interfaces de programación propietarias, esto reduce la dependencia de un único proveedor. Los precios, las condiciones de servicio o las estrategias de producto de un operador de plataforma externo pueden afectar menos al sistema de una empresa cuando el modelo opera dentro de su propio ámbito de responsabilidad.
Esta apertura fortalece la posición negociadora de los clientes frente a los proveedores de software y servicios en la nube. Una empresa puede comparar diferentes socios de alojamiento, cambiar de infraestructura o ejecutar aplicaciones especialmente sensibles internamente. También son posibles las personalizaciones específicas para cada sector. Las consultoras, los integradores y las empresas de software pueden desarrollar sus propias soluciones basadas en el modelo sin tener que pagar una tarifa por cada modelo propietario.
Sin embargo, Open Weight no implica que todo el sistema sea de código abierto en el sentido más estricto. Los pesos del modelo y los archivos de configuración están disponibles. Los datos de entrenamiento, el código completo de entrenamiento, el desarrollo de la arquitectura y todas las herramientas de producción no se divulgan automáticamente. La licencia publicada otorga amplios derechos de uso a los componentes proporcionados, pero no permite la reproducción completa del proceso de desarrollo.
Incluso las herramientas de descarga gratuita no eliminan los costos operativos. Las empresas deben financiar el hardware, la energía, el espacio en el centro de datos, la monitorización, la seguridad, las actualizaciones y el personal cualificado. A esto se suman los gastos de preparación de datos, bases de datos vectoriales, controles de acceso, evaluación, registro y protección de aplicaciones. En muchos casos, la licencia del modelo representa solo una pequeña parte del costo total.
Por lo tanto, la decisión económica no se reduce a elegir entre un modelo gratuito y una API de pago, sino entre costes fijos y variables. Las API propietarias suelen cobrar por token procesado o por solicitud. El alojamiento interno conlleva altos costes iniciales y de configuración, pero puede resultar más rentable con un uso elevado y constante. Las empresas con volúmenes fluctuantes o bajos suelen beneficiarse de la facturación en la nube basada en el uso. Las organizaciones con una utilización constantemente alta, requisitos de datos estrictos o necesidades de adaptación estratégica pueden obtener ventajas del alojamiento interno.
Una nueva dimensión de la transformación digital con 'IA Gestionada' (Inteligencia Artificial) - Plataforma y solución B2B | Xpert Consulting

Una nueva dimensión de la transformación digital con 'IA Gestionada' (Inteligencia Artificial) – Plataforma y solución B2B | Xpert Consulting - Imagen: Xpert.Digital
Aquí aprenderá cómo su empresa puede implementar soluciones de IA personalizadas de forma rápida, segura y sin grandes barreras de entrada.
Una plataforma de IA gestionada es su solución integral y sin preocupaciones para la inteligencia artificial. En lugar de lidiar con tecnología compleja, infraestructura costosa y largos procesos de desarrollo, recibirá una solución lista para usar y adaptada a sus necesidades de un socio especializado, a menudo en tan solo unos días.
Las principales ventajas de un vistazo:
⚡ Implementación rápida: De la idea a la aplicación lista para usar en días, no meses. Ofrecemos soluciones prácticas que generan valor añadido inmediato.
🔒 Máxima seguridad de datos: Tus datos confidenciales permanecen contigo. Garantizamos un procesamiento seguro y conforme a la normativa sin compartirlos con terceros.
💸 Sin riesgo financiero: Solo pagas por resultados. Se eliminan por completo las altas inversiones iniciales en hardware, software y personal.
🎯 Concéntrese en su negocio principal: Concéntrese en lo que mejor sabe hacer. Nos encargamos de toda la implementación técnica, la operación y el mantenimiento de su solución de IA.
📈 A prueba de futuro y escalable: Tu IA crece contigo. Garantizamos la optimización y la escalabilidad continuas, y adaptamos los modelos con flexibilidad a las nuevas necesidades.
Más información aquí:
El verdadero coste de Kolibri-1 en las operaciones comerciales
El cálculo real comienza después de la descarga
Un análisis económico sólido para Kolibri-1 debe ir mucho más allá de la compra de la GPU. En cuanto a la inversión inicial, esto incluye la adquisición, la financiación, la tecnología de red, los sistemas de almacenamiento, la refrigeración y las posibles modificaciones estructurales necesarias. En el aspecto operativo, surgen costos por electricidad, mantenimiento, personal, operación del software y confiabilidad. Los sistemas redundantes suelen ser necesarios para aplicaciones de producción. Un solo servidor podría ser suficiente para las pruebas, pero no constituye un servicio empresarial confiable.
La utilización es el factor de coste más importante. Un modelo gestionado internamente puede, en teoría, lograr bajos costes marginales por solicitud adicional. Sin embargo, en la práctica, la infraestructura también debe estar disponible durante los periodos de baja demanda. Si solo se utiliza al diez o veinte por ciento de su capacidad, los costes fijos se distribuyen entre un número reducido de tokens. Un proveedor de alojamiento especializado puede agregar las cargas de diferentes clientes y, por lo tanto, operar de forma mucho más eficiente. Esto justifica las ofertas de IA gestionadas por el Estado, donde el almacenamiento de datos, la operación del modelo y la gobernanza se combinan en una infraestructura europea controlada.
Los contextos a largo plazo también modifican la estructura de costos. El procesamiento de un documento extenso consume tiempo de almacenamiento y procesamiento durante un período prolongado. Cuando varios usuarios envían simultáneamente cientos de miles de tokens, disminuye la cantidad de solicitudes que se pueden gestionar en paralelo. Por lo tanto, las empresas deben modelar no solo la solicitud promedio, sino también las cargas máximas, los requisitos de tiempo de respuesta y las prioridades. Un sistema de procesamiento por lotes nocturno puede operar de manera mucho más rentable con el mismo hardware que un asistente interactivo con tiempos de respuesta garantizados.
Adaptarse a los datos de la empresa genera costos adicionales. A menudo, no es necesario un ajuste exhaustivo. Un buen sistema RAG, metadatos limpios y un concepto de autorización sólido suelen ofrecer mayores beneficios. El ajuste exhaustivo puede ser útil cuando se requiere aprender de forma fiable formatos recurrentes, lenguajes empresariales o flujos de trabajo. Sin embargo, aumenta el esfuerzo necesario para la calidad de los datos, las pruebas, el control de versiones y la verificación posterior a las actualizaciones del modelo.
El factor de costo oculto más importante es el control de calidad. Un modelo de lenguaje puede producir resultados convincentes y aun así estar equivocado. Por lo tanto, los sistemas productivos requieren casos de prueba relacionados con el negocio, tolerancias de error definidas y evaluación continua. Para cada aplicación crítica, las empresas deben medir con qué frecuencia el modelo encuentra información correcta, cuándo genera conclusiones infundadas, si respeta los derechos de acceso y cómo reacciona ante documentos manipulados. Sin estos controles, un bajo costo de token es económicamente inútil, ya que incluso un solo error puede causar daños significativos.
950 megavatios hora y la cuestión de la eficiencia
El consumo energético para las fases de preentrenamiento, entrenamiento intermedio y contexto prolongado se estima en aproximadamente 950 megavatios-hora. Esta cifra incluye el consumo de energía de los nodos de computación y la sobrecarga del centro de datos. No incluye, entre otros, el ajuste fino supervisado, el aprendizaje por refuerzo, los modelos auxiliares, las series de pruebas ni los estados de inactividad y pico. Por lo tanto, el consumo energético total real del programa de desarrollo es superior a la cifra publicada.
La fase de preentrenamiento se ejecutó durante 21 días en 768 GPU Nvidia B200 distribuidas en 96 sistemas HGX. Esto resultó en aproximadamente 392 000 horas de GPU. La posterior fase de entrenamiento intermedio duró unos cinco días y requirió aproximadamente 90 000 horas de GPU. La fase de contexto a largo plazo añadió otras 10 000 horas de GPU. El esfuerzo computacional reportado es de 6,4 x 10²³ operaciones de coma flotante.
La cifra de 950 megavatios-hora parece elevada, pero debe analizarse desde una perspectiva económica. La capacitación representa una inversión única en un activo digital reutilizable. El factor crucial reside en la intensidad de uso posterior del modelo y los efectos productivos que genera. Si un modelo se utiliza en miles de aplicaciones durante varios años, el esfuerzo de capacitación se distribuye entre una gran cantidad de producción económica. Por el contrario, si se mantiene como un proyecto de demostración tecnológica con bajo uso, la productividad del recurso es escasa.
Para la evaluación del impacto ambiental, el funcionamiento continuo suele ser más significativo a largo plazo que una sesión de capacitación puntual. Cada consulta consume energía, y las ventanas de contexto extensas aumentan esta demanda. Al mismo tiempo, un modelo experto eficiente puede requerir menos cálculos por token que un modelo denso con una capacidad total comparable. Por lo tanto, la comparación crucial no radica en un alto consumo absoluto frente a la ausencia de consumo, sino en la energía por resultado útil.
Europa tiene un incentivo estratégico para la eficiencia. Los altos precios de la electricidad y la limitada capacidad de los centros de datos hacen que las arquitecturas ineficientes resulten especialmente costosas. Modelos como Kolibri-1, que solo activan un pequeño subconjunto de sus parámetros, se ajustan a la estrategia europea de combinar el rendimiento tecnológico con la productividad de los recursos. Sin embargo, esta ventaja se ve parcialmente contrarrestada por los elevados requisitos de almacenamiento y el hardware de alto rendimiento necesario.
Los indicadores de referencia muestran solidez, pero no hay un claro ganador
Los datos comparativos publicados posicionan a Kolibri-1 como un modelo de alto rendimiento en su categoría de tamaño y eficiencia. Obtiene un promedio general de 75,5 puntos en inglés y 70,8 puntos en alemán. Su desempeño es particularmente sólido en matemáticas y razonamiento multietapa. Alcanza el 96,0 % en la prueba AIME-2026 en inglés y el 90,0 % en la versión alemana. En la exigente prueba científica GPQA Diamond, el modelo obtiene un 84,3 % en inglés y un 81,3 % en alemán.
Kolibri-1 también demuestra resultados competitivos en tareas de programación, procesos basados en agentes y escenarios RAG industriales. Destacan especialmente sus altas puntuaciones en áreas como el suministro automotriz, la tecnología de semiconductores, el sector público alemán y la tecnología de accionamiento industrial. Esto respalda su posicionamiento como modelo para procesos de negocio intensivos en conocimiento. Igualmente significativa es la mejora con respecto a una versión anterior del modelo base: tras el entrenamiento, se ha fortalecido considerablemente el razonamiento, el uso de herramientas y la adherencia a las instrucciones.
Sin embargo, Kolibri-1 no es líder en todas las disciplinas. Modelos competidores más densos y de mayor tamaño obtienen mejores resultados en diversas pruebas de conocimiento, código y contexto extenso. Otros modelos expertos también superan a Kolibri-1 en tareas individuales de búsqueda o recuperación de herramientas. Los resultados alemanes son sólidos, pero no consistentemente superiores. Por lo tanto, no se puede deducir una clara ventaja económica únicamente a partir de una tabla comparativa.
Los puntos de referencia solo reflejan condiciones de prueba definidas. En las empresas reales, la calidad de los documentos, los permisos, la diversidad de formatos, la jerga técnica y las consecuencias de los errores son mucho más complejos. Un modelo podría tener un buen rendimiento en una prueba estandarizada, pero aun así fallar debido a archivos PDF mal escaneados, datos heredados contradictorios o abreviaturas internas. Por el contrario, un modelo con una puntuación media ligeramente inferior podría ser superior en una aplicación empresarial bien configurada.
Para la toma de decisiones sobre adquisiciones y arquitectura, las pruebas internas son esenciales. Las empresas deben utilizar documentos representativos, casos extremos exigentes y datos de procesos reales. Las mediciones deben abarcar no solo la precisión de la respuesta, sino también el costo, la latencia, la estabilidad, la referencia de origen, el comportamiento ante fallos y la mantenibilidad. Kolibri-1, con sus ponderaciones abiertas, es idóneo para este tipo de evaluaciones controladas. Esto representa una ventaja significativa sobre los sistemas cuyas versiones internas y condiciones de funcionamiento pueden cambiar sin la intervención del cliente.
La seguridad es una tarea sistémica
El entrenamiento de Kolibri-1 incluye medidas contra contenido malicioso, datos personales y alucinaciones. La información personal identificable se eliminó o reemplazó parcialmente durante el preentrenamiento. Para el ajuste fino supervisado, se añadieron datos para protegerse contra ataques a la información personal. Además, el modelo se entrenó para abstenerse de responder ante información faltante o contradictoria.
Estas medidas reducen los riesgos, pero no los eliminan. Los modelos de lenguaje pueden generar información falsa, adoptar sesgos políticos o sociales y reaccionar a datos manipulados. Los ataques de inyección indirecta de comandos son particularmente problemáticos. En estos ataques, un documento recuperado contiene instrucciones ocultas diseñadas para engañar al modelo y que realice acciones no deseadas. Cuanto más se utilicen las llamadas a herramientas y los procesos automatizados, mayor será el daño potencial de un ataque de este tipo.
Por lo tanto, los sistemas empresariales seguros requieren múltiples capas de protección. El acceso debe otorgarse según el principio de mínimo privilegio. Las llamadas a herramientas deben validarse, las acciones sensibles requieren aprobación y los resultados deben registrarse. El modelo por sí solo no debe decidir qué datos puede ver ni qué transacciones puede ejecutar. Sus permisos deben estar técnicamente limitados fuera del modelo.
El contexto ampliado también genera nuevos riesgos. Grandes volúmenes de documentos pueden contener información confidencial, datos personales o instrucciones contradictorias. Quien gestione salas de datos completas debe asegurarse de que los usuarios solo reciban la información a la que están autorizados a acceder. Un modelo de lenguaje centralizado en distintos departamentos, sin una separación de acceso coherente, puede, involuntariamente, romper los silos de información existentes.
Por lo tanto, la implementación en industrias reguladas requiere más que un modelo desarrollado en Europa. Exige evaluaciones de riesgos documentadas, clasificación de datos, supervisión humana, protocolos técnicos y líneas de responsabilidad claras. La soberanía no significa simplemente que los datos residan en un centro de datos específico, sino que la organización controle todo el proceso de toma de decisiones técnicas y legales.
El bloque de poder transatlántico detrás del modelo
El lanzamiento de Kolibri-1 coincide con un periodo de profunda reestructuración corporativa. Aleph Alpha y la empresa canadiense de IA Cohere han firmado un acuerdo vinculante para fusionarse. La transacción aún está sujeta a las aprobaciones regulatorias finales a principios de octubre de 2026. La empresa resultante operará a nivel mundial bajo la marca Cohere, con sedes en Toronto y Berlín. El centro de Heidelberg se mantendrá como centro de investigación.
Esta configuración modifica la clasificación de Kolibri-1. Si bien el modelo se desarrolló en Alemania, su futuro económico se decide cada vez más dentro de una organización transatlántica. La fusión combina la investigación, la experiencia en alemán y el acceso al sector público de Aleph Alpha con el alcance internacional, los productos corporativos y la capacidad de ventas de Cohere. Esto puede acelerar la comercialización, pero reduce la idea de un líder alemán en IA completamente independiente.
Políticamente, la alianza se presenta como una alternativa de Alemania y Canadá a las plataformas estadounidenses dominantes. Esta descripción es comprensible, pero solo parcialmente suficiente. Si bien Canadá es un socio cercano de Europa, está sujeto a estructuras legales, de mercado de capitales y de seguridad diferentes. La soberanía digital no surge automáticamente de la nacionalidad de las empresas involucradas. Factores cruciales incluyen las estructuras de propiedad, la gobernanza, el acceso a los datos, el control de la infraestructura y la capacidad de los clientes europeos para cambiar de proveedor y ubicación.
El Grupo Schwarz desempeña un papel fundamental en este proyecto. Ya era un inversor importante en Aleph Alpha y está invirtiendo aún más en la empresa resultante de la fusión. A través de Schwarz Digits y la plataforma en la nube STACKIT, proporcionará capacidad de computación para soluciones de IA soberanas. Esto crea una estructura más integrada verticalmente que abarca el desarrollo de modelos, el software empresarial, la infraestructura en la nube y la capacidad de los centros de datos.
Desde una perspectiva económica, esta consolidación tiene sentido. Un solo modelo por sí solo no genera poder de mercado. La creación de valor surge de las ventas, la integración, el alojamiento, las plataformas de datos y los contratos a largo plazo con los clientes. La alianza transatlántica puede abarcar estos niveles mejor que Aleph Alpha por sí sola. Al mismo tiempo, esto aumenta la dependencia de unos pocos socios importantes. Si STACKIT se convierte en la plataforma técnica preferida, la apertura de los pesos del modelo podría complementarse en la práctica con un firme compromiso con un ecosistema operativo específico.
La soberanía de Europa necesita ser ampliada, no simbólica
Europa está invirtiendo fuertemente en infraestructura de IA. La red de fábricas de IA europeas está creciendo y se han destinado miles de millones a estas fábricas y estructuras relacionadas. Además, se están planificando varias gigafábricas de IA. El objetivo es proporcionar a las empresas, instituciones de investigación y administraciones públicas europeas acceso a capacidad de computación de alto rendimiento. Esta política de infraestructura es necesaria porque los modelos modernos no pueden desarrollarse ni operarse de forma rentable sin grandes clústeres de GPU.
Sin embargo, Kolibri-1 demuestra que el hardware por sí solo no basta. Europa necesita un ecosistema industrial completo que incluya modelos, centros de datos, salas de datos, integradores, software especializado, servicios de seguridad y usuarios cualificados. La inversión pública en capacidad de procesamiento solo es efectiva si genera aplicaciones comercializables. De lo contrario, Europa subvenciona infraestructuras costosas mientras que las empresas de software y plataformas rentables permanecen fuera del continente.
La demanda es innegable. La gran mayoría de las empresas alemanas prefiere soluciones de IA de origen alemán. Sin embargo, en la práctica, los servicios estadounidenses predominan claramente. Esta discrepancia no se debe a una falta de interés en la soberanía tecnológica, sino a la conveniencia, la madurez del producto, los ecosistemas y los contratos existentes. Las empresas rara vez eligen un modelo en función de su origen. Seleccionan una solución que sea de rápida integración, fiable, con precios transparentes y fácil de gestionar a nivel organizativo.
Por lo tanto, Kolibri-1 debe ofrecer algo más que la promesa de ser de origen europeo. Necesita herramientas competitivas, opciones de alojamiento estables, buena documentación, redes de socios y ventajas cuantificables en los procesos empresariales alemanes. El enfoque Apache 2.0 facilita el desarrollo de dicho ecosistema. Las empresas de software y los grupos de investigación pueden probar el modelo, adaptarlo e integrarlo en sus propios productos. Esto aumenta la probabilidad de que la innovación no se limite a un único proveedor.
Al mismo tiempo, existe el riesgo de que las plataformas globales exploten los pesos abiertos sin que Alemania reciba la parte correspondiente del valor añadido. Por lo tanto, la apertura no sustituye una estrategia empresarial sólida. Aleph Alpha y sus socios deben ofrecer servicios, modelos operativos seguros, soluciones específicas para cada sector y generar confianza institucional. El modelo sirve como base tecnológica y puerta de entrada, no como única fuente de ingresos.
Una evaluación realista de Hummingbird-1
Kolibri-1 no es ni una prueba de la completa independencia europea en IA ni un modelo de nicho insignificante. Su importancia radica en un punto intermedio entre estos dos extremos. Técnicamente, combina una gran capacidad general con una carga computacional activa relativamente baja, un componente de entrenamiento en alemán excepcionalmente sólido, contextos muy extensos, razonamiento y llamadas a herramientas. La licencia abierta ofrece un margen de acción real para empresas, integradores e instituciones públicas.
Desde el punto de vista económico, este modelo resulta especialmente atractivo en entornos donde convergen datos confidenciales, terminología técnica alemana y altos volúmenes de uso. Grandes empresas industriales, agencias gubernamentales, bancos, aseguradoras, proveedores de energía, organizaciones de investigación y proveedores de software especializado son algunos de los grupos objetivo más evidentes. Para las pequeñas empresas sin infraestructura propia, el alojamiento directo suele ser menos práctico. Es más probable que utilicen Kolibri-1 a través de servicios gestionados, soluciones específicas para su sector u ofertas de nube soberana.
La mayor ventaja no reside en los 78 mil millones de parámetros, sino en la capacidad de combinar control y adaptabilidad con un rendimiento competitivo. La mayor desventaja es que este control debe financiarse y gestionarse internamente. Quien opere el modelo asume la responsabilidad de la infraestructura, la seguridad, la evaluación y las actualizaciones. Esto representa libertad estratégica, pero no una libertad sin costo.
La alianza con Cohere y Schwarz Digits podría transformar Kolibri-1 en un producto comercial con proyección internacional. Podría aunar investigación, capital, ventas y capacidad de procesamiento. Al mismo tiempo, exige una reevaluación profunda del concepto de soberanía digital. Una corporación transatlántica con investigación alemana e infraestructura europea en la nube podría ser una alternativa viable a las principales plataformas estadounidenses. Sin embargo, esto no implica automáticamente un sistema puramente alemán ni controlado íntegramente por Europa.
Por lo tanto, la perspectiva es clara: Kolibri-1 es un pilar fundamental para una economía europea de IA, pero su éxito no está garantizado. No dependerá de tablas comparativas, sino de centros de datos, presupuestos de adquisición y procesos de negocio concretos. Si la ventaja del idioma alemán, la licencia abierta y la eficiente arquitectura experta se traducen en aplicaciones robustas, el modelo puede captar un mercado comercialmente significativo. Si el alojamiento, la integración y la distribución siguen siendo demasiado costosos o complejos, la calidad tecnológica por sí sola no bastará.
Kolibri-1 ilustra, por tanto, la oportunidad y el problema de Europa. El continente tiene el potencial para desarrollar una IA potente, cuenta con clientes industriales exigentes y está expandiendo su infraestructura. Sin embargo, a menudo falta la rápida transición del modelo de investigación a un producto estándar de amplia adopción. El colibrí puede parecer ligero y utilizar solo una pequeña parte de la energía de sus alas en cada momento. Pero para que vuele de forma rentable, necesita una base sólida de capital, energía, capacidad de procesamiento, confianza y distribución.
🎯🎯🎯 Centro de datos para la industria B2B como una solución casi interna

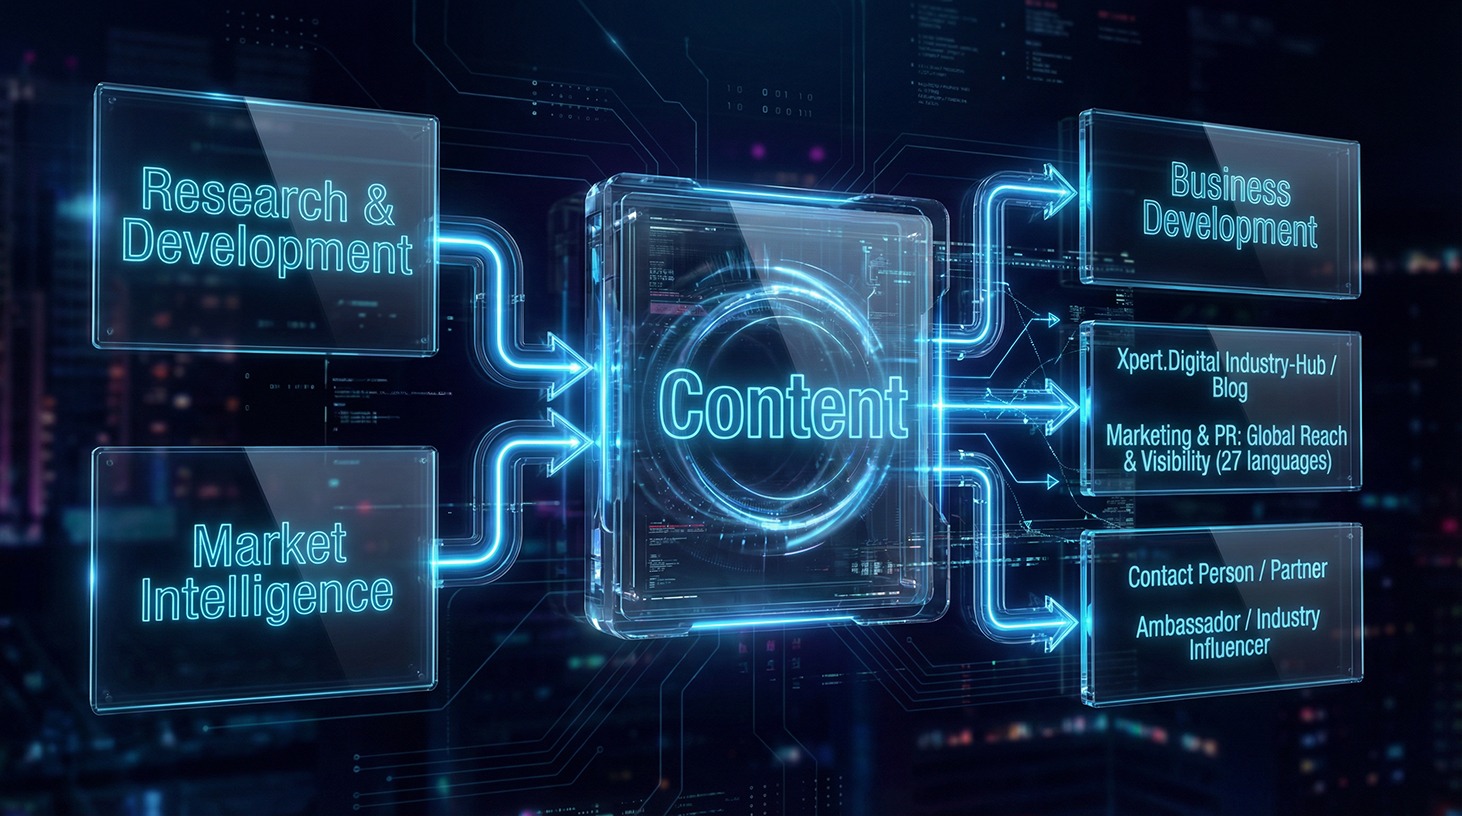
La solución casi interna: Cómo Xpert.Digital cierra las brechas operativas en el marketing y las ventas B2B – Negocios inteligentes basados en contenido - Imagen: Xpert.Digital
Xpert.Digital es un centro industrial B2B basado en datos, dirigido por Konrad Wolfenstein . La empresa actúa como una solución externa, casi interna, para socios industriales, cubriendo las brechas operativas en marketing, contenido y ventas, sin requerir recursos adicionales por parte del cliente.
Más información aquí:
Su socio global de marketing y desarrollo empresarial
☑️ Nuestro idioma comercial es el inglés o el alemán
☑️ NUEVO: ¡Correspondencia en tu idioma nativo!

Konrad Wolfenstein
Mi equipo y yo estaremos encantados de estar disponibles para usted como su asesor personal.
Puedes contactarme rellenando el formulario de contacto aquí wolfenstein@xpert.digital:o simplemente llamándome al +49 7348 4088 965. Mi dirección de correo electrónico es
Espero con ilusión nuestro proyecto conjunto.