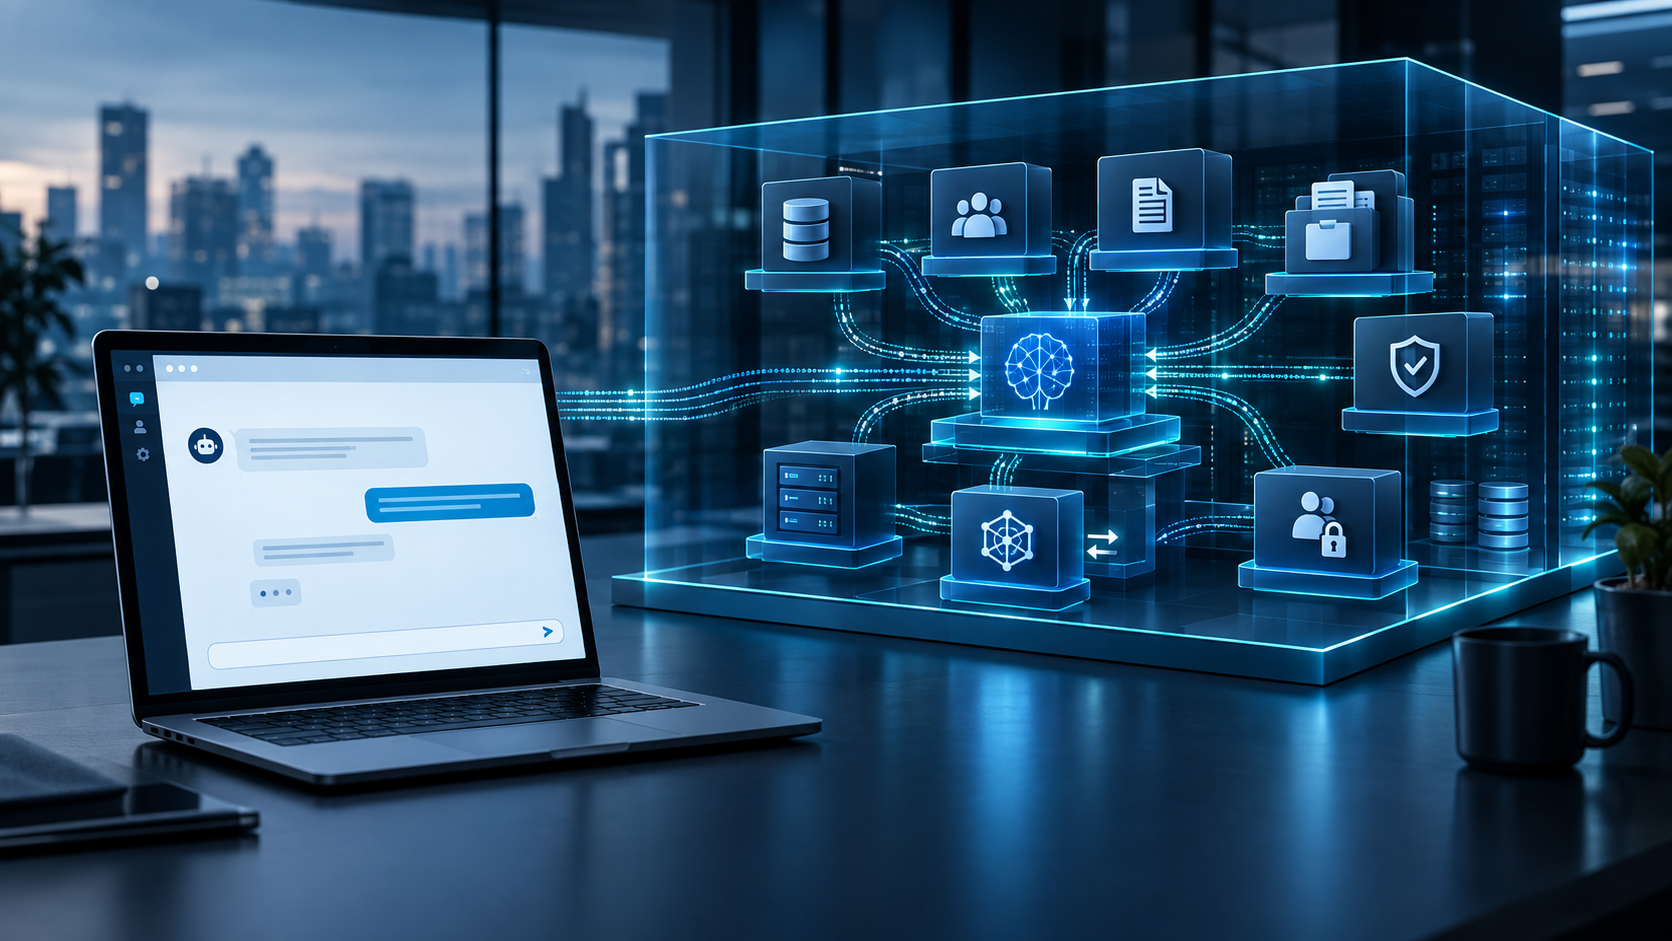
Enterprise-KI beginnt dort, wo der Chatbot aufhört – Kreativbild zum Thema, mit KI: Xpert.Digital
Von der Lizenz zur Verantwortung: Wie Unternehmen ihre KI-Strategie neu denken sollten
So schließen Unternehmen die Lücke zwischen KI-Hoffnung und -Wirklichkeit
Die Bedeutung einer Kontextschicht für effektive Unternehmens-KI
In der heutigen digitalen Landschaft gewinnt die Integration von künstlicher Intelligenz (KI) in Unternehmensprozesse zunehmend an Bedeutung. Doch viele Firmen stehen vor der Herausforderung, dass ihre Mitarbeiter oft auf nicht genehmigte, private KI-Dienste zurückgreifen – eine Praxis, die als Schatten-KI bekannt ist. Diese Entwicklung offenbart eine kritische Lücke zwischen den bereitgestellten Unternehmenslösungen und den tatsächlichen Bedürfnissen der Nutzenden am Arbeitsplatz. Während Unternehmenslizenzen für bekannte KI-Tools als grundlegende Maßnahme betrachtet werden, sind sie allein nicht ausreichend, um den komplexen Anforderungen und den spezifischen Gegebenheiten eines Unternehmens gerecht zu werden. Echte generative Unternehmens-KI erfordert vielmehr eine durchdachte Systemarchitektur, die Modelle, Datenzugänge, Prozesslogik und Verantwortlichkeiten umfasst. In diesem Artikel beleuchten wir die wesentlichen Aspekte, die Unternehmen berücksichtigen müssen, um die Potenziale von KI vollständig auszuschöpfen und Schatten-KI effektiv zu bekämpfen.
Passend dazu:
Wer nur Lizenzen verteilt, digitalisiert nicht das Unternehmen – sondern sein Schatten-KI-Problem
In vielen Unternehmen entscheidet sich die Zukunft der generativen künstlichen Intelligenz nicht in einem Strategiemeeting, sondern in einem unscheinbaren Moment am Arbeitsplatz: Eine Mitarbeiterin kopiert einen Kundenvertrag, eine Kalkulation oder eine interne E-Mail in einen öffentlich verfügbaren KI-Dienst, weil das privat genutzte Werkzeug schneller, verständlicher und leistungsfähiger wirkt als die offiziell freigegebene Unternehmenslösung. Aus Sicht der Beschäftigten ist das häufig kein bewusster Regelverstoß, sondern eine pragmatische Reaktion auf schlechte Prozesse. Aus Sicht des Unternehmens ist es ein Hinweis darauf, dass zwischen technischer Freigabe und tatsächlichem Nutzwert eine gefährliche Lücke besteht.
Der verbreitete Reflex, diese Lücke durch den flächendeckenden Kauf einer Unternehmenslizenz für einen bekannten KI-Assistenten zu schließen, greift zu kurz. Eine solche Lizenz kann wichtige Schutzmechanismen, Verwaltungsfunktionen und vertragliche Zusagen bringen. Sie verwandelt einen allgemeinen Assistenten aber nicht automatisch in ein System, das die Produkte, Kunden, Verträge, Rollen, Genehmigungsgrenzen und Arbeitsabläufe des Unternehmens versteht. Ebenso wenig beantwortet sie von selbst, wo sensible Inhalte verarbeitet werden, wer für falsche Ergebnisse einsteht und ob sich nach dem ersten Anwendungsfall weitere Prozesse zu vertretbaren Grenzkosten erschließen lassen.
Die zentrale ökonomische These lautet deshalb: Echte generative Unternehmens-KI ist kein einzelnes Modell und kein Chatfenster mit Firmenlogo. Sie ist ein betriebliches System aus Modellen, Datenzugängen, Kontext, Identitäten, Berechtigungen, Prozesslogik, Qualitätskontrollen, Verantwortlichkeiten und einer belastbaren Kostenarchitektur. Der eigentliche Wert entsteht nicht durch den Zugang zur KI, sondern durch ihre kontrollierte Einbettung in die Organisation. Genau dort trennt sich ein produktiver Unternehmensbaustein von einem komfortablen Verbraucherprodukt mit geschäftlichem Login.
Die Firmenlizenz ist ein Fundament, aber noch kein Gebäude
Unternehmensversionen großer KI-Assistenten lösen reale Probleme. Typischerweise sagen Anbieter zu, geschäftliche Eingaben und Ausgaben nicht standardmäßig zum Training ihrer allgemein angebotenen Modelle zu verwenden. Hinzu kommen Funktionen wie zentrale Benutzerverwaltung, Single Sign-on, Rollensteuerung, Protokollierung, Verschlüsselung, Nutzungsberichte, Datenverarbeitungsvereinbarungen und teilweise konfigurierbare Aufbewahrungsfristen. In etablierten Büroplattformen können außerdem vorhandene Zugriffsrechte, Richtlinien und Sicherheitsmechanismen genutzt werden. Für viele Organisationen ist das gegenüber privaten Konten ein erheblicher Fortschritt.
Der Fehler besteht nicht darin, solche Lizenzen zu kaufen. Der Fehler besteht darin, ihren Schutzumfang mit einer vollständigen Unternehmenslösung zu verwechseln. Die Zusage, Kundendaten nicht für das allgemeine Modelltraining zu verwenden, beantwortet nur eine von mehreren Datenfragen. Offen bleiben können der Ort der Verarbeitung, die Speicherung von Ein- und Ausgaben, die Dauer der Aufbewahrung, die Beteiligung von Unterauftragnehmern, die Behandlung von Telemetrie sowie die anwendbaren Rechtsräume. Auch unterscheiden sich Chatprodukt, Programmierschnittstelle, integrierter Büroassistent und kundenspezifische Cloud-Instanz häufig erheblich. Eine pauschale Freigabe nach Markennamen ist deshalb betriebswirtschaftlich und regulatorisch unzureichend.
Vor allem enthält die Lizenz noch kein institutionelles Gedächtnis. Ein Modell kennt nicht automatisch die unternehmenseigene Bedeutung einer Produktbezeichnung, die Historie einer Reklamation oder die Frage, welches von mehreren Kundensystemen für einen bestimmten Vorgang führend ist. Es kennt weder informelle Ausnahmen noch die Genehmigungsmatrix und kann nicht selbst entscheiden, ob eine veraltete Richtlinie oder deren Nachfolger maßgeblich ist. Der Zugang zum Modell wird eingekauft; die betriebliche Verlässlichkeit muss dagegen aufgebaut, getestet und dauerhaft betrieben werden.
Schatten-KI ist ein Markturteil der eigenen Belegschaft
Die Nutzung privater KI-Konten wird häufig als Disziplin- oder Schulungsproblem behandelt. Das greift zu kurz. Wenn Beschäftigte trotz Verboten auf nicht freigegebene Werkzeuge ausweichen, liefern sie ein unfreiwilliges Marktfeedback: Das sanktionierte Angebot verliert im direkten Vergleich bei Geschwindigkeit, Bedienbarkeit, Modellqualität oder praktischer Einbettung in die Arbeit. Verbote können Risiken kurzfristig reduzieren, beseitigen aber nicht die Nachfrage nach einer besseren Lösung.
Die Größenordnung ist erheblich. Für 2026 wurde berichtet, dass 47 Prozent der Beschäftigten, die generative KI am Arbeitsplatz nutzen, weiterhin persönliche und nicht verwaltete Konten einsetzen. Gleichzeitig verdoppelte sich die Zahl registrierter Vorgänge, bei denen sensible Daten an KI-Anwendungen übermittelt wurden. Im Durchschnitt wurden 223 entsprechende Richtlinienverstöße je Organisation und Monat erfasst; bei besonders stark betroffenen Unternehmen lag die Belastung um ein Vielfaches höher. Regulierte personenbezogene, finanzielle und medizinische Daten stellten dabei einen besonders großen Anteil dar. Solche Messwerte erfassen nur sichtbare Vorgänge und dürften die tatsächliche Nutzung nicht vollständig abbilden.
Ökonomisch betrachtet konkurriert die zentrale IT damit gegen ein kostenloses oder privat bezahltes Substitut. Dieses Substitut hat geringe Zugangshürden, eine gute Nutzererfahrung und oft das neueste Modell. Eine interne Alternative gewinnt nicht allein durch Compliance, sondern nur dann, wenn sie mindestens ebenso bequem ist und zusätzlichen Unternehmensnutzen bietet. Sie muss relevante Informationen finden, in vorhandenen Anwendungen verfügbar sein, unnötiges Kopieren vermeiden und Antworten in den Arbeitszusammenhang einordnen. Dauerhafte Akzeptanz entsteht nicht durch Zwang, sondern durch einen besseren Nutzen bei geringerem persönlichem Aufwand.
Das bedeutet nicht, dass technische Kontrollen entbehrlich wären. Datenverlustprävention, Mandantenbeschränkungen, Browserkontrollen, Protokollierung und klare Nutzungsregeln bleiben notwendig. Ihre Wirkung steigt jedoch erheblich, wenn gleichzeitig eine leistungsfähige Alternative bereitsteht. Die richtige Managementreaktion lautet daher nicht nur, Schatten-KI zu blockieren, sondern ihre Ursachen zu analysieren: Welche Aufgaben erledigen Beschäftigte damit? Welche freigegebenen Systeme versagen? Welche Reibungskosten treiben Menschen in private Konten? Aus diesen Antworten entsteht eine realistische Prioritätenliste für Unternehmens-KI.
Unternehmenswissen entsteht nicht im Chatfenster
Allgemeine KI-Assistenten beginnen einen Vorgang im Kern mit dem Kontext, den der Nutzer bereitstellt oder den das Produkt aus begrenzten früheren Interaktionen ableitet. Für private Aufgaben ist diese Neutralität oft sinnvoll. Im Unternehmen wird sie zum Risiko, sobald Entscheidungen von historischer, vertraglicher oder kundenspezifischer Information abhängen. Eine Antwort zu einem Versicherungsfall kann beispielsweise nur belastbar sein, wenn Schadenhistorie, Vertragsversion, Korrespondenz, regulatorische Vorgaben und Bearbeitungsstatus zusammengeführt werden. Ein einzelner hochgeladener Vertrag reicht dafür nicht.
Das benötigte Wissen liegt selten an einem Ort. Es verteilt sich auf ERP, CRM, Dokumentenmanagement, Ticketsysteme, Data Warehouses, E-Mail, Fachanwendungen und persönliche Ablagen. Hinzu kommen unterschiedliche Identifikatoren, Schreibweisen, Datenstände und Verantwortlichkeiten. Ein Kunde kann in drei Systemen unter abweichenden Namen geführt werden; ein Produktcode kann nach einer Fusion eine andere Bedeutung erhalten haben; eine Richtlinie kann formell noch auffindbar, aber fachlich bereits abgelöst sein. Das Sprachmodell löst diese Widersprüche nicht aus eigener Kraft. Ohne verlässliche Zuordnung erzeugt es im schlechtesten Fall eine sprachlich überzeugende Synthese aus inkonsistenten Daten.
Deshalb ist Kontextbereitstellung vor allem eine Integrations- und Datenmanagementaufgabe. Retrieval-Augmented Generation, also das gezielte Bereitstellen relevanter Inhalte zum Zeitpunkt einer Anfrage, ist dabei ein wichtiges Verfahren, aber keine vollständige Lösung. Erforderlich sind zusätzlich Metadaten, Versionierung, Identitätsabgleich, Berechtigungsprüfung, Quellenrangfolge, Gültigkeitszeiträume und Regeln für widersprüchliche Informationen. Je stärker das System handeln statt nur antworten soll, desto wichtiger werden transaktionale Kontrollen und eindeutig definierte Systemführerschaften.
Eine einfache Prüfung kann die Reife sichtbar machen: Das freigegebene Werkzeug erhält eine Frage, deren korrekte Beantwortung ausschließlich unternehmensinternes Wissen erfordert. Liefert es eine allgemeine, selbstsichere und falsche Antwort, handelt es sich funktional um einen Chatbot mit Firmenzugang. Fordert es lediglich eine Datei an, ist es ein Chatbot mit Upload-Funktion. Erst wenn es berechtigt, nachvollziehbar und aktuell auf die maßgeblichen Systeme zugreift, Unsicherheit erkennt und die Antwort in den Unternehmenskontext einordnet, entsteht echte betriebliche Intelligenz.
Die Kontextschicht wird zum produktiven Kapitalstock
Die entscheidende Architekturkomponente liegt zwischen Modell und operativem Geschäft. Diese Schicht kann als Kontextplattform, Wissensgewebe oder Integrations- und Orchestrierungsebene beschrieben werden. Ihr Name ist weniger wichtig als ihre Funktion: Sie ordnet Entitäten einander zu, verbindet Datenquellen, prüft Berechtigungen, stellt Definitionen bereit, steuert Werkzeuge und dokumentiert, wie eine Antwort oder Aktion zustande kam. Idealerweise wird diese Arbeit nicht für jeden Anwendungsfall neu begonnen, sondern als wiederverwendbarer Unternehmensbaustein aufgebaut.
Aus ökonomischer Sicht ähnelt diese Schicht einem produktiven Kapitalstock. Die erste Verbindung zu einem Vertragsarchiv, die erste saubere Zuordnung von Kundenidentitäten oder die erste Umsetzung einer Genehmigungslogik verursacht hohe Anfangskosten. Sind diese Elemente jedoch standardisiert, können weitere Anwendungsfälle darauf aufbauen. Der Grenzaufwand des zweiten, dritten und fünften Einsatzes sollte sinken. Genau dieser Effekt rechtfertigt eine Plattformstrategie: Ein Teil der Investition wird nicht nur für ein Projekt, sondern für eine wachsende Zahl künftiger Prozesse nutzbar.
Dieser Wiederverwendungseffekt entsteht allerdings nicht automatisch. Viele vermeintliche Plattformen bestehen aus einer Sammlung projektspezifischer Schnittstellen, Prompts und Sonderlösungen. Dann wird jede neue Anwendung erneut analysiert, integriert und abgesichert. Die Kostenkurve bleibt linear, während zusätzliche Abhängigkeiten entstehen. Ein ehrlicher Reifetest lautet deshalb, welche konkreten Komponenten des ersten Anwendungsfalls im zweiten ohne Neubau verwendet werden können. Wiederverwendbar sind beispielsweise Identitätsdienste, Konnektoren, Rechteprüfungen, Datenkataloge, Evaluationsverfahren, Protokollierung, Modellzugänge und standardisierte menschliche Freigaben.
Die Kontextschicht ist zugleich strategisch wichtiger als die Bindung an ein einzelnes Modell. Modelle verbessern sich schnell, Preise ändern sich und verschiedene Aufgaben profitieren von unterschiedlichen Stärken. Unternehmen benötigen daher die Fähigkeit, Modelle kontrolliert auszutauschen oder mehrere parallel einzusetzen. Vollständig kostenfrei ist ein Wechsel dennoch nicht: Promptverhalten, Ausgabeformate, Sicherheitsfilter, Kontextfenster und Leistungsprofile unterscheiden sich. Eine gute Architektur reduziert diese Wechselkosten durch Abstraktion, standardisierte Schnittstellen und wiederholbare Tests, statt einen unrealistischen Eindruck vollständiger Austauschbarkeit zu erzeugen.
Datenhoheit umfasst mehr als den Trainingsausschluss
Die öffentliche Diskussion konzentrierte sich lange auf die Frage, ob Eingaben zum Training eines Modells verwendet werden. Für Unternehmen ist diese Frage wichtig, aber zu eng. Entscheidend ist die gesamte Verwahr- und Verarbeitungskette: Wo wird eine Eingabe verarbeitet? Welche Teile eines Dokuments werden übertragen? Wo liegen Chatverläufe, Zwischenspeicher, Protokolle und Vektorrepräsentationen? Wie lange bleiben sie erhalten? Welche Unterauftragnehmer haben technische Berührungspunkte? Welche Rechtsordnung gilt? Können Administratoren Inhalte einsehen, exportieren und löschen? Wie wird mit Sicherungskopien verfahren?
Eine Marketingabteilung kann einen extern verarbeiteten Entwurf unter Umständen verantwortbar nutzen. Für unveröffentlichte Geschäftszahlen, Produktionsgeheimnisse, Gesundheitsdaten, Rechtsfälle oder kritische Infrastruktur gelten andere Maßstäbe. Die Risikoklasse sollte deshalb nicht allein am Werkzeug, sondern an Datenart, Handlung, möglichem Schaden und menschlicher Kontrolle festgemacht werden. Dasselbe Modell kann beim Umformulieren einer öffentlichen Pressemitteilung ein geringes und bei der automatisierten Bearbeitung eines Kredit- oder Schadenfalls ein hohes Risiko darstellen.
Eine robuste Architektur minimiert Datenbewegungen. Informationen verbleiben soweit möglich in den vorhandenen Systemen; nur der für die Aufgabe notwendige Kontext wird unter den bestehenden Zugriffsregeln bereitgestellt. Abfragen werden nutzerbezogen autorisiert, sensible Felder gegebenenfalls maskiert und Ausgaben entsprechend ihrem Inhalt klassifiziert. Für besonders kritische Prozesse können regionale Verarbeitung, dedizierte Instanzen, vertrauliche Rechenumgebungen oder lokale Bereitstellung sinnvoll sein. Ein vollständiger Eigenbetrieb ist aber weder automatisch sicherer noch wirtschaftlicher, weil Betrieb, Patches, Überwachung, Modellpflege und Fachpersonal erhebliche Kosten verursachen.
Die Formel, das Modell zu den Daten zu bringen, beschreibt daher ein sinnvolles Prinzip, darf jedoch nicht als technische Vereinfachung missverstanden werden. Auch bei föderierten oder lokal angebundenen Lösungen können Ausschnitte, Einbettungen oder Metadaten externe Dienste erreichen. Entscheidend ist eine dokumentierte Datenflussanalyse auf Komponentenebene. Erst wenn für jede Stufe nachweisbar ist, welche Daten wohin gelangen und wie sie geschützt werden, lässt sich Datenhoheit belastbar beurteilen.
Regulierung macht Nachweisbarkeit zum Wirtschaftsfaktor
In regulierten Branchen ist die Datenflussfrage kein abstraktes Sicherheitsideal. Finanzunternehmen müssen im Rahmen der europäischen Regeln zur digitalen operationellen Resilienz Risiken von Informations- und Kommunikationstechnik sowie von Drittanbietern strukturiert bewerten. Vertraulichkeitsvereinbarungen, Berufsgeheimnisse, Datenschutzrecht und sektorale Vorgaben verlangen ebenfalls, dass Unternehmen Verarbeitung, Zuständigkeiten und Kontrollmaßnahmen erklären können. Eine KI-Anwendung, deren Antwortqualität überzeugt, deren Datenweg aber nicht prüfbar ist, kann den betrieblichen Abnahmetest trotzdem nicht bestehen.
Mit dem europäischen KI-Recht gewinnt die systematische Governance weiter an Bedeutung. Seit August 2026 gelten große Teile des europäischen Regelwerks, während einzelne Pflichten für bestimmte Hochrisikosysteme gestaffelt später wirksam werden. Für Unternehmen folgt daraus kein pauschales Verbot generativer KI. Erforderlich ist vielmehr eine belastbare Einordnung nach Einsatzgebiet und Rolle. Ein allgemeines Modell, ein darauf aufgebautes Fachsystem und das Unternehmen, das dieses System einsetzt, können unterschiedliche Pflichten tragen. Transparenz, Dokumentation, menschliche Aufsicht, Datenqualität, Genauigkeit, Cybersicherheit und Nachvollziehbarkeit werden insbesondere bei risikoreichen Anwendungen zentral.
Compliance ist dabei nicht bloß ein Kostenblock. Eine wiederverwendbare Kontrollarchitektur kann Markteinführungszeiten verkürzen, weil nicht jedes Projekt seine Regeln neu erfinden muss. Standardisierte Risikoklassen, freigegebene Modellwege, technische Protokollierung, Evaluationsvorlagen und definierte Freigabestufen reduzieren Unsicherheit. Governance wird so von einer nachgelagerten Kontrollfunktion zu einer produktiven Infrastruktur. Der ökonomische Vorteil zeigt sich vor allem beim zweiten und dritten Einsatz, wenn geprüfte Bausteine erneut verwendet werden können.
Unternehmen sollten außerdem zwischen Modellrisiko und Prozessrisiko unterscheiden. Ein Modell kann technisch leistungsfähig sein, während ein schlecht gestalteter Prozess weiterhin falsche Datenquellen nutzt, unklare Verantwortung besitzt oder keine Rücknahme fehlerhafter Aktionen erlaubt. Umgekehrt kann ein begrenztes Modell in einem eng definierten, gut kontrollierten Prozess hohen Nutzen stiften. Die Qualität der Gesamtarchitektur entscheidet deshalb häufiger über regulatorische und wirtschaftliche Tragfähigkeit als die Spitzenleistung des Modells in allgemeinen Tests.
🤖🚀 Managed-AI-Platform: Schneller, sicherer & smarter zur KI-Lösung mit UNFRAME.AI

Managed AI Platform - Bild: Xpert.Digital
Hier erfahren Sie, wie Ihr Unternehmen maßgeschneiderte KI-Lösungen schnell, sicher und ohne hohe Einstiegshürden realisieren kann.
Eine Managed AI Platform ist Ihr Rundum-Sorglos-Paket für künstliche Intelligenz. Anstatt sich mit komplexer Technik, teurer Infrastruktur und langwierigen Entwicklungsprozessen zu befassen, erhalten Sie von einem spezialisierten Partner eine fertige, auf Ihre Bedürfnisse zugeschnittene Lösung – oft innerhalb weniger Tage.
Die zentralen Vorteile auf einen Blick:
⚡ Schnelle Umsetzung: Von der Idee zur einsatzbereiten Anwendung in Tagen, nicht Monaten. Wir liefern praxisnahe Lösungen, die sofort Mehrwert schaffen.
🔒 Maximale Datensicherheit: Ihre sensiblen Daten bleiben bei Ihnen. Wir garantieren eine sichere und konforme Verarbeitung ohne Datenweitergabe an Dritte.
💸 Kein finanzielles Risiko: Sie zahlen nur für Ergebnisse. Hohe Vorabinvestitionen in Hardware, Software oder Personal entfallen komplett.
🎯 Fokus auf Ihr Kerngeschäft: Konzentrieren Sie sich auf das, was Sie am besten können. Wir übernehmen die gesamte technische Umsetzung, den Betrieb und die Wartung Ihrer KI-Lösung.
📈 Zukunftssicher & Skalierbar: Ihre KI wächst mit Ihnen. Wir sorgen für die laufende Optimierung, Skalierbarkeit und passen die Modelle flexibel an neue Anforderungen an.
Mehr dazu hier:
Vom KI-Projekt zum betriebswirtschaftlichen Betriebssystem
Verantwortung darf nicht zwischen Lizenz und Beratung verschwinden
Verbraucherorientierte KI-Dienste werden als Werkzeuge verkauft. Anbieter weisen zu Recht darauf hin, dass Ausgaben ungenau sein können und Nutzer Ergebnisse prüfen müssen. Dieses Modell ist für einen günstigen Massenmarkt nachvollziehbar. Im betrieblichen Einsatz entsteht jedoch eine Verantwortungslücke, sobald dieselben Ausgaben Kunden erreichen, regulatorische Meldungen beeinflussen oder finanzielle Vorgänge anstoßen. Der Zugangsanbieter verkauft die Nutzungsmöglichkeit, übernimmt aber gewöhnlich nicht die Ergebnisverantwortung des konkreten Geschäftsprozesses.
Auch das klassische Integrationsmodell kann diese Lücke offenlassen. Ein Dienstleister analysiert, entwickelt und integriert über Monate, rechnet Zeit und Material ab und übergibt schließlich ein System. Der Vertrag kann formal erfüllt sein, obwohl das Werkzeug im Alltag geringe Akzeptanz findet, zu viele Fehler produziert oder keine messbare Prozessverbesserung erreicht. Auf der einen Seite wurde Zugang verkauft, auf der anderen Arbeitsaufwand. In beiden Fällen ist nicht zwingend jemand wirtschaftlich an das vereinbarte Ergebnis gebunden.
Unternehmens-KI benötigt deshalb eine explizite Zuordnung von Verantwortung. Fachbereich, IT, Informationssicherheit, Datenschutz, Risikomanagement und Anbieter müssen wissen, wer Datenqualität verantwortet, wer Modelle auswählt, wer Grenzwerte festlegt, wer Ausgaben freigibt und wer bei Störungen entscheidet. Für automatisierte Aktionen sind Rückverfolgbarkeit, Widerrufsmöglichkeiten und klar definierte Eskalationen notwendig. Eine menschliche Prüfung ist nur dann eine wirksame Kontrolle, wenn die prüfende Person genügend Zeit, Kompetenz und Informationen besitzt; ein routinemäßiges Anklicken verwandelt menschliche Aufsicht in eine Formalie.
Ergebnisorientierte Vergütungsmodelle können Anreize verbessern, sind aber kein Allheilmittel. Sie funktionieren nur, wenn Ergebnisse messbar, zurechenbar und gegen Manipulation geschützt sind. Bei einem klaren Prozess wie der Verkürzung einer Bearbeitungszeit, der Senkung von Fehlerquoten oder der Steigerung gelöster Fälle lassen sich erfolgsabhängige Elemente vereinbaren. Bei strategischen Wissensaufgaben ist die Zurechnung schwieriger. Sinnvoll ist häufig ein hybrides Modell aus Grundvergütung, Qualitäts- und Nutzungskennzahlen sowie einem Anteil, der an vereinbarte Geschäftsergebnisse gekoppelt ist.
Der zweite Anwendungsfall entlarvt die Plattformökonomie
Viele Auswahlverfahren konzentrieren sich auf einen ersten, bewusst einfachen Anwendungsfall. Dokumente zusammenfassen, E-Mails formulieren, eine hochgeladene Datei erläutern oder Textvarianten erzeugen sind für allgemeine Modelle gut geeignet, weil nahezu der gesamte Kontext im Prompt liegt. Solche Aufgaben zeigen die Sprachfähigkeit des Modells, aber kaum die Reife einer Unternehmensplattform. Sie lassen sich oft mit wenigen Lizenzen und überschaubarem Einführungsaufwand abdecken.
Der zweite Anwendungsfall ist aussagekräftiger. Soll dasselbe System Lieferantenrechnungen mit Verträgen abgleichen, benötigt es Zugriff auf Vertragsarchiv, ERP, Genehmigungsmatrix, Stammdaten und Ausnahmeregeln. Es muss unterschiedliche Bezeichnungen zusammenführen, Abweichungen erklären, Berechtigungen beachten und bei Unsicherheit an die richtige Rolle eskalieren. Hier verschiebt sich der Wert vom Modell zur Integration und Prozesslogik. Der Anwendungsfall prüft, ob die zuvor aufgebaute Architektur tatsächlich wiederverwendbar ist.
Eine Plattform verdient ihre Bezeichnung, wenn der zweite Einsatz relativ schneller und günstiger wird und sich dieser Effekt bei weiteren Anwendungen verstärkt. Bleibt jeder neue Anwendungsfall ebenso teuer wie der vorherige, existiert keine nennenswerte Verbundökonomie. Dann besitzt das Unternehmen eine Lizenz plus Warteschlange für Beratungsleistungen. Der wichtigste kommerzielle Test besteht deshalb darin, bereits vor der Entscheidung für den ersten Einsatz einen belastbaren Kosten- und Zeitrahmen für den zweiten und dritten zu verlangen.
Diese Betrachtung verändert auch die Investitionsrechnung. Der erste Anwendungsfall darf nicht isoliert mit allen Plattformkosten belastet werden, wenn wesentliche Komponenten später erneut genutzt werden. Umgekehrt ist es unredlich, vage künftige Wiederverwendung als Nutzen anzusetzen, ohne konkrete Folgeprozesse, Eigentümer und Budgets zu benennen. Eine tragfähige Rechnung trennt einmalige Plattforminvestitionen, anwendungsfallspezifische Entwicklung, laufende Modell- und Infrastrukturkosten sowie Kosten für Überwachung, Qualitätssicherung und Veränderungsmanagement. Erst daraus entsteht ein realistischer Gesamtaufwand über mehrere Jahre.
Die Kosten liegen selten nur in den Modellaufrufen
Bei generativer KI richtet sich die Aufmerksamkeit häufig auf Lizenzpreise oder Tokenkosten. Diese Positionen sind sichtbar, aber in komplexen Unternehmensanwendungen oft nicht dominant. Hinzu kommen Datenbereinigung, Schnittstellen, Identitätsmanagement, Sicherheitsprüfungen, Evaluationsdatensätze, Überwachung, Fachbereichszeit, Schulung, Support und laufende Anpassungen. Besonders teuer werden unklare Datenverantwortung, projektspezifische Sonderlösungen und manuelle Nacharbeit bei schwankender Qualität.
Marktstudien zeigen die Spannung zwischen hohen Erwartungen und begrenzter Skalierung. In einer internationalen Befragung von 2.000 Unternehmensleitern erreichte nur etwa ein Viertel der KI-Initiativen bislang den erwarteten Investitionsertrag; nur 16 Prozent waren unternehmensweit skaliert. Gleichzeitig betrachteten 72 Prozent proprietäre Unternehmensdaten als entscheidend für den Wert generativer KI, und 68 Prozent hielten eine integrierte unternehmensweite Datenarchitektur für kritisch. Die Zahlen sind keine Naturgesetze, verdeutlichen aber, dass Modellzugang allein weder Skalierung noch Rendite erzeugt.
Auch sehr hohe Misserfolgsquoten aus Untersuchungen sollten differenziert gelesen werden. Eine viel beachtete Analyse aus dem Jahr 2025 kam zu dem Ergebnis, dass 95 Prozent der betrachteten Initiativen keinen messbaren finanziellen Nutzen erreicht hätten. Methodik, Stichprobe und Definition von Erfolg begrenzen die Verallgemeinerbarkeit; zudem befanden sich viele Vorhaben noch in frühen Phasen. Dennoch weist das Ergebnis auf ein reales Muster hin: Generische Werkzeuge können individuelle Produktivität erhöhen, ohne dass diese Zeitersparnis automatisch in geringere Kosten, höheren Durchsatz oder zusätzlichen Umsatz übersetzt wird.
Für die Investitionsrechnung sind deshalb Prozesskennzahlen wichtiger als Aktivitätskennzahlen. Zahl der Nutzer, Prompts oder erzeugten Texte misst Akzeptanz, nicht wirtschaftlichen Erfolg. Relevanter sind Bearbeitungszeit, Kosten pro Vorgang, Fehlerquote, Nacharbeitsaufwand, Durchsatz, Forderungslaufzeit, Lösungsquote und Kundenzufriedenheit. Produktivitätsgewinne werden erst dann zu einem finanziellen Ergebnis, wenn das Unternehmen Kapazitäten anders einsetzt, Engpässe beseitigt, zusätzliche Leistung verkauft oder tatsächlich Kosten vermeidet.
Ein privates Modell ist noch keine Unternehmens-KI
Die Begriffe private KI, privates Sprachmodell und Unternehmens-KI werden oft vermischt. Ein privates Modell beschreibt primär, unter welchen technischen und vertraglichen Bedingungen ein Modell betrieben wird und wer darauf zugreifen kann. Es kann lokal, in einer dedizierten Cloud-Umgebung oder über einen besonders abgesicherten Dienst laufen. Diese Eigenschaft sagt jedoch wenig darüber aus, ob das System relevante Geschäftsdaten versteht, Berechtigungen korrekt anwendet oder einen Prozess zuverlässig unterstützt.
Ein Unternehmen kann ein Modell vollständig selbst betreiben und dennoch isolierte Daten, schlechte Suchqualität, unklare Verantwortlichkeiten und fehlende Erfolgsmessung haben. Umgekehrt kann eine sorgfältig konfigurierte Cloud-Lösung für bestimmte Datenklassen wirtschaftlicher und ausreichend sicher sein. Die richtige Entscheidung hängt von Sensibilität, Latenz, Volumen, Integrationsbedarf, regulatorischen Anforderungen, internem Betriebsvermögen und strategischer Unabhängigkeit ab. Ein lokaler Betrieb sollte nicht als Statussymbol, sondern als Ergebnis einer Risiko- und Kostenanalyse gewählt werden.
Echte Unternehmens-KI umfasst das Modell, die Kontext- und Integrationsschicht, Governance, Zugriffskontrollen, Prozesslogik, Tests, Überwachung und ein Betriebsmodell mit klarer Verantwortung. Hinzu kommt eine kommerzielle Struktur, die Kostenentwicklung und Ergebnisrisiken transparent macht. Ein privates Modell kann Teil dieser Architektur sein, ersetzt sie aber nicht. Der entscheidende Prüfpunkt lautet nicht, wo allein das Modell läuft, sondern ob das gesamte System einen geschäftlichen Vorgang kontrolliert, nachvollziehbar und wirtschaftlich verbessert.
Diese Unterscheidung schützt auch vor unnötiger technischer Komplexität. Nicht jeder Anwendungsfall benötigt ein großes Modell, und nicht jede Aufgabe ist generativ. Klassische Suchverfahren, Regeln, statistische Modelle oder Prozessautomatisierung können günstiger, stabiler und leichter prüfbar sein. Reife Unternehmensarchitektur bedeutet, generative KI nur dort einzusetzen, wo ihre Fähigkeit zum Umgang mit unstrukturierten Informationen und variabler Sprache einen nachweisbaren Zusatznutzen erzeugt.
Schnelle Einführung braucht enge Grenzen statt großer Versprechen
Ein gut abgegrenzter erster Anwendungsfall auf vorhandenen Systemen sollte eher in Wochen als in vielen Quartalen zu einem produktionsnahen Ergebnis führen. Das bedeutet nicht, dass eine vollständige Transformation in kurzer Zeit abgeschlossen werden kann. Gemeint ist ein enger Prozess mit klaren Nutzern, definierten Datenquellen, messbaren Qualitätsgrenzen und einem kontrollierten Betriebsweg. Wenn bereits dieser Einstieg mehr als ein halbes Jahr benötigt, kann dies auf fehlende Standardkomponenten, unklare Datenlage, übergroßen Umfang oder eine von Grund auf neu gebaute Integrationsarchitektur hinweisen.
Geschwindigkeit darf allerdings nicht mit übereilter Produktivsetzung verwechselt werden. Ein überzeugender Prototyp zeigt nur, dass ein Modell unter günstigen Bedingungen brauchbare Ausgaben erzeugen kann. Für den Betrieb müssen seltene Fälle, veraltete Dokumente, widersprüchliche Daten, Zugriffswechsel, Ausfälle und feindliche Eingaben berücksichtigt werden. Besonders Prompt-Injection-Angriffe können versuchen, über Dokumentinhalte oder Webseiten die Systemanweisungen zu umgehen. Daher braucht es technische Begrenzungen, Inhaltsprüfungen, getrennte Berechtigungen und Tests mit realistischen Störfällen.
Ein sinnvoller Einführungsprozess beginnt mit einem messbaren Problem, nicht mit einem bevorzugten Modell. Danach werden Datenwege, Nutzerrollen, Fehlerrisiken und wirtschaftliche Hebel bestimmt. Es folgt ein begrenzter Pilot mit echten Arbeitsabläufen, einer Vergleichsbasis und klaren Abbruchkriterien. Erst wenn Qualität, Akzeptanz, Sicherheit und Prozesswirkung belegt sind, wird skaliert. Diese Stufung reduziert versunkene Kosten und verhindert, dass ein technisch attraktiver Versuch jahrelang ohne belastbaren Geschäftsnutzen weiterfinanziert wird.
Entscheidend ist außerdem das Veränderungsmanagement. Beschäftigte müssen verstehen, wofür das System geeignet ist, wo seine Grenzen liegen und wie Fehler gemeldet werden. Fachwissen darf nicht stillschweigend durch vermeintliche Automatisierung entwertet werden. Die besten Ergebnisse entstehen häufig, wenn erfahrene Mitarbeiter an Evaluationsfällen, Ausnahmeregeln und Rückmeldeschleifen beteiligt sind. So wird aus individueller Korrektur ein lernender organisatorischer Prozess, auch wenn das Basismodell selbst nicht aus jedem Gespräch dauerhaft lernt.
Vier Prüfsteine trennen Plattformen von neu verpackten Chatbots
Die erste Kernfrage lautet, ob das System das Unternehmen bereits im zulässigen Umfang kennt oder ob Nutzer bei jedem Vorgang den Kontext erneut zusammenstellen müssen. Eine aussagekräftige Vorführung verwendet deshalb eigene Daten, eigene Fachbegriffe und reale Berechtigungen statt einer vorbereiteten Musterdatenbank. Geprüft werden sollten nicht nur richtige Antworten, sondern auch der Umgang mit fehlenden, widersprüchlichen und unzulässigen Informationen. Ein verlässliches System muss Grenzen erkennen und Unsicherheit sichtbar machen.
Die zweite Frage betrifft den vollständigen Datenweg. Unternehmen sollten Verarbeitungspfad, Speicherorte, Aufbewahrungsregeln, Unterauftragnehmer, Protokollierung und Löschmöglichkeiten schriftlich prüfen. Ebenso wichtig ist, ob die Architektur Daten in bestehenden Systemen belassen kann und nur notwendige Ausschnitte bereitstellt. Aussagen über Sicherheit sind erst belastbar, wenn sie einer konkreten Produktvariante und Konfiguration zugeordnet werden können.
Die dritte Frage lautet, wer für das vereinbarte Ergebnis wirtschaftlich und organisatorisch einsteht. Zu klären ist, was geschieht, wenn Genauigkeit, Durchsatz, Bearbeitungszeit oder andere Zielwerte nicht erreicht werden. Reine Verweise auf eine künftige Produktplanung zeigen eine Verantwortungslücke. Gleichzeitig muss das Unternehmen eigene Pflichten anerkennen, insbesondere für Datenqualität, Prozessdefinition, Nutzertraining und fachliche Entscheidungen. Ergebnisverantwortung lässt sich nicht vollständig auslagern.
Die vierte Frage ist die nach den Kosten des zweiten Anwendungsfalls. Anbieter sollten zeigen, welche Verbindungen, Rechte, Definitionen, Tests und Betriebsfunktionen erneut genutzt werden. Eine nachvollziehbare Kalkulation für einen Folgeprozess ist aussagekräftiger als eine allgemeine Plattformfolie. Sie macht sichtbar, ob Skaleneffekte real sind oder ob jede Erweiterung ein neues Integrationsprojekt auslöst. Diese vier Fragen richten den Blick bewusst weg vom Modellnamen und hin zu Kontext, Datenhoheit, Verantwortung und kumulierendem wirtschaftlichem Nutzen.
Die passende Betriebsarchitektur ist risikobasiert, nicht ideologisch
Für die meisten Unternehmen gibt es nicht die eine richtige Bereitstellungsform. Ein Portfolioansatz ist wirtschaftlich sinnvoller. Öffentliche Inhalte und risikoarme Schreibaufgaben können über standardisierte Unternehmensassistenten laufen. Interne Wissensabfragen benötigen kontrollierte Konnektoren, Berechtigungsprüfung und Quellenbelege. Kritische Fachprozesse verlangen strengere Datenwege, reproduzierbare Tests, menschliche Freigaben und gegebenenfalls dedizierte oder lokale Verarbeitung. Hochwirksame automatisierte Aktionen brauchen zusätzlich eng begrenzte Werkzeuge, transaktionale Kontrollen und Rücknahmeverfahren.
Diese Abstufung verhindert zwei teure Extreme. Das erste besteht darin, sämtliche Daten in einen allgemeinen Assistenten zu geben und auf Vertragsklauseln zu vertrauen. Das zweite besteht darin, jede KI-Funktion vollständig selbst zu entwickeln und zu betreiben. Zwischen beiden Polen liegen verwaltete Cloud-Dienste, regionale Verarbeitung, kundeneigene Schlüssel, private Netzwerkpfade, dedizierte Instanzen, lokale Modelle und hybride Architekturen. Ihre Kombination sollte anhand des konkreten Risikos gewählt werden.
Auch die Modellwahl kann abgestuft erfolgen. Kleine Modelle sind häufig günstiger, schneller und für enge Aufgaben ausreichend. Größere Modelle können bei komplexer Sprache, Planung oder uneinheitlichen Dokumenten überlegen sein. Ein intelligenter Router kann Aufgaben nach Sensibilität, Komplexität und Kosten unterschiedlichen Modellen zuweisen. Voraussetzung ist ein einheitliches Evaluationssystem, damit Preisvorteile nicht durch höhere Fehler- und Nacharbeitskosten aufgezehrt werden.
Langfristig wird damit nicht das leistungsstärkste Einzelmodell zum wichtigsten Vermögenswert, sondern die Fähigkeit des Unternehmens, Modelle sicher und schnell in produktive Prozesse einzusetzen. Diese Fähigkeit besteht aus Datenqualität, modularer Architektur, Fachwissen, Governance und einer Kultur messbarer Verbesserung. Sie ist schwerer zu kopieren als eine Lizenz und bleibt wertvoll, wenn sich der führende Modellanbieter ändert.
Vom KI-Projekt zum betriebswirtschaftlichen Betriebssystem
Die strategische Perspektive verschiebt sich von der Frage, welcher Assistent angeschafft werden soll, zur Frage, welche betrieblichen Fähigkeiten aufgebaut werden müssen. Unternehmen benötigen einen katalogisierten Bestand an Datenquellen, klar benannte Verantwortliche, standardisierte Zugriffswege, ein Modellportfolio, wiederverwendbare Evaluationsverfahren und eine Priorisierung nach wirtschaftlichem Wert. Ohne dieses Fundament entstehen viele isolierte Werkzeuge, deren Nutzen schwer vergleichbar ist und deren Risiken sich addieren.
Die Auswahl von Anwendungsfällen sollte auf wiederkehrende, datenreiche und reibungsintensive Prozesse zielen. Besonders attraktiv sind Übergaben zwischen Funktionen und Systemen, bei denen Beschäftigte Informationen suchen, vergleichen, übertragen oder erklären müssen. Dort kann generative KI unstrukturierte Inhalte erschließen und klassische Automatisierung ergänzen. Weniger geeignet sind Prozesse ohne klare Datenbasis, ohne messbaren Ausgangszustand oder mit extrem hohen Fehlerfolgen und geringer Kontrollmöglichkeit.
Das Management sollte für jeden priorisierten Fall eine wirtschaftliche Hypothese formulieren. Diese beschreibt, welcher Engpass beseitigt wird, welche Kennzahl sich verändert, welche Kosten vollständig anfallen und wie der Effekt im Betrieb realisiert werden soll. Eine angenommene Zeitersparnis genügt nicht. Es muss klar sein, ob die frei werdende Zeit mehr Fälle ermöglicht, Wartezeiten senkt, Qualität erhöht oder tatsächlich Personal- und Fremdkosten vermeidet. Erst diese Verbindung macht aus technischer Produktivität einen ökonomischen Ertrag.
Parallel braucht es eine Architekturentscheidung, die über den ersten Pilot hinausweist, ohne sofort eine überdimensionierte Plattform zu bauen. Ein schmaler gemeinsamer Kern aus Identität, Protokollierung, Modellzugang, Datenkonnektoren und Evaluation kann schrittweise wachsen. Jede neue Anwendung sollte diesen Kern verbessern und möglichst wenig Sonderlogik erzeugen. So entsteht kumulierende Fähigkeit statt einer Sammlung von Demonstrationen.
Die eigentliche Kaufentscheidung liegt rund um das Modell
Modelle werden leistungsfähiger, günstiger und stärker in Standardsoftware integriert. Dadurch sinkt der Differenzierungswert des bloßen Zugangs. Was Unternehmen tatsächlich erwerben oder selbst aufbauen, sind die Komponenten rund um das Modell: geschäftlicher Kontext, kontrollierte Datenverwahrung, verlässliche Integration, nachvollziehbare Entscheidungen, organisatorische Verantwortung und eine Kostenkurve, die mit weiteren Anwendungsfällen günstiger wird. Diese Elemente entscheiden darüber, ob KI ein Produktivitätswerkzeug einzelner Beschäftigter bleibt oder zu einer unternehmensweiten Fähigkeit wird.
Eine Unternehmenslizenz ist dafür weder wertlos noch ausreichend. Sie bildet häufig die vernünftige Untergrenze für allgemeine Aufgaben und kann Schatten-KI reduzieren. Für regulierte oder geschäftskritische Prozesse muss sie jedoch durch Datenarchitektur, Governance, Prozessgestaltung und messbare Ergebnisverantwortung ergänzt werden. Ebenso wenig ist ein privates Modell allein die Lösung. Technische Abgeschlossenheit ohne Kontext und Betriebskonzept erzeugt lediglich eine privat betriebene Insel.
Die stärkste Warnung liefert der zweite Anwendungsfall. Wenn erneut alle Datenverbindungen, Regeln, Tests und Zuständigkeiten aufgebaut werden müssen, war der erste Erfolg kein Plattformeffekt, sondern ein Einzelprojekt. Wenn dagegen wesentliche Komponenten wiederverwendet werden und die Zeit bis zum Nutzen sinkt, beginnt echte Unternehmensökonomie. Der Wert liegt dann nicht in einer spektakulären Demonstration, sondern in einer lernenden Infrastruktur, die immer mehr Prozesse zu niedrigeren Grenzkosten verbessert.
Beschäftigte, die bereits mit privaten Konten abgestimmt haben, sind deshalb nicht nur ein Sicherheitsproblem. Sie zeigen, wie hoch der Bedarf und wie niedrig die Toleranz für schlechte Werkzeuge ist. Die Aufgabe der Unternehmensführung besteht darin, diese Nachfrage in eine kontrollierte, bessere Alternative zu überführen: ein System, das das Geschäft kennt, sensible Daten angemessen schützt, Fehler verantwortbar behandelt und beim nächsten Einsatz nicht wieder bei null beginnt. Alles darunter bleibt ein Chatbot mit Login – nützlich, oft beeindruckend, aber noch keine Enterprise-KI.
Beratung - Planung - Umsetzung

Konrad Wolfenstein
Gerne stehe ich Ihnen als persönlicher Berater zur Verfügung.
Sie können mit mir unter wolfenstein∂xpert.digital Kontakt aufnehmen oder
mich einfach unter +49 7348 4088 965 anrufen.