Podniková umělá inteligence začíná tam, kde končí chatbot
Předběžné vydání Xpertu

K dispozici ve 27 jazycích 📢
Preferujte Xpert.Digital na GoogluⓘPublikováno: 2. října 2026 / Aktualizováno: 2. října 2026 – Autor: Konrad Wolfenstein
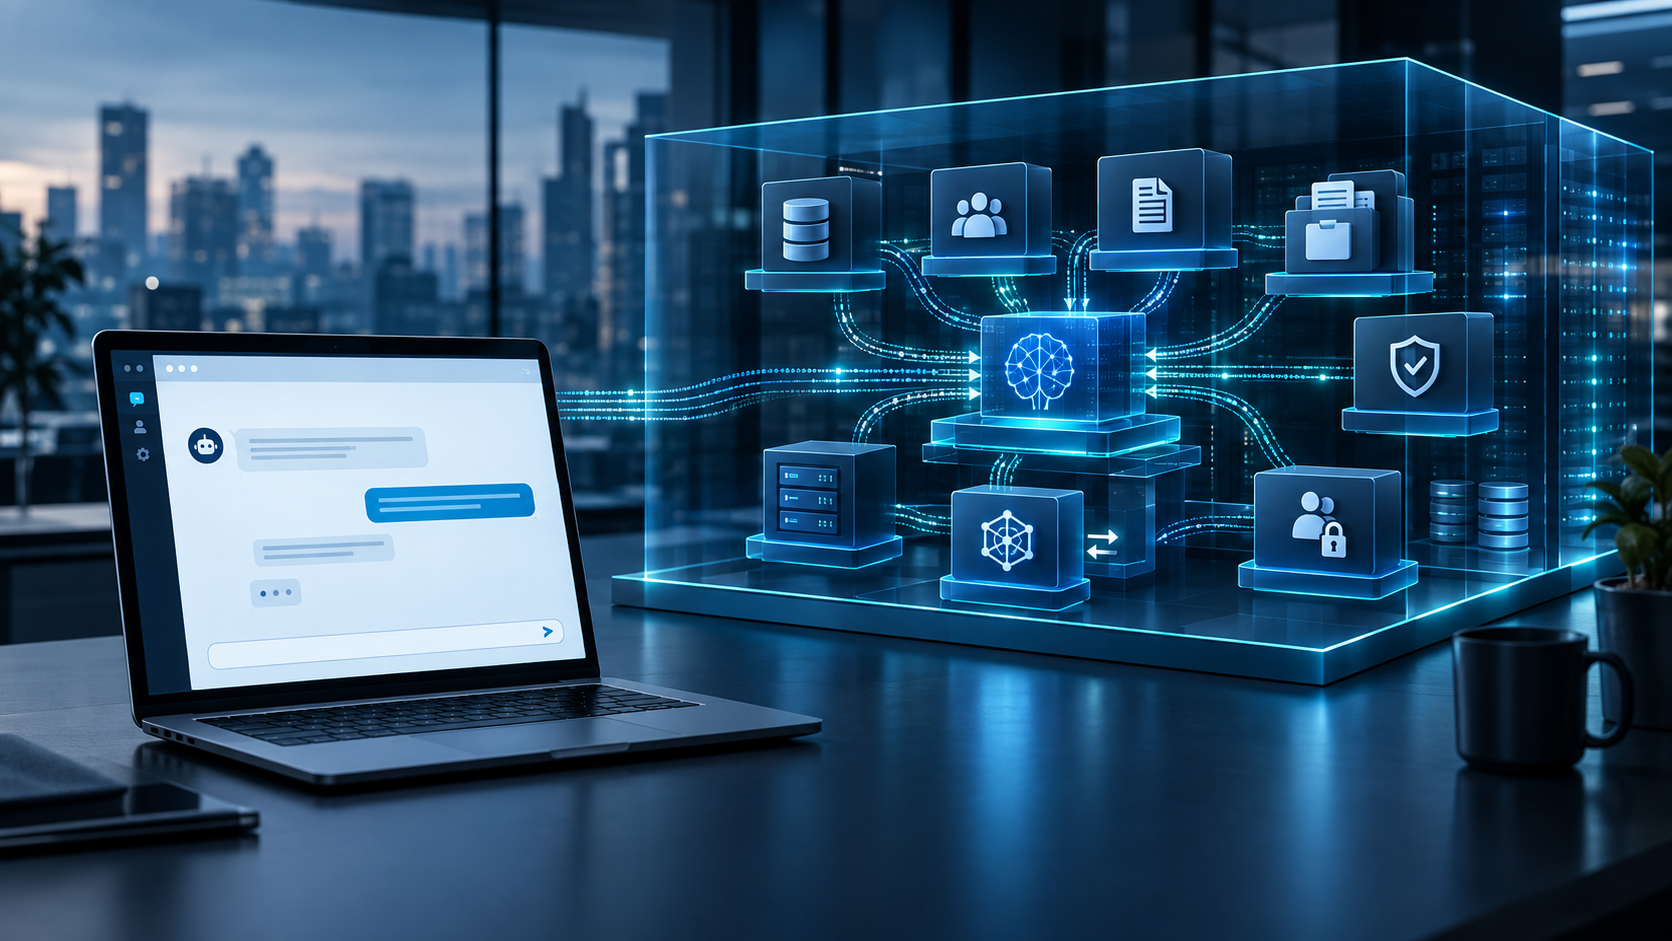
Podniková umělá inteligence začíná tam, kde končí chatbot – kreativní obrázek na dané téma s umělou inteligencí: Xpert.Digital
Od licence k odpovědnosti: Jak by firmy měly přehodnotit svou strategii v oblasti umělé inteligence
Takto firmy zmenšují propast mezi nadějemi v oblasti umělé inteligence a realitou
Důležitost kontextové vrstvy pro efektivní podnikovou umělou inteligenci
V dnešní digitální krajině je integrace umělé inteligence (AI) do obchodních procesů stále důležitější. Mnoho společností však čelí problému, že jejich zaměstnanci se často spoléhají na neautorizované, soukromé služby AI – což je praxe známá jako stínová AI. Tento vývoj odhaluje kritickou mezeru mezi řešeními poskytovanými společnostmi a skutečnými potřebami uživatelů na pracovišti. Podnikové licence pro zavedené nástroje AI jsou sice považovány za základní opatření, ale samy o sobě nestačí k uspokojení složitých požadavků a specifických okolností podniku. Skutečně generativní podniková AI vyžaduje dobře navrženou systémovou architekturu, která zahrnuje modely, přístup k datům, logiku procesů a odpovědnost. V tomto článku zkoumáme základní aspekty, které musí společnosti zvážit, aby plně využily potenciál AI a účinně bojovaly proti stínové AI.
Souvisí s tím:
Pouhá distribuce licencí nedigitalizuje společnost – digitalizuje její problém stínové umělé inteligence
V mnoha firmách se o budoucnosti generativní umělé inteligence nerozhoduje na strategické schůzce, ale v nenápadném okamžiku v práci: Zaměstnanec zkopíruje smlouvu se zákazníkem, výpočet nebo interní e-mail do veřejně dostupné služby umělé inteligence, protože soukromě používaný nástroj se zdá rychlejší, srozumitelnější a výkonnější než oficiálně schválené firemní řešení. Z pohledu zaměstnance se často nejedná o úmyslné porušení pravidel, ale o pragmatickou reakci na neefektivní procesy. Z pohledu firmy to naznačuje nebezpečnou propast mezi technickým schválením a skutečnou použitelností.
Běžný reflex překlenout tuto mezeru zakoupením celofiremní licence pro známého asistenta s umělou inteligencí selhává. Taková licence může poskytnout důležité záruky, administrativní funkce a smluvní závazky. Automaticky však netransformuje obecného asistenta na systém, který rozumí firemním produktům, zákazníkům, smlouvám, rolím, hranicím schvalování a pracovním postupům. Ani automaticky neodpovídá na otázky typu, kde se zpracovávají citlivá data, kdo je zodpovědný za nesprávné výsledky nebo zda lze po počátečním použití vyvinout další procesy s rozumnými marginálními náklady.
Ústřední ekonomická teze tedy zní takto: Skutečná generativní podniková umělá inteligence není jediný model ani chatovací okno s logem společnosti. Je to operační systém složený z modelů, přístupových bodů k datům, kontextu, identit, oprávnění, procesní logiky, kontrol kvality, odpovědností a robustní architektury nákladů. Skutečná hodnota nepramení z přístupu k umělé inteligenci, ale z její řízené integrace do organizace. Právě zde se produktivní obchodní složka liší od pohodlného spotřebitelského produktu s firemním přihlášením.
Firemní licence je základem, ale ještě ne budovou
Podnikové verze hlavních asistentů umělé inteligence řeší problémy reálného světa. Dodavatelé se obvykle zavazují, že k trénování svých univerzálních modelů nebudou standardně používat obchodní vstupy a výstupy. Mezi další funkce patří centralizovaná správa uživatelů, jednotné přihlašování, řízení přístupu na základě rolí, protokolování, šifrování, zprávy o používání, dohody o zpracování dat a částečně konfigurovatelné doby uchovávání. Stávající přístupová práva, zásady a bezpečnostní mechanismy lze navíc využít v rámci zavedených kancelářských platforem. Pro mnoho organizací to představuje významné zlepšení oproti osobním účtům.
Chyba nespočívá v nákupu takových licencí. Chyba spočívá v záměně jejich rozsahu ochrany za kompletní podnikové řešení. Závazek nepoužívat zákaznická data pro obecné trénování modelů odpovídá pouze na jednu z několika otázek týkajících se dat. Otevřenými otázkami mohou zůstat umístění zpracování, ukládání vstupů a výstupů, doba uchovávání, zapojení subdodavatelů, zpracování telemetrie a příslušné jurisdikce. Kromě toho se chatovací produkt, programovací rozhraní, integrovaný kancelářský asistent a cloudová instance specifická pro zákazníka často výrazně liší. Plošné vydání založené na značce je proto nedostatečné jak z obchodního, tak z regulačního hlediska.
Především samotné licenci chybí institucionální paměť. Model automaticky nezná specifický význam názvu produktu pro danou společnost, historii stížností ani to, který z několika zákaznických systémů je pro konkrétní proces směrodatný. Nerozpoznává neformální výjimky ani schvalovací matici a nemůže nezávisle určit, zda je použitelná zastaralá politika nebo její nástupce. Přístup k modelu je zakoupen; provozní spolehlivost však musí být neustále budována, testována a udržována.
Stínová umělá inteligence je úsudek trhu ze strany vlastních zaměstnanců společnosti
Používání soukromých účtů s umělou inteligencí je často považováno za disciplinární nebo školicí problém. To je příliš zjednodušující. Když se zaměstnanci navzdory zákazům uchýlí k neoprávněným nástrojům, poskytují neúmyslnou zpětnou vazbu na trh: Schválená možnost v přímém srovnání prohrává z hlediska rychlosti, použitelnosti, kvality modelu nebo praktické integrace do pracovních procesů. Zákazy mohou krátkodobě snížit rizika, ale neodstraňují poptávku po lepším řešení.
Rozsah je značný. Zprávy ukazují, že do roku 2026 bude 47 procent zaměstnanců používajících generativní umělou inteligenci na pracovišti stále používat osobní, nespravované účty. Současně se zdvojnásobil počet zaznamenaných incidentů zahrnujících přenos citlivých dat do aplikací umělé inteligence. V průměru bylo zaznamenáno 223 takových porušení zásad na organizaci měsíčně; u obzvláště postižených společností byla zátěž mnohonásobně vyšší. Obzvláště velký podíl těchto porušení tvořily regulované osobní, finanční a lékařské údaje. Takové metriky zachycují pouze viditelné incidenty a je nepravděpodobné, že by plně odrážely skutečné využití.
Z ekonomického hlediska tak centrální IT konkuruje bezplatné nebo soukromě financované alternativě. Tato alternativa má nízké vstupní bariéry, dobrou uživatelskou zkušenost a často je nejnovějším modelem. Interní alternativa nevítězí pouze na základě souladu s předpisy, ale pouze pokud je alespoň stejně pohodlná a nabízí dodatečnou obchodní hodnotu. Musí vyhledávat relevantní informace, být dostupná ve stávajících aplikacích, vyhýbat se zbytečnému kopírování a zasazovat odpovědi do kontextu pracovního procesu. Trvalého přijetí se nedosahuje nátlakem, ale většími výhodami s menším osobním úsilím.
To neznamená, že technické kontroly jsou zbytečné. Prevence ztráty dat, omezení klientů, ovládací prvky prohlížeče, protokolování a jasná pravidla používání zůstávají zásadní. Jejich účinnost se však výrazně zvyšuje, pokud je k dispozici i vysoce výkonná alternativa. Správnou reakcí managementu proto není jen blokování stínové umělé inteligence, ale analýza jejích základních příčin: Pro jaké úkoly ji zaměstnanci používají? Které autorizované systémy selhávají? Jaká neefektivnost nutí lidi používat soukromé účty? Tyto odpovědi povedou k realistickému seznamu priorit pro podnikovou umělou inteligenci.
Firemní znalosti se nevytvářejí v okně chatu
Obecní asistenti s umělou inteligencí začínají proces primárně s kontextem poskytnutým uživatelem nebo odvoděným produktem z omezených předchozích interakcí. Tato neutralita je často užitečná pro osobní úkoly. V obchodním kontextu se však stává rizikem, jakmile rozhodnutí závisí na historických, smluvních nebo zákaznicky specifických informacích. Například spolehlivé reakce na pojistnou událost lze dosáhnout pouze kombinací historie pojistných událostí, verze pojistky, korespondence, regulačních požadavků a stavu zpracování. Jedna nahraná smlouva pro tento účel nestačí.
Potřebné znalosti se zřídka nacházejí na jednom místě. Jsou rozptýleny v ERP systémech, CRM, systémech správy dokumentů, systémech pro prodej tiketů, datových skladech, e-mailu, specializovaných aplikacích a osobních souborech. Kromě toho existují různé identifikátory, pravopisy, verze dat a odpovědnosti. Zákazník může být ve třech systémech uveden pod různými jmény; kód produktu mohl po sloučení získat jiný význam; politika může být stále formálně dostupná, ale technicky nahrazena. Jazykový model sám o sobě tyto rozpory nevyřeší. Bez spolehlivého mapování může v nejlepším případě vytvořit jazykově přesvědčivou syntézu nekonzistentních dat.
Poskytování kontextu je proto primárně úkolem integrace a správy dat. Generování s rozšířeným vyhledáváním, tj. cílené poskytování relevantního obsahu v okamžiku požadavku, je důležitou metodou, ale nikoli kompletním řešením. Vyžadují se také metadata, verzování, ověřování identity, kontroly autorizace, priorita zdrojů, doby platnosti a pravidla pro konfliktní informace. Čím více je systém určen k akci, než k pouhé reakci, tím důležitější se stávají transakční kontroly a jasně definované vedení systému.
Jednoduchý test může odhalit vyspělost: Schválenému nástroji je předložena otázka, jejíž správná odpověď vyžaduje pouze interní znalosti společnosti. Pokud poskytne obecnou, jistou a nesprávnou odpověď, funkčně se jedná o chatbota s firemním přístupem. Pokud pouze požaduje soubor, jedná se o chatbota s funkcí nahrávání. Skutečná firemní inteligence se projeví pouze tehdy, když přistupuje k příslušným systémům legitimně, transparentně a v reálném čase, rozpoznává nejistotu a zasazuje odpověď do kontextu společnosti.
Kontextová vrstva se stává produktivním kapitálem
Klíčová architektonická složka se nachází mezi modelem a provozním podnikáním. Tuto vrstvu lze popsat jako kontextovou platformu, znalostní strukturu nebo integrační a orchestrační vrstvu. Její název je méně důležitý než její funkce: mapuje entity na sebe, propojuje zdroje dat, kontroluje oprávnění, poskytuje definice, řídí nástroje a dokumentuje, jak vznikla odpověď nebo akce. V ideálním případě se tato práce nezačíná znovu pro každý případ užití, ale spíše se vytváří jako opakovaně použitelný podnikový stavební blok.
Z ekonomického hlediska se tato vrstva podobá produktivnímu kapitálu. Počáteční připojení k archivu smluv, první čisté přiřazení identit zákazníků nebo první implementace schvalovací logiky s sebou nese vysoké počáteční náklady. Jakmile jsou však tyto prvky standardizovány, lze na nich stavět další případy užití. Mezní náklady na druhé, třetí a páté použití by se měly snížit. Už jen tento efekt ospravedlňuje strategii platformy: Část investice se stane použitelnou nejen pro jeden projekt, ale pro rostoucí počet budoucích procesů.
K tomuto efektu opětovného použití však nedochází automaticky. Mnoho předpokládaných platforem se skládá ze souboru rozhraní, výzev a vlastních řešení specifických pro daný projekt. Každá nová aplikace pak musí být znovu analyzována, integrována a zajištěna. Křivka nákladů zůstává lineární, zatímco vznikají další závislosti. Skutečným testem zralosti je proto určení, které konkrétní komponenty z prvního případu užití lze znovu použít v druhém bez nutnosti opětovné sestavy. Mezi opakovaně použitelné komponenty patří například služby identity, konektory, řízení přístupu, datové katalogy, vyhodnocovací postupy, protokolování, přístup k modelu a standardizované lidské schvalování.
Kontextová vrstva je strategicky důležitější než závazek k jedinému modelu. Modely se rychle zlepšují, ceny se mění a různé úkoly těží z různých silných stránek. Společnosti proto potřebují možnost kontrolovaně přepínat mezi modely nebo jich používat několik paralelně. Přepínání však není zcela zdarma: liší se chování při výzvách, výstupní formáty, bezpečnostní filtry, kontextová okna a výkonnostní profily. Dobrá architektura snižuje tyto náklady na přepínání prostřednictvím abstrakce, standardizovaných rozhraní a opakovatelných testů, spíše než vytvářením nerealistického dojmu úplné zaměnitelnosti.
Datová suverenita zahrnuje více než jen vyloučení školení
Veřejná debata se dlouhodobě zaměřuje na to, zda se vstupy používají k trénování modelu. I když je tato otázka pro firmy důležitá, je její zaměření příliš úzké. Klíčový je celý řetězec ukládání a zpracování: Kde se vstupy zpracovávají? Které části dokumentu se přenášejí? Kam se ukládají historie chatu, mezipaměti, protokoly a vektorové reprezentace? Jak dlouho se uchovávají? Kteří subdodavatelé mají technické kontaktní body? Jaký právní rámec se uplatňuje? Mohou administrátoři prohlížet, exportovat a mazat obsah? Jak se nakládá se zálohami?
Marketingové oddělení může za určitých okolností zodpovědně používat externě zpracovaný návrh. Pro nepublikované obchodní údaje, obchodní tajemství, zdravotní údaje, právní případy nebo kritickou infrastrukturu platí různé standardy. Třída rizika by proto neměla být založena pouze na použitém nástroji, ale spíše na typu dat, provedených opatřeních, potenciálních škodách a úrovni lidského dohledu. Stejný model může představovat nízké riziko při přepisování veřejné tiskové zprávy a vysoké riziko při automatickém zpracování půjčky nebo pohledávky.
Robustní architektura minimalizuje pohyb dat. Informace zůstávají co nejvíce v rámci stávajících systémů; poskytuje se pouze kontext nezbytný pro daný úkol, v souladu se stávajícími pravidly přístupu. Dotazy jsou autorizovány na základě specifických pro daného uživatele, citlivá pole jsou v případě potřeby maskována a výstup je klasifikován podle svého obsahu. Pro obzvláště kritické procesy může být vhodné regionální zpracování, vyhrazené instance, důvěrná výpočetní prostředí nebo lokální nasazení. Plně interní provoz však není automaticky ani bezpečnější, ani ekonomičtější, protože provoz, opravy, monitorování, údržba modelu a specializovaný personál s sebou nesou značné náklady.
Vzorec pro přenesení modelu do dat tedy popisuje rozumný princip, ale neměl by být špatně chápán jako technické zjednodušení. I u federovaných nebo lokálně propojených řešení se výňatky, vkládání nebo metadata mohou dostat k externím službám. Zdokumentovaná analýza toku dat na úrovni komponent je klíčová. Pouze tehdy, když lze pro každou fázi prokázat, která data kam jdou a jak jsou chráněna, lze spolehlivě posoudit datovou suverenitu.
Regulace činí ze sledovatelnosti ekonomický faktor
V regulovaných odvětvích není tok dat abstraktním bezpečnostním ideálem. Finanční instituce musí podle evropských pravidel pro digitální provozní odolnost systematicky posuzovat rizika, která představují informační a komunikační technologie, jakož i poskytovatelé třetích stran. Dohody o mlčenlivosti, profesní tajemství, zákony na ochranu osobních údajů a odvětvové předpisy rovněž vyžadují, aby společnosti byly schopny vysvětlit činnosti zpracování, odpovědnosti a kontrolní opatření. Aplikace umělé inteligence, jejíž kvalita odezvy je přesvědčivá, ale jejíž datová cesta není auditovatelná, nemůže projít provozním akceptačním testováním.
S evropským právem v oblasti umělé inteligence nabývá systematická správa na významu. Velké části evropského regulačního rámce platí od srpna 2026, zatímco jednotlivé povinnosti pro určité vysoce rizikové systémy budou platit postupně. To nevede k plošnému zákazu generativní umělé inteligence pro společnosti. Spíše je zapotřebí robustní klasifikace založená na oblasti použití a roli. Obecný model, specializovaný systém na něm postavený a společnost, která tento systém používá, mohou mít různé povinnosti. Pro vysoce rizikové aplikace jsou obzvláště důležité transparentnost, dokumentace, lidský dohled, kvalita dat, přesnost, kybernetická bezpečnost a sledovatelnost.
Dodržování předpisů není pouze nákladovým faktorem. Znovupoužitelná architektura řízení může zkrátit dobu uvedení na trh, protože ne každý projekt musí znovu vymýšlet svá pravidla. Standardizované třídy rizik, schválené modelové cesty, technické protokolování, šablony hodnocení a definované úrovně schvalování snižují nejistotu. Řízení se tak transformuje z následné kontrolní funkce na produktivní infrastrukturu. Ekonomická výhoda se stává obzvláště patrnou během druhého a třetího nasazení, kdy lze testované komponenty znovu použít.
Společnosti by také měly rozlišovat mezi modelovým rizikem a procesním rizikem. Model může být technicky výkonný, zatímco špatně navržený proces může nadále používat nesprávné zdroje dat, mít nejasné odpovědnosti nebo neumožňovat zvrácení chybných akcí. Naopak omezený model může být velmi prospěšný v přesně definovaném a dobře kontrolovaném procesu. Proto je kvalita celkové architektury častěji rozhodujícím faktorem pro regulační a ekonomickou životaschopnost než špičkový výkon modelu v obecných testech.
🤖🚀 Platforma spravované umělé inteligence: Rychlejší, bezpečnější a chytřejší řešení umělé inteligence s UNFRAME.AI

Platforma spravované umělé inteligence – obrázek: Xpert.Digital
Zde se dozvíte, jak může vaše společnost rychle, bezpečně a bez vysokých vstupních bariér implementovat řešení umělé inteligence na míru.
Spravovaná platforma umělé inteligence je vaším komplexním a bezstarostným řešením pro umělou inteligenci. Místo řešení složitých technologií, drahé infrastruktury a zdlouhavých vývojových procesů získáte hotové řešení šité na míru vašim potřebám od specializovaného partnera – často během několika dní.
Klíčové výhody na první pohled:
⚡ Rychlá implementace: Od nápadu k aplikaci připravené k použití během několika dnů, nikoli měsíců. Dodáváme praktická řešení, která vytvářejí okamžitou přidanou hodnotu.
🔒 Maximální zabezpečení dat: Vaše citlivá data zůstanou u vás. Garantujeme bezpečné a kompatibilní zpracování bez sdílení dat s třetími stranami.
💸 Žádné finanční riziko: Platíte pouze za výsledky. Vysoké počáteční investice do hardwaru, softwaru nebo personálu jsou zcela eliminovány.
🎯 Zaměřte se na své hlavní podnikání: Soustřeďte se na to, co děláte nejlépe. Postaráme se o kompletní technickou implementaci, provoz a údržbu vašeho řešení s umělou inteligencí.
📈 Připraveno na budoucnost a škálovatelné: Vaše umělá inteligence roste s vámi. Zajišťujeme neustálou optimalizaci a škálovatelnost a flexibilně přizpůsobujeme modely novým požadavkům.
Více informací zde:
Od projektu s umělou inteligencí k operačnímu systému pro firmy
Zodpovědnost nesmí zmizet mezi licencováním a poradenstvím
Služby umělé inteligence orientované na spotřebitele se prodávají jako nástroje. Poskytovatelé správně poukazují na to, že výdaje mohou být nepřesné a že uživatelé musí výsledky ověřit. Tento model je pochopitelný pro nízkonákladový masový trh. V obchodních aplikacích však vzniká mezera v odpovědnosti, jakmile se tyto výdaje dostanou k zákazníkům, ovlivní regulační reporting nebo spustí finanční procesy. Poskytovatel přístupu prodává možnost používat službu, ale obvykle nepřebírá odpovědnost za výsledek konkrétního obchodního procesu.
I tradiční model integrace může tuto mezeru nechat otevřenou. Poskytovatel služeb analyzuje, vyvíjí a integruje po dobu několika měsíců, fakturuje čas a materiál a nakonec dodá systém. Smlouva může být formálně splněna, i když je nástroj v každodenním používání špatně přijat, produkuje příliš mnoho chyb nebo nedosahuje žádného měřitelného zlepšení procesu. Na jedné straně byl prodán přístup, na druhé straně práce. V obou případech není nikdo nutně finančně vázán dohodnutým výsledkem.
Podniková umělá inteligence proto vyžaduje explicitní rozdělení odpovědnosti. Obchodní jednotky, IT, informační bezpečnost, ochrana dat, řízení rizik a dodavatelé musí vědět, kdo je zodpovědný za kvalitu dat, kdo vybírá modely, kdo stanovuje limity, kdo schvaluje výdaje a kdo rozhoduje v případě narušení. Pro automatizované akce je nezbytná sledovatelnost, možnosti zrušení a jasně definované eskalace. Lidská kontrola je účinnou kontrolou pouze tehdy, má-li kontrolor dostatek času, odborných znalostí a informací; rutinní kliknutí redukuje lidský dohled na pouhou formalitu.
Modely odměňování orientované na výsledky mohou zlepšit motivaci, ale nejsou všelékem. Fungují pouze tehdy, jsou-li výsledky měřitelné, přiřaditelné a chráněné před manipulací. Pro jasný proces, jako je zkrácení doby zpracování, snížení chybovosti nebo zvýšení počtu vyřešených případů, lze dohodnout prvky založené na výkonu. Atribuce je obtížnější u strategických úkolů založených na znalostech. Často se doporučuje hybridní model, který se skládá ze základního platu, metrik kvality a využití a složky vázané na dohodnuté obchodní výsledky.
Druhý případ použití odhaluje ekonomiku platformy
Mnoho výběrových procesů se zaměřuje na první, záměrně jednoduchý případ použití. Shrnutí dokumentů, psaní e-mailů, vysvětlení nahraného souboru nebo generování textových variant se dobře hodí pro obecné modely, protože téměř celý kontext je k dispozici na výzvu. Takové úkoly demonstrují jazykové možnosti modelu, ale stěží vyspělost podnikové platformy. Často je lze pokrýt jen několika licencemi a zvládnutelným implementačním úsilím.
Druhý případ užití je informativnější. Pokud má stejný systém odsouhlasovat faktury dodavatelů se smlouvami, vyžaduje přístup k archivu smluv, ERP systému, schvalovací matici, kmenovým datům a pravidlům výjimek. Musí konsolidovat různá označení, vysvětlovat nesrovnalosti, respektovat autorizace a v případě nejistoty eskalovat problémy na příslušnou roli. Zde se pozornost přesouvá z modelu na integrační a procesní logiku. Tento případ užití ověřuje, zda je dříve zavedená architektura skutečně znovu použitelná.
Platforma si zaslouží své jméno, když se druhé nasazení stane relativně rychlejším a levnějším a tento efekt se umocňuje s následnými aplikacemi. Pokud každý nový případ použití zůstává stejně drahý jako ten předchozí, neexistuje žádná významná synergická ekonomika. V takovém případě společnost vlastní licenci a čekací listinu na konzultační služby. Nejdůležitějším komerčním testem je proto požadovat spolehlivé náklady a časový rámec pro druhé a třetí nasazení ještě předtím, než se vůbec rozhodne pro první.
Tato perspektiva také mění výpočet investic. Počáteční případ užití by neměl být zatížen všemi náklady na platformu izolovaně, pokud jsou významné komponenty později znovu použity. Naopak je nečestné považovat vágní budoucí opětovné použití za výhodu bez specifikace konkrétních následných procesů, vlastníků a rozpočtů. Správný výpočet odděluje jednorázové investice do platformy, vývoj specifický pro daný případ užití, průběžné náklady na model a infrastrukturu a náklady na monitorování, zajištění kvality a řízení změn. Teprve poté lze stanovit realistické celkové výdaje za několik let.
Náklady lze zřídka připsat výhradně volání modelu
U generativní umělé inteligence se pozornost často zaměřuje na licenční poplatky nebo náklady na tokeny. Tyto náklady jsou viditelné, ale v komplexních podnikových aplikacích často nejsou dominantní. Mezi další výdaje patří čištění dat, rozhraní, správa identit, bezpečnostní audity, datové sady pro hodnocení, monitorování, čas specialistů, školení, podpora a průběžné úpravy. Obzvláště nákladné se stávají nejasné vlastnictví dat, zakázková řešení specifická pro daný projekt a ruční přepracování z důvodu nekonzistentní kvality.
Studie trhu odhalují napětí mezi vysokými očekáváními a omezenou škálovatelností. V mezinárodním průzkumu mezi 2 000 vedoucími pracovníky v podnikání dosáhla očekávané návratnosti investic pouze zhruba čtvrtina iniciativ v oblasti umělé inteligence; pouze 16 procent se rozšířilo na celou společnost. Zároveň 72 procent považovalo proprietární firemní data za klíčová pro hodnotu generativní umělé inteligence a 68 procent považovalo integrovanou datovou architekturu pro celou společnost za klíčovou. Tato čísla nejsou absolutní pravdou, ale ilustrují, že přístup k modelům sám o sobě negeneruje ani škálovatelnost, ani návratnost investic.
I velmi vysoké míry neúspěchu ze studií by měly být interpretovány s nuancemi. Široce citovaná analýza z roku 2025 dospěla k závěru, že 95 procent zkoumaných iniciativ nedosáhlo žádného měřitelného finančního přínosu. Metodologie, velikost vzorku a definice úspěchu omezují zobecnitelnost tohoto zjištění; mnoho projektů bylo navíc stále v raných fázích. Výsledek nicméně poukazuje na skutečný vzorec: Generické nástroje mohou zvýšit individuální produktivitu, ale tato úspora času se automaticky nepromítá do nižších nákladů, vyšší propustnosti ani dodatečných příjmů.
Pro hodnocení investic jsou proto procesní metriky důležitější než metriky aktivity. Počet uživatelů, výzev nebo vygenerovaných textů měří přijetí, nikoli ekonomický úspěch. Důležitější jsou doba zpracování, náklady na transakci, míra chyb, úsilí o přepracování, propustnost, doba zpracování pohledávek, míra řešení a spokojenost zákazníků. Zvýšení produktivity se promítá do finančního výsledku pouze tehdy, když společnost přerozdělí zdroje, odstraní úzká hrdla, prodá další služby nebo se skutečně vyhne nákladům.
Soukromý model ještě není podniková umělá inteligence
Pojmy soukromá umělá inteligence, model soukromého jazyka a podniková umělá inteligence se často používají zaměnitelně. Soukromý model primárně popisuje technické a smluvní podmínky, za kterých je model provozován, a kdo k němu má přístup. Může běžet lokálně, ve vyhrazeném cloudovém prostředí nebo prostřednictvím vysoce zabezpečené služby. Tato charakteristika však málo vypovídá o tom, zda systém rozumí relevantním obchodním datům, správně používá oprávnění nebo spolehlivě podporuje proces.
Společnost může provozovat model výhradně interně a přesto skončit s izolovanými daty, špatnou kvalitou vyhledávání, nejasnými odpovědnostmi a nedostatkem měření výkonnosti. Naopak pečlivě nakonfigurované cloudové řešení může být pro určité datové třídy ekonomičtější a dostatečně bezpečné. Správné rozhodnutí závisí na citlivosti, latenci, objemu, potřebách integrace, regulačních požadavcích, interních provozních aktivech a strategické nezávislosti. Provoz v místní síti by neměl být vybrán jako symbol statusu, ale spíše jako výsledek analýzy rizik a nákladů.
Skutečná podniková umělá inteligence zahrnuje model, kontextovou a integrační vrstvu, řízení, řízení přístupu, procesní logiku, testování, monitorování a provozní model s jasně definovanými odpovědnostmi. Zahrnuje také komerční strukturu, která transparentně zobrazuje vývoj nákladů a výkonnostní rizika. Součástí této architektury může být i soukromý model, ale nenahrazuje ji. Klíčovým testem není to, kde samotný model běží, ale zda celý systém řídí, prokazatelně vylepšuje a ekonomicky vylepšuje obchodní proces.
Toto rozlišení také chrání před zbytečnou technickou složitostí. Ne každý případ použití vyžaduje rozsáhlý model a ne každý úkol je generativní. Klasické vyhledávací metody, pravidla, statistické modely nebo automatizace procesů mohou být nákladově efektivnější, stabilnější a snáze testovatelné. Zralá podniková architektura znamená nasazení generativní umělé inteligence pouze tam, kde její schopnost zpracovávat nestrukturované informace a variabilní jazyk generuje prokazatelnou přidanou hodnotu.
Rychlá implementace vyžaduje přísná omezení, nikoli velkolepé sliby
Dobře definovaný počáteční případ použití na stávajících systémech by měl vést k téměř produkčním výsledkům během několika týdnů, nikoli po několika čtvrtletích. To neznamená, že kompletní transformaci lze dokončit rychle. Jedná se o striktně strukturovaný proces s jasně definovanými uživateli, zdroji dat, měřitelnými prahovými hodnotami kvality a kontrolovaným provozním postupem. Pokud i tato počáteční fáze trvá déle než šest měsíců, mohlo by to znamenat chybějící standardní komponenty, nejasná data, nadměrně velký rozsah nebo integrační architekturu postavenou od nuly.
Rychlost by se však neměla zaměňovat se spěchem do produkce. Přesvědčivý prototyp pouze ukazuje, že model může za příznivých podmínek produkovat použitelný výstup. Provozní implementace musí zohledňovat vzácné výskyty, zastaralé dokumenty, konfliktní data, změny přístupu, selhání a škodlivý vstup. Zejména útoky typu prompt injection se mohou pokusit obejít systémové instrukce prostřednictvím obsahu dokumentů nebo webových stránek. Proto jsou nezbytná technická omezení, validace obsahu, oddělená oprávnění a testování s realistickými scénáři incidentů.
Rozumný implementační proces začíná měřitelným problémem, nikoli preferovaným modelem. Dále se definují datové toky, uživatelské role, rizika chyb a ekonomický vliv. Následuje omezený pilotní projekt s reálnými pracovními postupy, základem pro srovnání a jasnými kritérii pro ukončení. K škálování dochází až po prokázání kvality, akceptace, bezpečnosti a dopadu na proces. Tento fázovaný přístup snižuje utopené náklady a zabraňuje tomu, aby technicky atraktivní studie byla financována po mnoho let bez prokazatelné obchodní hodnoty.
Řízení změn je také klíčové. Zaměstnanci musí chápat, k čemu je systém vhodný, kde leží jeho omezení a jak hlásit chyby. Odbornost nesmí být potichu znehodnocována údajnou automatizací. Nejlepších výsledků často dosahují, když jsou do hodnocení případů, výjimek a zpětnovazebních smyček zapojeni zkušení zaměstnanci. Tímto způsobem se individuální korekce stává učícím se organizačním procesem, i když se samotný základní model z každé konverzace trvale neučí.
Platformy od přebalených chatbotů odlišují čtyři testovací kritéria
První klíčovou otázkou je, zda systém již zná danou společnost v požadované míře, nebo zda si uživatelé musí kontext pro každou transakci rekonstruovat. Smysluplná demonstrace proto využívá vlastní data, terminologii a reálná oprávnění dané společnosti namísto předpřipravené šablonové databáze. Vyhodnocení by mělo posoudit nejen správné odpovědi, ale také to, jak systém nakládá s chybějícími, protichůdnými a neplatnými informacemi. Spolehlivý systém musí rozpoznat omezení a zviditelnit nejistoty.
Druhá otázka se týká kompletní datové cesty. Společnosti by měly zdokumentovat cestu zpracování, místa uložení, pravidla uchovávání, subdodavatele, protokolování a možnosti mazání. Stejně důležité je, zda architektura dokáže uchovávat data v existujících systémech a poskytovat pouze nezbytné výňatky. Prohlášení o bezpečnosti jsou spolehlivá pouze tehdy, pokud je lze propojit s konkrétní variantou a konfigurací produktu.
Třetí otázkou je, kdo je ekonomicky a organizačně zodpovědný za dohodnutý výsledek. Je třeba objasnit, co se stane, pokud nebude dosaženo přesnosti, propustnosti, doby zpracování nebo jiných cílových hodnot. Pouhý odkaz na plánování budoucích produktů odhaluje mezeru v odpovědnosti. Zároveň si společnost musí uvědomit svou vlastní odpovědnost, zejména pokud jde o kvalitu dat, definici procesů, školení uživatelů a expertní rozhodnutí. Odpovědnost za výsledky nelze zcela outsourcovat.
Čtvrtá otázka se týká nákladů druhého případu užití. Dodavatelé by měli prokázat, která připojení, oprávnění, definice, testy a provozní funkce se znovu používají. Transparentní výpočet nákladů pro následný proces je informativnější než obecný slajd platformy. Odhaluje, zda jsou úspory z rozsahu skutečné, nebo zda každé rozšíření spouští nový integrační projekt. Tyto čtyři otázky záměrně přesouvají pozornost od názvu modelu směrem ke kontextu, datové suverenitě, odpovědnosti a kumulativním ekonomickým přínosům.
Vhodná operační architektura je založena na rizicích, nikoli na ideologii
Pro většinu společností neexistuje jediná správná metoda nasazení. Portfoliový přístup má větší ekonomický smysl. Veřejný obsah a úkoly psaní s nízkým rizikem lze zpracovávat pomocí standardizovaných podnikových asistentů. Interní dotazy na znalosti vyžadují kontrolované konektory, kontroly autorizace a ověřování zdrojů. Kritické obchodní procesy vyžadují přísnější toky dat, reprodukovatelné testy, lidské schvalování a v případě potřeby specializované nebo lokální zpracování. Vysoce efektivní automatizované akce navíc vyžadují přísně kontrolované nástroje, transakční kontroly a postupy vrácení předchozích změn.
Tento stupňovitý přístup zabraňuje dvěma nákladným extrémům. Prvním je předání všech dat obecnému asistentovi a spoléhání se na smluvní doložky. Druhým je vývoj a provozování každé funkce umělé inteligence výhradně interně. Mezi těmito dvěma extrémy leží spravované cloudové služby, regionální zpracování, klíče vlastněné zákazníkem, cesty do privátních sítí, dedikované instance, on-premise modely a hybridní architektury. Jejich kombinace by měla být volena na základě konkrétního rizika.
Výběr modelu může být také stupňovitý. Menší modely jsou často levnější, rychlejší a postačující pro úzce definované úkoly. Větší modely mohou být lepší pro složitý jazyk, plánování nebo nekonzistentní dokumenty. Inteligentní router dokáže přiřadit úkoly různým modelům na základě citlivosti, složitosti a nákladů. Předpokladem je standardizovaný systém hodnocení, který zajistí, že cenové výhody nebudou negovány vyššími náklady na chyby a přepracování.
Z dlouhodobého hlediska nebude nejdůležitějším aktivem nejvýkonnější individuální model, ale spíše schopnost společnosti bezpečně a rychle nasazovat modely do produkčních procesů. Tato schopnost zahrnuje kvalitu dat, modulární architekturu, odborné znalosti, řízení a kulturu měřitelného zlepšování. Je těžší ji kopírovat než licenci a zůstává cenná, i když se změní přední poskytovatel modelu.
Od projektu s umělou inteligencí k operačnímu systému pro firmy
Strategická perspektiva se přesouvá od otázky, kterého asistenta pořídit, k otázce, jaké operační schopnosti je třeba rozvíjet. Společnosti vyžadují katalogizovaný inventář datových zdrojů, jasně definované odpovědnosti, standardizované metody přístupu, modelové portfolio, opakovaně použitelné hodnotící postupy a prioritizaci na základě ekonomické hodnoty. Bez tohoto základu vzniká mnoho izolovaných nástrojů, jejichž přínosy je obtížné porovnávat a jejichž rizika se hromadí.
Výběr případů užití by se měl zaměřit na opakující se, datově bohaté a frikční procesy. Obzvláště atraktivní jsou předávání informací mezi funkcemi a systémy, kde zaměstnanci potřebují vyhledávat, porovnávat, přenášet nebo vysvětlovat informace. V těchto situacích může generativní umělá inteligence odemknout nestrukturovaný obsah a doplnit tradiční automatizaci. Procesy bez jasného datového základu, bez měřitelného počátečního stavu nebo s extrémně vysokou mírou chyb a omezenými možnostmi kontroly jsou méně vhodné.
Pro každý prioritní případ by měl management formulovat ekonomickou hypotézu. Tato hypotéza popisuje, které úzké hrdlo bude odstraněno, který klíčový ukazatel výkonnosti se změní, jaké náklady budou v plné výši vynaloženy a jak se efekt projeví v provozu. Pouhý předpoklad úspory času nestačí. Musí být jasné, zda uvolněný čas umožní více případů, zkrátí čekací doby, zvýší kvalitu, nebo skutečně zamezí personálním a externím nákladům. Pouze toto propojení transformuje technickou produktivitu na ekonomickou návratnost.
Souběžně je zapotřebí architektonické rozhodnutí, které překročí rámec počátečního pilotního projektu, aniž by okamžitě vybudovalo nadměrně velkou platformu. Štíhlé, sdílené jádro zahrnující identitu, protokolování, přístup k modelu, datové konektory a vyhodnocování se může postupně rozrůstat. Každá nová aplikace by se měla na tomto jádru vylepšovat a generovat co nejméně vlastní logiky. Tento přístup vytváří kumulativní možnosti spíše než soubor demonstrací.
Skutečné rozhodnutí o koupi se točí kolem modelu
Modely umělé inteligence se stávají výkonnějšími, levnějšími a hlouběji integrovanými do standardního softwaru. To snižuje rozlišovací faktor pouhého přístupu. To, co si firmy ve skutečnosti samy pořizují nebo vytvářejí, jsou komponenty, které model obklopují: obchodní kontext, řízené ukládání dat, spolehlivá integrace, sledovatelná rozhodnutí, organizační odpovědnost a nákladová křivka, která se s dalšími případy použití stává příznivější. Tyto prvky určují, zda umělá inteligence zůstane nástrojem produktivity pro jednotlivé zaměstnance, nebo se vyvine v celopodnikovou schopnost.
Podniková licence není pro tento účel ani bezcenná, ani dostatečná. Často představuje rozumné minimum pro obecné úkoly a může omezit stínovou umělou inteligenci. U regulovaných nebo obchodně kritických procesů však musí být doplněna datovou architekturou, řízením, návrhem procesů a měřitelnou odpovědností za výsledky. Stejně tak samotný soukromý model není řešením. Technická izolace bez kontextu a provozní koncepce pouze vytváří soukromě provozovaný ostrov.
Druhý případ užití poskytuje nejsilnější varování. Pokud je nutné znovu sestavit všechna datová připojení, pravidla, testy a odpovědnosti, počáteční úspěch nebyl důsledkem platformy, ale spíše samostatným projektem. Naopak, pokud jsou základní komponenty znovu použity a doba potřebná k dosažení přínosu se zkrátí, začíná skutečná obchodní ekonomika. Hodnota pak nespočívá ve velkolepé demonstraci, ale v infrastruktuře učení, která neustále zlepšuje více procesů s nižšími mezními náklady.
Zaměstnanci, kteří již hlasovali pomocí soukromých účtů, proto nepředstavují jen bezpečnostní problém. Demonstrují vysokou poptávku a nízkou toleranci vůči nekvalitním nástrojům. Úkolem vedení společnosti je převést tuto poptávku do kontrolované a nadstandardní alternativy: systému, který rozumí podnikání, adekvátně chrání citlivá data, zodpovědně zvládá chyby a při příštím použití nezačíná od nuly. Cokoli jiného zůstává chatbot s přihlášením – užitečný, často působivý, ale ještě ne podniková umělá inteligence.
Poradenství - Plánování - Implementace

Konrad Wolfenstein
Rád/a bych sloužil/a jako váš osobní poradce.
Můžete mě kontaktovat na adrese wolfenstein∂xpert.digital nebo
Zavolejte mi na +49 7348 4088 965 .