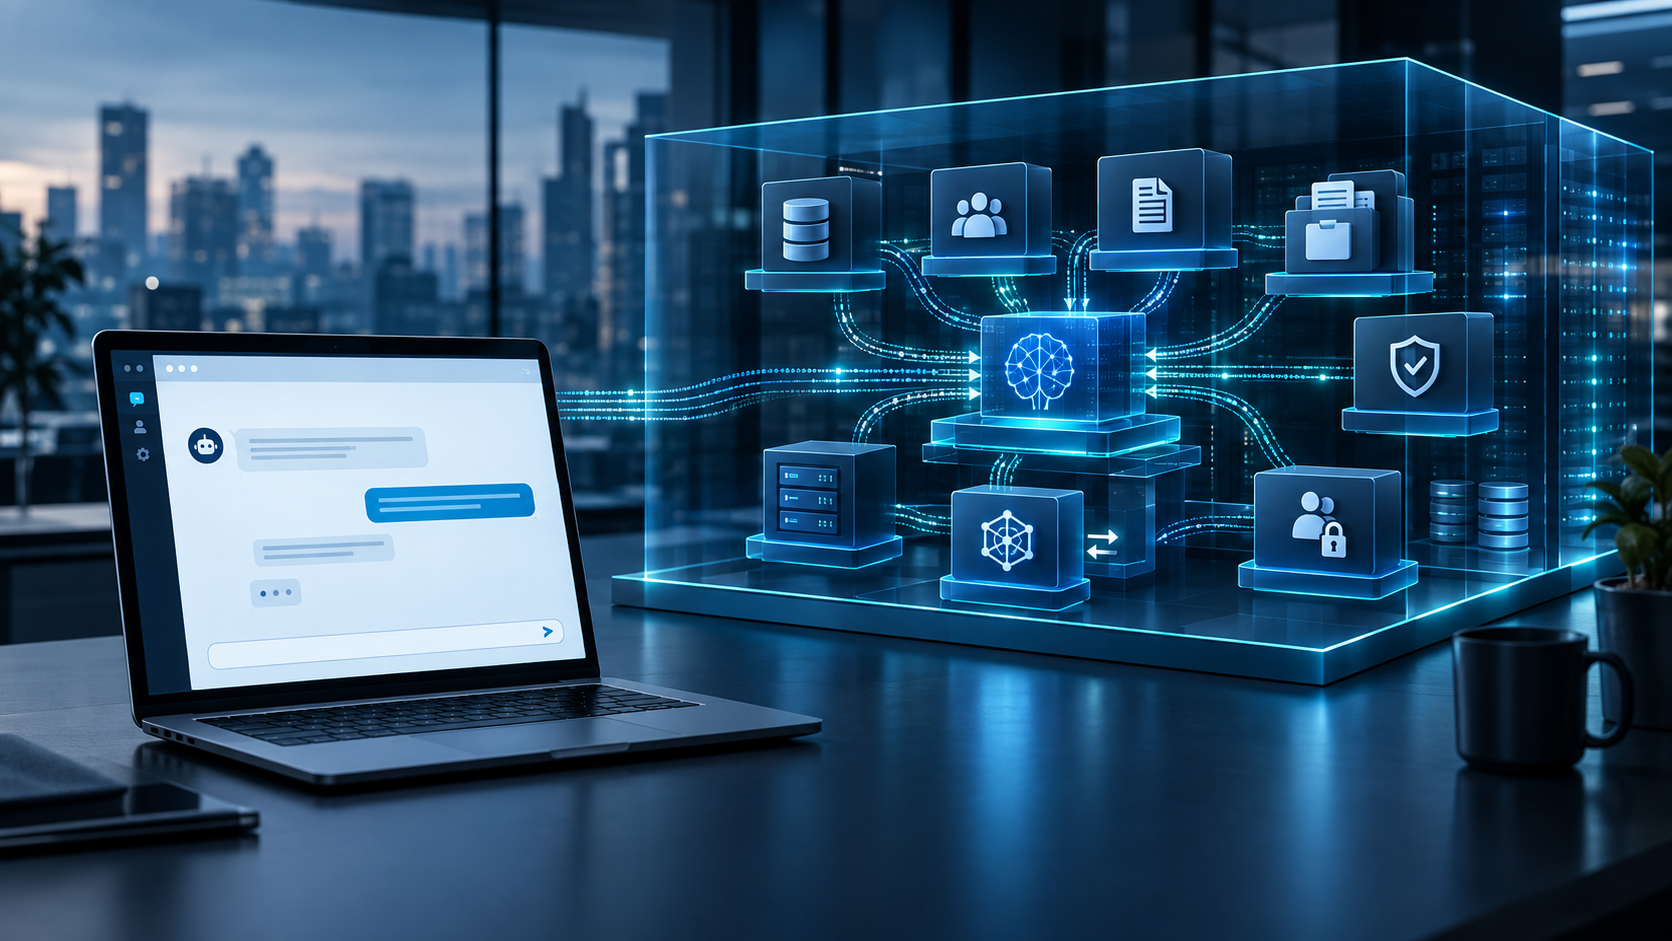
Корпоративен изкуствен интелект започва там, където свършва чатботът – креативно изображение по темата, включващо изкуствен интелект: Xpert.Digital
От лиценз към отговорност: Как компаниите трябва да преосмислят своята стратегия за изкуствен интелект
Ето как компаниите запълват пропастта между надеждите за изкуствен интелект и реалността
Значението на контекстния слой за ефективен корпоративен ИИ
В днешния дигитален пейзаж интеграцията на изкуствения интелект (ИИ) в бизнес процесите става все по-важна. Много компании обаче са изправени пред предизвикателството, че служителите им често разчитат на неоторизирани, частни услуги с ИИ – практика, известна като скрит ИИ. Това развитие разкрива критична празнина между решенията, предоставяни от компаниите, и реалните нужди на потребителите на работното място. Въпреки че корпоративните лицензи за установени инструменти с ИИ се считат за основна мярка, те сами по себе си са недостатъчни, за да отговорят на сложните изисквания и специфичните обстоятелства на бизнеса. Истинският генеративен корпоративен ИИ изисква добре проектирана системна архитектура, която обхваща модели, достъп до данни, логика на процесите и отчетност. В тази статия разглеждаме основните аспекти, които компаниите трябва да вземат предвид, за да използват пълноценно потенциала на ИИ и ефективно да се борят със скрит ИИ.
Свързано с това:
Простото разпространение на лицензи не дигитализира компанията – то дигитализира проблема ѝ с изкуствения интелект в сянка
В много компании бъдещето на генеративния изкуствен интелект не се решава на стратегическа среща, а в незабележим момент на работното място: служител копира договор с клиент, изчисление или вътрешен имейл в публично достъпна услуга за изкуствен интелект, защото използваният за частно ползване инструмент изглежда по-бърз, по-разбираем и по-мощен от официално одобреното решение на компанията. От гледна точка на служителя това често не е умишлено нарушение на правилата, а прагматична реакция на неефективни процеси. От гледна точка на компанията това показва опасна пропаст между техническото одобрение и реалната използваемост.
Обичайният рефлекс за запълване на тази празнина чрез закупуване на лиценз за цялата компания за добре познат асистент с изкуствен интелект е недостатъчен. Такъв лиценз може да осигури важни гаранции, административни функции и договорни ангажименти. Той обаче не превръща автоматично един общ асистент в система, която разбира продуктите, клиентите, договорите, ролите, границите на одобрение и работните процеси на компанията. Нито пък автоматично отговаря на въпроси като къде се обработват чувствителни данни, кой е отговорен за неправилни резултати или дали могат да бъдат разработени допълнителни процеси на разумна пределна цена след първоначалния случай на употреба.
Следователно централната икономическа теза е следната: Истинският генеративен корпоративен изкуствен интелект не е единичен модел или прозорец за чат с фирмено лого. Това е операционна система, съставена от модели, точки за достъп до данни, контекст, идентичности, разрешения, логика на процесите, контрол на качеството, отговорности и стабилна архитектура на разходите. Истинската стойност произтича не от достъпа до изкуствения интелект, а от контролираната му интеграция в организацията. Именно тук продуктивният бизнес компонент се различава от удобния потребителски продукт с бизнес вход.
Фирменият лиценз е фондация, но все още не е сграда
Корпоративните версии на основните асистенти с изкуствен интелект решават реални проблеми. Обикновено доставчиците се ангажират да не използват бизнес входове и изходи по подразбиране за обучение на своите модели с общо предназначение. Допълнителните функции включват централизирано управление на потребителите, еднократно влизане, контрол на достъпа, базиран на роли, регистриране, криптиране, отчети за употреба, споразумения за обработка на данни и частично конфигурируеми периоди на съхранение. Освен това, съществуващите права за достъп, политики и механизми за сигурност могат да бъдат използвани в рамките на установени офис платформи. За много организации това представлява значително подобрение спрямо личните акаунти.
Грешката не е в закупуването на такива лицензи. Грешката е в объркването на обхвата им на защита с цялостно корпоративно решение. Ангажиментът да не се използват клиентски данни за общо обучение на модели отговаря само на един от няколко въпроса, свързани с данните. Мястото на обработка, съхранението на входни и изходни данни, периодът на съхранение, участието на подизпълнители, обработката на телеметрията и приложимите юрисдикции могат да останат отворени въпроси. Освен това, продуктът за чат, интерфейсът за програмиране, интегрираният офис асистент и специфичният за клиента облачен екземпляр често се различават значително. Следователно общо издание, базирано на търговска марка, е недостатъчно както от бизнес, така и от регулаторна гледна точка.
Преди всичко, самият лиценз няма институционална памет. Моделът не знае автоматично специфичното значение на компанията на името на даден продукт, историята на оплакване или коя от няколко клиентски системи е авторитетна за определен процес. Той не разпознава неформални изключения или матрицата за одобрение и не може самостоятелно да определи дали е приложима остаряла политика или неин наследник. Достъпът до модела се закупува; въпреки това, оперативната надеждност трябва да бъде изградена, тествана и поддържана непрекъснато.
Shadow AI е пазарна преценка от собствената работна сила на компанията
Използването на частни акаунти с изкуствен интелект често се третира като дисциплинарен или обучителен въпрос. Това е твърде опростено. Когато служителите прибягват до неоторизирани инструменти въпреки забраните, те предоставят неволна обратна връзка от пазара: санкционираният вариант губи при директно сравнение по отношение на скорост, използваемост, качество на модела или практическа интеграция в работните процеси. Забраните могат да намалят рисковете в краткосрочен план, но не елиминират търсенето на по-добро решение.
Мащабът е значителен. Докладите показват, че до 2026 г. 47% от служителите, използващи генеративен изкуствен интелект на работното място, все още ще използват лични, неуправлявани акаунти. Едновременно с това броят на регистрираните инциденти, включващи прехвърляне на чувствителни данни към приложения с изкуствен интелект, се е удвоил. Средно по 223 такива нарушения на правилата са регистрирани на организация на месец; за особено засегнатите компании тежестта е била многократно по-висока. Регулираните лични, финансови и медицински данни представляват особено голям дял от тези нарушения. Такива показатели обхващат само видими инциденти и е малко вероятно да отразяват напълно действителната употреба.
От икономическа гледна точка, централизираните ИТ решения се конкурират с безплатна или частно финансирана алтернатива. Тази алтернатива има ниски бариери за навлизане, добро потребителско изживяване и често е най-новият модел. Вътрешната алтернатива не печели единствено въз основа на съответствие, а само ако е поне толкова удобна и предлага допълнителна бизнес стойност. Тя трябва да намира подходяща информация, да е достъпна в съществуващи приложения, да избягва ненужно копиране и да контекстуализира отговорите в рамките на работния процес. Трайното приемане не се постига чрез принуда, а чрез по-големи ползи с по-малко лични усилия.
Това не означава, че техническите контроли са ненужни. Предотвратяването на загуба на данни, ограниченията за клиенти, контролът на браузъра, регистрирането и ясните правила за употреба остават от съществено значение. Въпреки това, тяхната ефективност се увеличава значително, когато е налична и високопроизводителна алтернатива. Следователно правилният управленски отговор не е просто да се блокира скритият ИИ, а да се анализират коренните му причини: За какви задачи го използват служителите? Кои оторизирани системи се провалят? Какви неефективности карат хората да използват частни акаунти? Тези отговори ще доведат до реалистичен списък с приоритети за корпоративния ИИ.
Корпоративните знания не се създават в прозореца за чат
Асистентите с общ изкуствен интелект започват процес предимно с контекста, предоставен от потребителя или изведен от продукта от ограничени предишни взаимодействия. Тази неутралност често е полезна за лични задачи. В бизнес контекст обаче тя се превръща в риск, веднага щом решенията зависят от историческа, договорна или специфична за клиента информация. Например, надежден отговор на застрахователен иск може да се постигне само чрез комбиниране на историята на исковете, версията на полицата, кореспонденцията, регулаторните изисквания и статуса на обработка. Един качен договор е недостатъчен за тази цел.
Необходимите знания рядко се намират на едно място. Те са разпръснати в ERP системи, CRM, системи за управление на документи, системи за издаване на билети, хранилища за данни, имейл, специализирани приложения и лични файлове. Освен това има различни идентификатори, изписвания, версии на данните и отговорности. Клиентът може да е посочен под различни имена в три системи; код на продукт може да е придобил различно значение след сливане; политика може все още да е формално достъпна, но технически заменена. Езиковият модел не може сам да разреши тези противоречия. Без надеждно картографиране, той може в най-добрия случай да създаде езиково убедителен синтез на противоречиви данни.
Следователно, предоставянето на контекст е предимно задача за интеграция и управление на данни. Генерирането с допълнено извличане, т.е. целенасоченото предоставяне на подходящо съдържание в момента на заявка, е важен метод, но не и цялостно решение. Необходими са също метаданни, версии, проверка на самоличността, проверки на оторизациите, приоритет на източника, периоди на валидност и правила за противоречива информация. Колкото повече системата е предназначена да действа, а не просто да отговаря, толкова по-важни стават транзакционните контроли и ясно дефинираното системно лидерство.
Един прост тест може да разкрие зрялост: Одобреният инструмент получава въпрос, който изисква само вътрешни познания за компанията, за да се отговори правилно. Ако предоставя общ, уверен и неправилен отговор, той функционално е чатбот с достъп до компанията. Ако просто изисква файл, той е чатбот с функция за качване. Само когато осъществява достъп до съответните системи легитимно, прозрачно и в реално време, разпознава несигурността и поставя отговора в контекста на компанията, се появява истинска корпоративна интелигентност.
Контекстният слой се превръща в производствен капитал
Ключовият архитектурен компонент се намира между модела и оперативния бизнес. Този слой може да бъде описан като контекстна платформа, структура на знанията или слой за интеграция и оркестрация. Името му е по-малко важно от функцията му: той съпоставя обектите един с друг, свързва източници на данни, проверява разрешения, предоставя дефиниции, контролира инструменти и документира как е възникнал отговор или действие. В идеалния случай тази работа не се започва наново за всеки случай на употреба, а по-скоро се изгражда като многократно използваем градивен елемент на предприятието.
От икономическа гледна точка, този слой наподобява продуктивен капиталов запас. Първоначалната връзка с архив от договори, първото чисто присвояване на идентичност на клиенти или първото внедряване на логика за одобрение води до високи първоначални разходи. След като тези елементи бъдат стандартизирани обаче, върху тях могат да се надградят по-нататъшни случаи на употреба. Пределните разходи за второ, трето и пето използване би трябвало да намалеят. Само този ефект оправдава платформена стратегия: Част от инвестицията става използваема не само за един проект, но и за нарастващ брой бъдещи процеси.
Този ефект на повторна употреба обаче не се случва автоматично. Много предполагаеми платформи се състоят от колекция от специфични за проекта интерфейси, подкани и персонализирани решения. Всяко ново приложение след това трябва да бъде анализирано, интегрирано и защитено наново. Кривата на разходите остава линейна, докато възникват допълнителни зависимости. Следователно, истинският тест за зрялост е да се определи кои специфични компоненти от първия случай на употреба могат да бъдат използвани повторно във втория, без да се престрояват. Компонентите за повторна употреба включват например услуги за идентичност, конектори, контрол на достъпа, каталози на данни, процедури за оценка, регистриране, достъп до модели и стандартизирани човешки одобрения.
Контекстният слой е стратегически по-важен от ангажимента към един-единствен модел. Моделите се подобряват бързо, цените се променят и различните задачи се възползват от различни силни страни. Следователно, компаниите се нуждаят от възможността да превключват между модели по контролиран начин или да използват няколко паралелно. Превключването обаче не е напълно безплатно: бързото поведение, изходните формати, филтрите за сигурност, контекстните прозорци и профилите на производителност се различават. Добрата архитектура намалява тези разходи за превключване чрез абстракция, стандартизирани интерфейси и повтаряеми тестове, вместо да създава нереалистично впечатление за пълна взаимозаменяемост.
Суверенитетът на данните обхваща повече от просто изключване на обучението
Общественият дебат отдавна се фокусира върху това дали входните данни се използват за обучение на модел. Макар че този въпрос е важен за бизнеса, той е твърде тесен. Цялата верига за съхранение и обработка е от решаващо значение: Къде се обработват входните данни? Кои части от документа се прехвърлят? Къде се съхраняват историите на чатовете, кешовете, лог файловете и векторните представяния? Колко дълго се съхраняват? Кои подизпълнители имат технически точки за контакт? Коя правна рамка се прилага? Могат ли администраторите да преглеждат, експортират и изтриват съдържание? Как се обработват резервните копия?
Маркетинговият отдел може, при определени обстоятелства, отговорно да използва външно обработен чернова. Различни стандарти се прилагат за непубликувани бизнес данни, търговски тайни, здравни данни, съдебни дела или критична инфраструктура. Следователно класът на риска не трябва да се основава единствено на използвания инструмент, а по-скоро на вида данни, предприетите действия, потенциалните щети и нивото на човешки надзор. Същият модел може да представлява нисък риск при пренаписване на публично прессъобщение и висок риск при автоматична обработка на заем или иск.
Здравата архитектура минимизира движението на данни. Информацията остава в рамките на съществуващите системи, доколкото е възможно; предоставя се само контекстът, необходим за задачата, съгласно съществуващите правила за достъп. Заявките се оторизират на базата на специфични за потребителя данни, чувствителните полета се маскират, където е уместно, а изходът се класифицира според съдържанието му. За особено критични процеси може да се препоръча регионална обработка, специализирани инстанции, поверителни изчислителни среди или локално внедряване. Въпреки това, изцяло вътрешната експлоатация не е нито автоматично по-сигурна, нито по-икономична, тъй като експлоатацията, инсталирането на корекции, наблюдението, поддръжката на модела и специализираният персонал водят до значителни разходи.
Формулата за привеждане на модела към данните следователно описва разумен принцип, но не бива да се разбира погрешно като техническо опростяване. Дори при федерални или локално свързани решения, откъси, вграждания или метаданни могат да достигнат до външни услуги. Документиран анализ на потока от данни на ниво компонент е от решаващо значение. Само когато може да се демонстрира за всеки етап кои данни къде отиват и как са защитени, може да се оцени надеждно суверенитетът на данните.
Регулирането превръща проследимостта в икономически фактор
В регулираните индустрии потокът от данни не е абстрактен идеал за сигурност. Финансовите институции, съгласно европейските правила за дигитална оперативна устойчивост, трябва систематично да оценяват рисковете, породени от информационните и комуникационните технологии, както и от доставчици от трети страни. Споразуменията за поверителност, професионалната тайна, законите за защита на данните и секторните разпоредби също изискват от компаниите да могат да обяснят дейностите по обработка, отговорностите и мерките за контрол. Приложение с изкуствен интелект, чието качество на отговор е убедително, но чийто път на данните не е одитиран, не може да премине тестове за оперативно приемане.
С европейското законодателство за изкуствения интелект, систематичното управление придобива още по-голямо значение. Големи части от европейската регулаторна рамка са в сила от август 2026 г., докато отделните задължения за определени високорискови системи ще влизат в сила поетапно. Това не води до пълна забрана на генеративния изкуствен интелект за компаниите. По-скоро е необходима строга класификация, основана на областта на приложение и ролята. Общ модел, специализирана система, изградена върху него, и компанията, използваща тази система, могат да имат различни задължения. Прозрачността, документацията, човешкият надзор, качеството на данните, точността, киберсигурността и проследимостта са особено важни за високорисковите приложения.
Съответствието не е просто фактор, свързан с разходите. Архитектурата за многократна употреба на контрол може да съкрати времето за пускане на пазара, тъй като не всеки проект трябва да преоткрива правилата си. Стандартизираните класове риск, одобрените модели, техническото регистриране, шаблоните за оценка и дефинираните нива на одобрение намаляват несигурността. По този начин управлението се трансформира от функция за контрол надолу по веригата в продуктивна инфраструктура. Икономическото предимство става особено очевидно по време на второто и третото внедряване, когато тестваните компоненти могат да бъдат използвани повторно.
Компаниите също трябва да разграничават риска на модела от риска на процеса. Един модел може да бъде технически мощен, докато лошо проектиран процес продължава да използва неправилни източници на данни, има неясни отговорности или не позволява обръщане на грешни действия. И обратно, ограниченият модел може да бъде много полезен в строго дефиниран, добре контролиран процес. Следователно, качеството на цялостната архитектура е по-често решаващ фактор за регулаторната и икономическа жизнеспособност, отколкото пиковите резултати на модела в общи тестове.
🤖🚀 Управлявана платформа с изкуствен интелект: По-бързи, по-безопасни и по-интелигентни решения с изкуствен интелект с UNFRAME.AI

Управлявана AI платформа - Изображение: Xpert.Digital
Тук ще научите как вашата компания може да внедри персонализирани решения с изкуствен интелект бързо, сигурно и без високи бариери за навлизане.
Управляваната AI платформа е вашето цялостно и безпроблемно решение за изкуствен интелект. Вместо да се занимавате със сложни технологии, скъпа инфраструктура и продължителни процеси на разработка, вие получавате готово решение, съобразено с вашите нужди, от специализиран партньор – често само в рамките на няколко дни.
Ключовите предимства накратко:
⚡ Бързо внедряване: От идея до готово за употреба приложение за дни, а не за месеци. Ние предлагаме практични решения, които създават незабавна добавена стойност.
🔒 Максимална сигурност на данните: Вашите чувствителни данни остават при вас. Гарантираме сигурна и съвместима обработка без споделяне на данни с трети страни.
💸 Без финансов риск: Плащате само за резултати. Високите първоначални инвестиции в хардуер, софтуер или персонал са напълно елиминирани.
🎯 Фокусирайте се върху основния си бизнес: Концентрирайте се върху това, което правите най-добре. Ние се грижим за цялостното техническо внедряване, експлоатация и поддръжка на вашето AI решение.
📈 Готов за бъдещето и мащабируем: Вашият изкуствен интелект расте с вас. Ние гарантираме непрекъсната оптимизация и мащабируемост и гъвкаво адаптираме моделите към новите изисквания.
Повече информация тук:
От проект с изкуствен интелект до бизнес операционна система
Отговорността не трябва да изчезва между лицензирането и консултирането
Ориентираните към потребителя услуги с изкуствен интелект се продават като инструменти. Доставчиците правилно посочват, че разходите могат да бъдат неточни и че потребителите трябва да проверят резултатите. Този модел е разбираем за нискобюджетен масов пазар. В бизнес приложенията обаче възниква празнина в отговорността веднага щом същите тези разходи достигнат до клиентите, повлияят на регулаторното отчитане или задействат финансови процеси. Доставчикът на достъп продава възможността за използване на услугата, но обикновено не поема отговорност за резултата от конкретния бизнес процес.
Дори традиционният модел на интеграция може да остави тази празнина отворена. Доставчикът на услуги анализира, разработва и интегрира в продължение на месеци, таксува за време и материали и накрая доставя система. Договорът може да бъде формално изпълнен, въпреки че инструментът е лошо приет в ежедневната употреба, произвежда твърде много грешки или не успява да постигне измеримо подобрение на процеса. От една страна, достъпът е продаден; от друга, трудът. И в двата случая никой не е непременно финансово обвързан с договорения резултат.
Следователно, корпоративният изкуствен интелект изисква изрично разпределение на отговорностите. Бизнес звената, ИТ, информационната сигурност, защитата на данните, управлението на риска и доставчиците трябва да знаят кой е отговорен за качеството на данните, кой избира модели, кой определя лимити, кой одобрява разходи и кой взема решения в случай на прекъсвания. За автоматизирани действия, проследимостта, опциите за отмяна и ясно дефинираните ескалации са от съществено значение. Човешкият преглед е ефективен контрол само ако проверяващият има достатъчно време, експертиза и информация; рутинно кликване свежда човешкия надзор до обикновена формалност.
Моделите на компенсация, ориентирани към резултатите, могат да подобрят стимулите, но не са панацея. Те работят само ако резултатите са измерими, приписваеми и защитени от манипулация. За ясен процес, като например намаляване на времето за обработка, намаляване на процента на грешки или увеличаване на броя на решените случаи, могат да се договорят елементи, базирани на изпълнението. Атрибуцията е по-трудна за стратегически задачи, базирани на знания. Често е препоръчителен хибриден модел, състоящ се от основна заплата, показатели за качество и използване и компонент, свързан с договорени бизнес резултати.
Вторият случай на употреба разкрива платформената икономика
Много процеси на подбор се фокусират върху първи, умишлено опростен случай на употреба. Обобщаването на документи, писането на имейли, обяснението на качен файл или генерирането на текстови варианти са подходящи за общи модели, защото почти целият контекст е достъпен при поискване. Такива задачи демонстрират езиковите възможности на модела, но едва ли зрялостта на корпоративна платформа. Те често могат да бъдат покрити само с няколко лиценза и управляеми усилия за внедряване.
Вторият случай на употреба е по-информативен. Ако същата система трябва да съгласува фактурите на доставчиците с договорите, тя изисква достъп до архива на договорите, ERP системата, матрицата за одобрение, основните данни и правилата за изключения. Тя трябва да консолидира различните обозначения, да обяснява несъответствията, да спазва оторизациите и да ескалира проблемите към съответната роля, когато има съмнения. Тук фокусът се измества от модела към интеграционната и процесната логика. Този случай на употреба проверява дали предварително установената архитектура наистина е за многократна употреба.
Една платформа заслужава името си, когато второто внедряване стане относително по-бързо и по-евтино и този ефект се усилва с последващите приложения. Ако всеки нов случай на употреба остава толкова скъп, колкото предишния, не съществува значителна синергична икономика. В този случай компанията притежава лиценз плюс списък с чакащи за консултантски услуги. Следователно, най-важният търговски тест е да се изисква надеждна цена и времева рамка за второто и третото внедряване, преди дори да се вземе решение за първото.
Тази перспектива променя и изчислението на инвестициите. Първоначалният случай на употреба не трябва да бъде обременяван с всички разходи за платформата поотделно, ако по-късно се използват повторно значими компоненти. И обратно, нечестно е да се разглежда неясно бъдещо повторно използване като предимство, без да се посочват конкретни последващи процеси, собственици и бюджети. Едно разумно изчисление разделя еднократните инвестиции в платформата, разработката, специфична за конкретния случай на употреба, текущите разходи за модел и инфраструктура, както и разходите за мониторинг, осигуряване на качеството и управление на промените. Само тогава може да се определи реалистичен общ разход за няколко години.
Разходите рядко се дължат единствено на извикванията на модела
При генеративния изкуствен интелект вниманието често се фокусира върху лицензионните такси или разходите за токени. Тези разходи са видими, но често не са доминиращи в сложните корпоративни приложения. Допълнителните разходи включват почистване на данни, интерфейси, управление на идентичността, одити за сигурност, набори от данни за оценка, мониторинг, време на специалисти, обучение, поддръжка и текущи корекции. Неясната собственост върху данните, специфичните за проекта персонализирани решения и ръчната преработка поради непостоянно качество стават особено скъпи.
Пазарните проучвания разкриват напрежението между високите очаквания и ограничената мащабируемост. В международно проучване сред 2000 бизнес лидери, само около една четвърт от инициативите за изкуствен интелект досега са постигнали очакваната възвръщаемост на инвестициите; само 16% са се разширили в цялата компания. В същото време 72% считат собствените фирмени данни за ключови за стойността на генеративния изкуствен интелект, а 68% смятат интегрираната архитектура на данните в цялата компания за критична. Тези цифри не са абсолютна истина, но те илюстрират, че достъпът до модели сам по себе си не генерира нито мащабируемост, нито възвръщаемост на инвестициите.
Дори много високите нива на неуспех от проучванията трябва да се тълкуват с нюанс. Широко цитиран анализ от 2025 г. заключава, че 95% от изследваните инициативи не са постигнали никаква измерима финансова полза. Методологията, размерът на извадката и определението за успех ограничават обобщаемостта на това откритие; освен това много проекти все още са в ранен етап. Въпреки това резултатът сочи реална закономерност: Общите инструменти могат да увеличат индивидуалната производителност, но това спестяване на време не се превръща автоматично в по-ниски разходи, по-висока производителност или допълнителни приходи.
Следователно, за оценката на инвестициите, показателите за процесите са по-важни от показателите за активност. Броят на потребителите, подканите или генерираните текстове измерва приемането, а не икономическия успех. По-важни са времето за обработка, цената на транзакция, процентът на грешки, усилията за преработка, производителността, времето за обработка на вземанията, процентът на разрешаване на проблеми и удовлетвореността на клиентите. Повишаването на производителността се превръща във финансов резултат само когато компанията преразпредели ресурси, елиминира пречките, продава допълнителни услуги или действително избягва разходи.
Частният модел все още не е корпоративен ИИ
Термините „частен ИИ“, „модел на частен език“ и „корпоративен ИИ“ често се използват взаимозаменяемо. Частният модел описва предимно техническите и договорните условия, при които се управлява моделът, и кой има достъп до него. Той може да работи локално, в специална облачна среда или чрез високо сигурна услуга. Тази характеристика обаче не казва много за това дали системата разбира съответните бизнес данни, прилага правилно разрешенията или надеждно поддържа даден процес.
Една компания може да управлява модел изцяло вътрешнофирмено и въпреки това да се окаже с изолирани данни, лошо качество на търсене, неясни отговорности и липса на измерване на производителността. И обратно, внимателно конфигурираното облачно решение може да бъде по-икономично и достатъчно сигурно за определени класове данни. Правилното решение зависи от чувствителността, латентността, обема, нуждите от интеграция, регулаторните изисквания, вътрешните оперативни активи и стратегическата независимост. Локалната работа не трябва да се избира като символ на статус, а по-скоро като резултат от анализ на риска и разходите.
Истинският корпоративен ИИ обхваща модела, контекстния и интеграционния слой, управлението, контрола на достъпа, логиката на процесите, тестването, мониторинга и оперативния модел с ясно определени отговорности. Той включва и търговска структура, която прави прозрачни рисковете, свързани с развитието на разходите и производителността. Частният модел може да бъде част от тази архитектура, но не я замества. Решаващият тест не е къде работи самостоятелният модел, а дали цялата система контролира, подобрява и икономически облагодетелства бизнес процеса.
Това разграничение предпазва и от ненужна техническа сложност. Не всеки случай на употреба изисква голям модел и не всяка задача е генеративна. Класическите методи за търсене, правила, статистически модели или автоматизация на процеси могат да бъдат по-рентабилни, стабилни и по-лесни за тестване. Зрялата корпоративна архитектура означава внедряване на генеративен ИИ само там, където способността му да обработва неструктурирана информация и променлив език генерира демонстрируема добавена стойност.
Бързото внедряване изисква строги ограничения, а не грандиозни обещания
Добре дефиниран първоначален сценарий на употреба на съществуващи системи би трябвало да доведе до почти производствени резултати в рамките на седмици, а не на няколко тримесечия. Това не означава, че пълната трансформация може да бъде завършена бързо. Тя се отнася до строго структуриран процес с ясно определени потребители, източници на данни, измерими прагове за качество и контролиран оперативен път. Дори ако тази начална фаза отнеме повече от шест месеца, това може да показва липсващи стандартни компоненти, неясни данни, прекомерно голям обхват или изградена от нулата интеграционна архитектура.
Скоростта обаче не бива да се бърка с бързането в производство. Убедителният прототип само показва, че даден модел може да генерира използваем резултат при благоприятни условия. Оперативното внедряване трябва да отчита редки случаи, остарели документи, противоречиви данни, промени в достъпа, повреди и злонамерен вход. Атаките с бързо внедряване, по-специално, могат да се опитат да заобиколят системните инструкции чрез съдържание на документи или уебсайтове. Следователно, техническите ограничения, валидирането на съдържанието, отделните разрешения и тестването с реалистични сценарии на инциденти са от съществено значение.
Разумен процес на внедряване започва с измерим проблем, а не с предпочитан модел. След това се дефинират потоци от данни, потребителски роли, рискове от грешки и икономически ливъридж. След това се осъществява ограничен пилотен проект с реални работни процеси, основа за сравнение и ясни критерии за прекратяване. Мащабирането се осъществява само след като са демонстрирани качество, приемане, сигурност и въздействие върху процеса. Този поетапен подход намалява невъзстановимите разходи и предотвратява финансирането на технически привлекателно проучване в продължение на години без доказуема бизнес стойност.
Управлението на промените също е от решаващо значение. Служителите трябва да разбират за какво е подходяща системата, къде са нейните ограничения и как да докладват за грешки. Експертизата не трябва да бъде тихомълком обезценявана чрез предполагаема автоматизация. Най-добрите резултати често се получават, когато опитни служители участват в случаи на оценка, изключения и обратна връзка. По този начин индивидуалната корекция се превръща в обучаващ се организационен процес, дори ако самият основен модел не се учи трайно от всеки разговор.
Четири критерия за тестване разделят платформите от препакетираните чатботове
Първият ключов въпрос е дали системата вече познава компанията в необходимата степен или потребителите трябва да реконструират контекста за всяка транзакция. Следователно, една смислена демонстрация използва собствените данни, терминология и реални разрешения на компанията, вместо предварително подготвена база данни с шаблони. Оценката трябва не само да оценява верните отговори, но и как системата обработва липсваща, противоречива и невалидна информация. Надеждната система трябва да разпознава ограниченията и да прави несигурностите видими.
Вторият въпрос се отнася до пълния път на данните. Компаниите трябва да документират пътя на обработка, местата за съхранение, правилата за запазване, подизпълнителите, опциите за регистриране и изтриване. Също толкова важно е дали архитектурата може да запазва данни в съществуващите системи и да предоставя само необходимите откъси. Твърденията за сигурност са надеждни само когато могат да бъдат свързани с конкретен вариант и конфигурация на продукта.
Третият въпрос е кой е икономически и организационно отговорен за договорения резултат. Трябва да се изясни какво се случва, ако не са постигнати точност, производителност, време за обработка или други целеви стойности. Самото позоваване на бъдещото продуктово планиране разкрива празнина в отчетността. В същото време компанията трябва да признае собствените си отговорности, особено по отношение на качеството на данните, дефинирането на процесите, обучението на потребителите и експертните решения. Отговорността за резултатите не може да бъде изцяло възложена на външни изпълнители.
Четвъртият въпрос се отнася до разходите за втория случай на употреба. Доставчиците трябва да демонстрират кои връзки, разрешения, дефиниции, тестове и оперативни функции се използват повторно. Прозрачното изчисление на разходите за последващ процес е по-информативно от общ слайд за платформата. То разкрива дали икономиите от мащаба са реални или всяко разширение задейства нов проект за интеграция. Тези четири въпроса умишлено изместват фокуса от името на модела към контекста, суверенитета на данните, отговорността и кумулативните икономически ползи.
Подходящата оперативна архитектура е базирана на риска, а не идеологическа
За повечето компании няма един-единствен правилен метод за внедряване. Подходът, основан на портфолио, е по-икономически изгоден. Публичното съдържание и задачите за писане с нисък риск могат да се обработват чрез стандартизирани корпоративни асистенти. Вътрешните заявки за знания изискват контролирани конектори, проверки за оторизация и проверка на източниците. Критичните бизнес процеси изискват по-строги потоци от данни, възпроизводими тестове, човешки одобрения и, където е необходимо, специализирана или локална обработка. Високоефективните автоматизирани действия допълнително изискват строго контролирани инструменти, контрол на транзакциите и процедури за връщане към предишни версии.
Този многоетапен подход предотвратява две скъпоструващи крайности. Първата е предаването на всички данни на общ асистент и разчитането на договорни клаузи. Втората е разработването и управлението на всяка функция на изкуствения интелект изцяло вътрешнофирмено. Между тези две крайности се намират управлявани облачни услуги, регионална обработка, ключове, собственост на клиента, частни мрежови пътища, специализирани инстанции, локални модели и хибридни архитектури. Тяхната комбинация трябва да се избира въз основа на специфичния риск.
Изборът на модел може да бъде и на нива. По-малките модели често са по-евтини, по-бързи и достатъчни за тясно дефинирани задачи. По-големите модели могат да бъдат по-добри за сложен език, планиране или непоследователни документи. Интелигентен рутер може да разпределя задачи на различни модели въз основа на чувствителност, сложност и цена. Предпоставка е стандартизирана система за оценка, за да се гарантира, че ценовите предимства не се обезсмислят от по-високи разходи за грешки и преработка.
В дългосрочен план най-важният актив няма да бъде най-добре представящият се индивидуален модел, а по-скоро способността на компанията да внедрява модели сигурно и бързо в производствените процеси. Тази способност включва качество на данните, модулна архитектура, експертиза, управление и култура на измеримо подобрение. По-трудно е да се копира от лиценз и остава ценна, дори ако водещият доставчик на модели се промени.
От проект с изкуствен интелект до бизнес операционна система
Стратегическата перспектива се измества от въпроса кой асистент да се придобие към въпроса какви оперативни възможности трябва да се развият. Компаниите се нуждаят от каталогизиран инвентар от източници на данни, ясно определени отговорности, стандартизирани методи за достъп, портфолио от модели, процедури за многократна употреба и приоритизиране въз основа на икономическа стойност. Без тази основа се появяват много изолирани инструменти, чиито ползи са трудни за сравнение и чиито рискове се натрупват.
Изборът на случаи на употреба трябва да се фокусира върху повтарящи се, богати на данни и изискващи интензивно взаимодействие процеси. Прехвърлянето на ресурси между функции и системи, където служителите трябва да търсят, сравняват, прехвърлят или обясняват информация, е особено привлекателно. В тези ситуации генеративният изкуствен интелект може да отключи неструктурирано съдържание и да допълни традиционната автоматизация. Процесите без ясна база данни, без измеримо начално състояние или с изключително високи нива на грешки и ограничени възможности за контрол са по-малко подходящи.
За всеки приоритизиран случай, ръководството трябва да формулира икономическа хипотеза. Тази хипотеза описва кое пречка ще бъде елиминирано, кой ключов показател за ефективност ще се промени, какви разходи ще бъдат направени изцяло и как ефектът ще се реализира в операциите. Самото предположение за спестяване на време е недостатъчно. Трябва да е ясно дали освободеното време ще позволи повече случаи, ще намали времето за чакане, ще повиши качеството или реално ще избегне разходи за персонал и външни разходи. Само тази връзка превръща техническата производителност в икономическа възвръщаемост.
Успоредно с това е необходимо архитектурно решение, което да надхвърля първоначалния пилотен проект, без веднага да се изгражда прекалено голяма платформа. Едно елегантно, споделено ядро, включващо идентичност, регистриране, достъп до модели, конектори за данни и оценка, може да расте постепенно. Всяко ново приложение трябва да подобрява това ядро и да генерира възможно най-малко персонализирана логика. Този подход създава кумулативни възможности, а не колекция от демонстрации.
Действителното решение за покупка се върти около модела
Моделите с изкуствен интелект стават все по-мощни, по-евтини и по-дълбоко интегрирани в стандартния софтуер. Това намалява диференциращия фактор, който представлява самият достъп. Това, което компаниите всъщност придобиват или изграждат сами, са компонентите, обграждащи модела: бизнес контекст, контролирано съхранение на данни, надеждна интеграция, проследими решения, организационна отчетност и крива на разходите, която става по-благоприятна с допълнителни случаи на употреба. Тези елементи определят дали изкуственият интелект ще остане инструмент за производителност за отделните служители или ще се превърне в възможност за цялото предприятие.
Корпоративен лиценз не е нито безполезен, нито достатъчен за тази цел. Той често представлява разумен минимум за общи задачи и може да намали скритата ИИ. За регулирани или критични за бизнеса процеси обаче той трябва да бъде допълнен от архитектура на данните, управление, проектиране на процеси и измерима отчетност за резултатите. По същия начин, само частният модел не е решението. Техническата изолация без контекст и оперативна концепция просто създава частно управляван остров.
Вторият случай на употреба предоставя най-силното предупреждение. Ако всички връзки за данни, правила, тестове и отговорности трябва да бъдат преустроени, първоначалният успех не е бил ефект на платформата, а по-скоро самостоятелен проект. И обратно, ако основни компоненти се използват повторно и времето за реализиране на ползите намалява, започва истинската бизнес икономика. Стойността тогава не се крие в зрелищна демонстрация, а в обучаваща инфраструктура, която непрекъснато подобрява повече процеси при по-ниски пределни разходи.
Следователно служителите, които вече са гласували, използвайки лични акаунти, не са просто проблем със сигурността. Те демонстрират високото търсене и ниската толерантност към лоши инструменти. Задачата на ръководството на компанията е да превърне това търсене в контролирана, превъзходна алтернатива: система, която разбира бизнеса, адекватно защитава чувствителните данни, обработва грешките отговорно и не започва от нулата при следващото си използване. Всичко по-малко си остава чатбот с вход – полезен, често впечатляващ, но все още не е корпоративен изкуствен интелект.
Консултиране - Планиране - Внедряване

Konrad Wolfenstein
С удоволствие бих служел като ваш личен съветник.
Можете да се свържете с мен на wolfenstein∂xpert.digital или
Просто ми се обадете на +49 7348 4088 965 .