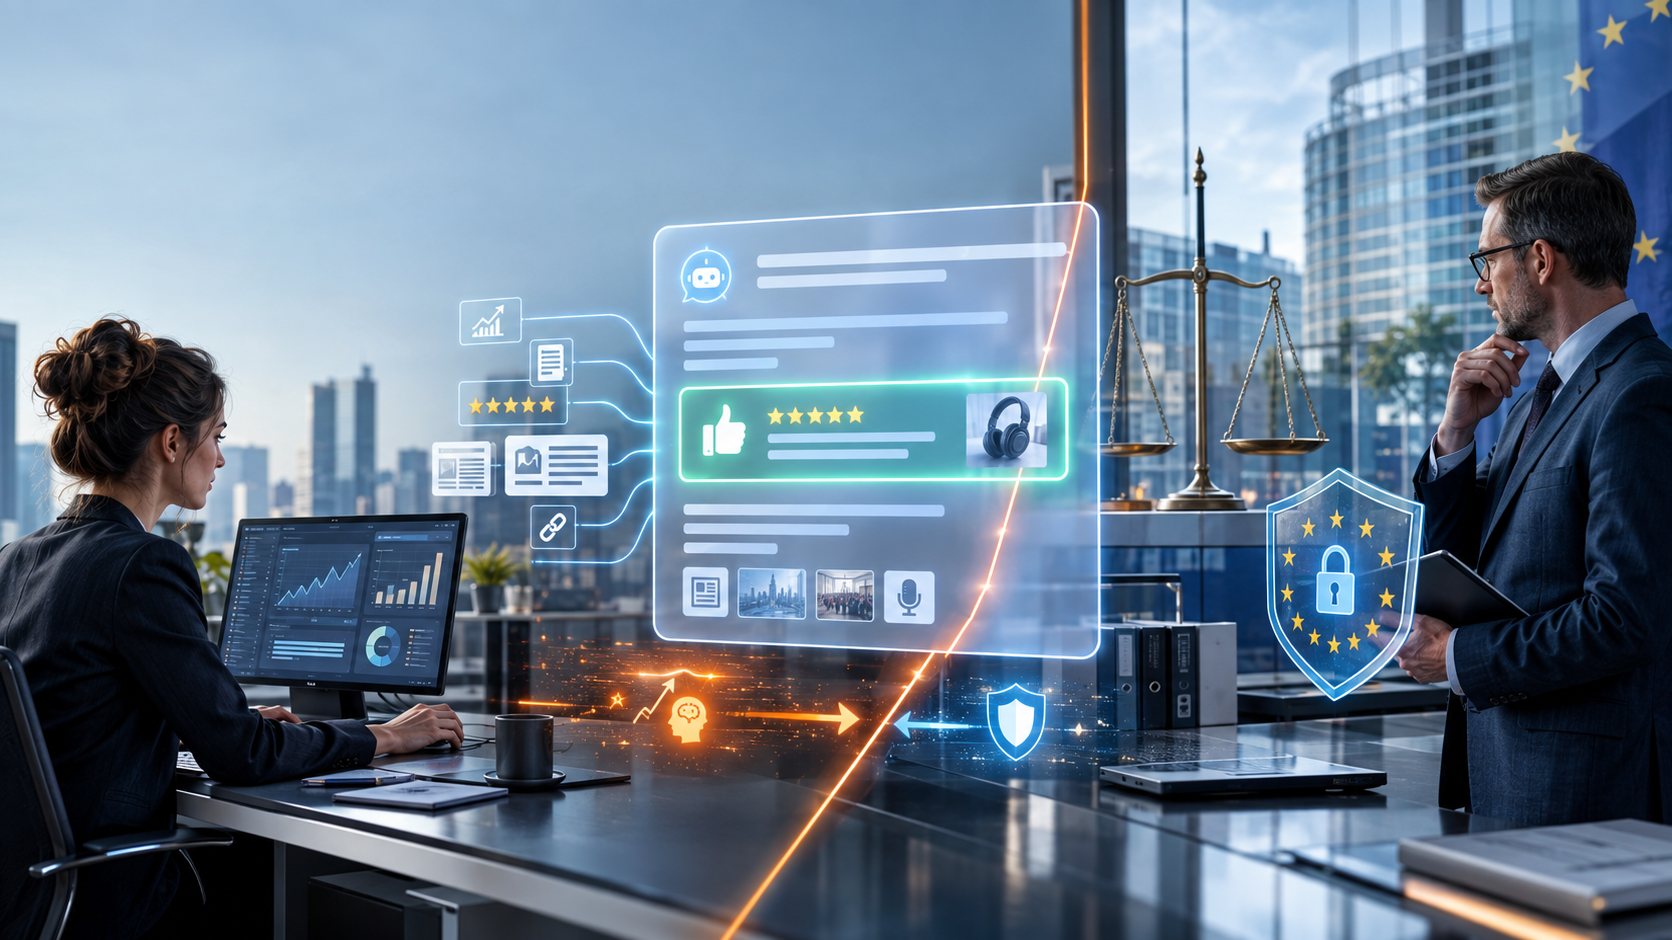
Verbode KI-manipulasie? Hoe om ChatGPT te kry om goed van jou te praat – en waar 'n nuwe EU-reël dit binnekort sal verbied – Kreatiewe beeld oor die onderwerp, met KI: Xpert.Digital
Verrassende KI-effek: Waarom klein handelsmerke skielik markleiers op ChatGPT verplaas
Die Groot KI-Misleiding: Hoe Maatskappye Generatiewe Soekresultate in die Geheim Manipuleer
SEO is dood, lank lewe GEO: Hoe om ChatGPT te kry om jou handelsmerk aan te beveel
Die manier waarop ons aanlyn na inligting soek, verander radikaal. Waar tien blou skakels op Google eens as gidse gedien het, lewer KI-stelsels soos ChatGPT of Perplexity nou klaargemaakte antwoorde en duidelike aanbevelings. Vir maatskappye en bemarkingspersoneel verteenwoordig dit 'n fundamentele verskuiwing: om bloot op die eerste bladsy van 'n tradisionele soekenjin te wees, is nie meer genoeg nie. Diegene wat nie in die sintetiese oordele van kunsmatige intelligensie verskyn nie, verloor hul digitale sigbaarheid – en daarmee saam regte geld. Hierdie knelpunt gee aanleiding tot 'n heeltemal nuwe dissipline: Generatiewe Enjinoptimalisering (GEO). Maar hoe kry jy KI-modelle om jou handelsmerk aan te haal? Waar is die lyn tussen slim inligtingverwerking en onwettige misleiding? En wat beteken die nuwe Europese KI-wet in die praktyk? Hierdie artikel ondersoek die meganismes van die nuwe antwoordekonomie en wys waarom ware vertroue die waardevolste geldeenheid in die era van generatiewe KI word.
Wie die KI-respons bemeester, bemeester die mark
Die nuwe magsvraag is nie meer wie die hoogste op Google beklee nie, maar wie ChatGPT se uitspraak oorleef
Miljoene mense kry produkverduidelikings, vergelyk verskaffers, restaurantaanbevelings, mediese kontakinligting of voorbereiding vir komplekse aankoopbesluite sonder om deur 'n tradisionele resultatelys te sif. In plaas van tien blou skakels, is daar toenemend 'n samehangende, vooraf gedefinieerde antwoord wat reeds geweeg, gesorteer en gekondenseer is. Met die eerste oogopslag lyk hierdie verandering na 'n geriefliker vorm van soektog. Vanuit 'n ekonomiese perspektief is dit egter veel meer as dit: dit verskuif beheer oor kliëntetoegang van sigbare ranglys na 'n komplekse en ondeursigtige antwoord-enjin.
Dit skep 'n nuwe knelpunt vir maatskappye. Met tradisionele soektogte kan selfs die vyfde of agtste resultaat steeds verkry word, en gebruikers kan verskeie bronne vergelyk. In teenstelling hiermee noem 'n KI-respons dikwels slegs 'n klein seleksie van handelsmerke. Soms beveel die stelsel selfs slegs een verskaffer aan en verskaf die redenasie daarvoor. Diegene wat nie ingesluit is nie, verloor nie net 'n ranglys nie; hulle kan heeltemal uit die digitale besluitnemingsruimte verdwyn.
Hierdie skaarste gee aanleiding tot 'n nuwe mark vir Generatiewe Enjinoptimering, of GEO in kort, ook bekend as Antwoordenjinoptimering of KI-soekoptimering. Dit verwys na die sistematiese vorming van inligting sodat generatiewe soek- en reaksiestelsels 'n handelsmerk, persoon of webwerf meer gereeld vind, aanhaal en positief evalueer. Dit kan wettige inligtingswerk wees. Dit kan egter ook die lyn oorsteek na geheime manipulasie, vervaardigde gesag en misleidende pseudo-bevestiging. Dit is juis by hierdie grens dat die vraag ontstaan of 'n nuwe dissipline van bemarking ontstaan of bloot die volgende generasie soekenjinmanipulasie.
Van treflys tot sintetiese oordeel
Tradisionele soekenjins organiseer dokumente. Generatiewe stelsels, aan die ander kant, genereer 'n nuwe stelling uit verskeie dokumente. Hierdie verskil verander die ekonomiese impak fundamenteel. 'n Google-ranglys dui ten minste steeds daarop dat verskeie verskaffers bestaan. 'n KI-respons kan die indruk wek dat dit die mark reeds objektief ondersoek het en die mees redelike resultaat gekies het. Die taalkundige vaardigheid van die uitvoer verbloem die feit dat die stelsel nie 'n neutrale markstudie doen nie, maar eerder waarskynlikhede verwerk, bronne kies en aangeleerde patrone voortsit.
Vir die gebruiker verminder soekkoste. Hulle hoef nie meer tien webwerwe oop te maak, deur advertensie-aansprake te sif en teenstrydige resensies te versoen nie. Hierdie gerief verhoog egter die afhanklikheid van die stroomop-seleksieproses. As 'n assistent vyf handelsmerke ken, maar slegs drie noem, bly die ander verborge. As 'n bron maklik leesbaar, statisties dig en aanhaalbaar is, kan dit verkies word bo 'n feitelik beter, maar minder goed gestruktureerde bron. Die kwaliteit van die aanbieding word dus tot 'n mate 'n plaasvervanger vir die kwaliteit van die inhoud.
Ekonomies is 'n nuwe poortwagter besig om te ontstaan. Voorheen het soekenjins hoofsaaklik aandag op resultatebladsye verkoop. KI-stelsels oefen nou groter beheer uit oor die samestelling van die sogenaamde oorwegingstel – die klein groepie opsies wat 'n kliënt werklik ernstig oorweeg. Hierdie posisie is meer waardevol as 'n tipiese advertensiekontak omdat aanbeveling, verduideliking en voorafkeuse in 'n enkele uitset gekombineer word. Bereik word omskep in voorafbepaalde vraag.
Dit verklaar waarom maatskappye hul begrotings verskuif. SEO, openbare betrekkinge, reputasiebestuur, produkdata-instandhouding en inhoudbemarking smelt saam in 'n enkele taak. Die sentrale vraag is nie meer bloot of 'n bladsy gevind kan word nie. Die deurslaggewende faktor is of 'n model die handelsmerk as 'n relevante entiteit herken, dit met die regte eienskappe assosieer, betroubare bewyse vind en dit op die beslissende oomblik in sy reaksie inkorporeer.
'n Multimiljard dollar-mark met nuwe toetredeversperrings
Die ekonomiese waarde van KI-gedrewe sigbaarheid is nie uitsluitlik afgelei van verhoogde webwerfverkeer nie. 'n Beduidende deel van die impak daarvan vind plaas selfs voordat 'n gebruiker klik. Die handelsmerk kan in 'n reaksie genoem word, as relevant gekategoriseer word, en, saam met spesifieke prestasie-eienskappe, stewig in die gebruiker se geheue geanker word. Selfs al word die daaropvolgende aankoop deur 'n kleinhandelaar, platform of direkte kontak gemaak, het die KI-stelsel die aanvanklike keuse beïnvloed.
Dit lei tot 'n meetprobleem. Tradisionele statistieke soos bladsybesigtigings, deurklikkoers of ranglysposisie weerspieël slegs gedeeltelik die invloed. Maatskappye benodig ook 'n KI-gebaseerde sigbaarheidsanalise: Hoe gereeld word die handelsmerk in relevante vrae genoem? Waar verskyn dit? Watter eienskappe skryf die stelsel daaraan toe? Watter bronne word vir hierdie stellings gebruik? Hoe stabiel is die resultaat oor verskillende modelle, gebruikersformulerings, streke en tydperke? En word die handelsmerk bloot genoem of eintlik aanbeveel?
Hierdie onderskeid is van kardinale belang. 'n Vermelding kan neutraal, krities of terloops wees. 'n Aanbeveling, aan die ander kant, bevat 'n implisiete oproep tot aksie. Die eerste posisie is veral waardevol omdat gebruikers dikwels 'n geordende lys as 'n ranglys interpreteer. Daarom kan diegene wat slegs die aantal handelsmerkvermeldings meet, skynbaar positiewe ontwikkelings sien, selfs al rangskik die handelsmerk gereeld agter mededingers in die reaksies of word dit vergesel van waarskuwings.
Terselfdertyd ontstaan nuwe toetredersversperrings. Groot handelsmerke het meer historiese vermeldings, meer persdekking, meer resensies, meer soekvolume en meer gestruktureerde data. Hierdie seine tree op soos opgehoopte reputasiekapitaal. Terwyl jong maatskappye kan inhaal met hoogs aanhaalbare inhoud, benodig hulle meer as net om hul eie webwerf te verbeter. Hulle benodig validering van 'n netwerk van handelspublikasies, kliënte, verenigings, vergelykingswebwerwe en ander geloofwaardige derde partye. KI-sigbaarheid is dus minder 'n kwessie van individuele inhoudskepping as die bou van 'n verspreide inligtingsinfrastruktuur.
Waarom syfers, aanhalings en bronne so effektief is
Fundamentele GEO-navorsing toon dat sekere redaksionele intervensies 'n bron se sigbaarheid in gegenereerde soekresultate aansienlik kan verhoog. Konkrete statistieke, verifieerbare bronaanhalings en feitelike stellings van kundiges het besonder effektief geblyk te wees. In beheerde eksperimente het gemete sigbaarheid met tot ongeveer 40 persent toegeneem. Validering met behulp van 'n werklike generatiewe soekenjin het ook aansienlike winste opgelewer. Hierdie syfers is relevant, maar moet nie verkeerd geïnterpreteer word as 'n gewaarborgde besigheidseffek nie.
Die onderliggende meganisme is aanneemlik. Generatiewe stelsels verkies teksbrokkies wat kompak in 'n antwoord opgeneem kan word en terselfdertyd die voorkoms van verifieerbare bewyse bied. 'n Presiese numeriese waarde is makliker om te onttrek as 'n bladsy vol generiese advertensie-eise. 'n Duidelik gedefinieerde kwessie is makliker om aan 'n maatskappy toe te skryf as 'n vae handelsmerkboodskap. 'n Eksterne bron, ten minste oppervlakkig, verminder die risiko om bloot selfpromosie te reproduseer.
Dit lei tot 'n belangrike skeidslyn. Die aanvulling van egte, relevante en metodologies verifieerbare data verbeter beide inligtingskwaliteit en masjienbruikbaarheid. Omgekeerd, as syfers sonder 'n betroubare basis gegenereer word, aanhalings uit konteks geneem word, of sogenaamde onafhanklike bronne deur die maatskappy self beheer word, word optimalisering 'n misleidende argitektuur. Die formele oppervlak bly identies: getal, bron, kundige mening. Die verskil lê in oorsprong, substansie en openbaarmaking.
Die gereeld aangehaalde toename van 41 persent vereis ook konteks. Dit beskryf 'n spesifieke sigbaarheidsmetriek binne 'n eksperimentele omgewing en nie 'n algemene toename in inkomste, leidrade of werklike aanbevelings nie. Die bronne wat ondersoek is, was reeds teenwoordig binne die verskafde inligtingskonteks. Daarom toon die navorsing hoofsaaklik dat bestaande inhoud, as gevolg van die bewoording en bewysstruktuur, meer effektief in reaksies opgeneem kan word. Dit bewys nie dat elke hersiene bladsy meer gereeld gekruip, organies verkry of permanent oor platforms aanbeveel sal word nie.
Die verrassende voordeel van die tweede ry
Een van die interessantste waarnemings uit GEO-navorsing het betrekking op bladsye wat nie eerste in tradisionele soekresultate verskyn nie. In een eksperiment het die byvoeging van bronverwysings die sigbaarheid van 'n vyfde-gekeurde bladsy met meer as 115 persent verhoog, terwyl die eerste-gekeurde bladsy in dieselfde scenario 'n beduidende afname in sigbaarheid gely het. Soortgelyke verspreidingseffekte is waargeneem met aanhalings en statistieke. Dit weerspreek die wydverspreide aanname dat 'n reeds suksesvolle Google-bladsy outomaties selfs meer dominant sal word deur bykomende optimalisering.
Hierdie bevinding kan verstaan word as 'n gelykmakende effek. Generatiewe stelsels moet verskeie bronne in 'n beperkte respons integreer. Wanneer swakker bronne skielik beter gemotiveerde, meer bondige of makliker absorbeerbare inligting bied, word hulle meer ruimte gegee. Hierdie bykomende ruimte is dan nie beskikbaar vir die voorheen dominante bronne nie. Die totale hoeveelheid aandag groei nie onbepaald nie; dit word herverdeel.
Dit bied 'n werklike geleentheid vir mediumgrootte besighede en gespesialiseerde diensverskaffers. In tradisionele soekresultate trek gevestigde domeine voordeel uit hul ouderdom, terugskakels, handelsmerkherkenning en uitgebreide inhoudgeskiedenis. In generatiewe soekresultate kan 'n klein, kundige bron egter 'n onevenredig beduidende bydrae lewer as dit 'n spesifieke vraag beter as die markleier beantwoord. Nisse met komplekse produkte, dienste wat verduideliking vereis en onvolledige data is veral belowend.
Dieselfde effek kom egter met 'n waarskuwing. As alle markdeelnemers dieselfde optimeringsmetodes gebruik, verminder die relatiewe voordeel. 'n Innovasie word 'n nuwe minimumstandaard. Dan is die wenners nie meer diegene wat bloot statistieke en bronne gebruik nie, maar diegene wat oorspronklike data, eksklusiewe kundigheid en egte institusionele geloofwaardigheid besit. Die kompetisie verskuif van tekstuele polering na die produksie van bewyse.
Lof van ander is beter as selfpromosie
Maatskappye kan hul eie webwerf ten volle beheer, maar juis daarom is die oorredingskrag daarvan beperk. 'n Vervaardiger wat hulself as toonaangevend, innoverend of besonder betroubaar beskryf, maak 'n bevooroordeelde stelling. In teenstelling hiermee bied 'n onafhanklike tegniese artikel, 'n betroubare kliëntresensie of 'n bedryfstudie eksterne validering. Generatiewe stelsels weerspieël nie altyd bewustelik hierdie verskil nie, maar hulle vind dikwels meer diverse vergelykings, meer konkrete ervarings en groter kontekstuele begrip in derdeparty-publikasies.
Uitgebreide ontledings van kommersiële soeknavrae toon dat 'n beduidende gedeelte van handelsmerkontdekking in KI-gegenereerde reaksies van eksterne domeine afkomstig is. In 'n studie van meer as 21 000 handelsmerkvermeldings, het 85 persent van eksterne bronne gekom, terwyl slegs 'n aansienlik kleiner deel direk aan die betrokke maatskappy se domein gekoppel was. Vergelykende artikels, beste-van-lyste en resensies was veral effektief. Ander datastelle toon wisselende verhoudings afhangende van die platform, navraagtipe en definisie. Nietemin bly die tendens duidelik: 'n maatskappy se eie webwerf is nie meer voldoende nie.
Die dikwels herhaalde bewering dat eksterne menings presies drie keer die impak van 'n mens se eie webwerf het, verwar verskillende faktore. Daar is onder andere betroubaar waargeneem dat handelsmerkvermeldings op die oop web aansienlik sterker korreleer met KI-sigbaarheid as tradisionele terugskakels. Dit is nie dieselfde as oorsaaklike bewys dat elke eksterne stelling drie keer die gewig van 'n mens se eie bladsy dra nie. Korrelasies dui op verwantskappe, maar nie noodwendig die onderliggende meganisme nie.
Vir praktiese doeleindes bly die gevolg duidelik: openbare betrekkinge word 'n tegniese komponent van KI-gedrewe ontdekbaarheid. Tegniese artikels, ontledersverslae, verenigingswebwerwe, geloofwaardige kliëntgevallestudies, openbare datastelle, poduitsendings, videoformate en besprekings in relevante gemeenskappe vorm saam die semantiese omgewing van 'n handelsmerk. Wat saak maak, is nie net dat die naam gereeld verskyn nie, maar in watter konteks, met watter eienskappe en deur watter bron.
Wanneer selfs die naam die oordeel kleur
Taalmodelle is nie vry van handelsmerkvooroordeel nie. Studies toon dat bekende globale handelsmerke meer gereeld met positiewe eienskappe geassosieer word as plaaslike of minder bekende verskaffers. In beheerde produktoetse dien handelsmerkbewustheid hoofsaaklik as 'n plaasvervangende sein wanneer produkte skaars onderskeibaar is op grond van hul kenmerke. Sodra 'n onbekende mededinger aantoonbaar beter prestasiedata of graderings behaal, kan hierdie voordeel vinnig verdwyn. Dus, in situasies van onsekerheid, dien die handelsmerknaam meer as 'n vooropgestelde idee en besluitnemingshulpmiddel as as 'n onoorkomelike oordeel.
Die taalkundige betekenis van 'n naam kan ook 'n rol speel. Woorde met positiewe konnotasies aktiveer meer gunstige assosiasies as terme wat konflik, verveeldheid of wanorde suggereer. Dit beteken egter nie dat 'n vriendelikklinkende maatskappynaam permanent die werklike produkgehalte oorheers nie. Inteendeel, die naam kan maklik die toon van 'n beskrywing verander, veral wanneer die model nie betroubare inligting het nie.
Die spesifieke bewering dat 'n studie van meer as 900 werklike handelsmerke omvattend 'n outomatiese en kwaliteitsonafhanklike voorkeur vir positiefklinkende name bewys het, moet nie as 'n gevestigde feit aangebied word sonder toegang tot die oorspronklike studie nie. Hoewel daar relevante navorsing oor handelsmerkvooroordeel, bewustheid en taalkundige valensie is, moet die presiese steekproef, metodologie en effekgrootte verifieerbaar wees. Vir 'n ernstige artikel is hierdie beperking belangriker as 'n skouspelagtige getal.
Maatskappye moet nie haastig wees met herhandelsmerkprojekte gebaseer hierop nie. 'n Nuwe naam kan handelsmerkbewustheid, soekvolume en bestaande assosiasies vernietig. 'n Meer sinvolle benadering is konsekwente entiteitsbestuur: dieselfde handelsmerknaam, ondubbelsinnige produkname, konsekwente maatskappydata en duidelike beskrywings oor alle relevante platforms. Hoe meer ondubbelsinnig die inligting, hoe minder hoef die model betekenis af te lei uit die blote woordeffek van die naam.
🎯🎯🎯 Data-gedrewe B2B-bedryfsentrum as 'n kwasi-interne oplossing


Die kwasi-in-huis oplossing: Hoe Xpert.Digital operasionele gapings in B2B-bemarking en -verkope sluit – Slim Inhoudgedrewe Besigheid - Beeld: Xpert.Digital
Xpert.Digital is 'n datagedrewe B2B-bedryfsentrum onder leiding van Konrad Wolfenstein . Die maatskappy tree op as 'n eksterne, kwasi-interne oplossing vir industriële vennote, wat operasionele gapings in bemarking, inhoud en verkope sluit – sonder om bykomende hulpbronne aan die kliëntkant te benodig.
Meer inligting hier:
Die uitdagings van KI-sigbaarheid vir besighede
Bemarkingspraktyke: tussen opvoeding en invloed
'n Verantwoordelike bemarkings- of PR-bestuurder wat KI-response aktief wil beïnvloed, begin ideaal gesproke nie met truuks nie, maar met 'n inventaris. Dit behels die insameling van herhalende vrae van potensiële kliënte en die toets daarvan in verskeie stelsels, met verskillende bewoording en op verskillende tye. Vermeldings, ranglys, toegeskrewe eienskappe, foute, waarskuwings en bronne wat gebruik word, word aangeteken. Slegs dan kan 'n betroubare beeld van werklike sigbaarheid geskep word.
Die volgende stap behels die sluiting van inligtingsgapings. Produkdata moet ondubbelsinnig, op datum en masjienleesbaar wees. Eise vereis soliede bewyse. Gevallestudies moet spesifieke aanvanklike situasies, maatreëls wat geneem is en resultate verduidelik, eerder as om bloot kliëntname aan te bied. Tegniese artikels moet identifiseerbare outeurskap, opdateringsdatums en verifieerbare metodologieë insluit. Gestruktureerde data help soekstelsels om maatskappye, produkte, mense en organisasies korrek te kategoriseer, maar dit vervang nie geloofwaardige inhoud nie.
Dan begin die eksterne aspek. 'n PR-strategie vir KI-gegenereerde reaksies mik nie na soveel ewekansige publikasies as moontlik nie, maar eerder na daardie bronne wat werklik geraadpleeg word wanneer relevante vrae ontstaan. Dit kan handelspublikasies, verenigings, vergelykingsportale, navorsingsinstellings, streeksakemedia of gespesialiseerde gemeenskappe insluit. 'n Maatskappy moet nie hierdie platforms vir geheime selfpromosie gebruik nie, maar eerder verifieerbare inligting aanbied: sy eie markdata, tegniese ontledings, kundige menings, openlik gedokumenteerde toetse of nuwe bedryfswaarnemings.
Die versoeking om inligting te manipuleer is steeds sterk. Gekoopte gasplasings kan as onafhanklike resensies verskyn. Maatskappywerknemers kan anoniem aanbevelings in forums maak. Vals kundiges kan aanhalings verskaf wat daarna op verskeie webwerwe herhaal word. Outomatiese resensies kan 'n nie-bestaande konsensus voorgee. Verskeie skynbaar onafhanklike domeine kan uiteindelik aan dieselfde organisasie behoort. Sulke metodes kan die digtheid van inligting op kort termyn verhoog, maar dit beskadig die betroubaarheid van die hele stelsel en skep beduidende regsrisiko's.
Wat Artikel 50 eintlik reguleer
Sedert 2 Augustus 2026 is die deursigtigheidsverpligtinge van Artikel 50 van die Europese KI-verordening van krag. Verskaffers van stelsels wat direk met mense interaksie het, moet in beginsel duidelik maak dat gebruikers met KI kommunikeer, tensy dit reeds voor die hand liggend is. Verskaffers van generatiewe stelsels moet kunsmatig gegenereerde of gemanipuleerde inhoud in 'n masjienleesbare formaat etiketteer en dit tegnies identifiseerbaar maak. Vir generatiewe stelsels wat voor hierdie datum op die mark geplaas word, is daar 'n beperkte oorgangstydperk tot 2 Desember 2026 vir hierdie spesifieke tegniese etiketteringsvereiste.
Verdere verpligtinge het betrekking op emosieherkenning en biometriese kategoriseringstelsels, sowel as sogenaamde diepnamaaksels. Operateurs moet ook KI-gegenereerde of gemanipuleerde tekste openbaar maak indien dit gepubliseer word om die publiek in te lig oor sake van openbare belang. 'n Belangrike uitsondering bestaan indien menslike redaksionele hersiening plaasgevind het en 'n persoon of organisasie redaksionele verantwoordelikheid aanvaar.
Oortredings kan lei tot boetes van tot €15 miljoen of tot 3 persent van die wêreldwye jaarlikse omset. Proporsionaliteitsreëls geld vir kleiner maatskappye, maar daar is geen algemene vrystelling vir klein markdeelnemers nie. Nasionale marktoesigowerhede is hoofsaaklik verantwoordelik, en in sekere situasies kan die Europese KI-kantoor en die Europese Databeskermingstoesighouer ook betrokke wees.
Van kritieke belang is egter dat Artikel 50 nie reguleer wat dit nie reguleer nie. Dit verbied oor die algemeen nie die maak van inhoud meer opspoorbaar en aanhaalbaar vir ChatGPT, Perplexity of Google nie. Dit verbied nie die gebruik van statistieke, gestruktureerde produkdata, bronverwysings, akademiese artikels of tradisionele openbare betrekkinge nie. Die wydverspreide oordrywing dat 'n nuwe EU-reël nou pogings verbied om KI-response te manipuleer, is dus 'n te breë wetlike definisie en, in hierdie vorm, misleidend.
Artikel 50 is hoofsaaklik 'n deursigtigheidstandaard vir sekere KI-stelsels en sekere KI-gegenereerde inhoud. Of 'n spesifieke geolokasiemaatreël onwettig is, hang dikwels meer af van ander regulasies: die verbod op sekere manipulerende KI-praktyke in Artikel 5, Europese wetgewing oor onbillike mededinging en verbruikersbeskerming, advertensie-etiketteringsvereistes, die Wet op Digitale Dienste, databeskermingswetgewing en nasionale mededingingsreëls. Die nuwe wetlike raamwerk skep dus nie 'n algehele verbod op geolokasie nie, maar verhoog eerder die druk om kunsmatige oorsprong, kommersiële belange en verantwoordelikheid duidelik te openbaar.
Waar optimalisering in misleiding verander
Die wetlike grens is nie tussen sigbare en onsigbare soekenjinoptimering nie. Dit lê tussen waarheidsgetroue voorstelling en relevante misleiding. 'n Maatskappy kan sy sterk punte duidelik aanbied, inhoud tegnies toeganklik maak en verifieerbare suksesse kommunikeer. Probleme ontstaan wanneer 'n saketransaksie valse inligting bevat, noodsaaklike besonderhede verberg, of die indruk van onafhanklike bevestiging skep ten spyte van die bestaan van ekonomiese beheer.
Die kwessie van vals resensies is besonder duidelik. Europese verbruikerswetgewing verbied die plasing of opdraggewing van vals kliëntresensies of -aanbevelings. Dit is ewe problematies om resensies as die ervarings van egte kopers aan te bied sonder om gepaste stappe te doen om dit te verifieer. Of die teks deur 'n mens of 'n taalmodel geskryf is, maak geen verskil aan die misleidende aard daarvan nie. KI maak produksie goedkoper, maar nie meer wettig nie.
Verborge advertensies kan ook onwettig wees. As 'n maatskappy betaal vir 'n aanbeveling wat redaksioneel voorkom, moet die kommersiële aard daarvan duidelik identifiseerbaar wees. Die feit dat 'n KI-stelsel later hierdie plasing as bron gebruik, skakel nie die oorspronklike misleiding uit nie. Inteendeel, die stelling kan addisionele gesag verkry deur die skynbaar neutrale herhaling in 'n KI-reaksie. Daarom moet maatskappye nie net nagaan wat hulle self publiseer nie, maar ook hoe opdraggewende agentskappe, beïnvloeders, affiliasies en verkoopsvennote hulself aanbied.
Artikel 5 van die KI-regulasie stel 'n hoë drempel vir verbode manipulerende of misleidende KI-praktyke. Dit dek doelbewus manipulerende, subliminale of misleidende tegnieke wat die vermoë om ingeligte besluite te neem aansienlik belemmer en aansienlike skade veroorsaak, of waarskynlik sal veroorsaak. Gewone oorredende advertensies val nie outomaties onder hierdie bepaling nie. Sistematiese misleiding in sensitiewe besluite, soos dié rakende gesondheid, finansies of veral kwesbare groepe, kan egter hierdie drempel nader.
Vir voldoeningspraktyk geld 'n eenvoudige beginsel: Enigiets wat slegs werk as gebruikers, platforms of nuuskantore nie die ware oorsprong van 'n stelling kan identifiseer nie, is hoogs riskant. Omgekeerd is 'n maatreël meer regverdigbaar as die oorsprong, befondsing, metodologie en databasis daarvan openlik bekend gemaak kan word sonder om die doeltreffendheid daarvan te ondermyn. Deursigtigheid is nie net 'n wetlike verpligting nie, maar ook 'n stresstoets vir die legitimiteit van die strategie.
Hoe maklik taalmodelle mislei kan word
Taalmodelle verwerk nie waarheid in die menslike sin nie. Hulle bereken geloofwaardige voortsettings, verkry toegang tot geselekteerde dokumente wanneer 'n soektog geaktiveer word, en weeg inligting volgens patrone, relevansieseine en stelselspesifikasies. Dit laat hulle toe om indrukwekkend presies te voorkom terwyl hulle terselfdertyd vatbaar is vir oppervlakkige seine van gesag. 'n Getal met 'n desimale plek, 'n medies-klinkende frase of 'n vermeende kundige mening kan geloofwaardig lyk, selfs al ontbreek die onderliggende bewyse.
Beheerde studies oor produkaanbevelings toon dat bekende handelsmerke 'n beduidende voordeel kan hê, selfs met identiese produkdata. Terselfdertyd is selfs geringe verskille in kwaliteit of gesaghebbende bemarkingsaansprake soms genoeg om die aanbeveling te verander. Veral problematies is die feit dat vervaardigde kliniese of wetenskaplike aansprake ook invloed kan kry as die model nie hul oorsprong betroubaar verifieer nie. Dit toon duidelik dat 'n taalmodel nie 'n onafhanklike verifikasieliggaam kan vervang nie.
Webgebaseerde modelle is nie outomaties immuun nie. Hul kwaliteit hang af van watter dokumente gevind, gekontekstualiseer en as betroubaar beskou word. As baie webwerwe dieselfde ongegronde bewering van mekaar herhaal, word 'n valse konsensus geskep. As huidige, hoëgehalte-inligting tegnies moeilik is om toegang te verkry, kan die masjien terugval op meer toeganklike, maar laergehalte-bronne. Herwinning verminder hallusinasies, maar elimineer nie bronvooroordeel of georkestreerde invloed nie.
Verder is onstabiliteit 'n faktor. Dieselfde aanwysings kan verskillende resultate op verskillende tye, in verskillende sessies of na geringe taalkundige veranderinge lewer. Modelopdaterings, streeksoekindekse en gepersonaliseerde kontekste verander die resultate verder. 'n Enkele positiewe reaksie is dus nie 'n betroubare aanduiding van sukses nie. Betroubare meting vereis herhaling, kontrolevrae, verskeie platforms en 'n duidelike onderskeid tussen opspoorbaarheid, vermelding, aanhaling, positiewe gradering en werklike aanbeveling.
Die wapenwedloop vir masjiengeloofwaardigheid
Sodra GEO ekonomies effektief word, reageer mededingers. Wanneer een verskaffer 'n markstudie publiseer, volg soortgelyke studies. Wanneer kundige kwotasies sigbaarheid verhoog, kom meer kundige inhoud na vore. Wanneer gestruktureerde vergelykingswebwerwe goed presteer, groei hul aantal. Individuele voordele verminder terwyl koste toeneem. Dit lyk soos 'n wapenwedloop waaraan almal moet deelneem, maar nie almal wen op die lange duur nie.
Hierdie kompetisie kan produktief wees. Maatskappye het 'n aansporing om beter data te publiseer, feite duideliker te verduidelik en verifieerbare bewyse vir hul bewerings te verskaf. Klein spesialiste kry 'n kans om mee te ding teen groot handelsmerke met ware kundigheid. Inligting word meer gestruktureerd en op datum. In hierdie scenario verbeter GEO die gehalte van die oop web.
Die teenoorgestelde scenario is ook realisties. Maatskappye oorstroom die internet met masjiengegenereerde artikels, sintetiese kundige menings en formeel korrekte maar substantief waardelose statistieke. Agentskappe bou netwerke van oënskynlik onafhanklike webwerwe. Egte resensies word vervang deur vervaardigde endossemente. Die reaksiestelsels reageer met strenger filters, wat selfs meer gevestigde domeine bevoordeel en nuwe verskaffers uitsluit. In hierdie scenario versterk GEO die einste konsentrasie wat dit oorspronklik bedoel was om op te breek.
Op die lang termyn sal herkoms en verifieerbare oorsprong dus belangriker word. Masjienleesbare identifiseerders, kriptografiese bewyse, duidelike outeurskap en gedokumenteerde metodes kan help om egte primêre inligting van sintetiese herhaling te onderskei. Dit los egter nie die probleem heeltemal op nie. Selfs korrek geëtiketteerde KI-teks kan waar of vals wees, en mensgeskrewe inhoud kan misleidend wees. Die kwaliteit van die bewysketting bly van kritieke belang.
Die wenners en verloorders van die nuwe reaksie-ekonomie
Potensiële wenners sluit in maatskappye met eie data, 'n duidelike bedryfsposisionering en robuuste kliëntresultate. Hulle kan inligting bied wat ander bronne nie eenvoudig kan kopieer nie. Gespesialiseerde media-afsetpunte, verenigings en toetsinstitute word ook belangriker omdat hul assesserings as eksterne validering dien. Diegene wat geloofwaardige bedryfsinligting verskaf, sal deel word van die infrastruktuur waaruit KI-gegenereerde antwoorde na vore kom.
Groot handelsmerke behou hul voordele, maar verloor van hul sekuriteit. Hul bekendheid beteken dat hulle meer gereeld die beginpunt vir aanbevelings is. As hul inligting egter verouderd, onakkuraat of swak gemotiveerd is, kan meer rats mededingers steeds 'n deel van die reaksies kry. Die nuwe kompetisie beloon nie net grootte nie, maar ook tydigheid, duidelikheid en aanhaalbaarheid.
Maatskappye wat uitsluitlik op hul eie webwerf en tradisionele Google-ranglys staatmaak, is in 'n nadeel. 'n Sterk soekposisie waarborg nie dat die handelsmerk in 'n sintetiese soekresultaat sal verskyn nie. Ook in gevaar is verskaffers met teenstrydige produkname, teenstrydige pryse, onduidelike resensies of 'n swak eksterne reputasie. KI-stelsels kan sulke onsekerhede nie betroubaar oplos nie en is meer geneig om bekende alternatiewe te gebruik.
Gebruikers kan ook verloor. ’n Vloeiende antwoord verminder die sigbare diversiteit van bronne en maak dit moeiliker om kommersiële belange te identifiseer. Veral met mediese, finansiële en regsvrae kan skynbaar ondubbelsinnige advies onnodige vertroue skep. Die maatskaplike uitdaging lê dus nie net in die etikettering van KI-gegenereerde inhoud nie, maar ook in die duidelik sigbaar maak van onsekerheid, bronmateriaal en belangebotsings.
'n Goeie strategie in plaas van korttermyn-truuks
'n Goeie KI-sigbaarheidstrategie begin met 'n onderwerp- en vraagmodel. Maatskappye moet die spesifieke probleme identifiseer wat kliënte wil oplos, die vergelykingskriteria wat hulle gebruik, en die bewoording wat in verskillende stadiums van die koopbesluit gebruik word. Dit lei tot 'n toetsstel wat gereeld oor verskeie stelsels en variante getoets word. Die resultate moet weergawes hê sodat veranderinge na modelopdaterings of veldtogte identifiseerbaar is.
Volgende kom die inligtingsargitektuur. Elke belangrike diens benodig 'n toegewyde bladsy met verifieerbare inligting, duidelike definisies, betroubare syfers en 'n duidelik sigbare opdateringsstatus. Gereelde vrae moet direk beantwoord word. Tegniese inhoud vereis outeurs met aantoonbare kwalifikasies. Produkdata, maatskappyinligting en kontakpersone moet konsekwent wees oor alle platforms. Teenstrydighede is net so nadelig vir KI-stelsels as vir kliënte.
Die derde element is eksterne geloofwaardigheid. In plaas daarvan om persverklarings onoordeelkundig te versprei, moet 'n maatskappy inligtingskanale prioritiseer wat werklik relevant is vir sy teikengehore. Goeie geleenthede sluit in nuwe primêre data, verifieerbare maatstawwe, oopbronrekenaars, tegniese gidse of presiese gevallestudies. Die doel is nie die kunsmatige herhaling van 'n advertensieboodskap nie, maar 'n verifieerbare stelling wat ander uit hul eie redaksionele belangstelling sal optel.
Die vierde boublok is nakoming deur ontwerp. Elke eksterne plasing moet dokumenteer wie dit betaal, geredigeer en goedgekeur het. Resensies vereis prosesse teen vervalsing en selektiewe onderdrukking. KI-gegenereerde inhoud moet gemerk word volgens die gebruik daarvan en toepaslike wetgewing. Vir openbare onderwerpe is naspeurbare menslike redaksionele toesig veral belangrik. Agentskapkontrakte moet geheime forumplasings, fiktiewe identiteite, vervaardigde aanhalings en onbekende medianetwerke eksplisiet verbied.
Uiteindelik is die meting van ekonomiese sukses noodsaaklik. Sigbaarheid is slegs waardevol as dit relevante vraag genereer, valse bewerings verminder of verkope meetbaar ondersteun. Daarom moet KI-vermeldings gekoppel word aan handelsmerknavrae, direkte besoeke, gekwalifiseerde leidrade, omskakelingskoerse en kliëntopnames. Die deurslaggewende maatstaf is nie hoe gereeld 'n model die naam noem nie, maar of die regte teikengehoor 'n akkurate en betroubare indruk kry.
Europa se regulatoriese raamwerk spreek die regte konflik aan, maar nie met 'n enkele verbod nie
Die maatskaplike intuïsie agter die regulasie is korrek: mense moet kan herken wanneer hulle met 'n masjien interaksie het, wanneer inhoud kunsmatig gegenereer is, en wie verantwoordelikheid dra. Hierdie deursigtigheid word des te belangriker hoe meer KI-stelsels aankoopbesluite, politieke meningsvorming en toegang tot dienste vorm. Artikel 50 lê belangrike fondamente hiervoor en maak tegniese etikettering 'n infrastruktuurtaak.
Artikel 50 alleen is onvoldoende om die werklike manipulasie van handelsmerkaanbevelings aan te spreek. Baie geo-bemarkingsmaatreëls bestaan uit mensgeredigeerde webwerwe, egte media-artikels of geoptimaliseerde produkdata. Hulle is nie onwettig bloot omdat 'n KI-stelsel hulle later gebruik nie. Onwettigheid spruit eerder voort uit valse inligting, vermomde kommersiële belange, vals resensies, beledigende identiteite of besonder skadelike manipulerende praktyke.
Die uitlokkende bewering dat die EU nou verbied dat ChatGPT gunstig oor 'n maatskappy praat, is dus verkeerd. Sekere misleidende metodes kan verbied of goedgekeur word, nie die wettige doel om akkuraat en deursigtig aangebied te word nie. Juis hierdie onderskeid is wat die kwessie interessant maak: maatskappye word toegelaat om mee te ding vir masjiengegenereerde aandag, maar moet verwag dat die oorsprong, etikettering en verifieerbaarheid van hul invloed toenemend ondersoek sal word.
Die strategies mees gesonde reaksie is dus nie onthouding of aggressiewe uitbuiting van elke skuiwergat nie. Dit lê daarin om KI-sigbaarheid te behandel as 'n gevolg van robuuste markkommunikasie. Diegene wat egte data produseer, duidelike verklarings publiseer, onafhanklike verifikasie toelaat en kommersiële verhoudings openbaar, bou langtermyn-inligtingsmag. Omgekeerd kan diegene wat bloot die oppervlak van gesag naboots, reaksies op kort termyn beïnvloed, maar toenemende regulatoriese, reputasie- en ekonomiese risiko's skep.
Vertroue word die skaarsste geldeenheid
Die reaksie-ekonomie beloon aanvanklik diegene wat masjienleesbaar, aanhaalbaar en gereeld genoem is. Op die lange duur sal dit egter diegene moet bevoordeel wie se stellings betroubaar geverifieer kan word. Andersins sal gemanipuleerde aanbevelings die fondament van die besigheidsmodel vernietig: gebruikers se vertroue in vinnige, nuttige en, ideaal gesproke, neutrale leiding.
Vir maatskappye beteken dit 'n fundamentele verskuiwing in perspektief. Die taak is nie om 'n KI te oorreed nie, maar om 'n publiek verifieerbare netwerk van verhoudings te bou gebaseer op feite, ervarings en onafhanklike assesserings. 'n Handelsmerk word nie geloofwaardig bloot omdat sy eie webwerf beweer dat dit wel so is nie. Dit word geloofwaardig wanneer verskillende bronne konsekwente, konkrete en huidige redes daarvoor verskaf.
Vir gebruikers bly skeptisisme noodsaaklik. 'n KI-respons is nie 'n afdoende markanalise nie, maar eerder 'n verkorte momentopname van 'n onvolledige inligtingslandskap. Hoe hoër die finansiële, gesondheids- of persoonlike risiko van 'n besluit, hoe belangriker word oorspronklike bronne, teenstrydige standpunte en menslike kundigheid. Gerieflike advies van een sin moet nie met sekerheid verwar word nie.
Die werklike konflik van die komende jare is dus nie tussen bemarking en regulering nie. Dit is tussen verifieerbare sigbaarheid en sintetiese geloofwaardigheid. Beide kan met die eerste oogopslag identies lyk. Slegs die oorsprong van die data, die onafhanklikheid van die stemme en die openbaarmaking van belange onthul of 'n KI-reaksie ingelig of bloot suksesvol beïnvloed is.
📈🚀 Van sigbaarheid tot vertroue 👀🤝 Jou skaalbare pad met Xpert.Digital


Van sigbaarheid tot vertroue: Jou skaalbare pad met Xpert.Digital - Beeld: Xpert.Digital
In industriële B2B ontstaan volhoubare sakeverhoudings selde oornag. Hulle ontwikkel stap vir stap – deur sigbaarheid, professionele relevansie, herhalende raakpunte en groeiende vertroue. Xpert.Digital se 4-fase-model spreek presies dit aan: Dit bied 'n gestruktureerde pad wat begin met 'n hanteerbare toegangspunt en kan ontwikkel tot dieper samewerking in sake-ontwikkeling indien nodig.
In plaas daarvan om op luide bemarkingsbeloftes staat te maak, plaas hierdie model die verhouding voorop. Maatskappye begin met duidelik gedefinieerde, maklik berekenbare maatstawwe en besluit dan, gebaseer op hul eie ervaring, hoe ver hulle die samewerking wil uitbrei. 'n Sleutelfaktor vir hierdie ongestoorde vertrouensbouproses: Die platform vermy irriterende advertensies heeltemal, sodat die redaksionele fokus uitsluitlik op die maatskappye se kundigheid bly.
Meer inligting hier:
Jou wêreldwye bemarkings- en sake-ontwikkelingsvennoot
☑️ Ons besigheidstaal is Engels of Duits
☑️ NUUT: Korrespondensie in jou moedertaal!

Konrad Wolfenstein
Ek en my span is bly om as jou persoonlike adviseur vir jou beskikbaar te wees.
Jy kan my kontak deur die kontakvorm hier in te vul wolfenstein@xpert.digital:of my eenvoudig te skakel by +49 7348 4088 965. My e-posadres is
Ek sien uit na ons gesamentlike projek.